
深入解析如何在 JavaScript 中实现真正的原地快速排序(In-place QuickSort)。本文对比新数组拼接的内存缺陷,详细讲解双指针分区算法(Lomuto Partition)、元素就地交换、递归边界以及防止栈溢出的工程优化。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
怎么在 JavaScript 中实现原地快速排序(In-place)
作者:青柠
时间:2026-10-30
浏览:585
文章目录
分类:JavaScript 数据结构与算法
阅读时长:约 10 分钟
执行环境:Node.js / 现代浏览器
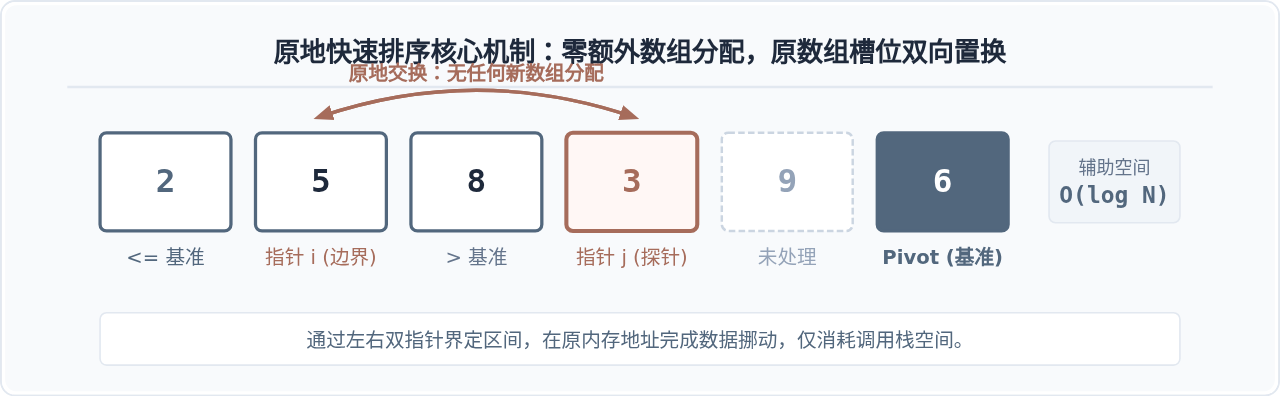
在 JavaScript 中实现真正的原地快速排序(In-place),核心在于直接通过索引在原数组上交换元素,绝不创建新数组。许多前端教程为了演示概念,常用 filter 或空数组拼接出 [...quickSort(left), pivot, ...quickSort(right)],这不仅失去了快速排序 \(O(\log N)\) 内存复杂度的精髓,更会在大数据量下引发垃圾回收暴增甚至页面卡死。本文直接给出生产可用的标准实现,并拆解双指针分区(Partition)细节与工程避坑指南。
一、一个普遍存在的写法误区:伪快排与真原地
打开很多网络教程,搜索“JavaScript 快速排序”,读者见到的第一版代码往往长这样:
// 常见的不良写法:每次递归都创建新数组
function fakeQuickSort(arr) {
  if (arr.length <= 1) return arr;
  const pivot = arr[0];
  const left = [];
  const right = [];
  for (let i = 1; i < arr.length; i++) {
    if (arr[i] < pivot) left.push(arr[i]);
    else right.push(arr[i]);
  }
  return [...fakeQuickSort(left), pivot, ...fakeQuickSort(right)];
}这段代码语法优雅、逻辑易懂,但在算法定义上,它根本不是原地排序。
在上述代码中,每一层递归都会开辟 left 和 right 两个全新的内存数组,最终还调用展开运算符 ... 合成第三个数组。当待排数据达到数十万级别时,V8 引擎的堆内存将迅速被这些临时数组填满,造成极度高频的 Minor GC(垃圾回收暂停),耗时成倍放大,在处理 Int32Array 等类型化数组时更是直接失效。
所谓“原地(In-place)”,是指算法在运行过程中,除了少量的指针变量和递归栈空间外,不申请任何随数据规模增长的额外堆内存。待排数据始终在原来的连续内存槽位内通过“两两交换”完成重新排列。
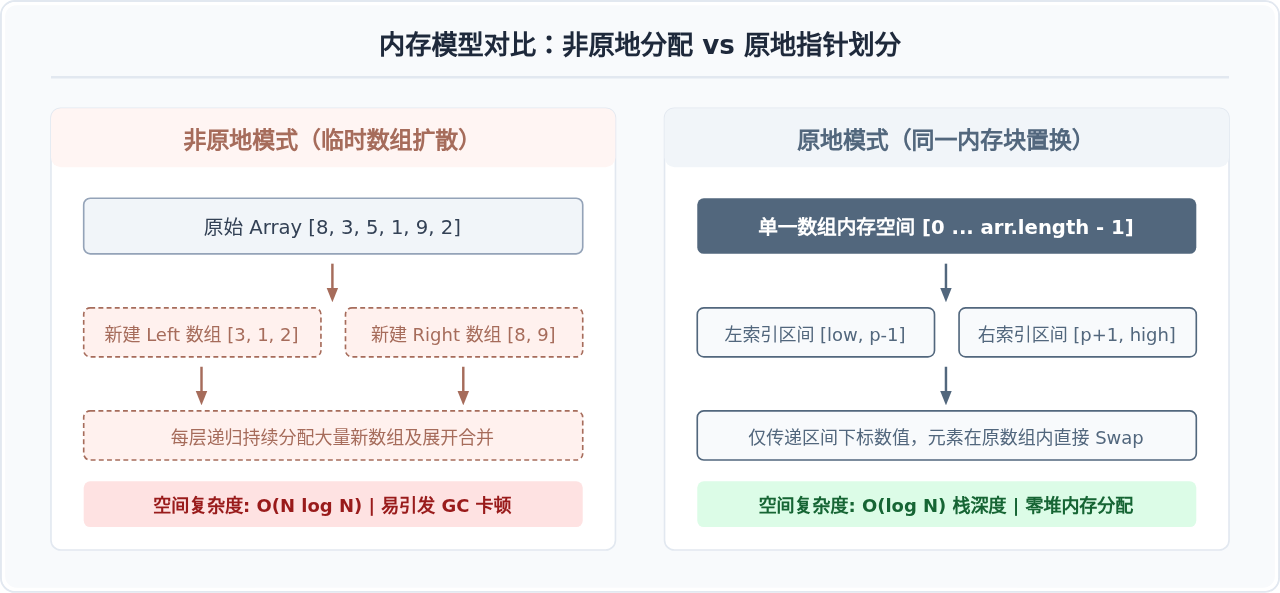
二、核心机制:Lomuto 分区算法与元素交换
实现原地快速排序,最关键的组件就是分区函数(Partition)。
分区的职责是:给定数组的某一段区间 [low, high],选定一个元素作为基准(Pivot),通过两两交换,把小于或等于基准的数全部赶到左边,大于基准的数留到右边,最后将基准放到分界线上,并返回基准最终所在的索引值。
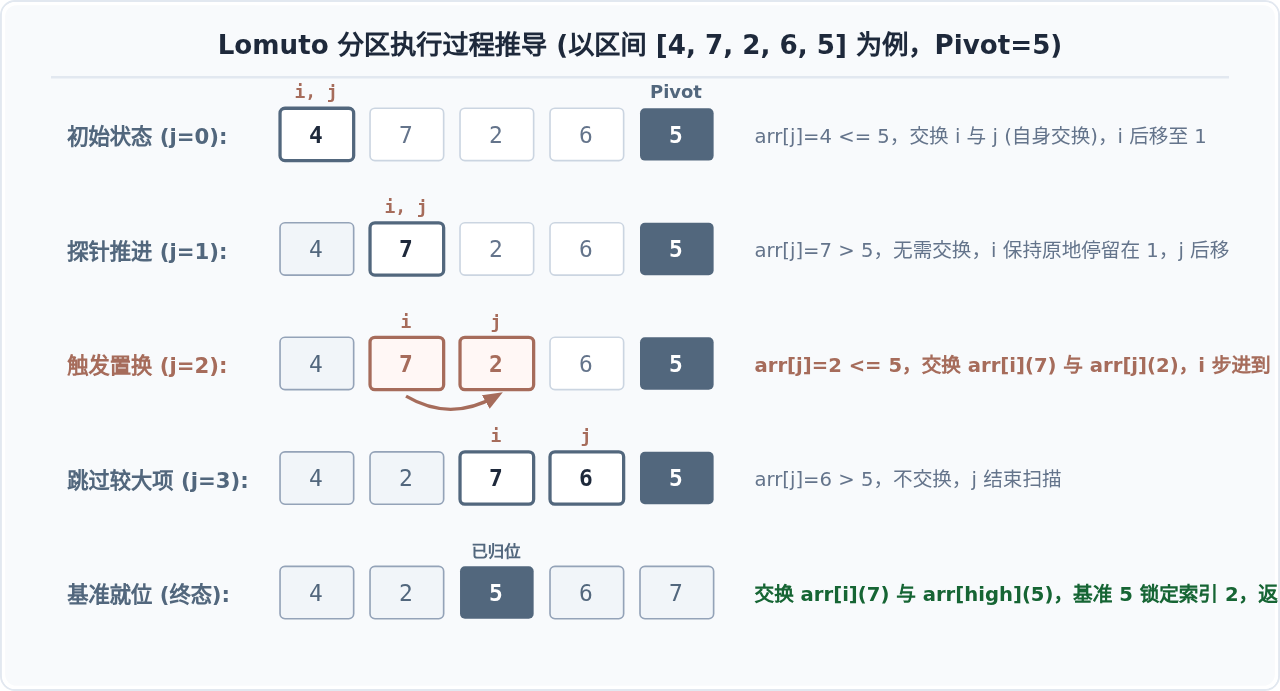
业界最常用且容易编写的是 Lomuto 分区方案。它的工作原理非常清晰:
- 选取区间最右端的元素
arr[high]作为基准值pivot。 - 维护一个分界指针
i,初始值为low。它的含义是:i的左侧(索引小于i的部分)全部是已经被确认“小于等于基准”的元素。 - 使用探针指针
j从low遍历到high - 1。 - 如果发现
arr[j] <= pivot,说明遇到了应该归入左侧区间的元素,此时将arr[i]与arr[j]互换,并将i向右推进一位(i++)。 - 当
j走完全程后,将处于最右侧的基准arr[high]与当前arr[i]互换。此时,i所在的位置就是基准的最终排序归宿。
注意:关于 JavaScript 中的元素交换性能
ES6 提供的解构赋值 [arr[i], arr[j]] = [arr[j], arr[i]] 语法极简,但在 V8 引擎底层频繁执行时,仍然会创建短命的临时数组对象。对于追求极致性能的原地快排,推荐使用传统临时变量 temp 进行交换,这样不仅具备零对象分配的优点,还能被 JIT 编译器充分内联并直接映射到机器寄存器。
三、完整的原地快速排序代码实现
基于上述原理,我们给出具备完整注释、支持可选区间的生产级标准 JavaScript 实现:
/**
 * 交换数组中两个索引位置的元素(无额外内存分配)
 */
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

/**
 * Lomuto 分区方案
 * @param {Array<number>} arr 待排数组
 * @param {number} low 当前分区的起始索引
 * @param {number} high 当前分区的结束索引
 * @returns {number} 基准元素最终就位的索引位置
 */
function partition(arr, low, high) {
  const pivot = arr[high]; // 选取末尾项作为基准
  let i = low;             // 维护小于基准项的边界

  for (let j = low; j < high; j++) {
    // 发现小于等于基准的项,置换到左侧边界
    if (arr[j] <= pivot) {
      if (i !== j) {
        swap(arr, i, j);
      }
      i++;
    }
  }

  // 最后将基准项交换到分界点 i
  if (i !== high) {
    swap(arr, i, high);
  }
  return i;
}

/**
 * 原地快速排序主递归函数
 * @param {Array<number>} arr 目标数组
 * @param {number} low 排序起始下标(默认 0)
 * @param {number} high 排序结束下标(默认 arr.length - 1)
 * @returns {Array<number>} 返回原数组引用
 */
function quickSort(arr, low = 0, high = arr.length - 1) {
  // 基线条件:当子数组元素个数小于等于 1 时停止
  if (low < high) {
    // 1. 在原地进行分区,获得基准所处索引
    const pivotIndex = partition(arr, low, high);

    // 2. 递归排左半边(不包含已就位的 pivotIndex)
    quickSort(arr, low, pivotIndex - 1);

    // 3. 递归排右半边
    quickSort(arr, pivotIndex + 1, high);
  }
  return arr;
}

// === 测试示例 ===
const numbers = [38, 27, 43, 3, 9, 82, 10];
quickSort(numbers);
console.log(numbers); // 输出: [3, 9, 10, 27, 38, 43, 82]
四、分治递归的执行结构与调用栈
快速排序本质上是一个自顶向下的分治算法(Divide and Conquer)。每次调用 partition 之后,原数组并不会切成两半,而是通过 (low, pivotIndex - 1) 与 (pivotIndex + 1, high) 这两对整数下标继续限定操作边界。
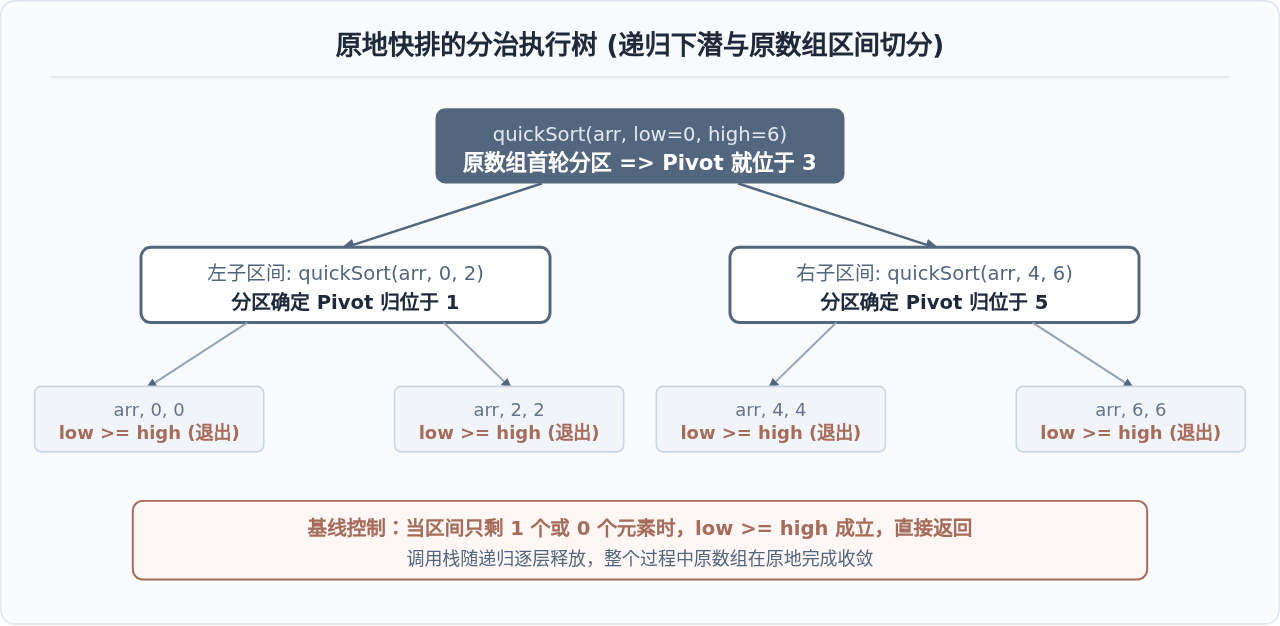
五、工程场景中的两个核心风险与应对方案
在真实业务工程中使用快速排序时,有两处由于 JavaScript 语言特性而极其容易踩坑的地方,需要格外引起警惕:
1. 最坏情况与调用栈溢出(Maximum call stack size exceeded)
当输入的数组本身已经有序(或倒序)时,如果每次固定选取末尾作为基准,会导致切分出的两个子数组严重失衡(一个大小为 0,另一个大小为 \(N - 1\))。
此时快速排序的时间复杂度会退化到 \(O(N^2)\),更危险的是递归深度会达到 \(O(N)\)。Node.js 与各主流浏览器的 JavaScript 调用栈上限通常在 10,000 左右,一旦处理包含上万项的有序数据,直接会抛出 RangeError: Maximum call stack size exceeded。
解决方案 A:随机化主元(Random Pivot)
在执行分区之前,随机挑选当前区间的一个索引,将其先与末尾元素进行一次交换:
function randomizedPartition(arr, low, high) {
  // 生成 [low, high] 之间的随机整数
  const randomIndex = Math.floor(Math.random() * (high - low + 1)) + low;
  swap(arr, randomIndex, high); // 随机项与末尾交换作为基准
  return partition(arr, low, high);
}
解决方案 B:尾递归消除(保证调用栈不超过 \(O(\log N)\))
递归深度过大的根源是同时向下递归两个分支。我们可以改造主循环:只对长度较短的半边进行递归,较长的半边用 while 循环继续迭代。这样能从数学上严格保证递归深度永远不会超过 \(\log_2(N)\)。
function robustQuickSort(arr, low = 0, high = arr.length - 1) {
  while (low < high) {
    const pivotIndex = randomizedPartition(arr, low, high);

    // 优先递归处理较小的一侧,较大的一侧改写为迭代
    if (pivotIndex - low < high - pivotIndex) {
      robustQuickSort(arr, low, pivotIndex - 1);
      low = pivotIndex + 1; // 迭代处理右半段
    } else {
      robustQuickSort(arr, pivotIndex + 1, high);
      high = pivotIndex - 1; // 迭代处理左半段
    }
  }
  return arr;
}
2. 对比原生 Array.prototype.sort 的应用边界
有读者可能会问:现代浏览器与 Node.js 都有内置的 sort(),为什么还要自己实现原地快排?
- TypedArray(类型化数组)的原地高效处理:在 WebGL、音频流分析或 Node.js 二进制 Buffer 处理中,大量使用
Float32Array、Int32Array。这些连续内存数组不允许随意增加长度或拼接对象,手写的原地快排能提供极致的缓存友好度(Cache Locality)。 - 引擎内置实现的变迁:在 V8 早期的实现中,
Array.prototype.sort针对长度小于 10 的数组使用插入排序,大于 10 的使用快速排序;自 2018 年起,V8 已全面切换为 TimSort。TimSort 是稳定的,但内部会维护额外运行栈与缓存数组。在特定内存极其严苛且不需要“稳定排序”的高性能场景下,原地快排是极佳的选择。
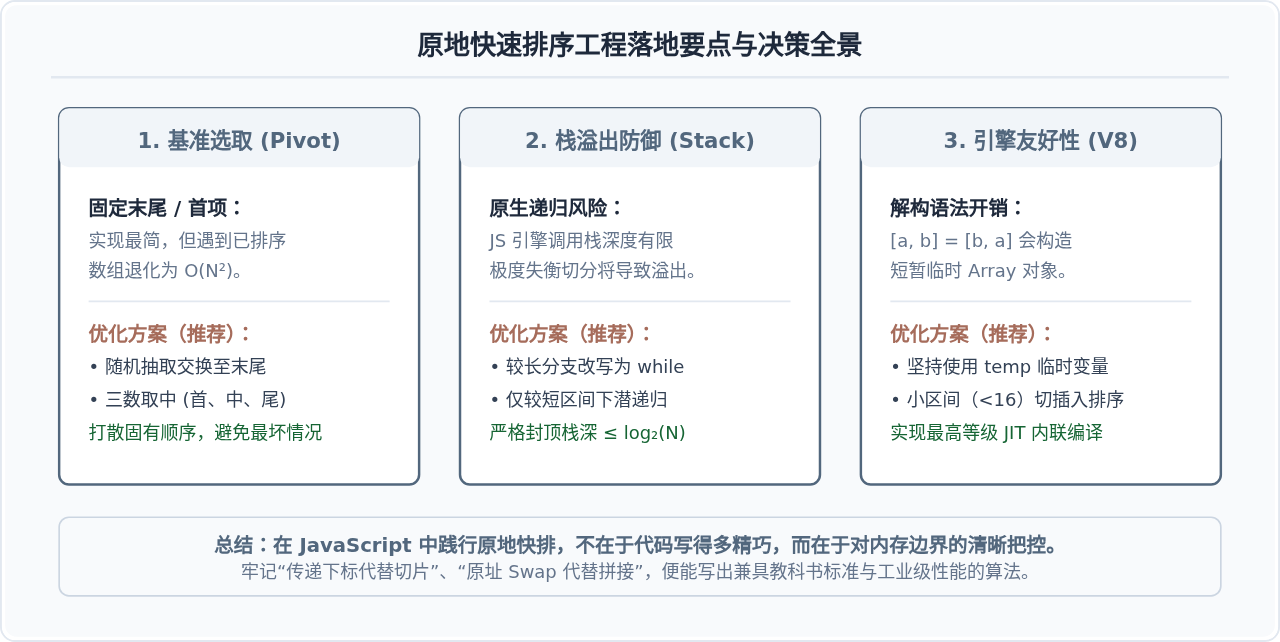
六、算法指标与核心特征汇总
为了让读者在方案选型时有直观的参考依据,我们将原地快速排序的各项技术指标整理如下:
| 维度指标 | 标准原地快排实现 | 伪原地(新数组拼接法) | 说明与场景建议 |
|---|---|---|---|
| 平均时间复杂度 | \(O(N \log N)\) | \(O(N \log N)\) | 二者理论时间复杂度阶数一致,但常数级开销天差地别。 |
| 辅助堆空间 | \(O(1)\)(真正零堆分配) | \(O(N)\) 至 \(O(N \log N)\) | 伪快排每次递归都会大量产生中间数组,增加垃圾回收负担。 |
| 调用栈空间 | \(O(\log N)\)(尾优化后) | \(O(N)\) | 标准原地快排辅以尾递归消除后,绝不会触发栈溢出。 |
| 排序稳定性 | 不稳定(Unstable) | 不稳定(Unstable) | 跨区间置换可能会改变相同数值元素的先后相对次序。 |
| 数据类型支持 | Array、TypedArray、Buffer | 仅支持普通可扩展 Array | 原地排序能直接运行在固定长度的类型化二进制数组上。 |
总结来说,只要记住“用索引指针定义工作区间”与“用临时变量完成原槽位 Swap”这两个根本原则,你就可以在 JavaScript 环境中轻松写出既符合算法规范、又具备极高运行效率的原地快速排序代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章