
基于ECMA-262规范、WHATWG标准与MDN Web Docs等权威资料,系统规划JavaScript分阶段学习路径,涵盖语言核心、宿主环境、运行时机制与工程实践。

当前位置:首页 > JavaScript 基础 > 正文
基于权威资料的JavaScript系统学习路径规划
作者:脚本小铺
时间:2026-10-30
浏览:125
文章目录
学习领域:现代 Web 前端与全栈核心
基准规范:ECMA-262 / WHATWG HTML / W3C DOM
核心参考:MDN Web Docs
建立扎实的 JavaScript 技术体系,核心在于摆脱对零散博客片段和碎片化问答的被动依赖,将学习基准牢固锚定在国际标准规范与权威技术文档上。本文以 ECMA-262 语言规范、WHATWG / W3C 宿主接口标准以及 MDN Web Docs 权威工程指南为蓝本,梳理一套边界明确、递进清晰的四阶段系统学习路径,解决概念模糊、底层运行机制不清以及新技术适应困难等系统性问题。
一、JavaScript 权威资料体系与分工定位
在开始制定具体学习进度之前,必须理清各类权威文献的技术边界。许多初学者常将 JavaScript 语言本身的语法特性与运行宿主提供的接口混为一谈,导致在遇到异步机制或全局对象时出现认知错位。
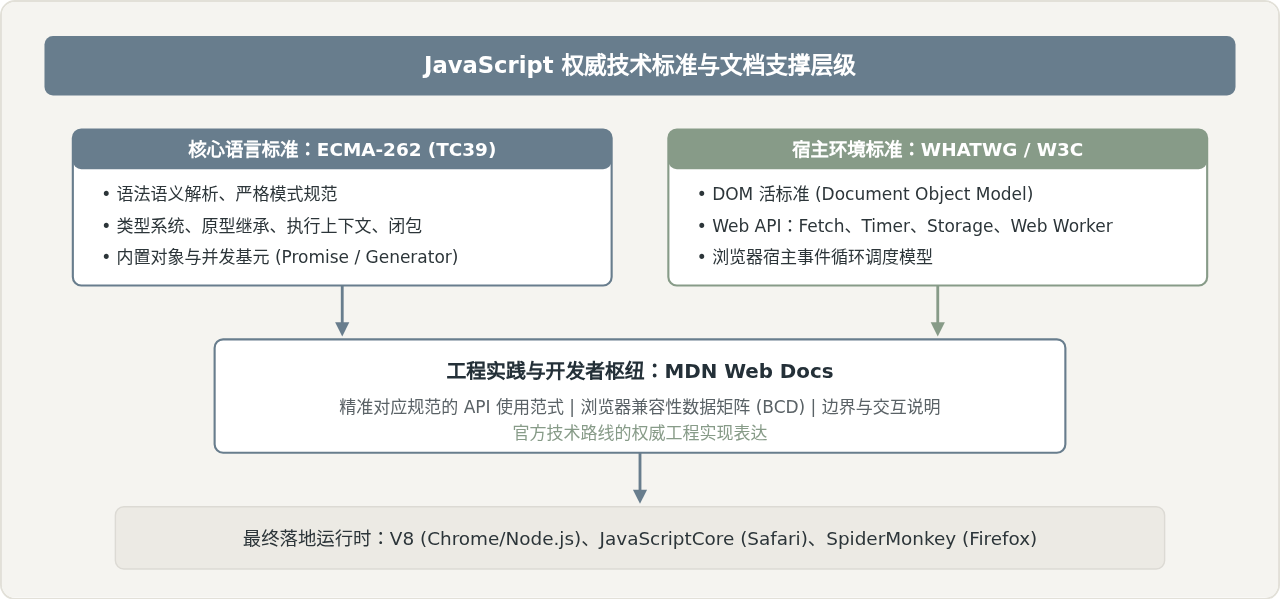
权威的技术资料体系主要分为三个层级:
- ECMA-262(ECMAScript 规范):由 Ecma 国际 TC39 委员会制定,规定了 JavaScript 的语法体系、数据类型、内存模型、对象原型链与原生内置对象(如 Object、Array、Promise)。这是语言的核心基石,完全独立于任何特定宿主环境。
- WHATWG 与 W3C 现行标准(Living Standards):定义了浏览器宿主提供的运行时能力,包括 DOM 树解析、HTML 事件调度、Fetch 网络通信以及广义的事件循环(Event Loop)并发模型。
- MDN Web Docs:由 Mozilla、Google、Microsoft 等多家主流浏览器厂商联合维护,是连接抽象规范与工程实现的最高权威实践资料,提供精准的语法范式、边界行为定义与运行时兼容性数据。
二、认知对比:碎片检索模式 vs 规范驱动体系
在 JavaScript 的学习过程中,选择“碎片检索式模式”还是“规范驱动体系”,决定了学习者能否建立自洽的排查与理解模型。两者在相同问题场景下的处理方式差异如下:
| 对照维度 | 碎片检索式学习模式 | 规范驱动系统学习模式 |
|---|---|---|
| 概念理解方式 | 通过零散示例死记语法规则,如将 this 归纳为多种互不相干的死记规则。 |
依据执行上下文创建、环境记录项(Environment Record)和函数调用类型进行推导。 |
| API 与新特性认知 | 通过博客二次解读,特性用法支离破碎,难以理清新特性的版本与演进动机。 | 查阅 MDN 规范锚点与 TC39 阶段提案,准确掌握参数约束、异常抛出点和副作用。 |
| 复杂问题排查能力 | 遇到异步竞态或原型链污染时,多采用尝试性修改,难以准确定位根本诱因。 | 依据微任务/宏任务队列调度算法与原型查找链,按步排查确定执行顺序。 |
| 长期知识迁移成本 | 框架更迭时认知重构成本极高,容易被新框架的表层语法形式所束缚。 | 底层模型保持稳定,能够快速透视前端框架响应式机制背后的代理(Proxy)本质。 |
由对比可见,规范驱动体系并非要求初学者一开始就逐字啃读晦涩的形式化数学规范,而是建立以 MDN 为纲、以 ECMA-262 核心定义为解题锚点的习惯,遇到疑惑时直接查验官方规范中的算法步骤。
三、四阶段系统学习进阶路径
遵循权威标准的认知规律,完整的学习流程应由语言核心逐步拓展至运行宿主,再深入到底层运行时机制,最终完成工程生态的自洽连接。
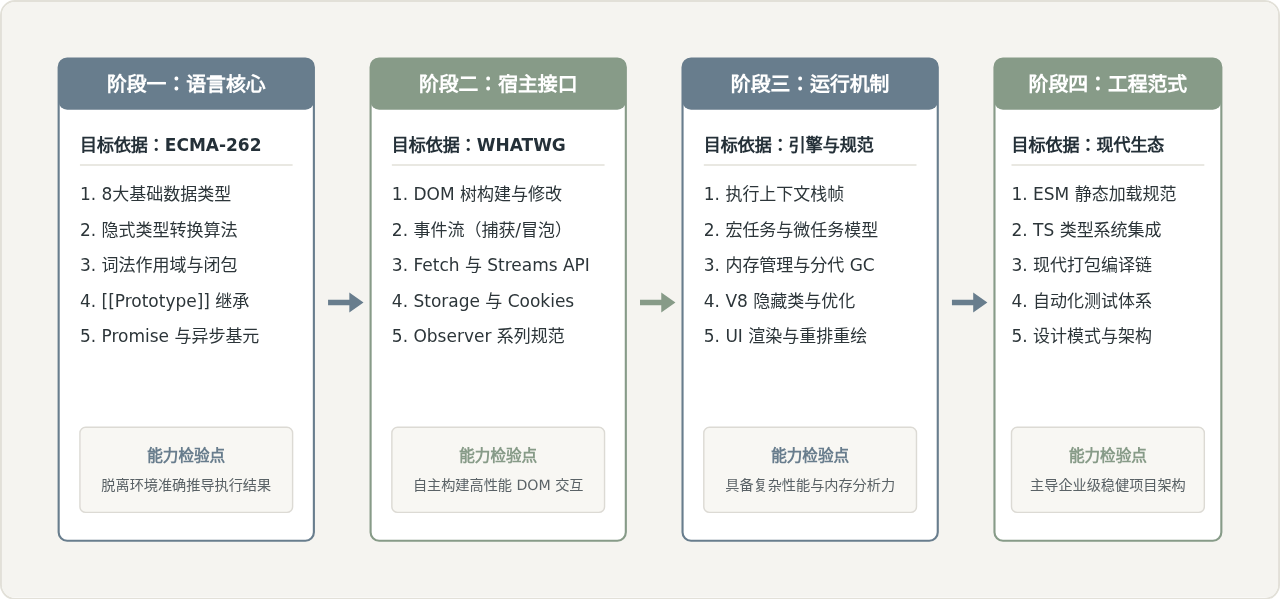
阶段一:语言核心与语法语义(锚定 ECMA-262)
该阶段的核心任务是理解 JavaScript 作为一门图灵完备的动态语言所具有的内在逻辑。重点包括:
- 类型系统本质:彻底掌握 7 种原始数据类型(Undefined、Null、Boolean、Number、BigInt、String、Symbol)与 Object 的内存表征差异。掌握规范中的
ToPrimitive与抽象相等比较算法(Abstract Equality Comparison),避免凭直觉推断运算结果。 - 作用域与执行上下文:通过词法环境(Lexical Environment)的建立过程,理解变量提升的底层成因、暂时性死区(TDZ)的规范定义,以及闭包在堆内存中的保持机制。
- 面向对象与原型链:理解
prototype属性与内部槽位[[Prototype]]的区别。以Object.getPrototypeOf()和属性查找机制为核心,避免将 ES6 的class误解为传统的基于类的静态结构。 - 异步基础基元:掌握
Promise的三种不可逆状态转移,理解其构造函数内同步执行、决议回调进入微任务队列的具体细节。
阶段二:宿主环境与 Web API(锚定 WHATWG 标准)
JavaScript 必须依附宿主才能产生实用价值。阶段二的目标是掌握浏览器环境提供的接口,主要包括:
- DOM 与 CSSOM 操作:熟练运用
querySelector、MutationObserver等标准接口,掌握节点增删查改的生命周期,理解浏览器重排(Reflow)与重绘(Repaint)的触发边界。 - 事件流模型:深入理解事件捕获(Capture Phase)、目标阶段(Target Phase)与冒泡阶段(Bubble Phase)。掌握事件委托机制,以及
stopPropagation()与preventDefault()的准确语义差异。 - 网络通信标准:熟练掌握 Fetch API、Request/Response 对象的流式处理能力(Streams API),以及处理跨域资源共享(CORS)的标准流程。
阶段三:运行时机制与底层性能剖析
在熟练使用语法和接口后,必须向下探究底层执行机理,这决定了开发者在排查卡顿、死锁与内存泄露时的上限。
- 事件循环与调度模型:明确宿主环境中的任务划分。理解微任务队列(Microtask Queue)在单个宏任务结束后、渲染(Rendering)执行前的清空机制。
- V8 引擎编译与优化流水线:理解从源码到抽象语法树(AST)、Ignition 解释器生成字节码,再到 TurboFan 编译器进行 JIT 机器码优化的全生命周期。
- 内存模型与垃圾回收(GC):掌握新生代(Scavenge 算法)与老生代(Mark-Sweep & Mark-Compact 标记整理算法)的工作机理,防范常见的闭包悬挂与未清理的事件侦听器引发的内存泄露。
阶段四:工程范式与架构进阶
现代 JavaScript 开发不仅是写出能运行的代码,更是维护大型协作工程的稳定性:
- 原生模块化(ESM):理解基于静态依赖分析的
import/export机制,区分 CommonJS 运行时加载与 ESM 编译时引用的本质不同。 - 静态类型强化:接入 TypeScript。类型系统不改变运行时行为,但能在编码阶段消除大量由于类型不匹配导致的运行时异常。
- 测试与工程约束:建立基于 Jest/Vitest 的单元测试、ESLint 规范检查与自动化持续集成,保证代码符合业界安全生产标准。
四、核心机制深入:以规范视角解析事件循环
为演示如何基于规范研读具体技术点,以最容易造成困惑的“异步执行机制”为例。WHATWG HTML 规范中明确规定了一个事件循环的执行轮转算法:
- 从任务队列(Task Queue,常称宏任务)中选取最早处于可执行状态的任务出队执行。
- 当该任务执行完毕(调用栈清空)后,执行“微任务检查点”(Perform a microtask checkpoint)。
- 微任务检查点中,连续出队并执行所有微任务,直到微任务队列完全清空。若在微任务执行过程中又产生了新的微任务,同样加入本轮队列并在本轮完全排空。
- 微任务全部清空后,宿主根据屏幕刷新率与系统状态决定是否触发更新渲染(Update the rendering)。
- 回到第 1 步,开始下一轮循环。
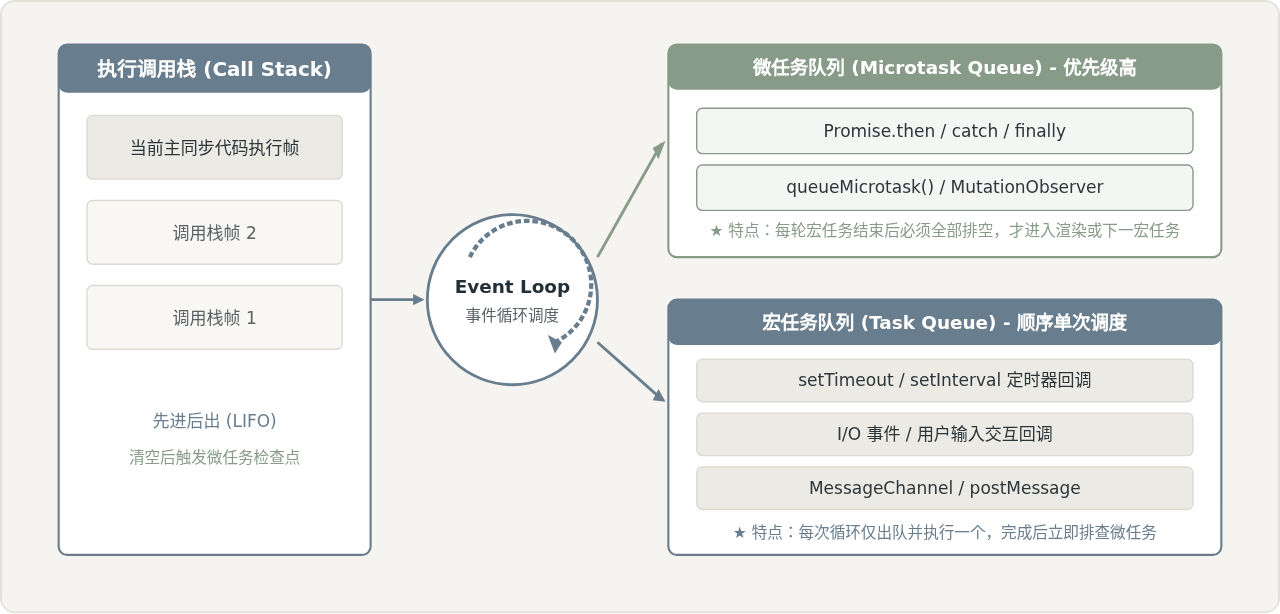
下面通过一段标准的验证代码,展示如何依据上述模型准确推导输出序列:
console.log('1: 脚本主线程同步起点');

setTimeout(() => {
  console.log('2: 定时器宏任务执行');
  Promise.resolve().then(() => {
    console.log('3: 定时器内微任务执行');
  });
}, 0);

Promise.resolve().then(() => {
  console.log('4: 主脚本第 1 个微任务');
}).then(() => {
  console.log('5: 链式生成的第 2 个微任务');
});

console.log('6: 脚本主线程同步终点');
推导分析与验证结果:
- 主脚本同步代码压入调用栈并依次执行:输出
1: 脚本主线程同步起点;注册setTimeout到宿主定时器系统;注册Promise.then到微任务队列;输出6: 脚本主线程同步终点。 - 主栈清空,触发微任务检查点:微任务队列中存在微任务 4,出队执行输出
4: 主脚本第 1 个微任务。此时产生链式回调微任务 5,入队当前微任务队列;由于微任务必须完全排空,微任务 5 紧接着出队执行,输出5: 链式生成的第 2 个微任务。 - 微任务队列清空,进入下一轮事件循环,宏任务出队执行:执行定时器回调,输出
2: 定时器宏任务执行;回调中再次产生微任务 3;该定时器宏任务执行完毕,立即排空微任务,输出3: 定时器内微任务执行。
五、高效研读与检索权威资料的实操方法
掌握了学习路径与底层知识后,日常开发中如何快速利用权威资料解决问题是关键技能:
- 检索 MDN 规范锚点(Specifications):在 MDN 查阅任何 API(例如
Array.prototype.toSorted)时,滑动到页面底部的 Specifications 区域。该区域会提供对应 API 在 ECMA-262 中的规范章节锚点(例如#sec-array.prototype.tosorted)。点击即可直达原始算法定义,查看参数处理和异常边界。 - 核对浏览器兼容性矩阵(Browser Compatibility):查阅页面底部的 BCD 表格,确认特性在主流浏览器桌面端与移动端的支持版本。若有脚注(Footnotes),必须查看是否有特定环境下的行为差异。
- 利用浏览器 DevTools 进行现场内存与堆栈验证:在 Chrome DevTools 的 Sources 面板中,利用 Call Stack 查看当前调用上下文;在 Memory 面板中使用 Heap snapshot 检查对象是否被未预期的闭包持久引用,用真实运行数据印证规范概念。
六、全景总结与阶段能力自测体系
为了帮助学习者检验自己在各个阶段的学习成效,下表与全景图对四个阶段的核心能力要求、对应权威文献及自查标准进行了系统归纳。
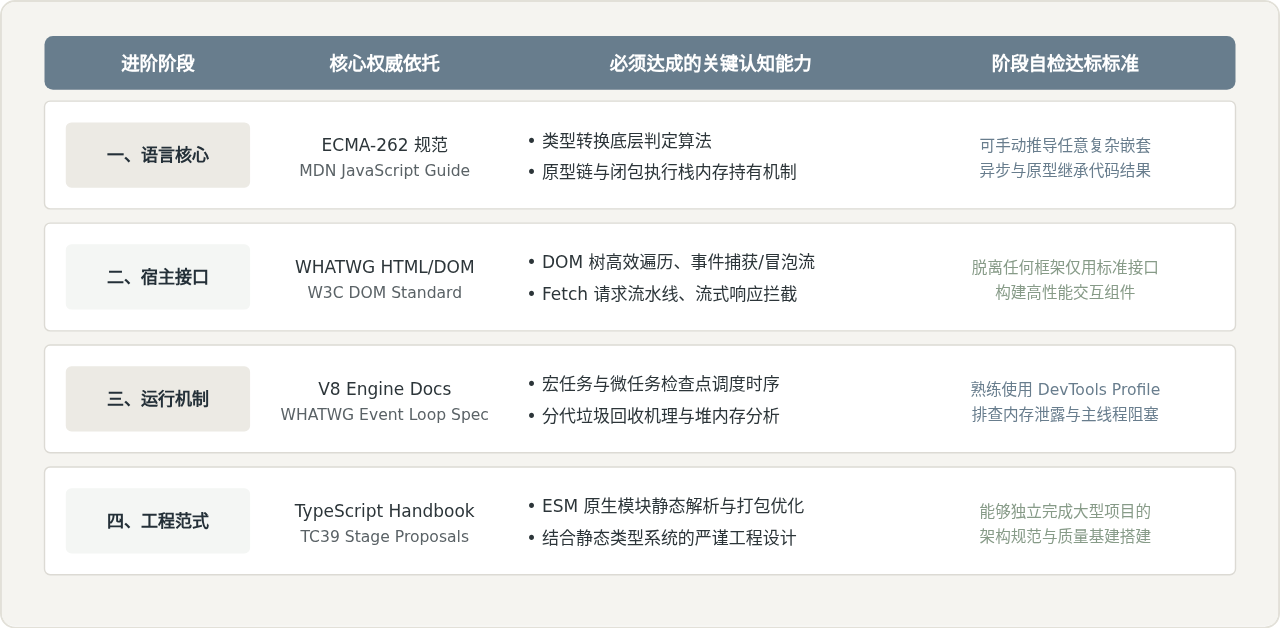
通过将学习基准扎根于权威技术文献,开发者能够在面对快速迭代的前端生态时,看清语法糖背后的语言基语与底层运行本质。按照“语言核心 - 宿主环境 - 运行机制 - 工程范式”四阶段逐层演进,不仅能有效根除知识盲区,更能建立长期稳固且可自我演进的专业技术体系。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章