
深入解析JavaScript中map、filter与reduce高阶函数的核心机制、实战用法、常见误区,并基于原型链规范提供完整的自定义实现与边界处理解析。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript高阶函数实战:map、filter、reduce的使用与自定义实现
作者:半夏
时间:2026-10-30
浏览:579
文章目录
高阶函数(Higher-Order Function)是函数式编程范式在 JavaScript 中的核心体现,也是现代前端工程中处理数组集合数据的基石。简单来说,只要一个函数能够接受另一个函数作为参数,或者将一个函数作为返回值输出,它就符合高阶函数的定义。在 Array.prototype 提供的原生 API 中,map、filter 和 reduce 是使用频次最高、表现力最强的三位代表。掌握它们的语义差异、底层运作机制以及边界防御,能够让我们写出可读性更强、副作用更可控的代码。
一、高阶函数的核心概念与数据流转
传统的命令式循环(如 for、while)要求开发者显式管理循环索引、跳出条件和临时累加变量。这种写法虽然贴近底层执行过程,但在处理多层嵌套或链式变换时容易滋生变量污染和越界错误。高阶函数则采用声明式思路:开发者只需要专注于“对每一个数据项做什么处理”,底层的迭代逻辑、索引步进和边界检查全部封装在函数内部。
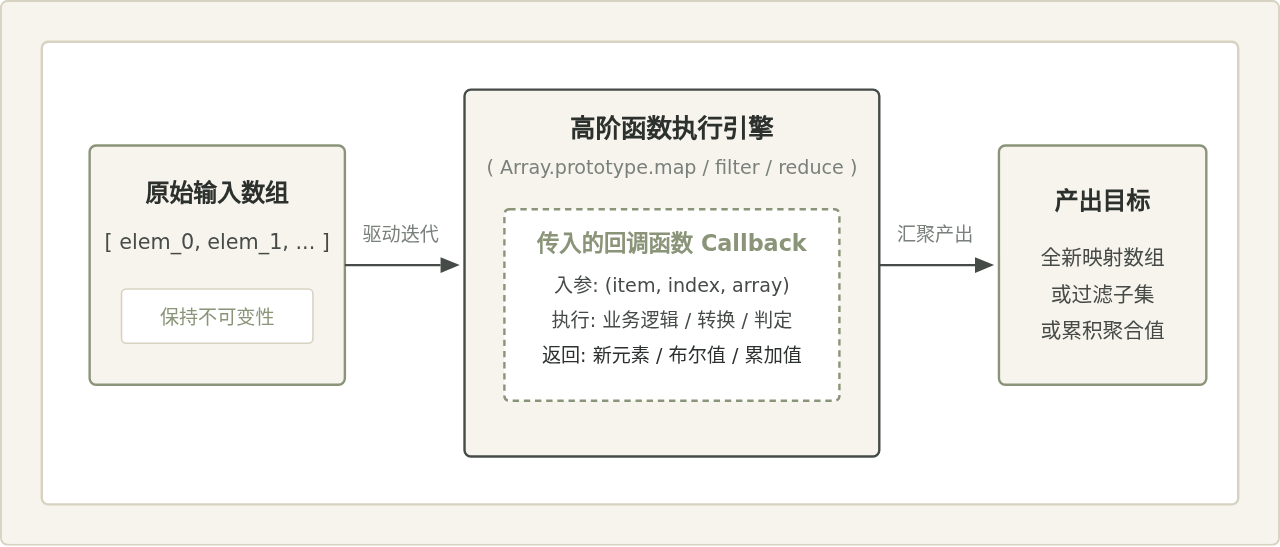
当数组调用高阶函数时,调用方传入一个回调函数(Callback Function)。高阶函数负责驱动迭代,并在每一步将当前元素、索引及原始数组注入到回调函数中,根据回调的执行结果完成数据收集或聚合。
常见认知辨析:高阶函数的运行性能一定不如传统 for 循环吗?
一种常见的说法是“由于函数调用栈存在开销,生产环境中应避免使用 map 和 filter,全面改用 for 循环”。这种看法在纯算法密集型且处理数百万级数据的特殊场景中确实成立,因为函数上下文切换和作用域查找会有纳秒级的损耗。然而在绝大部分常规 Web 业务中,数据规模往往在几十到几千项之间,性能瓶颈几乎全部集中在 DOM 操作与网络请求上。盲目牺牲高阶函数带来的清晰语义和纯函数不可变性,换取微不足道的计算性能,往往得不偿失。
二、Array.prototype.map 的使用与实现
1. 语义与实战用法
map 的核心语义是一对一映射。它创建一个新数组,其结果是原数组中的每个元素调用一次提供的回调函数后的返回值。调用 map 之后,新数组的长度必然与原数组完全相等。
// 场景:提取并转换接口返回的用户列表数据
const rawUsers = [
  { id: 101, firstName: "三", lastName: "张", active: true },
  { id: 102, firstName: "四", lastName: "李", active: false }
];

const userDisplayList = rawUsers.map(user => ({
  userId: user.id,
  fullName: `${user.lastName}${user.firstName}`,
  statusText: user.active ? "在线" : "离线"
}));

console.log(userDisplayList);
// 结果:
// [
//   { userId: 101, fullName: "张三", statusText: "在线" },
//   { userId: 102, fullName: "李四", statusText: "离线" }
// ]
经典陷阱:['1', '2', '3'].map(parseInt) 为何得到 [1, NaN, NaN]?
初学者常会直接将 parseInt 作为回调传递给 map,期望得到数值数组 [1, 2, 3],但实际输出却是 [1, NaN, NaN]。原因在于 map 在执行时传递了三个参数:(element, index, array),而 parseInt 恰好接受两个参数:parseInt(string, radix)。在遍历过程中,index(0、1、2)被作为进制数传入:
- 第一轮:
parseInt('1', 0),基数为 0 时默认按 10 进制解析,结果为1; - 第二轮:
parseInt('2', 1),二进制系统无法识别字符 '2',返回NaN; - 第三轮:
parseInt('3', 2),二进制系统无法识别字符 '3',返回NaN。
正确写法应当明确包裹一层单参数调用:['1', '2', '3'].map(str => parseInt(str, 10)) 或 ['1', '2', '3'].map(Number)。
2. 自定义实现 myMap
实现符合规范的 myMap 需要处理三个技术细节:
- 防御检查:判断调用上下文
this是否有效,以及传入的回调是否为函数; - 稀疏数组(Sparse Array)处理:原数组可能存在空槽(如
[1, , 3]),规范要求跳过未赋值的索引; - 执行上下文支持:
map允许传入可选的thisArg,以指定回调执行时的this绑定。
Array.prototype.myMap = function(callback, thisArg) {
  // 1. 防御检查:this 必须为对象或数组
  if (this == null) {
    throw new TypeError("Array.prototype.myMap called on null or undefined");
  }
  // 2. 防御检查:callback 必须为可执行函数
  if (typeof callback !== "function") {
    throw new TypeError(callback + " is not a function");
  }

  // 3. 将 this 转为对象,并安全提取长度(遵循规范无符号右移转整型)
  const O = Object(this);
  const len = O.length >>> 0;
  const result = new Array(len);

  // 4. 遍历并构建新数组
  for (let i = 0; i < len; i++) {
    // 检查索引是否是对象本身的实际属性,跳过空槽
    if (i in O) {
      result[i] = callback.call(thisArg, O[i], i, O);
    }
  }

  return result;
};

// 验证测试
const numbers = [1, 2, 3];
const squared = numbers.myMap((x) => x * x);
console.log(squared); // [1, 4, 9]

// 稀疏数组测试
const sparse = [1, , 3];
console.log(sparse.myMap(x => x * 2)); // [2, 空槽, 6]
三、Array.prototype.filter 的使用与实现
1. 语义与实战用法
filter 的核心语义是条件过滤。它接收一个谓词函数(Predicate),根据回调返回结果的真假决定是否在结果数组中保留对应项。返回值为真值(Truthy)的元素被浅拷贝推入新数组,反之被丢弃。输出数组的长度始终小于或等于原始数组。
// 场景:在电商订单中筛选出待支付且未超时的有效订单
const orders = [
  { orderId: "A001", status: "UNPAID", isExpired: false, amount: 260 },
  { orderId: "A002", status: "PAID", isExpired: false, amount: 1200 },
  { orderId: "A003", status: "UNPAID", isExpired: true, amount: 50 },
  { orderId: "A004", status: "UNPAID", isExpired: false, amount: 890 }
];

const pendingOrders = orders.filter(order => order.status === "UNPAID" && !order.isExpired);
console.log(pendingOrders);
// 结果仅保留 A001 与 A004 两个订单对象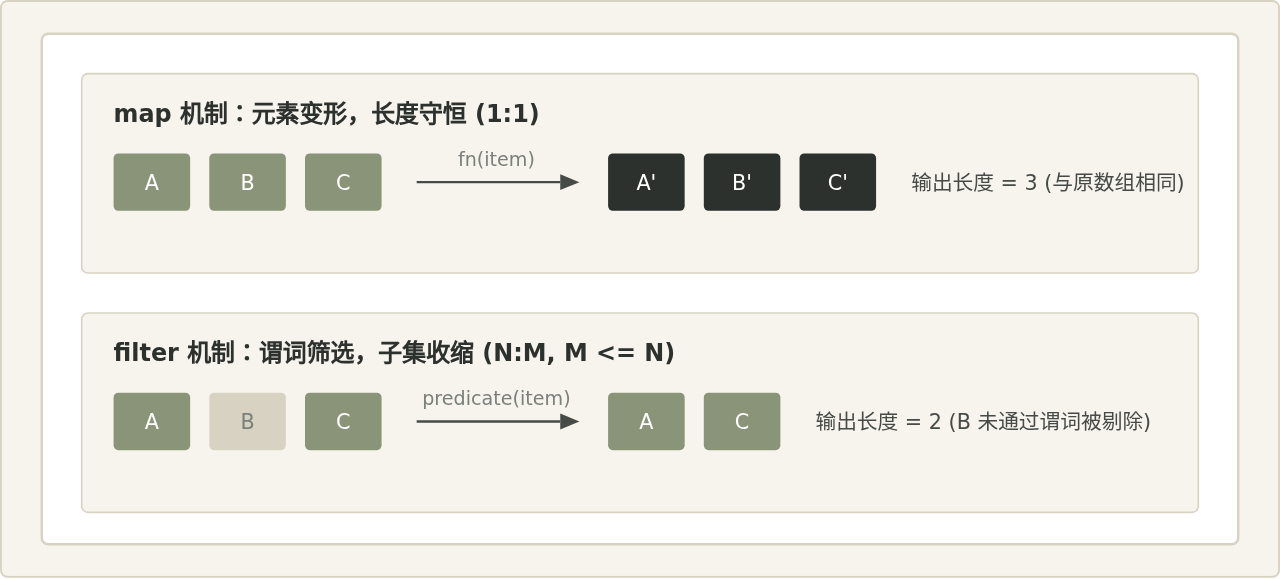
浅拷贝认知:修改 filter 产出的对象会污染原数组吗?
filter 内部创建了一个全新的数组容器,修改新数组本身的增删操作(如 push、pop)不会影响原数组。但是,新数组中存放的非原始类型元素仅仅是对原内存对象的引用拷贝。如果在过滤后的数组中直接修改对象的属性(如 pendingOrders[0].amount = 999),原数组中的同一对象也会发生改变。若需要彻底隔离副作用,应在过滤前或过滤后配合深拷贝进行处理。
2. 自定义实现 myFilter
Array.prototype.myFilter = function(callback, thisArg) {
  if (this == null) {
    throw new TypeError("Array.prototype.myFilter called on null or undefined");
  }
  if (typeof callback !== "function") {
    throw new TypeError(callback + " is not a function");
  }

  const O = Object(this);
  const len = O.length >>> 0;
  const result = [];

  for (let i = 0; i < len; i++) {
    if (i in O) {
      const element = O[i];
      // 检验回调执行结果的真假值,转换为布尔值判定
      if (callback.call(thisArg, element, i, O)) {
        result.push(element);
      }
    }
  }

  return result;
};

// 验证测试
const values = [10, 25, 30, 45, 5];
const greaterThan20 = values.myFilter(item => item > 20);
console.log(greaterThan20); // [25, 30, 45]
四、Array.prototype.reduce 的使用与深度实战
1. 语义与运作机制
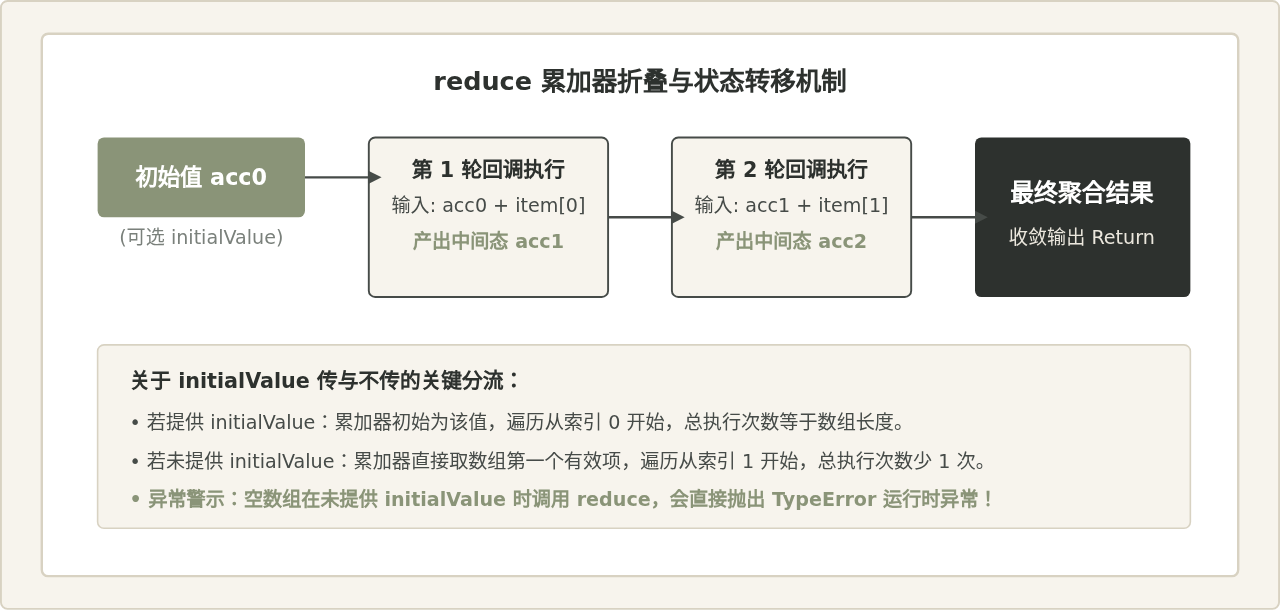
reduce 是数组方法中形态最为灵活的高阶函数,其核心语义是多对一折叠(Fold)。它将数组中的所有项逐步归纳为一个单一结果。这个结果不仅可以是数字或字符串,也可以是一个对象、嵌套 Map,甚至是另一个全新的数组。
reduce 接收两个参数:累加器回调函数 (accumulator, currentValue, currentIndex, array) 和可选的初始值 initialValue。其迭代状态流转遵循严格的交接规则:
2. 实战进阶:结构化分组与管道组合
除了常规的数值累加,reduce 更大的价值在于重构数据形态:
// 实战场景 1:按分类分组(模拟 groupBy)
const inventory = [
  { name: "苹果", type: "水果", quantity: 15 },
  { name: "芹菜", type: "蔬菜", quantity: 8 },
  { name: "香蕉", type: "水果", quantity: 20 },
  { name: "胡萝卜", type: "蔬菜", quantity: 12 }
];

const grouped = inventory.reduce((acc, item) => {
  const key = item.type;
  if (!acc[key]) {
    acc[key] = [];
  }
  acc[key].push(item);
  return acc;
}, {});

console.log(grouped);
// 输出按“水果”与“蔬菜”分类归总的对象结构
3. 自定义实现 myReduce
手写 reduce 的最大难点在于精准处理未传入 initialValue 时的起始索引寻找逻辑,必须在遇到稀疏数组时跳过空槽,定位到第一个真实存在的元素。
Array.prototype.myReduce = function(callback, initialValue) {
  if (this == null) {
    throw new TypeError("Array.prototype.myReduce called on null or undefined");
  }
  if (typeof callback !== "function") {
    throw new TypeError(callback + " is not a function");
  }

  const O = Object(this);
  const len = O.length >>> 0;
  let k = 0;
  let accumulator;

  // 1. 判断是否传入了 initialValue(判断实参个数)
  if (arguments.length >= 2) {
    accumulator = initialValue;
  } else {
    // 2. 未传 initialValue 时,寻找第一个实际存在的元素作为初始值
    let kPresent = false;
    while (k < len) {
      if (k in O) {
        accumulator = O[k];
        kPresent = true;
        k++;
        break;
      }
      k++;
    }
    // 3. 如果数组为空且没有初始值,按照 ECMAScript 规范抛出 TypeError
    if (!kPresent) {
      throw new TypeError("Reduce of empty array with no initial value");
    }
  }

  // 4. 从当前步进位置 k 继续迭代到末尾
  while (k < len) {
    if (k in O) {
      accumulator = callback(accumulator, O[k], k, O);
    }
    k++;
  }

  return accumulator;
};

// 验证测试
const sum = [1, 2, 3, 4].myReduce((acc, cur) => acc + cur, 0);
console.log(sum); // 10

// 稀疏数组与无初始值测试
const sparseList = [, 10, , 20];
const total = sparseList.myReduce((acc, cur) => acc + cur);
console.log(total); // 30
五、规范级自定义实现的推导与关键边界
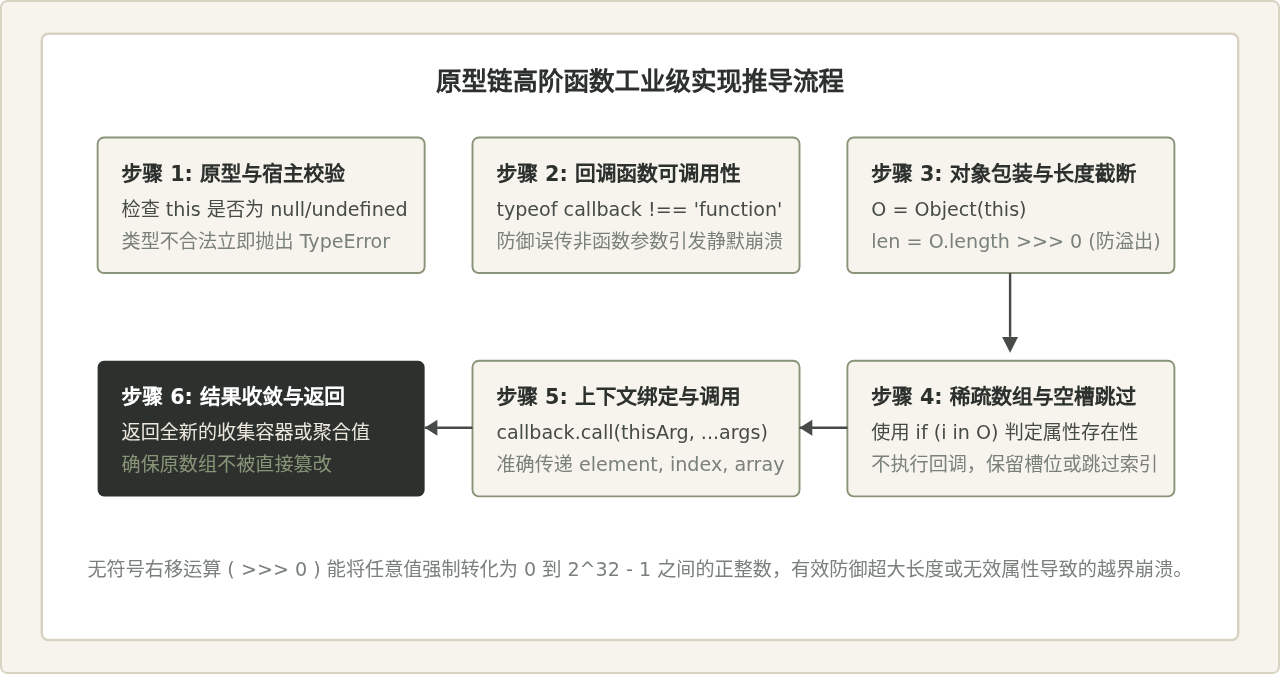
实现符合 ECMAScript 规范的原型扩展并非简单地写一个 for 循环,需要严格覆盖以下推导与执行步骤:
六、三大高阶函数选型对比与总结
在面对具体的业务场景时,选用哪一个高阶函数主要取决于输入与输出的关系模型:
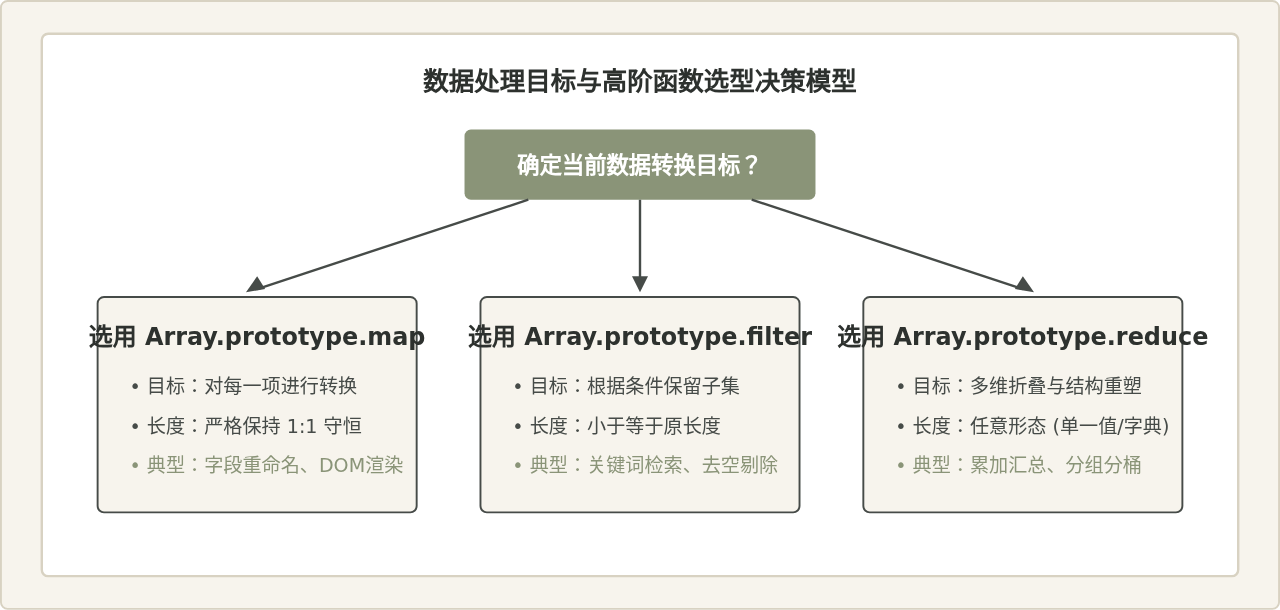
为了便于速查与系统梳理,以下表格总结了三者的核心特征:
| 方法名称 | 主要设计用途 | 返回值特征 | 空数组处理行为 | 是否修改原数组 |
|---|---|---|---|---|
map |
一对一数据结构转换与映射 | 与原数组等长的新数组 | 返回空数组 [] |
否(纯函数式映射) |
filter |
根据布尔谓词筛选符合项 | 长度小于等于原数组的新数组 | 返回空数组 [] |
否(浅拷贝保留项) |
reduce |
多对一累积计算或聚合重塑 | 单一累加值或重塑后的对象/数组 | 无初始值抛 TypeError,有初始值返回初始值 | 否(需注意累加器引用) |
在实际工程开发中,这三者经常链式组合使用,例如通过 filter 剔除无效数据、通过 map 格式化展示字段,最后通过 reduce 计算金额总和。通过深入理解它们的内部运行机制和边界细节,我们不仅能在日常业务中快速写出优雅直观的代码,在面试和底层技术考察中也能游刃有余地完成规范级的手写实现。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章