
深入讲解JavaScript中map、filter与reduce数组处理方法的核心原理与实战技巧,包含数据清洗、状态累加、分类分组及链式管道操作的完整代码实例与注意事项。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组常用方法实例:Map、Filter与Reduce的数据处理技巧
作者:青柠
时间:2026-10-30
浏览:586
文章目录
在日常的前端与全栈开发中,从服务端接口获取的数据很少能直接用于页面渲染或业务计算。对数组结构进行清洗、过滤、字段变形与多维聚合是最频繁的工作。JavaScript 提供了以 map、filter 和 reduce 为核心的高阶函数,它们不修改原数组、语义清晰且易于复合组装。本文通过清晰的心智模型、具体场景代码以及运行结果对比,系统梳理这三个方法的核心用法、组合技巧与性能边界。
一、Map:一对一的投影与结构映射
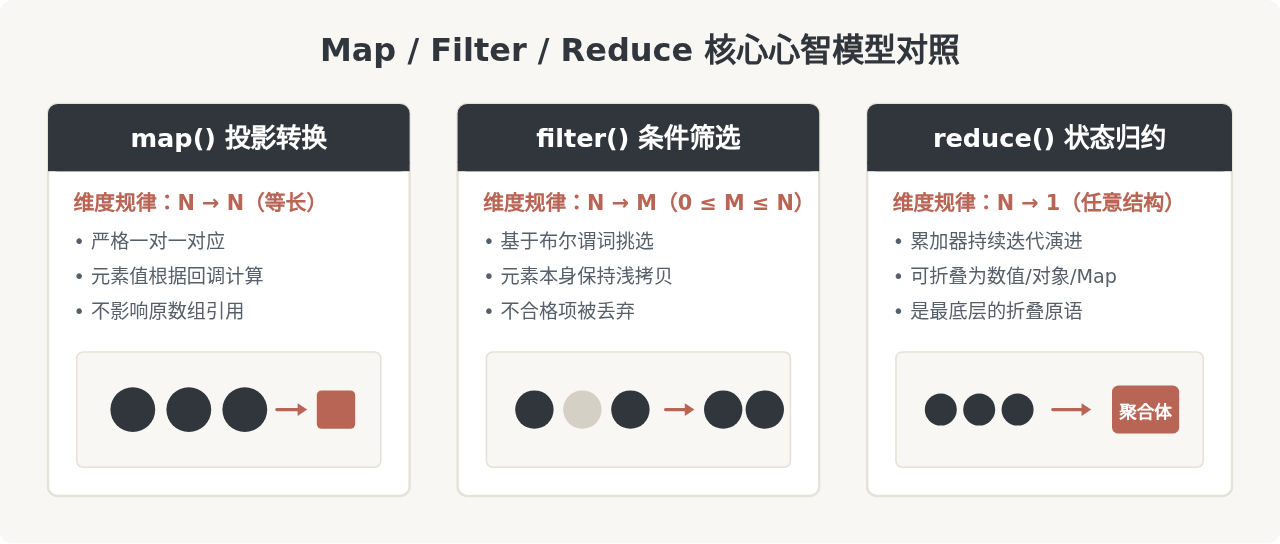
map 的核心语义是映射(Mapping)。它遍历原数组中的每一个元素,依次调用传入的回调函数,并将每次调用的返回值按原顺序组装成一个新数组返回。原数组长度与返回的新数组长度必定完全相同。
1. 基本语法与纯函数约定
// 语法结构
const newArray = arr.map(function callback(currentValue, index, array) {
  // 必须返回新元素
  return transformedValue;
}, thisArg);在函数式编程思想中,map 的回调函数应当保持为纯函数(Pure Function):只根据输入返回新值,不引起额外的副作用(例如不要在 map 内部直接修改外部变量或变更 currentValue 对象的属性)。
2. 实战场景:提取指定字段并重新塑形
从接口接收到用户列表时,通常包含许多不需要的字段。通过 map 可以直接投影出轻量级视图模型(ViewModel):
// 原始数据
const rawUsers = [
  { id: 101, firstName: "张", lastName: "伟", role: "admin", secretToken: "tok_991" },
  { id: 102, firstName: "李", lastName: "娜", role: "member", secretToken: "tok_992" },
  { id: 103, firstName: "王", lastName: "芳", role: "guest", secretToken: "tok_993" }
];

// 使用 map 提取 fullName 与脱敏展示信息
const userCards = rawUsers.map(user => ({
  userId: user.id,
  fullName: `${user.firstName}${user.lastName}`,
  isVip: user.role === "admin"
}));

console.log(userCards);
/* 示例输出:
[
  { userId: 101, fullName: '张伟', isVip: true },
  { userId: 102, fullName: '李娜', isVip: false },
  { userId: 103, fullName: '王芳', isVip: false }
]
*/
经典易错陷阱:parseInt 与 map 索引参数冲突
许多初学者会写出 ['1', '2', '3'].map(parseInt),却得到 [1, NaN, NaN]。原因在于 map 传给回调的第二个参数是当前元素索引 index,而 parseInt(string, radix) 的第二个参数表示进制基数:
- 第一轮:
parseInt('1', 0),基数为 0 时默认按十进制解析,返回1; - 第二轮:
parseInt('2', 1),一进制中不可能出现数字 2,返回NaN; - 第三轮:
parseInt('3', 2),二进制中不可能出现数字 3,返回NaN。
正确写法:显式声明单参数函数,如 ['1', '2', '3'].map(num => parseInt(num, 10)) 或 ['1', '2', '3'].map(Number)。
二、Filter:基于条件的纯净筛选
filter 的核心语义是过滤(Filtering)。它会对原数组中的每一项执行给定的谓词函数(Predicate)。若该函数返回真值(Truthly),则该项被收录到新数组中;若返回假值(Falsely),则丢弃。结果数组的长度满足 0 <= length <= 原数组长度。
1. 基本语法
const filteredArray = arr.filter(function predicate(currentValue, index, array) {
  // 返回 true 则保留,返回 false 则舍弃
  return booleanCondition;
});
2. 实战场景:复合条件过滤与空值清洗
在表单查询或商城筛选中,需要剔除缺货商品或下架商品,同时过滤掉输入中的无效空值:
// 场景 1:过滤无效假值(0、空字符串、null、undefined)
const mixedInputs = ["Vue", "", null, "React", undefined, "Angular", false];
const validFrameworks = mixedInputs.filter(Boolean);

console.log(validFrameworks);
// 示例输出: ['Vue', 'React', 'Angular']

// 场景 2:电商列表多维度业务筛选
const products = [
  { id: 'P1', name: '无线鼠标', price: 89, inStock: true, rating: 4.8 },
  { id: 'P2', name: '机械键盘', price: 299, inStock: false, rating: 4.9 },
  { id: 'P3', name: '显示器支架', price: 159, inStock: true, rating: 4.2 },
  { id: 'P4', name: 'Type-C扩展坞', price: 129, inStock: true, rating: 4.6 }
];

// 条件:必须有货,且评分不低于 4.5
const recommendedProducts = products.filter(item => item.inStock && item.rating >= 4.5);

console.log(recommendedProducts);
/* 示例输出:
[
  { id: 'P1', name: '无线鼠标', price: 89, inStock: true, rating: 4.8 },
  { id: 'P4', name: 'Type-C扩展坞', price: 129, inStock: true, rating: 4.6 }
]
*/注意引用保持问题:filter 创建的是浅拷贝(Shallow Copy)。新数组里保存的对象引用依然指向原有内存地址。如果后续直接改动了新数组中的对象属性,原数组内部的对象也会同步发生改变。
三、Reduce:多维聚合与万能折叠器
reduce 是 JavaScript 数组中最强大、最灵活的高阶函数。它的本质是折叠(Folding / Accumulation):将一个集合通过迭代归约成一个最终值。这个“最终值”可以是数字、字符串、单个对象、另一个数组,甚至是 Map 或 Set 数据结构。
1. 运行机理与执行参数
const result = arr.reduce((accumulator, currentValue, currentIndex, array) => {
  // 返回的值将作为下一轮迭代的 accumulator
  return nextAccumulator;
}, initialValue);
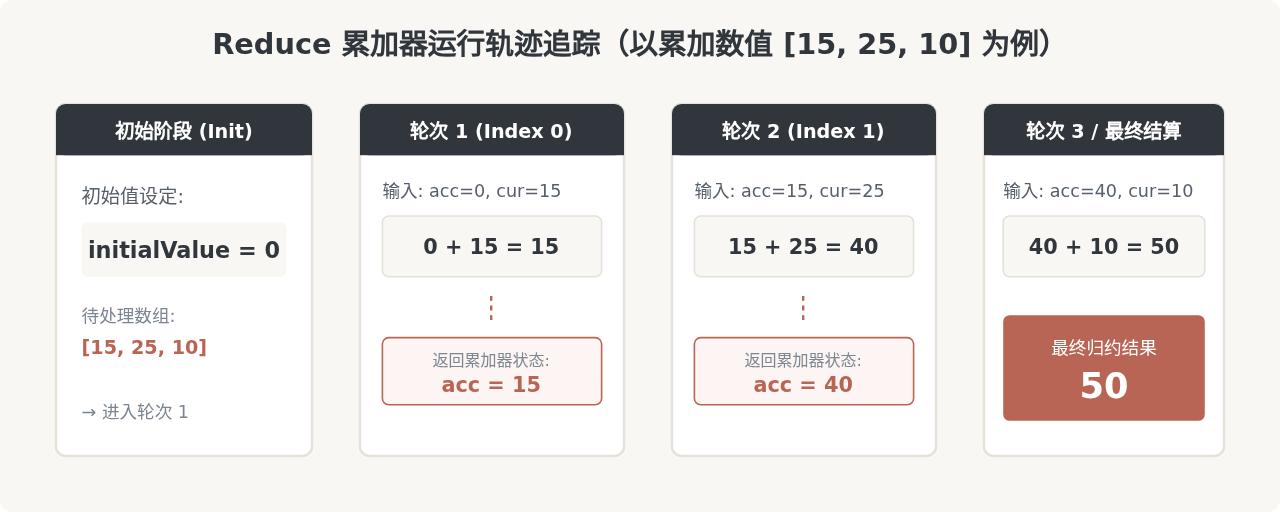
理解 reduce 的关键在于明确累加器(accumulator)的状态转移。如果没有提供 initialValue,数组将以第一个元素作为初始值,迭代从第二个元素(索引 1)开始;如果提供了 initialValue,迭代将从第一个元素(索引 0)开始,初始累加器即为该值。
核心忠告:永远明确显式提供 initialValue
如果对一个空数组 [] 调用不带初始值的 reduce,JavaScript 引擎会立即抛出运行时错误:TypeError: Reduce of empty array with no initial value。显式指定 initialValue(如 0 或 {})不仅能保证空数组时不抛错,还能让代码的类型意图一目了然。
2. 实战技巧一:按指定分类属性实现 GroupBy 分组
在 ES2024 的 Object.groupBy 广泛普及之前,reduce 一直是实现数据分组的业界标准模式:
const staff = [
  { name: '王敏', department: '技术部', city: '北京' },
  { name: '刘洋', department: '市场部', city: '上海' },
  { name: '陈晨', department: '技术部', city: '杭州' },
  { name: '赵静', department: '运营部', city: '北京' },
  { name: '周博', department: '技术部', city: '北京' }
];

// 按照部门聚合
const groupedByDept = staff.reduce((acc, person) => {
  const dept = person.department;
  // 若当前部门分组尚未初始化,则建置空数组
  if (!acc[dept]) {
    acc[dept] = [];
  }
  acc[dept].push(person);
  return acc;
}, {});

console.log(groupedByDept);
/* 示例输出:
{
  '技术部': [
    { name: '王敏', department: '技术部', city: '北京' },
    { name: '陈晨', department: '技术部', city: '杭州' },
    { name: '周博', department: '技术部', city: '北京' }
  ],
  '市场部': [ { name: '刘洋', department: '市场部', city: '上海' } ],
  '运营部': [ { name: '赵静', department: '运营部', city: '北京' } ]
}
*/
3. 实战技巧二:统计词频与频次分布(Frequency Counter)
const tags = ['JavaScript', 'Vue', 'React', 'JavaScript', 'TypeScript', 'React', 'JavaScript'];

const tagCounts = tags.reduce((counts, tag) => {
  counts[tag] = (counts[tag] || 0) + 1;
  return counts;
}, {});

console.log(tagCounts);
// 示例输出: { JavaScript: 3, Vue: 1, React: 2, TypeScript: 1 }
四、综合实战:构建流畅的数据转换管道
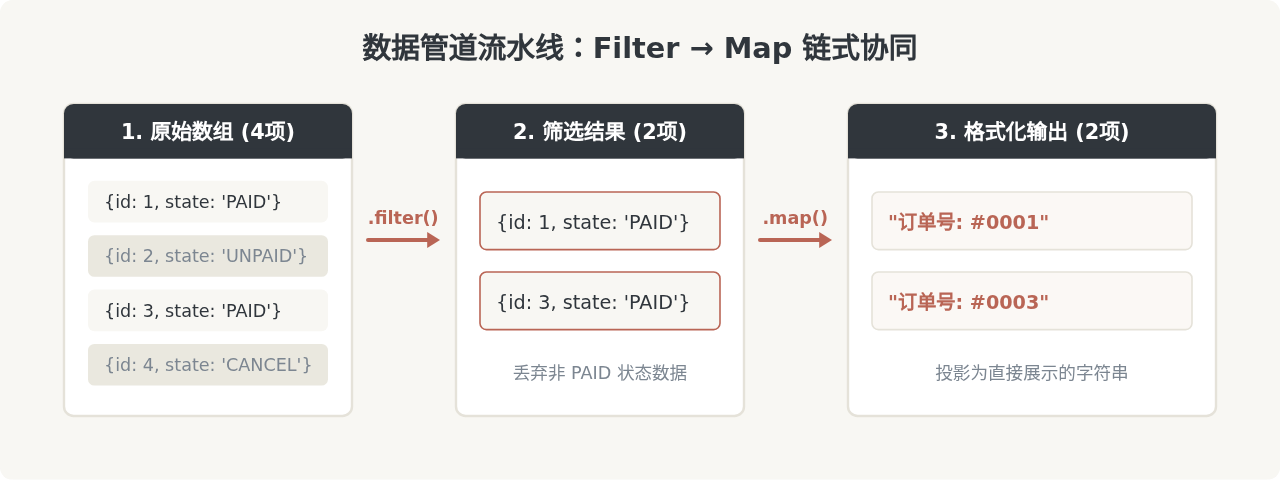
在现实项目中,单一方法往往无法独自解决复杂的报表需求。将 filter、map、reduce 串联形成函数式数据处理流水线,能使代码逻辑像声明式 SQL 一样清晰。
业务案例:在线商城订单收益与品类统计
需求:给出一段原始订单记录列表,需要完成:
- 剔除所有状态为
CANCELLED(已取消)的异常订单; - 为每笔有效订单计算实际支付金额(单价 × 数量 × 折扣系数);
- 汇总所有有效订单的营业额总和,并统计各品类销售的商品总件数。
const orderList = [
  { id: 'OD1', category: '数码', price: 1200, count: 2, discount: 0.9, status: 'COMPLETED' },
  { id: 'OD2', category: '日化', price: 45, count: 4, discount: 1.0, status: 'CANCELLED' },
  { id: 'OD3', category: '图书', price: 80, count: 3, discount: 0.8, status: 'COMPLETED' },
  { id: 'OD4', category: '数码', price: 350, count: 1, discount: 0.95, status: 'COMPLETED' },
  { id: 'OD5', category: '日化', price: 60, count: 2, discount: 1.0, status: 'PENDING' }
];

// 1. 过滤:只统计完成履约的订单
const validOrders = orderList.filter(o => o.status === 'COMPLETED');

// 2. 映射与归约复合:一次性产出总金额与品类销量透视表
const financialSummary = validOrders.reduce((report, order) => {
  const actualAmount = order.price * order.count * order.discount;

  // 累加总销售额
  report.totalRevenue += actualAmount;

  // 累加各品类售出件数
  report.categoryCounts[order.category] = (report.categoryCounts[order.category] || 0) + order.count;

  return report;
}, {
  totalRevenue: 0,
  categoryCounts: {}
});

console.log('财务总报表:', financialSummary);
/* 示例输出:
财务总报表: {
  totalRevenue: 2684.5,
  categoryCounts: {
    '数码': 3,
    '图书': 3
  }
}
*/
链式调用(Chaining)的性能权衡
诸如 list.filter(...).map(...).reduce(...) 的链式调用极具可读性,但在应对十万级别以上的巨量数据时需要注意性能影响:
- 内存开销:每一个链式环节都会分配一个中间状态的新数组(例如
filter产出数组后传递给map),如果原数组极大,会显著加剧垃圾回收(GC)的负担。 - 遍历次数:3 次链式调用意味着执行 3 轮循环。如果性能成为瓶颈,可以将过滤和投影整合在单次
reduce或普通的for...of循环中一次性完成。
五、方法选型决策与快速自查
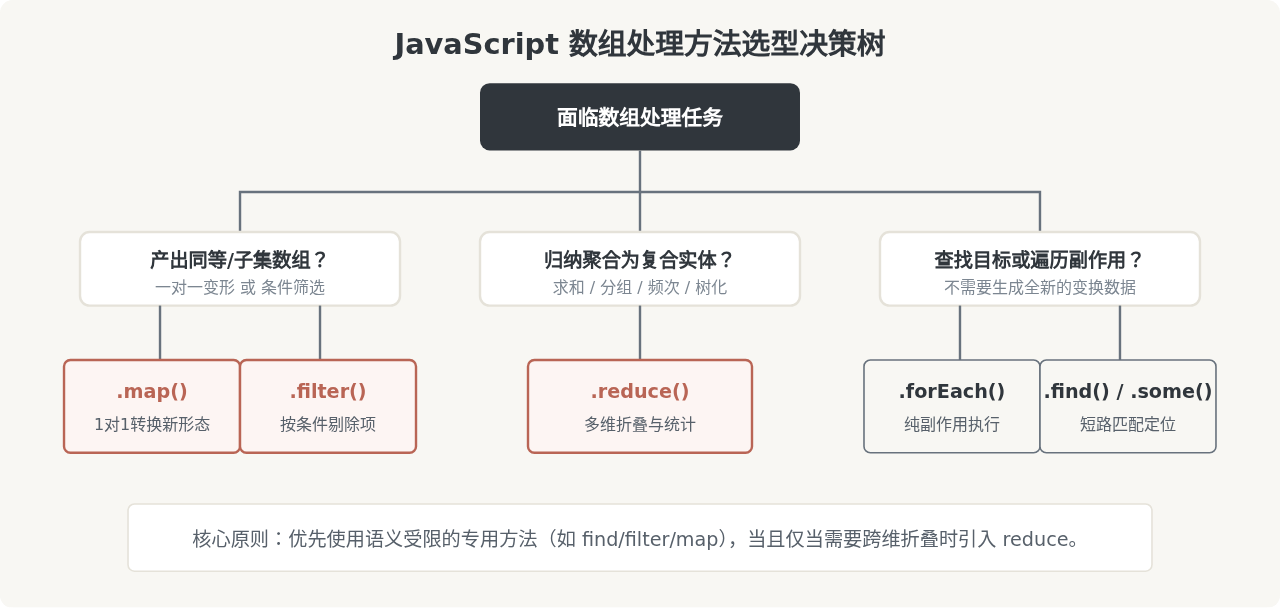
在面对具体的数组处理任务时,可以根据以下决策树选择语义最精准的方法,避免误用。
核心特性速查表
| 方法 | 输出结果 | 是否修改原数组 | 空数组行为 | 典型应用场景 |
|---|---|---|---|---|
map() |
与原数组等长的新数组 | 否 | 返回 [] |
字段提取、单位换算、视图对象包装 |
filter() |
长度 ≤ 原数组的新数组 | 否 | 返回 [] |
状态过滤、白名单校验、空值清理 |
reduce() |
单一累加值(数值/对象/数组等) | 否 | 若未给初始值则抛 TypeError | 总量计算、分组(GroupBy)、扁平化、频次统计 |
forEach() |
undefined |
否(除非内部修改) | 静默跳过 | 发送打点、更新外部状态、DOM 更新 |
总结
掌握 map、filter 和 reduce 的核心在于建立清晰的数据流意识:
- 使用
map时,关注结构投影,保持纯函数无副作用; - 使用
filter时,关注真值条件,注意其浅拷贝机制对嵌套对象的影响; - 使用
reduce时,始终显式提供初始值,把控每一轮迭代中累加器的状态迁移。
在日常开发中,结合具体业务规模合理运用这三项利器,既能保证代码简洁优雅与声明式可读性,又能有效防范运行时边界异常。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章