
深入对比Ramda与Lodash/fp在设计哲学、参数顺序、自动柯里化、透镜系统及打包体积上的差异,提供明确的JavaScript函数式编程库选型依据与落地方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
Ramda与Lodash/fp对比:JS函数式编程库怎么选
作者:青柠
时间:2026-10-30
浏览:132
文章目录
核心选型结论:如果你是在既有的大型业务工程中渐进式引入函数式特性,或者团队成员普遍对常规 Lodash API 较为熟悉,且希望零成本复用工程内已有的 Lodash 缓存与工具链,Lodash/fp 是心智阻力最小的平滑演进选择;如果你的项目从立项起就推崇纯正的函数式编程范式、依赖深层不可变更新(如 Lens 透镜系统)、重视严格的柯里化与数学意义上的 Pointfree 组合,Ramda 则是更彻底、扩展能力更完备的首选基石。
一、设计哲学:原生纯粹 vs 封装转换
JavaScript 作为多范式语言,其原生 Array 原型方法(如 map、filter、reduce)在函数式表达上存在天然限制:方法挂载在数据实例上,导致无法脱离上下文自由组合;回调参数通常包含数据、索引与数组本身,容易引发意料之外的隐式副作用。为了解决这一痛点,函数式工具库应运而生,但 Ramda 与 Lodash/fp 在诞生初期的定位存在本质区别。
Ramda 的核心定位是“原生函数式(Native FP)”。它从第一行代码开始,就是为了支持无偏见的纯函数式开发模式构建的。Ramda 的所有公开函数默认自带柯里化(Curry),严格遵循“数据后置(Data-last)”原则,即操作目标数据永远排在参数列表的最末尾。此外,Ramda 强调不变性保证,杜绝就地变更原始输入,并内置了完备的代数类型与透镜系统。
Lodash/fp 则是“命令式工具的函数式包装器”。它的代码并非完全独立手写,而是通过对标准版 Lodash 进行元编程重包装(Curry wrapper & Rearg wrapper)生成的子模块。Lodash 官方通过自动化脚本,将原版“数据优先(Data-first)”的方法倒置为“数据后置”,并将多参数方法包裹为柯里化形式。这使得 Lodash/fp 能与 Lodash 生态共享内核代码,但也带来了一系列封装层特有的副作用。
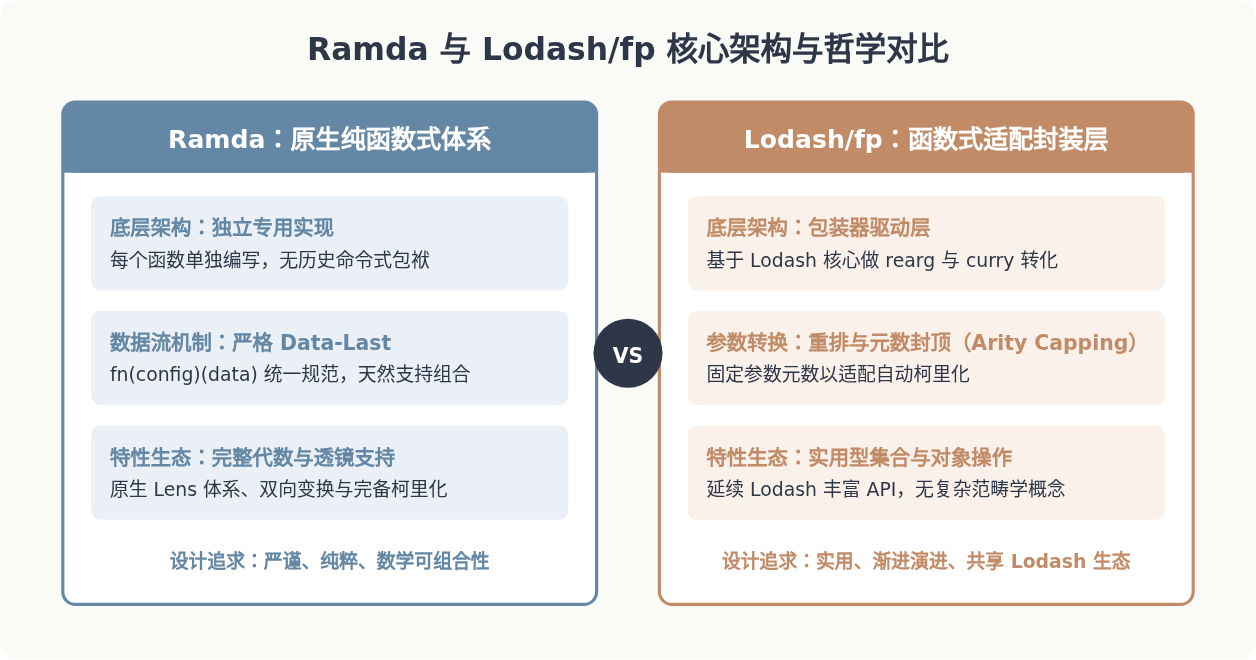
图 1:Ramda 与 Lodash/fp 核心架构与设计哲学对比
二、核心机制对比:柯里化、流水线与元数限制
为了能够将多个小函数像积木一样拼接起来,函数库必须解决两个核心问题:函数的参数何时能够拆解提供(柯里化),以及数据如何依次流经每一个函数(流水线)。
1. 管道组合:R.pipe vs fp.flow
在处理数据流动时,两者都支持从左至右的函数流管道。在 Ramda 中使用 R.pipe,在 Lodash/fp 中使用 fp.flow。
// 业务需求:筛选已付款订单,计算每个订单含税价格(税率10%),最后计算总金额
import * as R from 'ramda';
import fp from 'lodash/fp';

const orders = [
  { id: 101, paid: true, amount: 100 },
  { id: 102, paid: false, amount: 250 },
  { id: 103, paid: true, amount: 200 }
];

// 1. Ramda 风格实现(Pointfree:无显式参数引用)
const calculateTotalRamda = R.pipe(
  R.filter(R.propEq(true, 'paid')),
  R.map(R.pipe(R.prop('amount'), R.multiply(1.1))),
  R.sum
);

console.log(calculateTotalRamda(orders)); // 输出: 330

// 2. Lodash/fp 风格实现
const calculateTotalFP = fp.flow([
  fp.filter({ paid: true }),
  fp.map(order => order.amount * 1.1),
  fp.sum
]);

console.log(calculateTotalFP(orders)); // 输出: 330
2. 柯里化机制与元数限制(Arity Capping)陷阱
自动柯里化要求预先知道函数接受多少个参数。JavaScript 允许传入不定参数,这在柯里化时引发了难题。
在原始 Lodash 中,为了方便,很多迭代函数的回调会传入多个参数(如 iteratee(value, index, collection))。如果在函数式组合中直接保留这些参数,像 fp.map(parseInt) 就会像原生 JavaScript 一样变成 parseInt(value, index),导致基数错误。
Lodash/fp 的解决方案是强制截断元数(Capping Arity)。绝大部分集合操作的回调函数在 Lodash/fp 中被强制限制为只接收 1 个参数。虽然这避免了 parseInt 陷阱,但也带来限制:如果你确实需要在 map 过程中获取当前索引(Index),fp.map 无法直接提供,你必须显式改用 fp.map.convert({ cap: false }) 或 fp.addIndex。
相比之下,Ramda 从设计上就坚持“回调只接收最纯粹必要的数据”。如果需要索引,Ramda 提供了显式的增强包装器 R.addIndex,语义清晰且不依赖隐藏的内部全局状态。
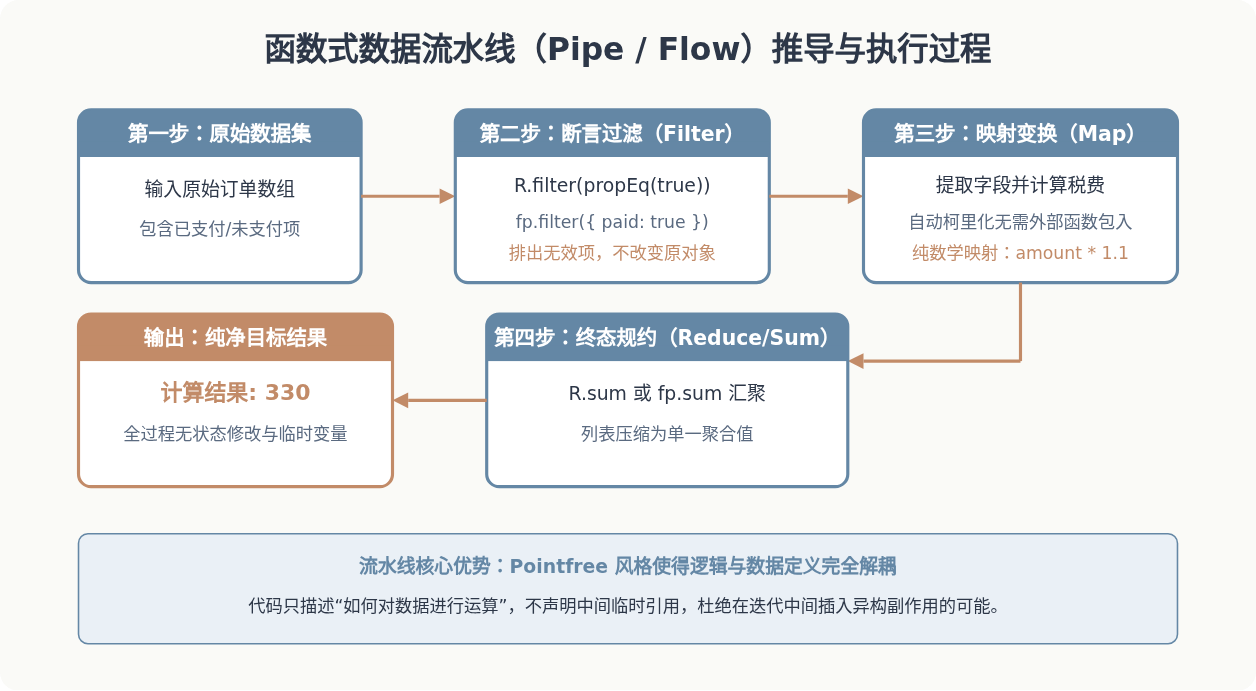
图 2:函数式数据流水线(Pipe / Flow)推导与执行过程
三、高级特性分野:透镜系统(Lens)与不可变更新
在现代前端或复杂状态管理中,深层嵌套对象的读取与不可变更新是频率最高的操作之一。这里展现了 Ramda 与 Lodash/fp 最大的一道技术鸿沟。
1. Ramda 的透镜系统(Lens)
透镜(Lens)是函数式编程中专门解决深层数据读写难题的代数工具。它可以将对象的某个嵌套路径抽象为一个一等公民的“透镜对象”,并提供三种核心能力:view(读取)、set(更新赋值并返回新对象)、over(应用变换函数并返回新对象)。
import * as R from 'ramda';

const state = {
  user: {
    profile: {
      name: 'alice',
      preferences: { theme: 'light' }
    }
  }
};

// 1. 定义透镜路径
const nameLens = R.lensPath(['user', 'profile', 'name']);

// 2. 读取属性
console.log(R.view(nameLens, state)); // 'alice'

// 3. 赋值更新(生成全新不可变副本,原 state 完全未动)
const updatedState = R.set(nameLens, 'bob', state);

// 4. 应用函数变换(转大写)
const upperState = R.over(nameLens, R.toUpper, state);
console.log(upperState.user.profile.name); // 'ALICE'
透镜的核心优势在于可组合性。两个透镜可以通过标准的 R.compose 进行复合。例如一个用于定位用户的透镜与一个用于定位偏好设置的透镜,组合后就是一个直接定位用户偏好的复合透镜,这在复杂表单与富数据模型下具有无与伦比的优雅度。
2. Lodash/fp 的路径更新方式
Lodash/fp 并不包含透镜的概念。它采用命令式工具库常见的路径字符串方式,通过 fp.get、fp.set 和 fp.update 来操作:
import fp from 'lodash/fp';

const state = {
  user: {
    profile: {
      name: 'alice'
    }
  }
};

// 读取
const name = fp.get('user.profile.name')(state);

// 赋值
const updatedState = fp.set('user.profile.name', 'bob')(state);

// 变换
const upperState = fp.update('user.profile.name', fp.toUpper)(state);
Lodash/fp 的字符串路径方案学习门槛极低,对新手非常直观。但它的局限也很明显:路径只是无逻辑能力的纯字符串,无法进行函数级别的代数组合与双向映射转换,在面对高阶复杂数据模型时后劲不足。
四、技术选型决策树与落地建议
在真实团队研发中,技术选型不仅取决于技术纯粹性,更受到工程既有条件、团队技能模型和打包维护成本的多维制约。
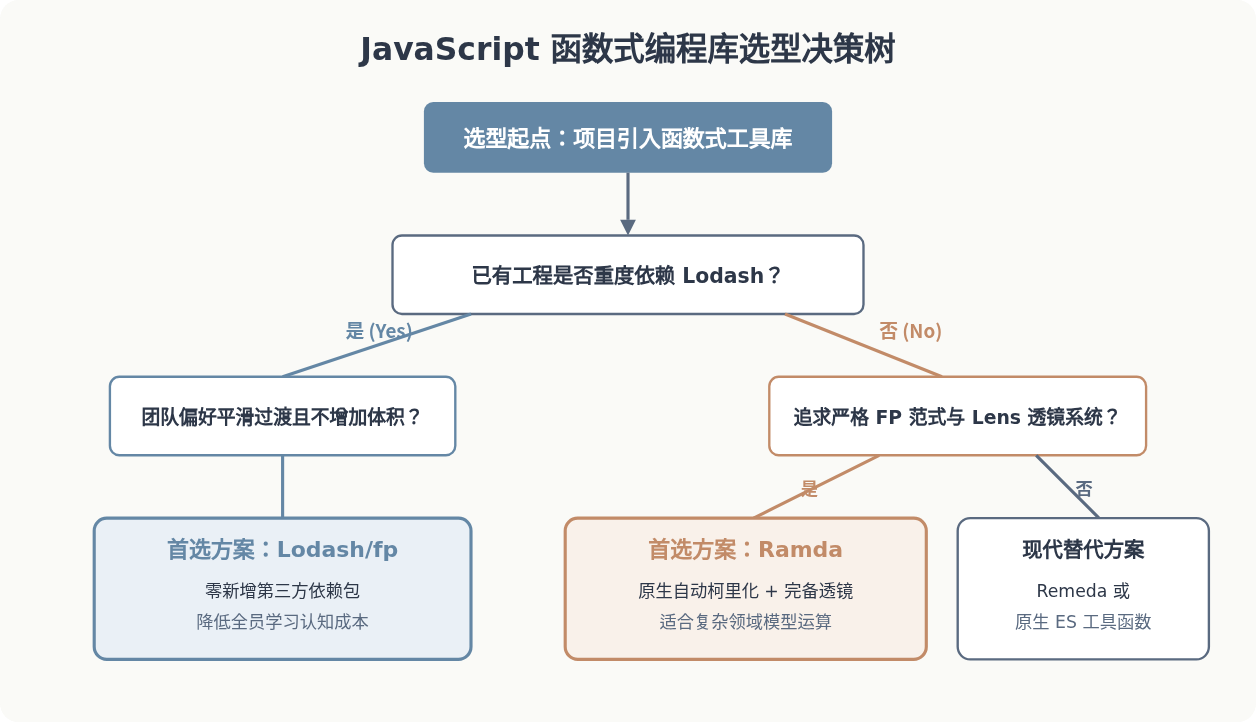
图 3:JavaScript 函数式编程库选型决策树
1. 什么时候坚决选择 Lodash/fp?
- 已有大型项目平滑迁移:如果你的项目已经在
package.json中引入了lodash,使用lodash/fp不需要添加任何额外依赖,打包体积增量几乎为零。 - 团队技术背景多元:团队中有大量初中级工程师或对函数式概念并不熟悉的成员,使用 Lodash/fp 能让他们在不被高深范畴学术语劝退的前提下,快速掌握管道化(Flow)编程的好处。
- 需要庞大的实用工具函数集:Lodash 积累了大量如正则转义、随机数、去抖节流(debounce/throttle)、数字 clamp 等实用方法,这些是专注纯函数的 Ramda 不提供的。
2. 什么时候果断选择 Ramda?
- 重度数据管道与领域驱动设计:如果业务模块需要大量复杂组合逻辑、复杂状态更新(如复杂表单引擎、可视化编辑器内部模型),Ramda 的 Lens 和严格 Pointfree 风格能显著降低逻辑分支 bug。
- 追求严格的纯函数规范:你不希望框架内部对回调做隐式截断,希望函数组合满足数学上的结合律与透明度。
- 架构层面对不变性有强一致要求:Ramda 在各种边界情况下对不变性的保护比封装版的 Lodash/fp 更为严密。
五、特性维度对比与总结
为了在团队评审与技术架构选型时提供清晰的横向比对依据,下表与全景图梳理了两者的核心差异点:
| 比对维度 | Ramda | Lodash/fp |
|---|---|---|
| 设计基石 | 原生纯函数式设计,零历史包袱 | Lodash 包装层转换,依赖命令式内核 |
| 默认参数顺序 | 数据后置(Data-last),适合管道流动 | 数据后置(通过 Rearg 自动翻转原版参序) |
| 自动柯里化 | 原生自动柯里化,支持动态传参 | 固定元数柯里化(截断为固定入参数量) |
| 透镜系统(Lens) | 原生完整支持(view / set / over / lensPath) | 无透镜支持,仅提供基础 set/update 字符串路径 |
| 非核心实用工具 | 少(专注纯函数变换,不提供 debounce 等) | 极丰富(继承 Lodash 全量实用工具生态) |
| 学习曲线 | 较高(需要理解代数思维与函数式组合) | 平缓(Lodash 用户仅需适应参数倒置与 flow) |
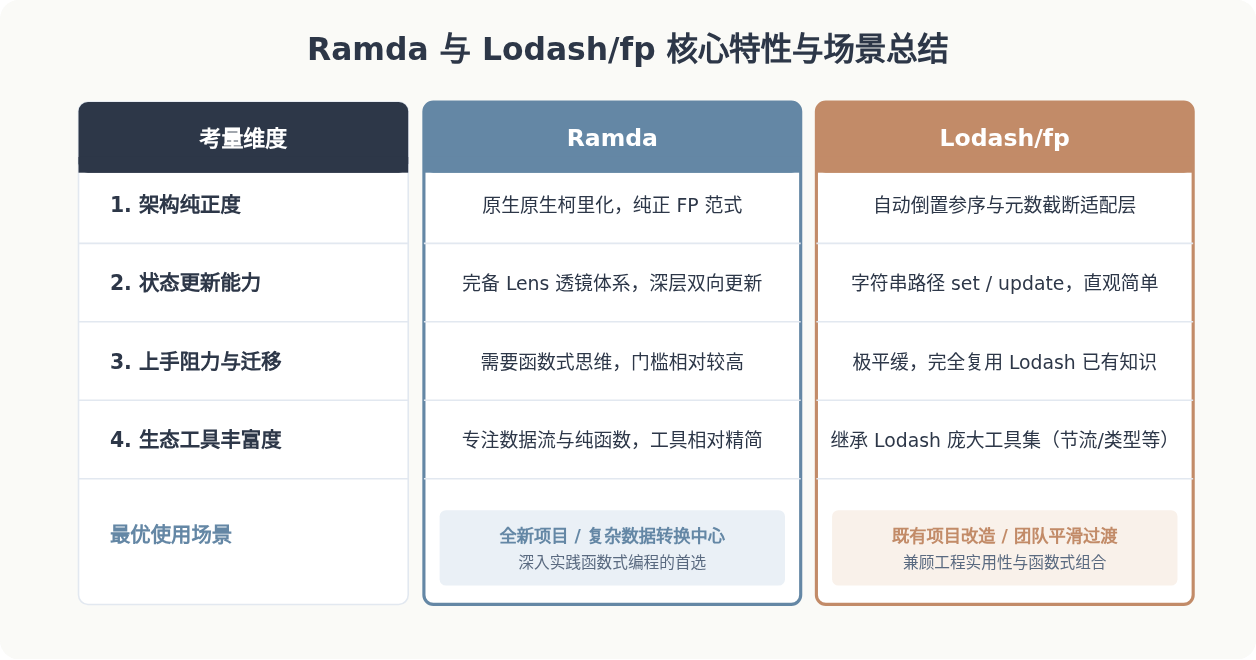
图 4:Ramda 与 Lodash/fp 核心特性与场景总结全景图
注意事项与避坑指南:
在现代使用 Webpack、Vite 或 Rollup 构建前端应用时,若使用 Lodash/fp,请确保配置好
babel-plugin-lodash 或按需引入模块(如 import map from 'lodash/fp/map'),以避免整包打包导致体积膨胀;而 Ramda 从 0.25+ 起已良好支持 ESM Tree-shaking,直接使用具名引入即可享受较好的死代码消除效果。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章