

深入解析前端JavaScript触发文件下载时文件名无法自定义重命名或中文乱码的底层原因,提供Fetch与Blob转换、Content-Disposition响应头规范及全套排查修复方案。
解决JS下载文件时文件名乱码或无法重命名问题
作者:键盘侠
时间:2026-10-30
浏览:486
文章目录
前端通过 JavaScript 触发文件下载时,文件名无法自定义重命名(强制使用原链接名称或随机字符)以及文件名包含中文时出现乱码(形如 %E6%B5%8B%E8%AF%95 或未知字符),是两类最常见且容易混淆的故障。解决这两个问题的核心路径非常明确:无法重命名通常由浏览器的跨域同源安全策略限制所致,需转换为本地同源 Blob 对象触发;而文件名乱码则源于 HTTP 响应头字符编码协议不匹配,需遵循 RFC 5987 标准并在前端进行安全解码。
一、为什么 a[download] 会重命名失效
很多开发者在实现前端文件下载时,第一反应是构造一个虚拟的 <a> 标签并触发点击事件:
const a = document.createElement('a');
a.href = 'https://oss.example.com/files/report_20261024.pdf';
a.download = '2026年第四季度分析报告.pdf';
document.body.appendChild(a);
a.click();
document.body.removeChild(a);
在实际运行时,读者常会发现 download 属性设置的自定义文件名完全被忽略,下载下来的文件仍然是 report_20261024.pdf 甚至是服务器接口的临时名字。这并不是代码写法错误,而是现代浏览器规范中的强制安全约束。
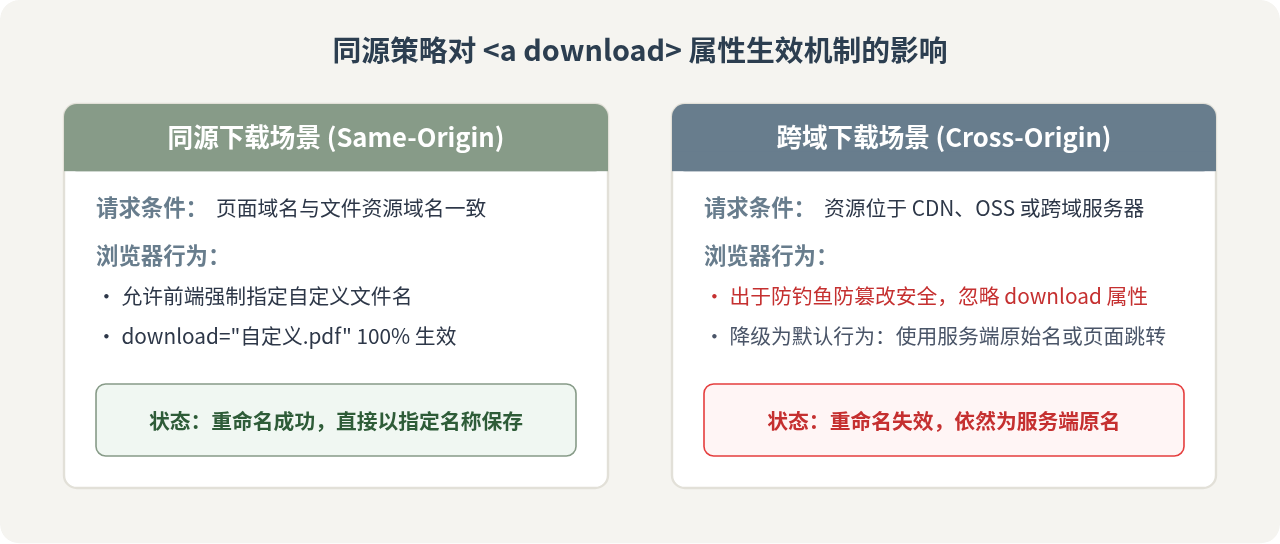
HTML5 规范明确指明:当资源 URL 与当前站点不同源(协议、域名或端口任一不同)时,出于防钓鱼软件和文件混淆攻击的安全考量,浏览器会直接忽略 download 属性的赋值,转而降级为默认导航或依赖响应头中的文件名。因此,只要资源存储在 CDN、对象存储(如阿里云 OSS、腾讯云 COS)或独立附件域名上,直接赋值 a.download 就无法改变下载文件名。
二、通过 Fetch + Blob 实现跨域重命名
要绕过跨域下 download 属性被忽略的限制,标准且有效的解决思路是:先将远程文件以数据流的形式拉取到前端内存中,生成一个本源上下文内的临时 Blob 对象,再触发下载。
因为由 URL.createObjectURL(blob) 生成的 blob:http://... 协议 URL 归属于当前前端页面的 Origin,浏览器将其判定为完全同源资源,此时 download 属性便能 100% 生效。
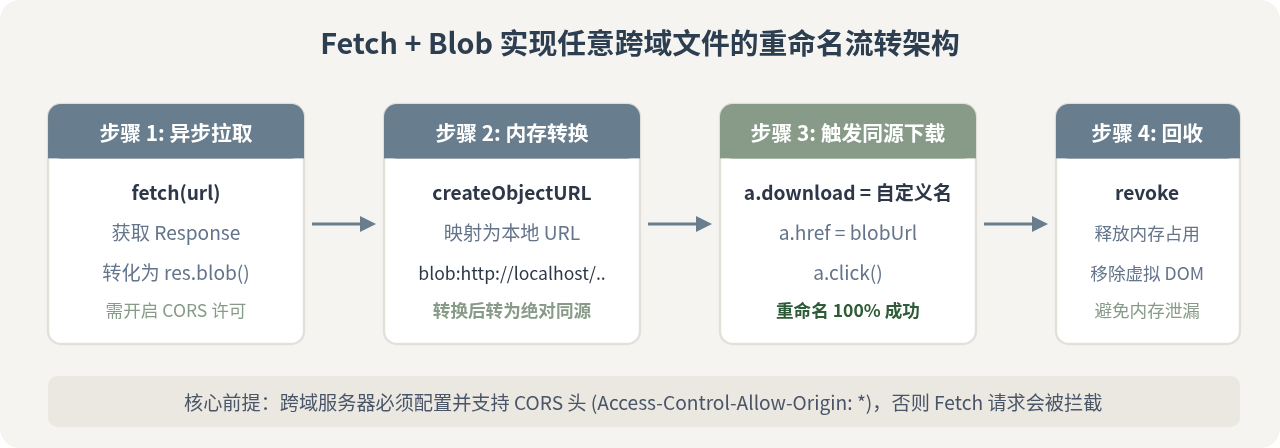
完整实现代码与封装示例
下面是一个经过实际生产验证的前端安全下载函数,包含了请求、Blob 转化、DOM 触发与内存回收机制:
/**
 * 跨域安全下载并重命名文件
 * @param {string} fileUrl 目标文件真实URL或接口地址
 * @param {string} customFileName 期望保存的文件名(含后缀)
 */
async function downloadFileWithRename(fileUrl, customFileName) {
  try {
    // 1. 发起网络请求获取原始二进制流
    const response = await fetch(fileUrl, {
      method: 'GET',
      mode: 'cors', // 确保以跨域安全模式请求
    });

    if (!response.ok) {
      throw new Error(`下载失败,服务器返回状态码: ${response.status}`);
    }

    // 2. 转换为 Blob 对象
    const blob = await response.blob();

    // 3. 创建临时同源指向 URL
    const blobUrl = window.URL.createObjectURL(blob);

    // 4. 创建虚拟 a 标签并配置
    const link = document.createElement('a');
    link.style.display = 'none';
    link.href = blobUrl;
    link.download = customFileName; // 此处由于同源,必定生效

    document.body.appendChild(link);
    link.click();

    // 5. 延迟清理内存和 DOM 节点
    setTimeout(() => {
      document.body.removeChild(link);
      window.URL.revokeObjectURL(blobUrl);
    }, 150);

  } catch (err) {
    console.error('文件下载发生异常:', err);
    throw err;
  }
}
重点注意:URL.revokeObjectURL 的时机
生成 Blob URL 后,浏览器会在内存中一直维系对该数据的引用。如果不调用 URL.revokeObjectURL(blobUrl),频繁下载大文件会导致严重的内存泄露。但切忌在 link.click() 后立即同步调用销毁,因为部分浏览器(如 Safari)在派发点击事件时尚未完成底层文件系统句柄初始化,过早销毁会导致下载内容为空或报错。使用 100~200ms 的微延迟是兼顾兼容性与内存安全的最佳实践。
三、中文文件名乱码的根源与 RFC 5987 规范
如果文件的重命名需求依赖于服务器接口返回(例如在导出 Excel 表格或动态报表时由后端决定文件名),前端经常会遇到文件名变成 _______.xlsx、æµè¯.xlsx 或 %E6%B5%8B%E8%AF%95.xlsx 的情况。
该问题的本质是 HTTP 报文头的编码历史缺陷:早期 HTTP 规范定义头字段仅支持 ISO-8859-1(单字节编码)。当服务端在 Content-Disposition 中直接写入 UTF-8 的中文字符时,传输过程中会被截断或错误转义。为了彻底解决国际化字符问题,IETF 推出了 RFC 5987 / RFC 6266 标准,规定使用 filename* 字段显式标记编码格式。
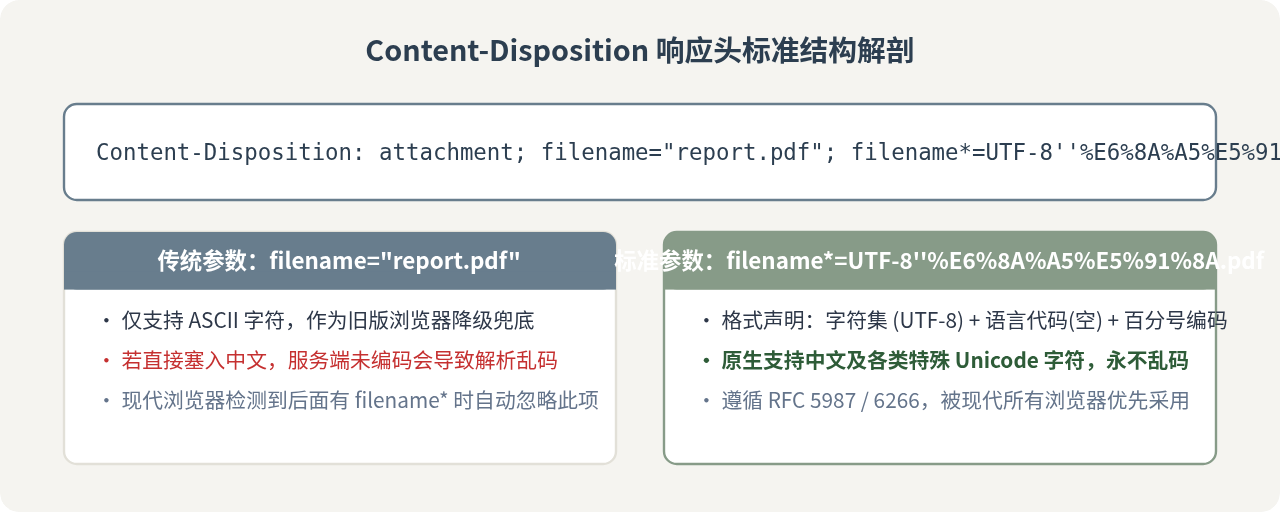
1. 服务端标准配置
服务端需要设置如下两个关键 Header。注意必须通过 Access-Control-Expose-Headers 开放该头,否则前端通过 JS 读取时只能拿到 null:
// 跨域暴露头信息(极其关键,否则前端无法访问 Content-Disposition)
Access-Control-Expose-Headers: Content-Disposition

// 双字段兼容输出(中文部分执行 UriEncode)
Content-Disposition: attachment; filename="report.xlsx"; filename*=UTF-8''%E5%B9%B4%E5%BA%A6%E6%8A%A5%E8%A1%A8.xlsx
2. 前端安全提取与解码函数
当通过 fetch 或 axios 请求文件流时,前端需要从响应头中解析出文件名并恢复中文字符:
/**
 * 从响应头中解析真实文件名并解决乱码
 * @param {Headers|object} headers 响应头对象
 * @returns {string} 解码后的文件名
 */
function parseFilenameFromHeaders(headers) {
  const disposition = headers.get ? headers.get('content-disposition') : headers['content-disposition'];
  if (!disposition) return 'download_file';

  let filename = '';

  // 1. 优先匹配 RFC 5987 现代规范:filename*=UTF-8''xxxx
  const rfc5987Regex = /filename\*=UTF-8''([^;]+)/i;
  const matchRfc = disposition.match(rfc5987Regex);
  if (matchRfc && matchRfc[1]) {
    try {
      filename = decodeURIComponent(matchRfc[1]);
      return filename;
    } catch (e) {
      console.warn('RFC 5987 解码失败:', e);
    }
  }

  // 2. 降级匹配传统 filename="..." 或 filename=...
  const fallbackRegex = /filename="?([^";]+)"?/i;
  const matchFallback = disposition.match(fallbackRegex);
  if (matchFallback && matchFallback[1]) {
    filename = matchFallback[1];
    try {
      // 兼容某些后端错误使用 urlencode 写入普通 filename 的情况
      if (filename.includes('%')) {
        filename = decodeURIComponent(filename);
      }
    } catch (e) {
      // 保持原样
    }
  }

  return filename || 'download_file';
}
四、两种常见下载方案的关键差异对比
选择“纯前端 <a download> 直链下载”还是“Fetch/Blob 内存转换下载”,需要依据业务实际情况衡量:
| 对比维度 | a[download] 直接下载 | Fetch / Axios 转 Blob 下载 |
|---|---|---|
| 跨域重命名 | 无效。直接被浏览器静默忽略,强制使用源名称。 | 有效。转为本地同源 Blob URL,100% 能够重命名。 |
| 请求控制能力 | 极弱。无法携带自定义 Headers(如 Authorization Token)。 | 极强。完整受控于 JS,支持携带 Token、拦截器与状态码捕获。 |
| 大文件内存消耗 | 无内存压力。浏览器底层直接将数据写入磁盘。 | 有内存压力。文件需完全缓存在浏览器内存中,GB 级大文件可能崩溃。 |
| 下载进度反馈 | 无。前端无法感知进度与下载成功率。 | 支持。可通过 ReadableStream 实时统计下载百分比。 |
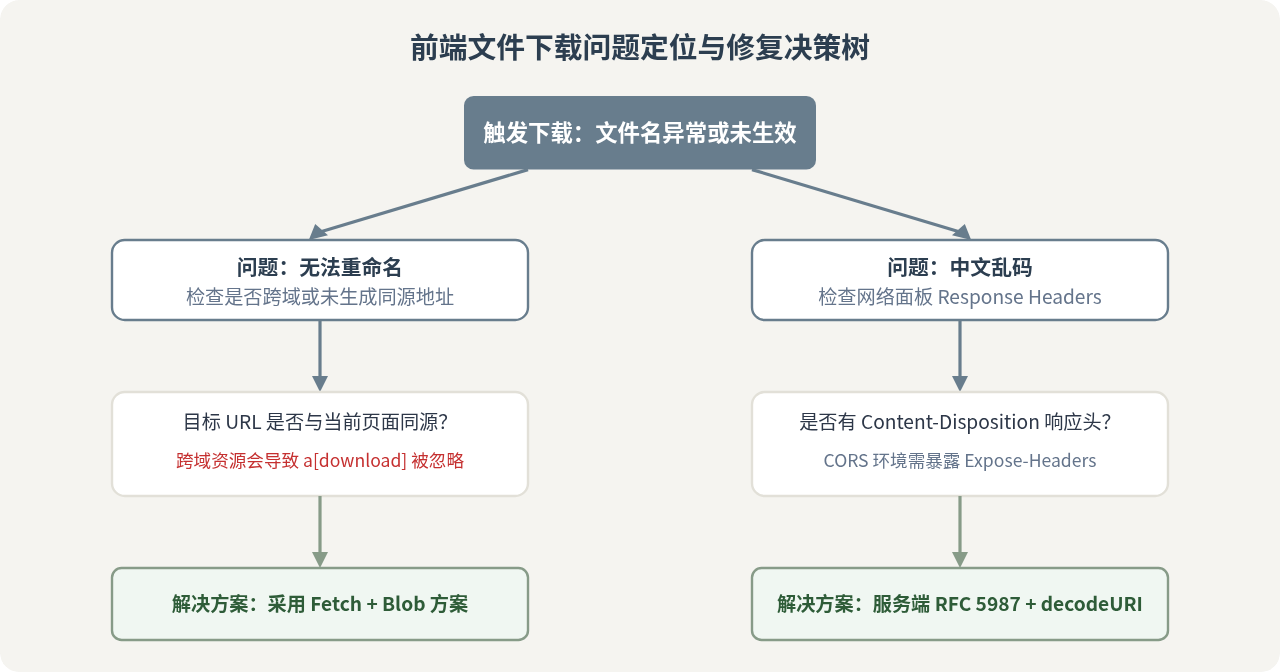
五、系统排查与定位决策流程
当遇到下载异常时,不要盲目试错,可根据以下排查决策流程逐一核实问题节点:
六、边界场景与进阶注意事项
- 超大文件(500MB 以上)的内存溢出防御:
Blob 转换方案要求全量数据进入 JavaScript 引擎堆内存中。在移动端或下载 GB 级别大文件时,直接调用
res.blob()极易触发浏览器页面崩溃(OOM)。针对这类超大文件,切忌使用 Blob 方案,应当引导服务端在生成下载链接时直接利用签名或由后端设置好合规的Content-Disposition,让浏览器原生下载管理器接管网络流。 - 避免重复双重编码:
部分后端在返回
filename*时,若对已编码字符串误执行了两次URLEncoder.encode(),前端只解码一次就会出现%E6%B5%8B...的半解码字符。排查时可观察字符串中是否存在双重%25。 - iOS Safari 浏览器的特殊限制:
在部分 iOS Safari 版本中,如果通过异步 Promise 延迟创建并在回调中派发
link.click(),会被 Safari 内置的弹窗拦截器误认为是恶意脚本操作而直接丢弃。对于此类场景,建议提示用户点击按钮后在新标签页打开,或确保网络请求与点击触发在同步用户交互上下文内紧密完成。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章