
深入解析JavaScript基本数据类型与引用类型的核心区别,详解栈内存与堆内存的存储机制、变量赋值、参数传递及全维度对比。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript基本数据类型与引用类型的区别及存储机制
作者:小括号
时间:2026-10-30
浏览:460
文章目录
JavaScript 中的变量根据其值在运行时的形态被清晰划分为两大阵营:基本数据类型(原始类型)与引用数据类型(复杂对象)。两者最核心的分水岭在于底层存储位置——基本类型直接存放于高速、结构规整的栈内存(Stack)中;而引用类型的实体数据存储于动态分配的堆内存(Heap)中,变量本身在栈中仅保留一个指向堆内存实体的地址指针。这一内存架构的设计,根本决定了赋值复制、函数传参、相等比较以及生命周期管理的运行逻辑。
一、JavaScript 数据类型的两大家族划分
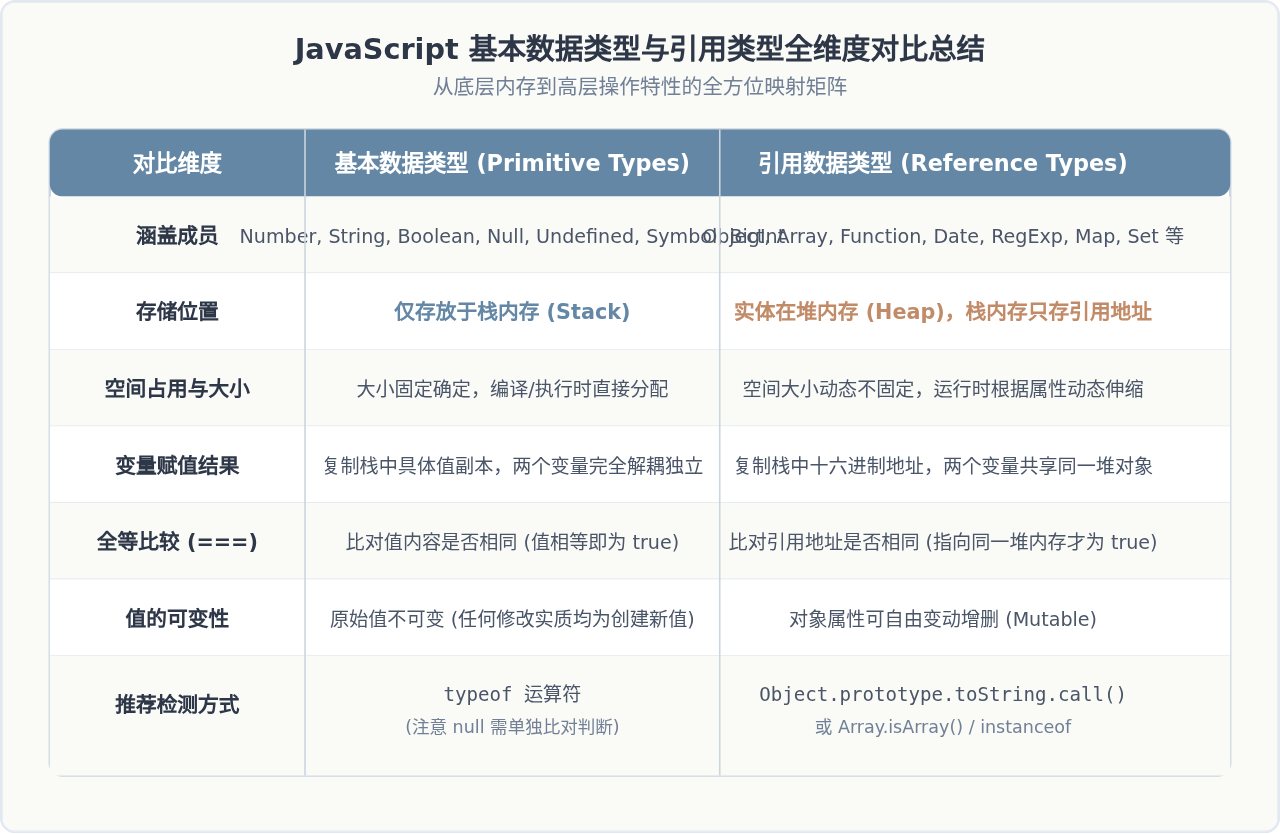
在 ECMAScript 最新规范中,数据类型被分为 7 种基本类型和 1 种复杂类型(统称为引用类型)。清晰掌握其归属是理解后续存储机制的前提:
- 基本数据类型(Primitive Types):包括
Number、String、Boolean、Undefined、Null、Symbol(ES6新增,代表独一无二的值)和BigInt(ES2020新增,用于安全表示任意精度的整数)。基本类型的特点是结构简单、占用空间大小固定,属于“不可变数据(Immutable)”。 - 引用数据类型(Reference Types):统称为
Object,并在此基础上衍生出各类特化形态,包括数组(Array)、函数(Function)、日期(Date)、正则表达式(RegExp)以及Map、Set等集合类型。引用类型的特点是结构复杂、体积可变,可以随时动态添加、删除或修改属性。
二、底层存储机制:栈内存(Stack)与堆内存(Heap)的协同
计算机程序运行时,JavaScript 引擎(如 V8)会将内存划分为不同的管理区域,其中最为关键的便是执行栈与内存堆:
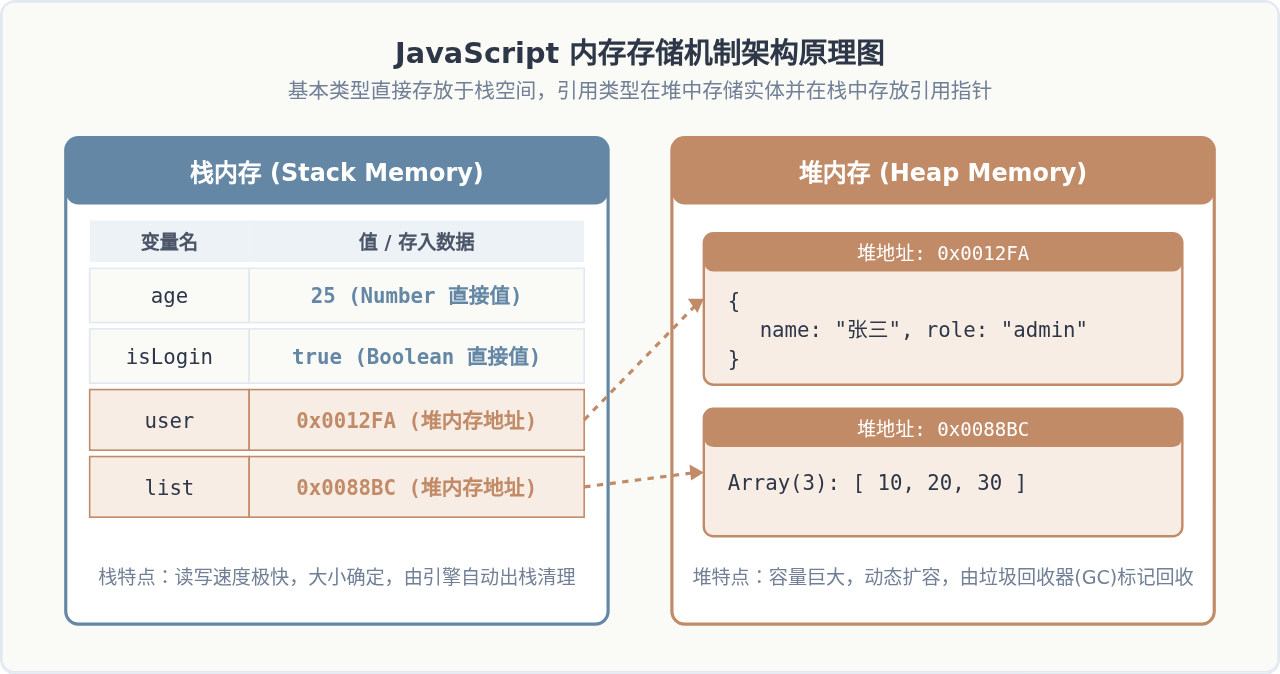
栈内存(Stack)是一块连续且由系统自动分配和释放的高速内存。由于其遵循“后进先出(LIFO)”的严格结构,存储在栈中的数据单元必须具备明确、固定且较小的内存尺寸。当代码执行到某个函数或代码块时,当前执行上下文入栈;基本数据类型的具体值、以及函数调用时的局部变量名,都直接存储在这块内存区域中。
堆内存(Heap)则是一大块非连续的动态分配区域。由于对象的属性数量、嵌套层级和内容长度不可预知(例如动态增长的数组、嵌套层级复杂的 JSON 对象),无法在编译或函数初始化阶段确定所需字节数,因此它们被放置在堆内存中。当通过 new 操作符或字面量声明一个对象时,引擎会在堆中开辟合适空间,并把该空间的十六进制起始地址(引用指针)写入栈内存对应的变量槽位中。
三、变量赋值与复制行为的本质差异
当执行赋值操作(let b = a)时,JavaScript 引擎在底层统一做一件事:将栈内存中变量当前槽位的内容原样复制一份,放到新变量在栈内存的独立槽位中。然而,由于基本类型和引用类型在栈中存放的数据性质不同,产生了截然相反的运行时表现:
1. 基本类型的“按值复制”
对于基本类型,栈中存放的就是实际的数据值。复制时,新变量会在栈中开辟新的独立存储单元,并拷入相同的值。两份数据各自独立,后续对其中任何一个变量的重新赋值或修改,绝对不会波及另一个。
let scoreA = 100;
let scoreB = scoreA; // 栈中为 scoreB 开辟新槽位,存入 100

scoreB = 80; // 仅修改 scoreB 槽位中的值

console.log(scoreA); // 100 (完全不受影响)
console.log(scoreB); // 80
2. 引用类型的“按引用地址复制”
对于引用类型,栈中存放的并不是对象本身,而是该对象在堆内存中的物理内存起始地址(Pointer)。当把一个引用类型变量赋值给新变量时,复制的仅仅是栈里的这一串内存地址编号。
复制完成后,两个变量各自在栈中拥有独立槽位,但槽位内部存储的地址值完全一致,共同指向堆内存中的同一块物理实体。因此,无论通过哪个变量去修改对象的属性,改动的都是同一份堆内存,所有引用该地址的变量都会感知到该变化。
let user1 = { name: "李雷", age: 18 };
let user2 = user1; // 仅复制了堆地址,user2 与 user1 指向同一对象

user2.age = 22; // 通过 user2 修改堆中的属性

console.log(user1.age); // 22 (user1 的属性同步发生改变!)
console.log(user1 === user2); // true (两者的引用地址完全一致)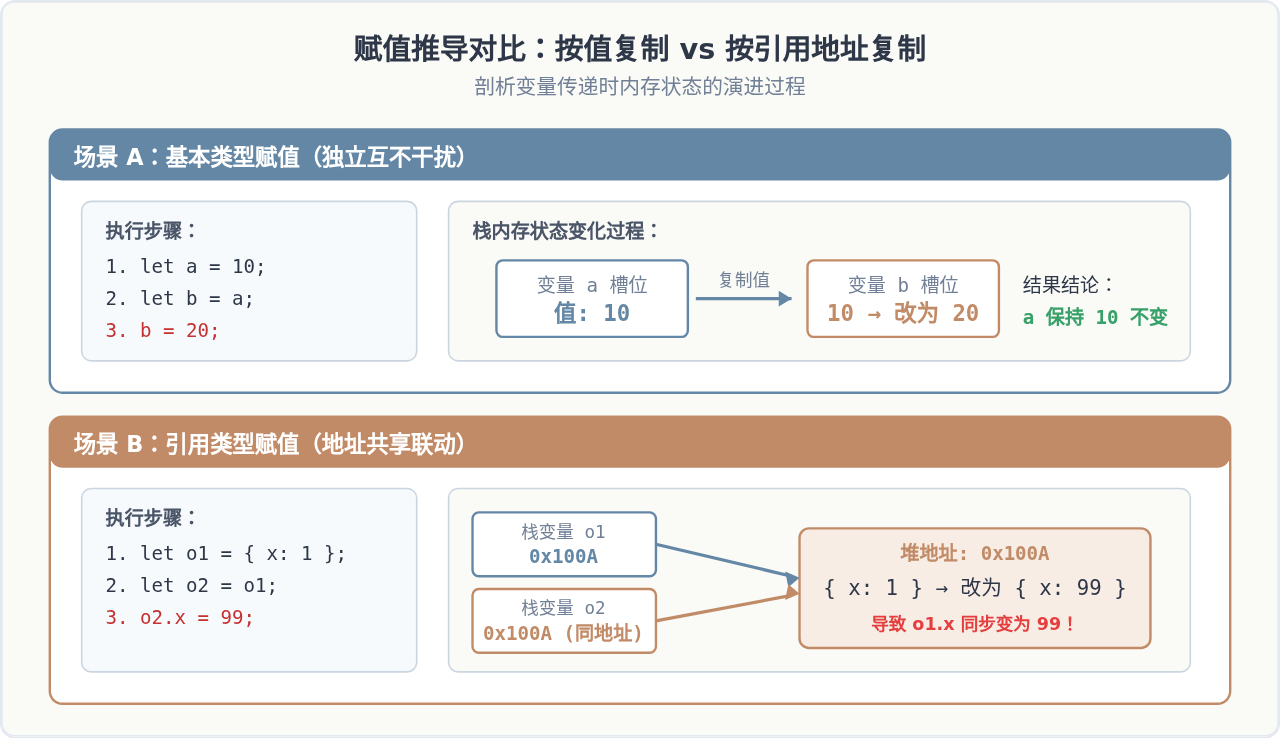
四、函数调用中的参数传递机制深度拆解
初学者常听到两种截然相反的说法:“基本类型按值传递,引用类型按引用传递”与“JavaScript中所有传参都是按值传递”。事实真相究竟如何?
明确规范结论:在 ECMAScript 规范定义中,JavaScript 所有的函数传参,无一例外全部都是“按值传递(Call by Value)”。
造成混淆的原因在于:当传递引用类型时,所传递的“值”恰恰是该对象在堆内存中的引用地址指针。
1. 修改形参对象的属性
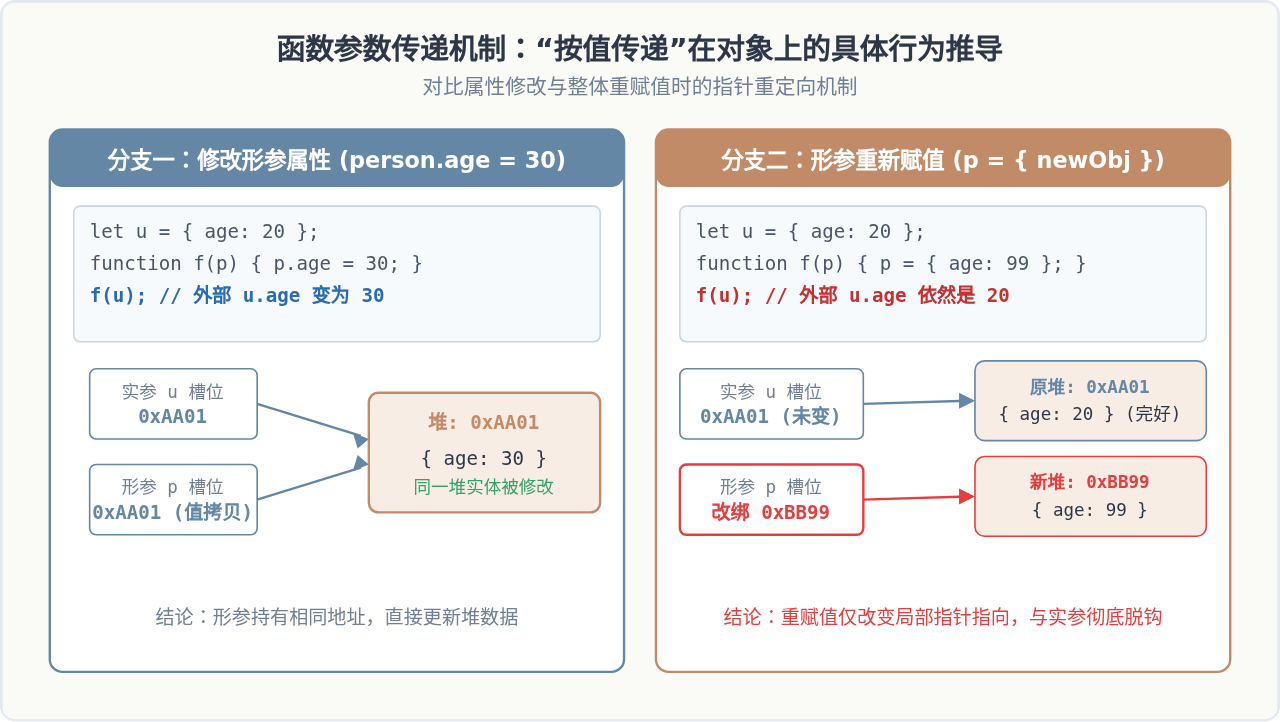
当我们将对象作为实参传入函数时,形参在函数作用域内被初始化为一个新变量,其栈内存槽位中拷贝了实参的内存地址。此时,形参和实参共同指向同一个堆对象。通过形参访问并修改对象内部属性时,修改直接反映在堆内存中:
function updateAge(person) {
  person.age = 30; // 修改堆内存实体的属性
}

let user = { name: "王五", age: 20 };
updateAge(user);
console.log(user.age); // 30 (外部属性被更改)
2. 对形参直接重新赋值(关键边界场景)
如果 JavaScript 是真正的“按引用传递(Call by Reference)”,那么在函数内把形参重新赋值为一个新对象时,外部变量也应当被同步替换。但实际运行结果并非如此:
function replaceUser(person) {
  // 重新对形参赋值:在堆中开辟新对象,并将新地址赋予局部形参 person
  person = { name: "赵六", age: 99 };
}

let original = { name: "王五", age: 20 };
replaceUser(original);
console.log(original.name); // 依然是 "王五"(没有被替换成 "赵六"!)
原因解释:当执行 person = { ... } 时,系统在堆中创建了新对象,并将形参 person 的指针指向了新地址。这一操作彻底切断了形参与外部实参 original 之间的地址绑定,外部实参仍然紧紧指向原先的内存区域。这强有力地证明了参数传递传递的仅是地址的值拷贝,而非引用变量本身的直接绑定。
五、比较运算与原始值不可变性(Immutability)
1. 全等比较(===)的底层比对规则
JavaScript 在执行严格全等比较(===)时,比对的依旧是栈内存中存放的数据内容:
- 基本类型比较:只要栈中存放的值完全相同且类型一致,即判定为
true。例如10 === 10为true,"abc" === "abc"为true。 - 引用类型比较:比较的是栈中存放的十六进制物理内存地址。即使两个对象长得一模一样,但只要它们是在堆中独立初始化的,其在栈中分配的地址便不相同,比较结果必然为
false。
let objA = { x: 1 };
let objB = { x: 1 };
console.log(objA === objB); // false (独立在堆中开辟两块空间,地址不同)

let objC = objA;
console.log(objA === objC); // true (栈中存放完全相同的引用地址)
2. 原始值的“不可变性”
所有基本数据类型的值本身都是只读不可变的。很多开发者误以为字符串方法会修改原字符串,例如:
let str = "hello";
str.toUpperCase();
console.log(str); // "hello" (原字符串丝毫未变)
调用 str.toUpperCase() 时,底层实际上是根据原字符串生成了一个全新的字符串存入内存并返回,原始的 "hello" 字符序列在内存中从未改变。
六、工程实践:类型检测陷阱与深浅拷贝策略
1. 类型判断的正确手段
针对不同数据类型,开发者在日常编写业务代码时需要避开典型陷阱:
typeof适合用于检测基本类型(除null外):typeof 42; // "number" typeof "hi"; // "string" typeof true; // "boolean" typeof undefined; // "undefined" typeof Symbol(); // "symbol" typeof 10n; // "bigint" // 陷阱 1:null 的历史 Bug(机器码以 000 开头误判为 object) typeof null; // "object"(必须通过 val === null 单独判空) // 陷阱 2:大部分引用类型均返回 "object" typeof [1, 2]; // "object" typeof {}; // "object" typeof function(){}; // "function" (函数是特殊的对象,有独立返回值)-
精准判断引用类型:推荐使用
Object.prototype.toString.call(val),它能精准返回内置标签,例如[object Array]、[object Object]、[object RegExp];数组亦可直接使用Array.isArray()。
2. 避免引用共享的副作用:浅拷贝 vs 深拷贝
由于引用类型的赋值只是拷贝地址,若要在业务中修改新对象而不污染原对象,必须进行“拷贝”:
- 浅拷贝(Shallow Copy):只克隆对象的第一层属性。对于第一层的基本类型属性复制其值,而第一层中如果包含对象或数组属性,复制的仍然是引用地址。常见实现方式包括扩展运算符
{ ...obj }、Object.assign({}, obj)、Array.prototype.slice()。 - 深拷贝(Deep Copy):递归遍历整个对象树,在堆内存中为每一层嵌套对象均开辟完全崭新的空间,达到彻底的物理隔离。现代浏览器已原生支持
structuredClone(obj),它能正确处理循环引用及 Date、Map、Set 等复杂类型,已成为推荐的标准方案。
七、总结与最佳开发实践
深入理解 JavaScript 的基本数据类型与引用类型,不仅有助于应对面试,更是排查深层次状态管理 Bug 的核心能力。总结以下三条高频实践准则:
- 防御意外的副作用修改:在组件化开发(如 React、Vue)中,状态的变更通常要求遵循“不可变数据(Immutable)”理念。接收到对象或数组类型的 props 时,切忌直接修改其内部属性,应先通过浅拷贝或深拷贝创建新副本后再行更新。
- 警惕引用类型的恒等判断:在编写条件逻辑时,不要直接使用
===比较两个字面量对象或数组(例如[] === []永远是false)。如果需要比对内容是否一致,应编写深比较函数或将关键标识提取为基本类型进行比较。 - 善用垃圾回收与解除引用:堆内存中的对象不会自动出栈,而是依赖 V8 引擎的垃圾回收器(标记清除算法)。对于不再使用的大型数据结构、闭包缓存或全局引用,及时将其赋值为
null,能够协助引擎尽早标记并释放堆空间,有效规避内存泄露风险。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章