
深入讲解JavaScript数组遍历与对象操作的核心方法与实际开发案例,包含列表数据清洗、字段重构、Reduce统计分组、对象键值转换与深浅拷贝最佳实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组遍历与对象操作基础案例
作者:小括号
时间:2026-10-30
浏览:251
文章目录
在现代 JavaScript 开发中,绝大部分业务数据都以“对象数组”(如列表接口返回值)或“嵌套键值字典”(如配置表、状态映射)的形式存在。掌握数组高阶遍历与对象操作的协同机制,核心在于根据实际业务目标——是单纯产生副作用、进行形态投影、条件过滤,还是多维聚合并重组结构——选用语义精准的 API 与保持数据不可变性(Immutability)。本文通过四个真实高频的基础案例,系统拆解数组遍历与对象操作的核心用法与常见陷阱。
一、数组遍历方法的定位与选型策略
JavaScript 为数组提供了丰富的内置遍历方法。初学者容易混淆 forEach 与 map,或在需要聚合运算时滥用外部局部变量。理解每个方法的设计意图和返回值契约,是编写可维护代码的前提:
- 副作用型(如
forEach、for...of):不关心返回值,用于更新外部状态、执行日志记录或 DOM 节点渲染。需要支持异步循环(await)或提前退出(break)时,应首选for...of。 - 映射转换型(如
map):严格维持“输入与输出元素数量 1:1 对等”,通过回调函数映射生成一个全新的数组,绝不能在map中不写return。 - 条件筛选型(如
filter):根据断言函数返回的真假值保留元素,生成原数组的子集数组。 - 聚合统计型(如
reduce):将多项数据归纳折叠为一个单一结果(可以是数字、字符串,也可以是全新的对象或映射字典)。
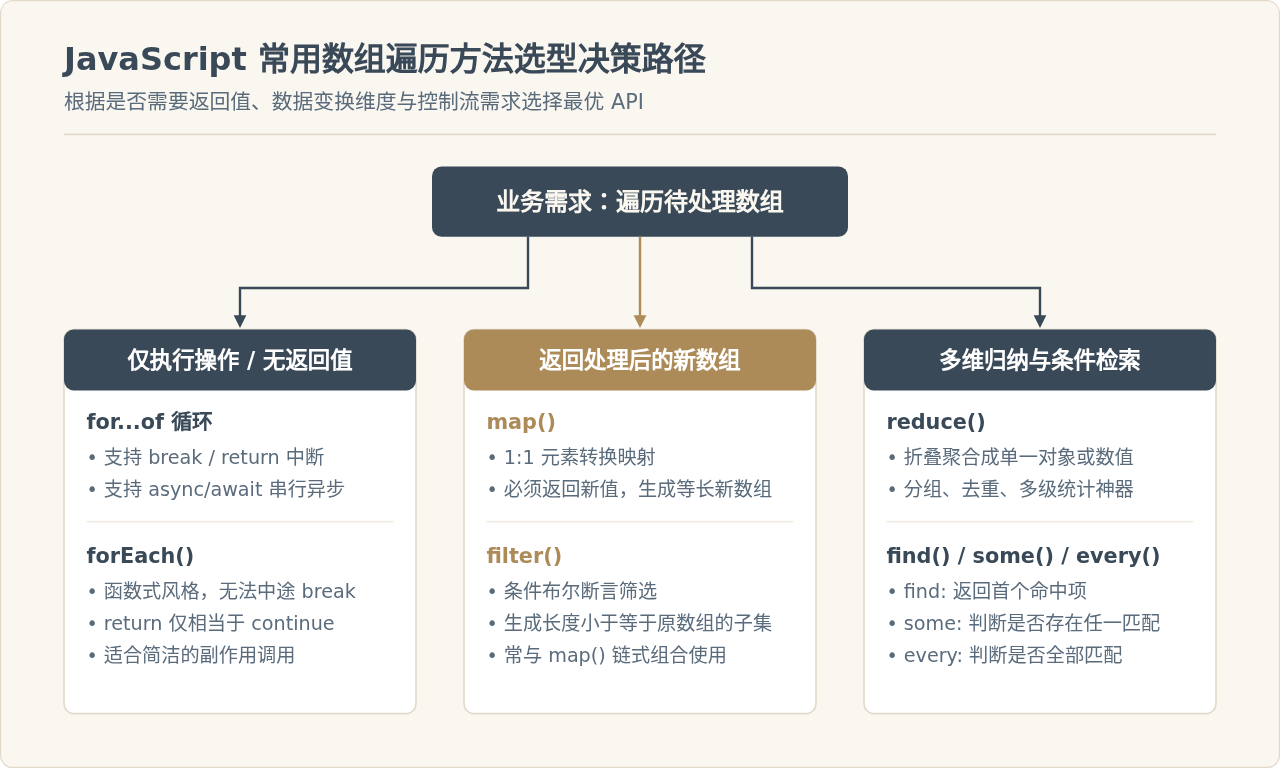
图 1:JavaScript 数组遍历方法选型决策模型
二、基础案例一:列表数据清洗与字段重构
在获取服务端响应后,前端通常不需要保留所有字段,甚至需要对特定字段做别名映射、计算派生属性并剔除无效数据。此时,最佳实践是先用 filter 进行有效性校验,再结合 map 与 ES6 对象解构赋值完成新对象的投影。
// 模拟从接口收到的原始用户数据列表
const rawUsers = [
  { id: 101, username: "zhang_san", status: "active", profile: { age: 24, city: "北京" } },
  { id: 102, username: "li_si", status: "inactive", profile: { age: 31, city: "上海" } },
  { id: 103, username: "wang_wu", status: "active", profile: null }, // profile 缺失场景
  { id: 104, username: "zhao_liu", status: "active", profile: { age: 19, city: "广州" } }
];

// 清洗目标:筛选 active 用户,提取简化字段,为缺失属性提供安全默认值
const cleanedUsers = rawUsers
  .filter(user => user.status === "active")
  .map(({ id, username, profile }) => {
    // 利用解构与默认值防止 TypeError: Cannot read properties of null
    const { age = 0, city = "未知" } = profile || {};
    return {
      userId: id,
      displayName: username.toUpperCase(),
      age,
      city,
      isAdult: age >= 18
    };
  });

console.log(cleanedUsers);
/* 示例输出:
[
  { userId: 101, displayName: "ZHANG_SAN", age: 24, city: "北京", isAdult: true },
  { userId: 103, displayName: "WANG_WU", age: 0, city: "未知", isAdult: false },
  { userId: 104, displayName: "ZHAO_LIU", age: 19, city: "广州", isAdult: true }
]
*/
关键细节与排错提醒
1. 避免原地篡改:在 map 中务必返回新的对象字面量,不要执行 user.userId = user.id; delete user.id;,这会直接污染上游原数组的数据引用。
2. 防御嵌套空值:当对象层级可能为 null 或 undefined 时,必须通过 profile || {} 或可选链运算符 profile?.age 做兜底保护,否则会触发解构异常。
三、基础案例二:统计汇总与分组转换(Reduce + 动态键名)
将扁平的记录列表转换为按类别划分的字典结构,是前端报表与状态管理中的经典需求。例如在电商购物车中,将商品明细按照分类归纳,并同步计算该分类下的商品数量与总金额。
// 原始订单明细数组
const orderItems = [
  { id: "p1", category: "数码电子", price: 299, quantity: 1 },
  { id: "p2", category: "图书文具", price: 59, quantity: 2 },
  { id: "p3", category: "数码电子", price: 99, quantity: 3 },
  { id: "p4", category: "生活日用", price: 35, quantity: 4 }
];

// 归纳统计:按分类汇总数量与总销售额
const categorySummary = orderItems.reduce((accumulator, item) => {
  const { category, price, quantity } = item;
  const currentTotal = price * quantity;

  // 检查累加器中是否已存在该分类对应键名,不存在则初始化
  if (!accumulator[category]) {
    accumulator[category] = {
      itemCount: 0,
      totalAmount: 0
    };
  }

  // 累加分类指标
  accumulator[category].itemCount += quantity;
  accumulator[category].totalAmount += currentTotal;

  // 必须返回累加器对象以供下一次迭代使用
  return accumulator;
}, {}); // 第二个参数传入空对象 {} 作为初始累加器

console.log(categorySummary);
/* 示例输出:
{
  "数码电子": { itemCount: 4, totalAmount: 596 },
  "图书文具": { itemCount: 2, totalAmount: 118 },
  "生活日用": { itemCount: 4, totalAmount: 140 }
}
*/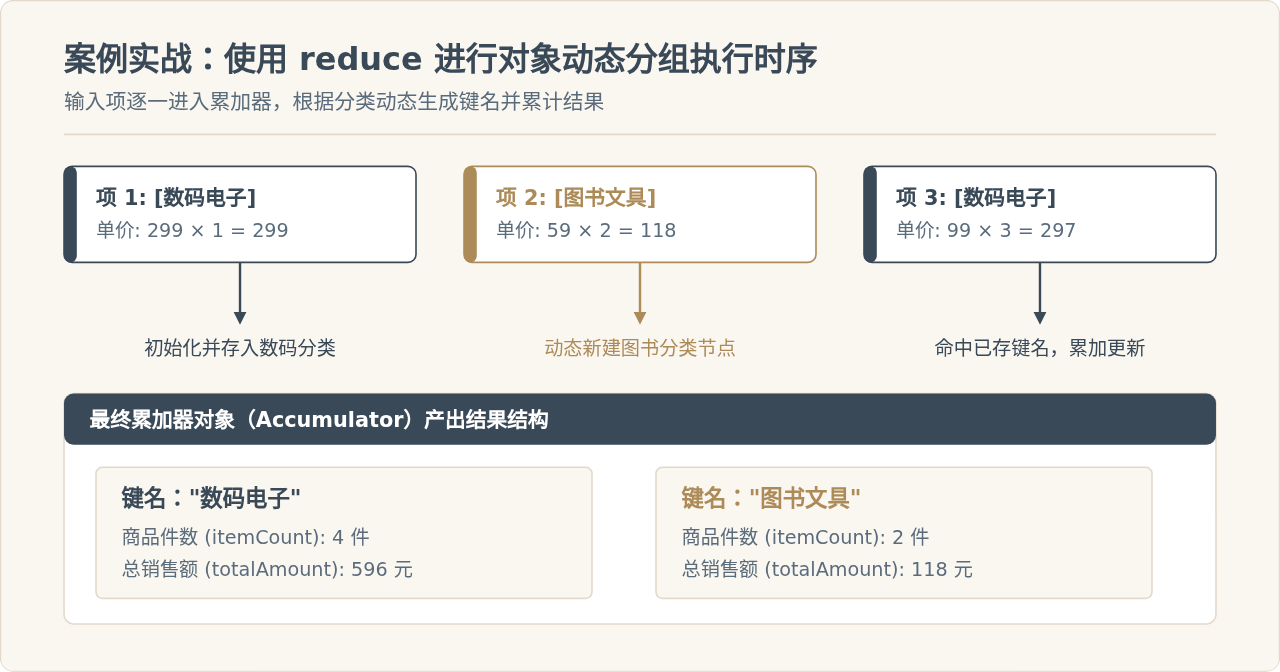
图 2:reduce 迭代中动态键名构建与累加过程
四、基础案例三:对象转数组与配置项遍历
JavaScript 对象本质是无序键值对集合,不能直接调用 map 或 filter。当需要将字典对象渲染为下拉列表组件、生成 URL 查询参数,或按条件过滤配置项时,必须先通过 Object.keys()、Object.values() 或 Object.entries() 将其投影为数组。
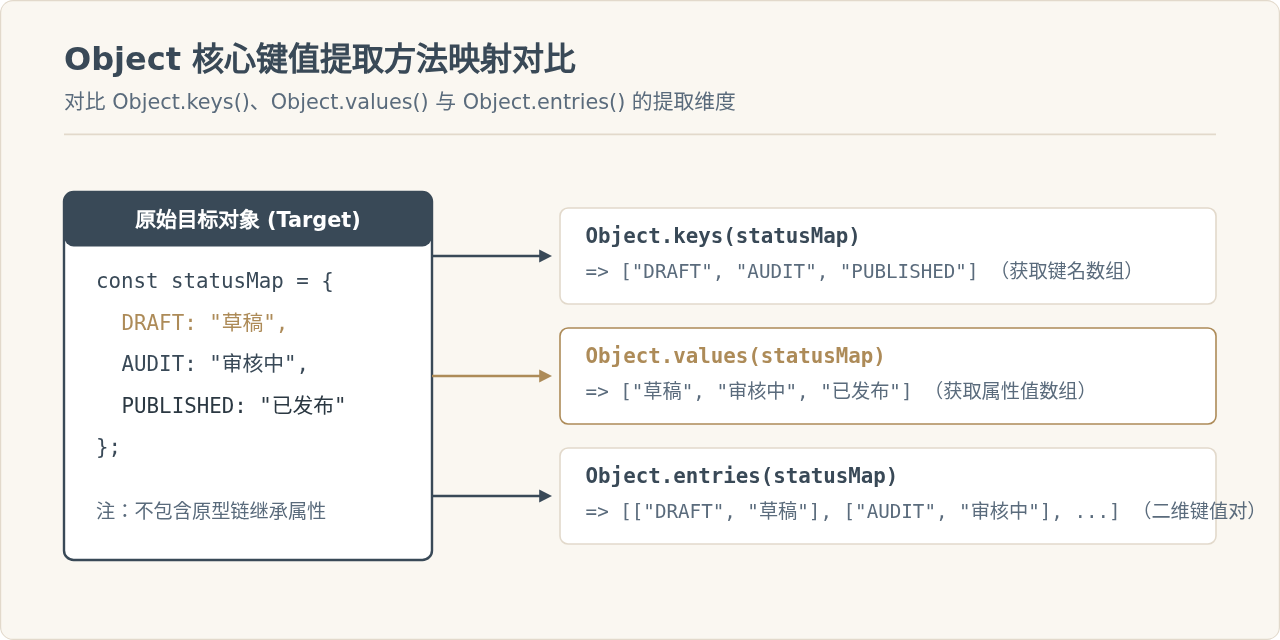
图 3:Object 键值提取方法对照关系
结合 Object.entries() 和 Object.fromEntries(),我们可以轻松实现类似数组操作的“对象过滤与变换”全流程:
const envConfig = {
  API_HOST: "https://api.example.com",
  TIMEOUT: 5000,
  ENABLE_CACHE: false,
  DEBUG_TOKEN: "" // 需要剔除的空配置
};

// 目标:剔除空字符串配置项,并将键名统一转换为小写
const normalizedConfig = Object.fromEntries(
  Object.entries(envConfig)
    .filter(([key, value]) => value !== "")
    .map(([key, value]) => [key.toLowerCase(), value])
);

console.log(normalizedConfig);
/* 示例输出:
{
  api_host: "https://api.example.com",
  timeout: 5000,
  enable_cache: false
}
*/
为什么推荐 Object.entries 而非 for...in?
传统的 for...in 循环会遍历对象自身及其原型链上的所有可枚举属性,若原型上被第三方库或旧代码扩展了方法,极易导致意外 Bug(必须配合 hasOwnProperty 校验)。而 Object.keys/entries 仅提取对象自身的可枚举属性,不仅更安全,且能无缝链式调用数组高阶函数。
五、基础案例四:安全的对象合并与更新(深浅拷贝边界)
在处理复杂表单提交、局部更新配置或 Redux/Vuex 状态流转时,对象合并是基础操作。现代 JavaScript 提供了展开运算符(...)与 Object.assign(),但必须清醒认知其浅拷贝特性。
// 系统默认配置项
const defaultSettings = {
  theme: "light",
  notifications: { email: true, sms: false },
  pageSize: 20
};

// 用户自定义覆盖项
const userCustom = {
  pageSize: 50,
  notifications: { sms: true } // 故意仅传入局部嵌套字段
};

// 常见错误做法:浅拷贝合并直接丢失 email 字段!
const shallowMerged = { ...defaultSettings, ...userCustom };
console.log(shallowMerged.notifications);
// 输出: { sms: true },原有的 email: true 被直接整体覆盖抹除!

// 正确解法一:多层级显式解构合并(轻量级、无第三方依赖)
const safeMerged = {
  ...defaultSettings,
  ...userCustom,
  notifications: {
    ...defaultSettings.notifications,
    ...userCustom.notifications
  }
};
console.log(safeMerged.notifications);
// 输出: { email: true, sms: true }

// 正确解法二:现代规范原生深拷贝 structuredClone()
const deepClonedDefault = structuredClone(defaultSettings);
// 修改克隆体绝不会对原始 defaultSettings 产生任何副作用引用
六、高频陷阱与开发准则全景总结
将数组遍历与对象操作融入日常编码时,建议遵循以下四项核心准则,从源头杜绝运行期隐蔽错误:
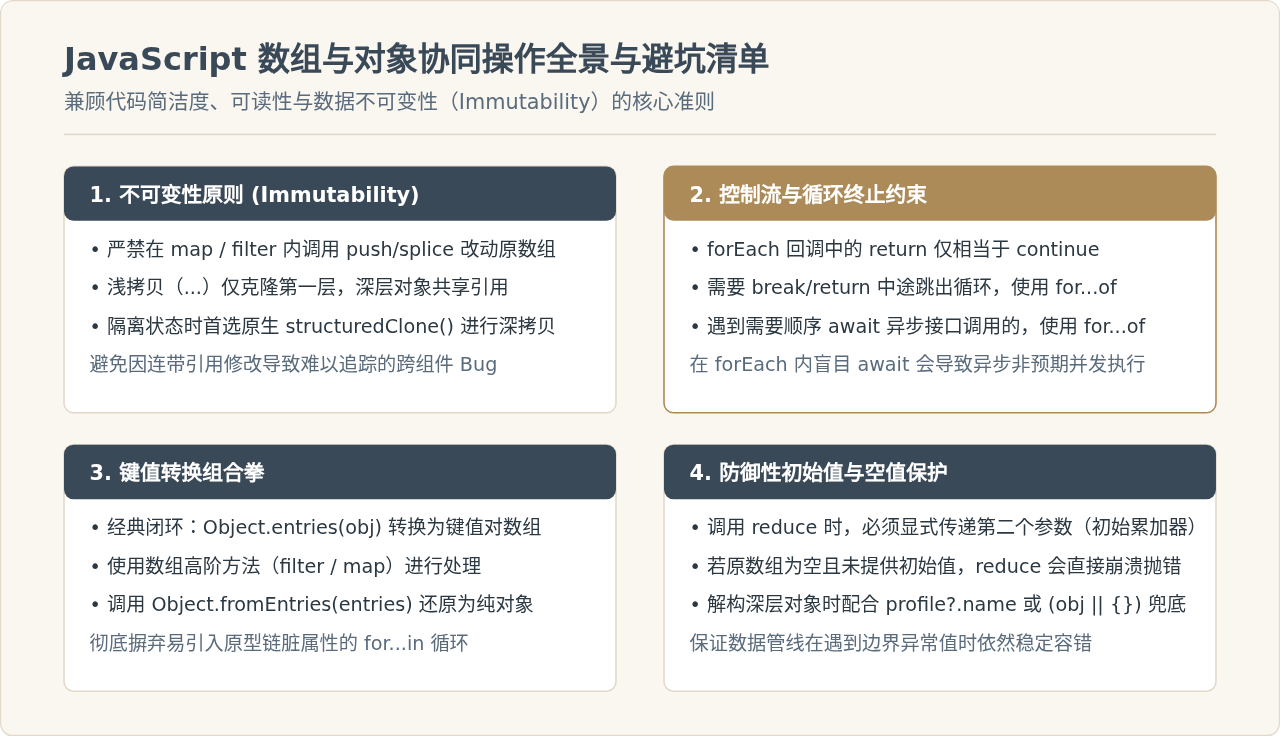
图 4:数组与对象操作全景知识与避坑准则
在日常工程实践中,根据数据规模与业务场景权衡代码可读性与性能:对于中小规模的数据清洗,优先采用语义清晰、易于单元测试的函数式链式调用(filter().map());对于存在复杂多维折叠的高性能统计场景,使用配置了显式初始值的 reduce();在涉及复杂异步串行调用时,回归清晰直观的 for...of 循环。合理利用对象解构与只读原则,能够写出优雅、健壮且易于团队协作的优质 JavaScript 代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章