
深入详解 JavaScript 正则表达式的核心匹配模式、高频业务实战案例(邮箱、手机号、URL、强密码)以及 String.replace/replaceAll 捕获组与回调替换高级技巧,附带执行原理与性能避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript正则表达式实例:常用匹配模式与替换技巧详解
作者:函数茶馆
时间:2026-10-30
浏览:75
文章目录
JavaScript 正则表达式(RegExp)是处理文本检索、模式校验以及字符串复杂替换的核心工具。本文围绕日常前端与 Node.js 业务中最关键的匹配需求展开,系统梳理字符类、量词、断言等核心模式,提供开箱即用的高频实战正则模板,并深入剖析
String.prototype.replace() 与 replaceAll() 结合捕获组与回调函数的高级文本变换方案,帮助开发者写出精准且健壮的正则逻辑。
一、JavaScript 正则基础与核心匹配模式
在 JavaScript 中,正则表达式可以通过字面量(例如 /pattern/flags)或构造函数 new RegExp("pattern", "flags") 创建。理解正则的内在机制,首先需要明确其三大支柱:字符匹配、量词限定与边界约束。
1. 核心元字符与字符类
元字符是构建匹配模式的基础积木,常见定义如下:
\d:匹配任意十进制数字,等价于[0-9];而\D匹配任意非数字字符。\w:匹配任意字母、数字或下划线,等价于[A-Za-z0-9_];\W匹配非单字字符。\s:匹配空白符(包含空格、制表符、换页符及换行符);\S匹配非空白符。.:在默认模式下匹配除换行符外的任意单个字符;配合s修饰符(dotAll 模式)可匹配包含换行符在内的所有字符。- 字符集
[...]:匹配集合内的任意单个字符,如[abc]或[a-z];使用[^...]表示对集合取反。
2. 量词控制与贪婪/惰性匹配
量词决定前一个子表达式重复出现的次数。JavaScript 正则引擎默认采用“贪婪匹配”,即尽可能多地消耗符合条件的字符;如果在量词后追加 ?,则转换为“惰性匹配(非贪婪匹配)”,即在满足条件的前提下尽可能少地匹配字符。
*(0 次或多次)与*?(惰性匹配 0 次或多次)+(1 次或多次)与+?(惰性匹配 1 次或多次)?(0 次或 1 次)与??(惰性匹配 0 次或 1 次){n,m}(至少 n 次,至多 m 次)与{n,m}?(惰性匹配至少 n 次)
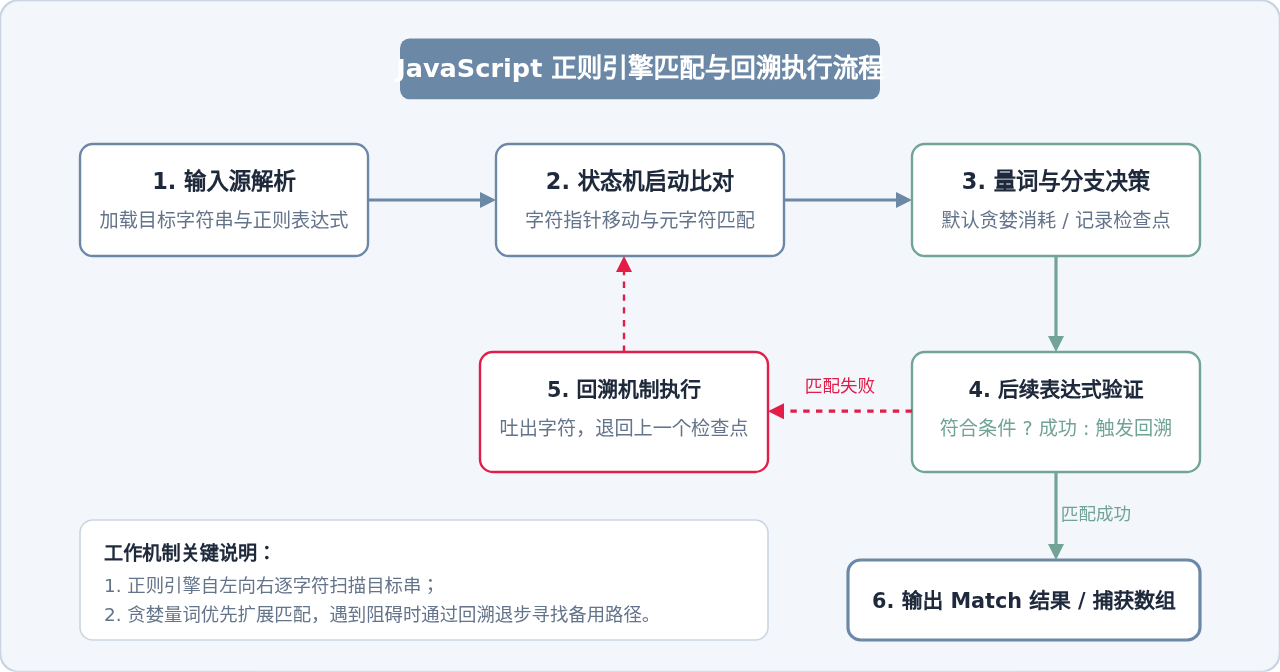
图 1:JavaScript 正则表达式状态机匹配与回溯判定流程
二、日常高频实战匹配模式实例
在实际业务开发中,数据格式校验与文本提取占据了正则表达式的大部分应用场景。以下整理了四类最常见的模式实例,附带严密的边界校验与实际代码验证。
1. 邮箱地址格式校验
邮箱格式需要兼顾用户名、@ 符号、二级域名及合法顶级域名(TLD)。对于绝大多数企业级 Web 应用,推荐使用符合常见字符规范的实用子集:
// 适用规范:允许英文字母、数字、下划线、点号和短横线,域名至少二级
const emailRegex = /^[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+$/;

console.log(emailRegex.test("developer.ops@example.com.cn")); // true
console.log(emailRegex.test("invalid..user@domain.com"));     // 需按业务细化约束
console.log(emailRegex.test("@no-username.org"));              // false
2. 中国大陆大陆手机号码与二代身份证号校验
国内手机号固定为 11 位数字,首位为 1,第二位涵盖 3-9。中国大陆第二代身份证固定为 18 位,前 17 位为数字,末尾校验位为数字或大写字母 X:
// 手机号码验证正则(中国大陆11位)
const phoneRegex = /^1[3-9]\d{9}$/;

// 二代身份证格式验证正则(18位,包含末位X)
const idCardRegex = /^[1-9]\d{5}(?:18|19|20)\d{2}(?:0[1-9]|1[0-2])(?:0[1-9]|[12]\d|3[01])\d{3}[\dXx]$/;

console.log(phoneRegex.test("13812345678")); // true
console.log(phoneRegex.test("12098765432")); // false (第二位不符)
console.log(idCardRegex.test("11010119900307231X")); // true
3. URL 解析与协议/域名/路径提取
通过带有捕获组的正则,不仅能够验证 URL 的合法性,还能同步提取协议名、主机域名与请求路径:
const urlPattern = /^(https?:\/\/)?([a-zA-Z0-9.-]+\.[a-zA-Z]{2,})(:[0-9]+)?(\/[^\s?]*)?(\?[^\s#]*)?(#.*)?$\/;

const targetUrl = "https://sub.domain.com:8080/api/v1/users?page=1&limit=20#section";
const matches = targetUrl.match(urlPattern);

if (matches) {
  const [full, protocol, host, port, pathname, query, hash] = matches;
  console.log({ protocol, host, port, pathname, query, hash });
}
4. 复杂强密码校验(先行断言组合)
企业级密码规则通常要求:“长度 8-20 位,必须同时包含大写字母、小写字母、数字及特殊符号”。使用传统单层判断难以兼顾顺序无关性,而使用正向肯定先行断言(Positive Lookahead) (?=...) 能够无缝实现多重约束:
// 强密码校验:至少1位大写、1位小写、1位数字、1位特殊字符,总长8-20位
const strongPasswordRegex = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[!@#$%^&*()_+\-=[\]{};':"\\|,.<>/?]).{8,20}$/;

console.log(strongPasswordRegex.test("P@ssw0rd2026")); // true
console.log(strongPasswordRegex.test("password123"));   // false (缺少大写与特殊符)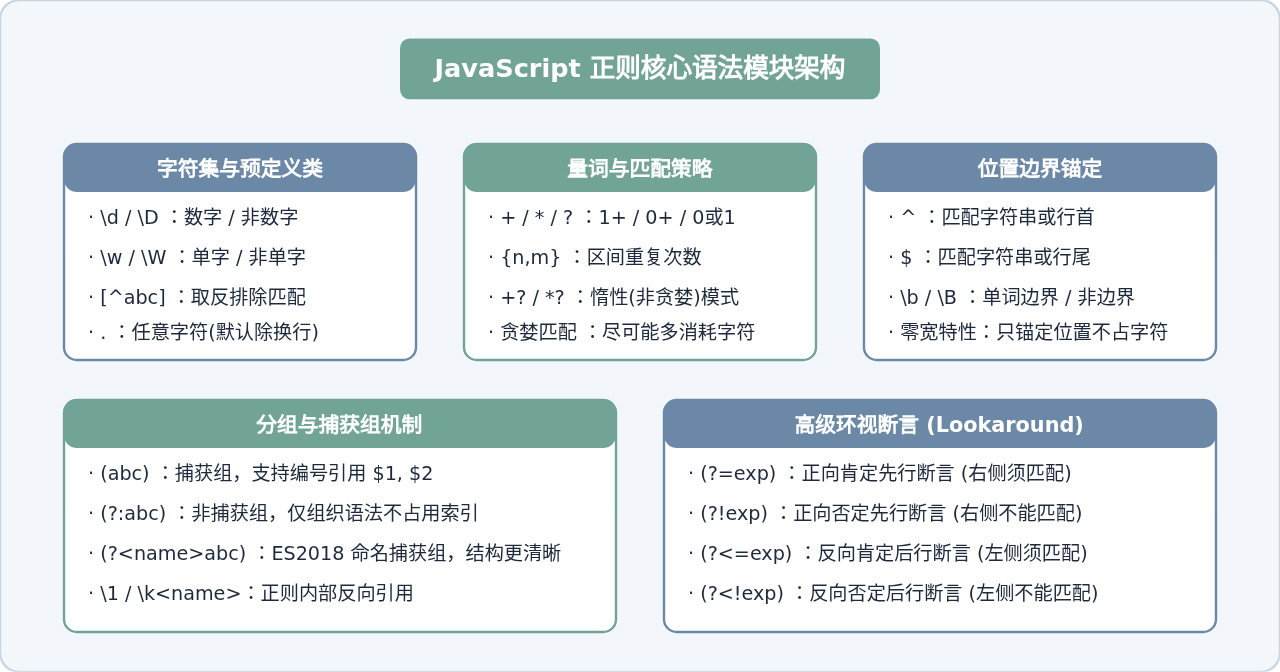
图 2:JavaScript 正则表达式语法模块结构与能力分类
三、JavaScript 正则替换技巧与深层用法
文本替换是 JavaScript 处理复杂格式、清洗数据与模板渲染的关键手段。现代 JavaScript 提供了 String.prototype.replace() 以及 ES2021 引入的 String.prototype.replaceAll()。
1. replace 与 replaceAll 的边界区别
当使用字符串作为入参时,replace() 仅替换首个匹配项,而 replaceAll() 会替换所有匹配项。但当入参为正则表达式时:
- 若使用
replace(regex, replacement),只有显式携带/g修饰符时才会进行全局替换;缺少/g时仅替换第一处。 - 若使用
replaceAll(regex, replacement),正则表达式必须包含g标志,否则 JavaScript 运行时会直接抛出TypeError: String.prototype.replaceAll called with a non-global RegExp错误。
2. 捕获组与反向引用替换符
在替换字符串中,可以使用形如 $1, $2 或命名捕获组 $<name> 引用匹配内容:
// 实例:将日期从 "YYYY-MM-DD" 替换为 "MM/DD/YYYY"
const rawDate = "2026-10-24";
const usDate = rawDate.replace(/(\d{4})-(\d{2})-(\d{2})/, "$2/$3/$1");
console.log(usDate); // "10/24/2026"

// 命名捕获组写法 (ES2018+)
const namedPattern = /(?<year>\d{4})-(?<month>\d{2})-(?<day>\d{2})/;
const formatted = rawDate.replace(namedPattern, "$<month>/$<day>/$<year>");
console.log(formatted); // "10/24/2026"
3. 回调函数驱动的高级动态替换
当静态模板字符串无法满足复杂的业务逻辑时,可以将 replacer 设置为函数。回调函数的签名包含完整匹配项、各个捕获组、匹配偏移索引以及原始字符串:
// 场景 1:下划线转小驼峰命名
function snakeToCamel(str) {
  return str.replace(/_([a-z])/g, (match, letter) => letter.toUpperCase());
}
console.log(snakeToCamel("user_profile_avatar_url")); // "userProfileAvatarUrl"

// 场景 2:手机号中间 4 位动态脱敏掩码
function maskPhoneNumber(phone) {
  return phone.replace(/^(\d{3})\d{4}(\d{4})$/, "$1****$2");
}
console.log(maskPhoneNumber("13912345678")); // "139****5678"

// 场景 3:千分位金额格式化(使用先行断言配合 replace)
function formatCurrency(num) {
  return String(num).replace(/\B(?=(\d{3})+(?!\d))/g, ",");
}
console.log(formatCurrency(123456789.5)); // "123,456,789.5"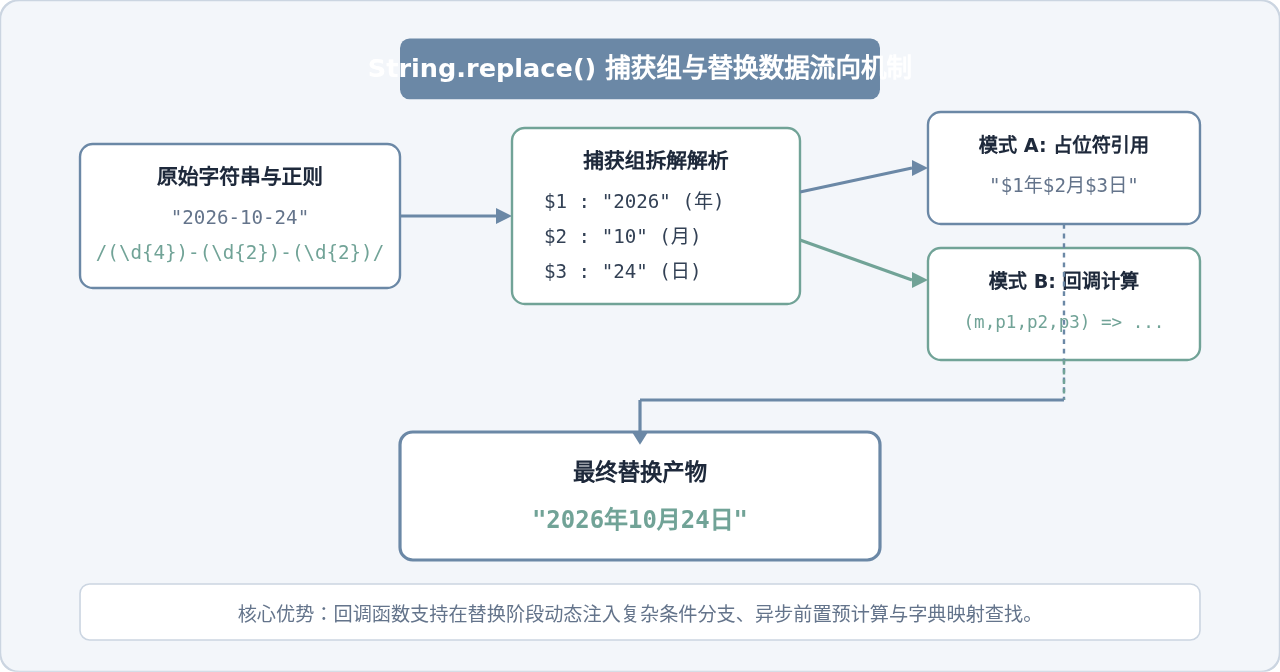
图 3:JavaScript 字符串替换中捕获组解析与模板/回调处理数据流
四、性能陷阱、避坑指南与工程建议
1. 警惕灾难性回溯(Catastrophic Backtracking)
当正则表达式中包含嵌套的可选量词(如 (a+)+$ 或 (a|a+)+$)时,如果遇到长且几乎匹配但不完全合规的畸形字符串,正则引擎会尝试指数级的状态组合,导致 CPU 使用率飙升至 100%,造成 Node.js 事件循环挂起或浏览器页面卡死(即正则拒绝服务攻击 ReDoS)。
防护法则:避免嵌套量词;优先使用具体的字符范围代替泛化的
.*;必要时在业务层对用户输入的文本长度做硬性截断(如超过 500 字符拒绝复杂校验)。
2. RegExp 实例全局修饰符 g 的 lastIndex 状态隐患
当 RegExp 实例带有 g 或 y 修饰符时,该实例会变成有状态对象。其 lastIndex 属性会记录上一次匹配成功结束的位置。如果在循环或复用的正则实例中调用 test() 或 exec(),可能会产生意想不到的交替匹配错误:
const reusableRegex = /foo/g;
console.log(reusableRegex.test("foo")); // true (lastIndex 变为 3)
console.log(reusableRegex.test("foo")); // false! (从索引 3 开始寻找,未找到)
console.log(reusableRegex.lastIndex);  // 0 (匹配失败后自动归零)
排查建议:若仅需判断字符串是否符合模式,无需提取所有匹配项,请勿在 test() 正则中添加 g 标志,或在每次执行前显式重置 regex.lastIndex = 0。
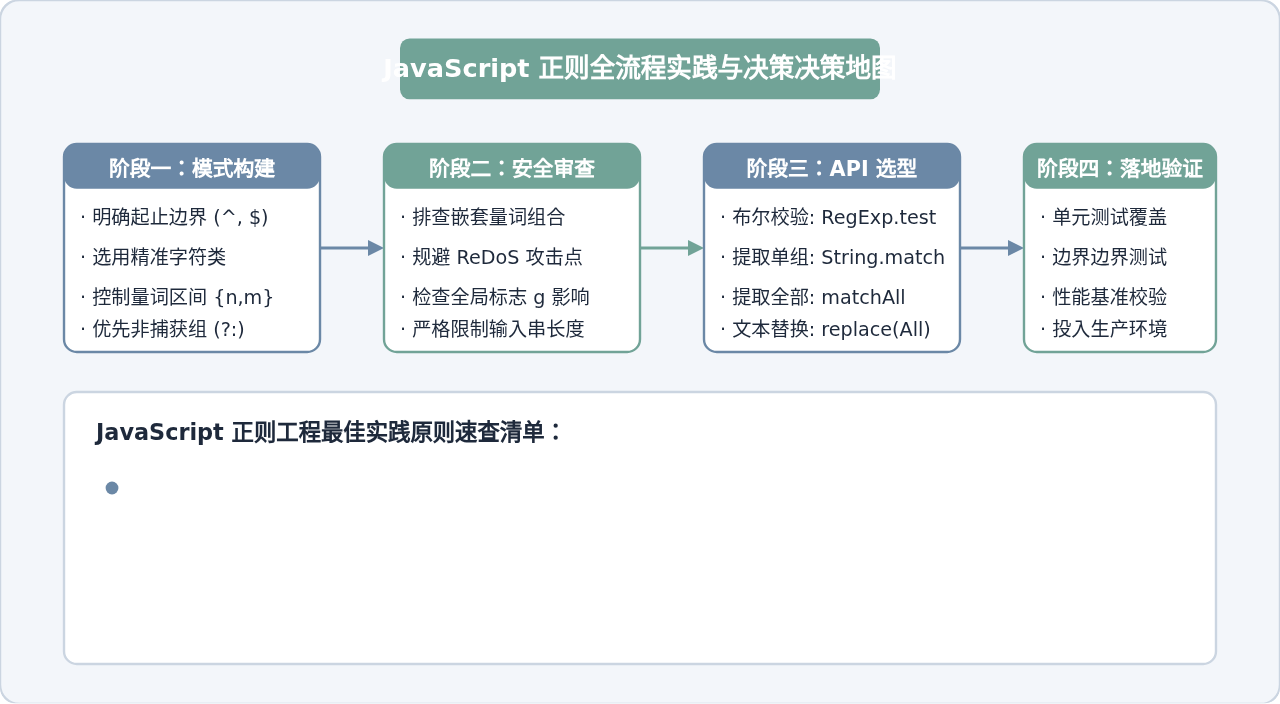
图 4:JavaScript 正则表达式全流程设计与工程落地总结地图
五、总结
熟练掌握 JavaScript 正则表达式不仅能大幅减少冗长的字符串切分与拼接代码,更能提高数据校验的准确性与系统的稳健度。在实际项目中,编写正则时应当秉持“明确边界、控制贪婪、注意性能、合理选用 replace 机制”的原则,让文本处理既优雅又高效。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章