

深入讲解在浏览器中使用JavaScript批量下载多个文件的三种主流方法,剖析浏览器多文件拦截机制、CORS同源限制及内存瓶颈,并提供实用代码与选型指南。
浏览器JavaScript批量下载多个文件的实现方法与限制
作者:小圆点
时间:2026-10-30
浏览:579
文章目录
在前端业务开发中,将报表、图片或文档批量导出至本地是极为高频的需求。由于浏览器的安全防护体系和运行机制限制,网页并不能像桌面端程序一样自由写入本地目录。本文将直接梳理在浏览器纯前端环境中实现多文件批量下载的三种成熟方案,结合完整代码演示其调度逻辑,并深入解析浏览器的并发拦截机制、跨域约束与内存边界,帮助你在技术选型时做出最可靠的决策。
一、核心技术路径概览
实现浏览器端多文件批量下载,主流路径通常有三条:
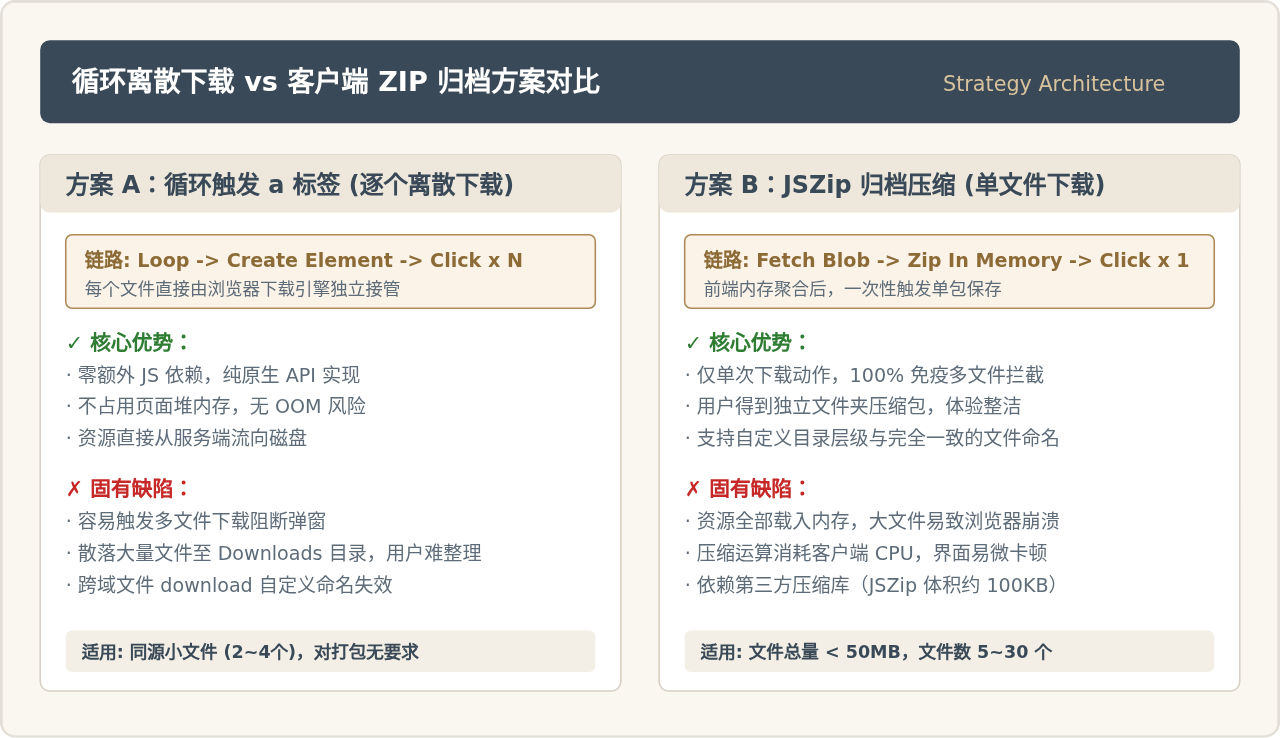
- 动态模拟 <a download> 结合延时队列:最轻量原生方案,通过 DOM 动态生成超链接节点并触发点击事件。适合文件数量较少、总大小轻量且资源同源的场景。
- 前端客户端压缩归档(JSZip + Blob):将所有目标文件通过异步请求拉取至浏览器内存,使用客户端算法打包成单个
.zip压缩包,再触发单次下载。能够彻底绕过浏览器的多文件拦截。 - 服务端打包或流式传输:对于超大文件或几十上百个文件的海量下载,将打包动作转移到后端,前端仅拉取最终生成的归档文件或消费流式数据。
二、方法一:动态触发 a 标签与间隔队列调度
在 HTML5 中,<a> 标签的 download 属性允许网页直接触发保存操作。常规思路是用一个循环遍历 URL 列表并连续点击:
// 错误示范:同步高频触发会导致后续文件被浏览器全部吞掉
function triggerBatchNaive(urls) {
  urls.forEach((url, index) => {
    const a = document.createElement('a');
    a.href = url;
    a.download = `file_${index + 1}`;
    document.body.appendChild(a);
    a.click();
    document.body.removeChild(a);
  });
}
如果直接运行上述代码,你会发现浏览器通常只会保存第一个文件,后续请求会被静默丢弃,或者直接触发浏览器的恶意多文件弹窗警告。
原因在于浏览器的滥用防护机制:在一个用户交互事件(如一次按钮点击)中,主线程只允许立即触发一次默认行为。短时间内密集触发大量下载动作,会被识别为仿冒恶意软件刷写磁盘。
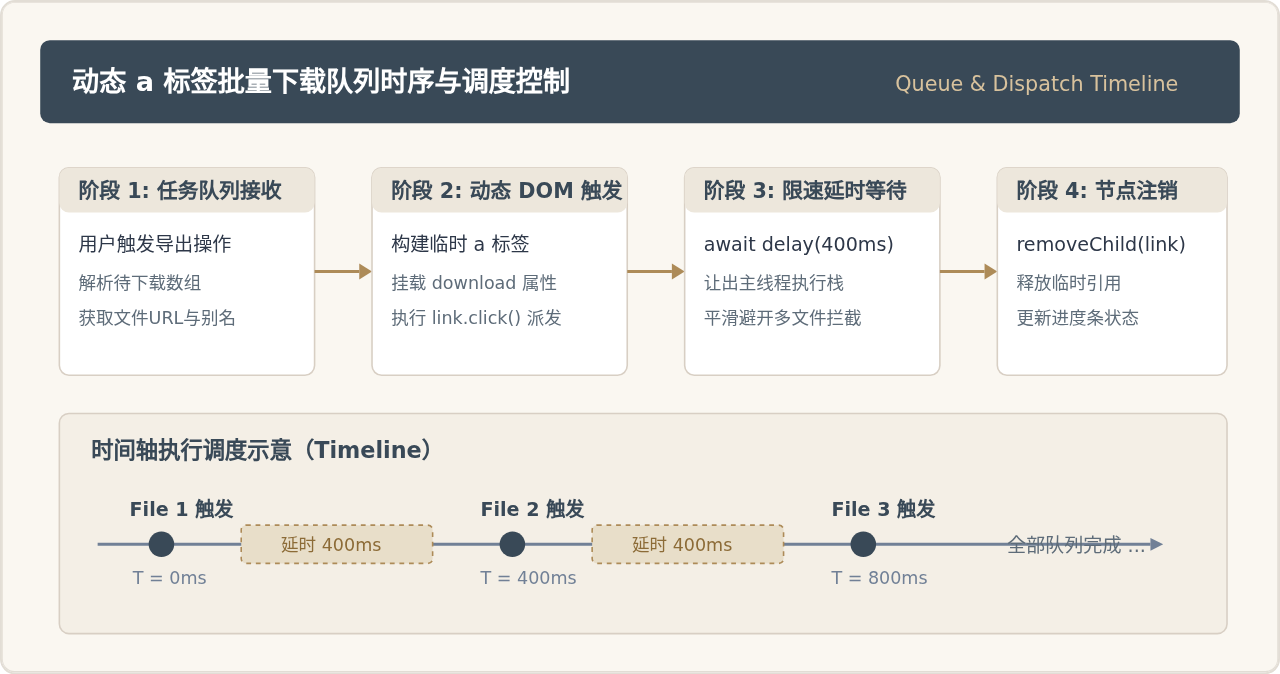
稳健解决方案:构建一个异步调度队列,对下载任务进行限速,在每次触发下载之间注入合理的延时(通常建议 300ms ~ 500ms),给浏览器下载管理器留出调度缓冲。
/**
 * 具有间隔调度的 a 标签批量下载器
 * @param {Array<{url: string, filename: string}>} files 待下载文件列表
 * @param {number} delay 每次下载触发的间隔时间(毫秒)
 */
async function downloadFilesWithInterval(files, delay = 400) {
  for (let i = 0; i < files.length; i++) {
    const { url, filename } = files[i];

    // 动态构建 a 标签
    const link = document.createElement('a');
    link.href = url;
    link.style.display = 'none';
    if (filename) {
      link.download = filename;
    }

    document.body.appendChild(link);
    link.click();

    // 及时清理 DOM 节点,避免内存残留
    setTimeout(() => {
      document.body.removeChild(link);
    }, 100);

    // 如果不是最后一个文件,等待设定时间后再执行下一轮
    if (i < files.length - 1) {
      await new Promise(resolve => setTimeout(resolve, delay));
    }
  }
}
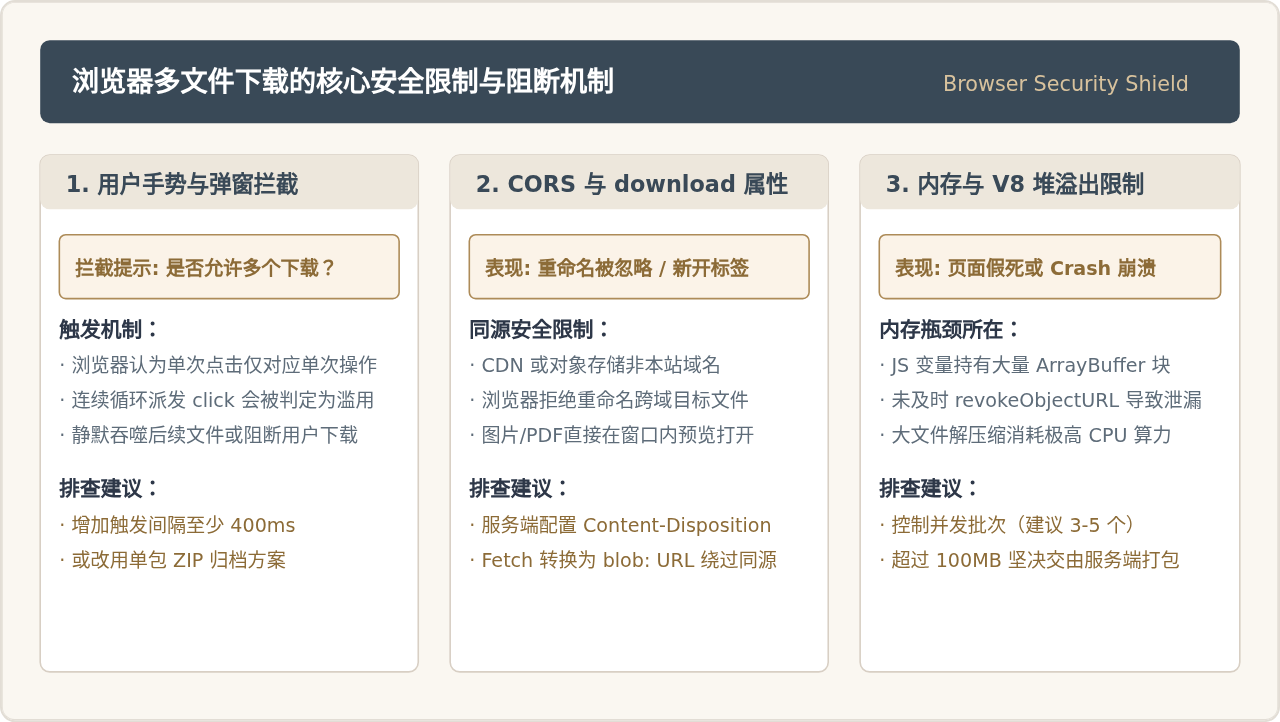
三、浏览器的关键限制与阻断机制分析
即便加入间隔调度,纯前端通过连续触发下载依然存在多项无法回避的底层限制:
1. 用户手势失效与自动下载权限拦截
现代 Chromium(Chrome / Edge)内核引入了严格的权限策略。当单次点击产生后续连续的下载意图时,浏览器会直接在地址栏右侧弹出安全提示:“该网站想要下载多个文件,是否允许?” 若用户随手点击了“禁止”,则该域名后续的所有连续下载请求将被永久静默阻断,直到用户手动清理站点权限设置。
2. 跨域(CORS)导致 download 属性重命名失效
HTML 规范严格规定:<a download="new_name.pdf"> 仅在目标资源与当前网页属于同源(Same-Origin),或是 blob: / data: 协议时生效。
如果目标文件托管在独立的 CDN 或 OSS 存储桶上,且没有开启代理同源转发,即使设置了 download 属性,浏览器也会直接忽略自定义文件名,甚至在很多情况下直接在当前页面或新窗口打开该文件(例如 PDF 或图片),破坏下载预期。
跨域资源强制下载的临时解法:
对于跨域文件,如果服务端配置了 Access-Control-Allow-Origin: *,前端可以先通过 fetch(url) 将响应体拉取为二进制 Blob,随后使用 URL.createObjectURL(blob) 生成同源虚拟链接,此时 download 属性便能正常重命名并触发下载。
3. 内存开销与主线程并发限制
在批量拉取资源时,如果同时发起几十个 fetch 并将它们驻留在内存的 Blob 缓冲区中,浏览器的 V8 堆内存很容易出现指数级攀升。对于移动端浏览器或内存受限的环境,单页面内存占用一旦触碰几百兆上限,便会直接触发标签页崩溃(Out of Memory)。
四、方法二:客户端 JSZip 打包为单文件下载
为了从根本上规避“多文件弹窗拦截”,同时给用户交付整洁有序的文件归档,业内广泛采用的方案是在浏览器内使用 JSZip 库将全部文件压缩成一个 .zip 包,最终仅执行一次原生下载。
核心执行流程
- 使用
fetch发起并发受控的异步网络请求,将每个文件读取为Blob或ArrayBuffer。 - 调用
zip.file(filename, data)将二进制载荷挂载进虚拟压缩目录树。 - 调用
zip.generateAsync({ type: 'blob' })计算生成最终的压缩包 Blob。 - 生成本地同源虚拟链接
URL.createObjectURL(zipBlob),触发单次a.click()。 - 在下载派发完毕后,调用
URL.revokeObjectURL释放内存空间。
import JSZip from 'jszip';

/**
 * 客户端并发拉取并打包成 ZIP 下载
 * @param {Array<{url: string, filename: string}>} items 待下载文件列表
 * @param {string} zipName 输出的压缩包名称
 * @param {Function} onProgress 进度回调 (percent) => void
 */
async function downloadAsZip(items, zipName = 'archive.zip', onProgress) {
  const zip = new JSZip();
  let completed = 0;

  // 1. 并发请求受控拉取文件内容
  const fetchPromises = items.map(async (item) => {
    try {
      const response = await fetch(item.url);
      if (!response.ok) {
        throw new Error(`下载失败: ${item.url} 状态码 ${response.status}`);
      }
      const arrayBuffer = await response.arrayBuffer();

      // 写入 zip 文件节点
      zip.file(item.filename, arrayBuffer);

      completed++;
      if (typeof onProgress === 'function') {
        onProgress(Math.round((completed / items.length) * 50)); // 前50%为下载阶段
      }
    } catch (err) {
      console.error(`拉取文件异常: ${item.filename}`, err);
    }
  });

  await Promise.all(fetchPromises);

  // 2. 生成本地压缩包 Blob
  const zipBlob = await zip.generateAsync(
    {
      type: 'blob',
      compression: 'DEFLATE',
      compressionOptions: { level: 6 }
    },
    (metadata) => {
      if (typeof onProgress === 'function') {
        // 后50%为压缩打包进度
        onProgress(50 + Math.round(metadata.percent / 2));
      }
    }
  );

  // 3. 触发单次安全下载
  const downloadUrl = URL.createObjectURL(zipBlob);
  const a = document.createElement('a');
  a.href = downloadUrl;
  a.download = zipName;
  document.body.appendChild(a);
  a.click();

  // 4. 清理资源与释放内存
  setTimeout(() => {
    document.body.removeChild(a);
    URL.revokeObjectURL(downloadUrl);
  }, 1000);
}
五、海量与超大文件场景的工程化解法
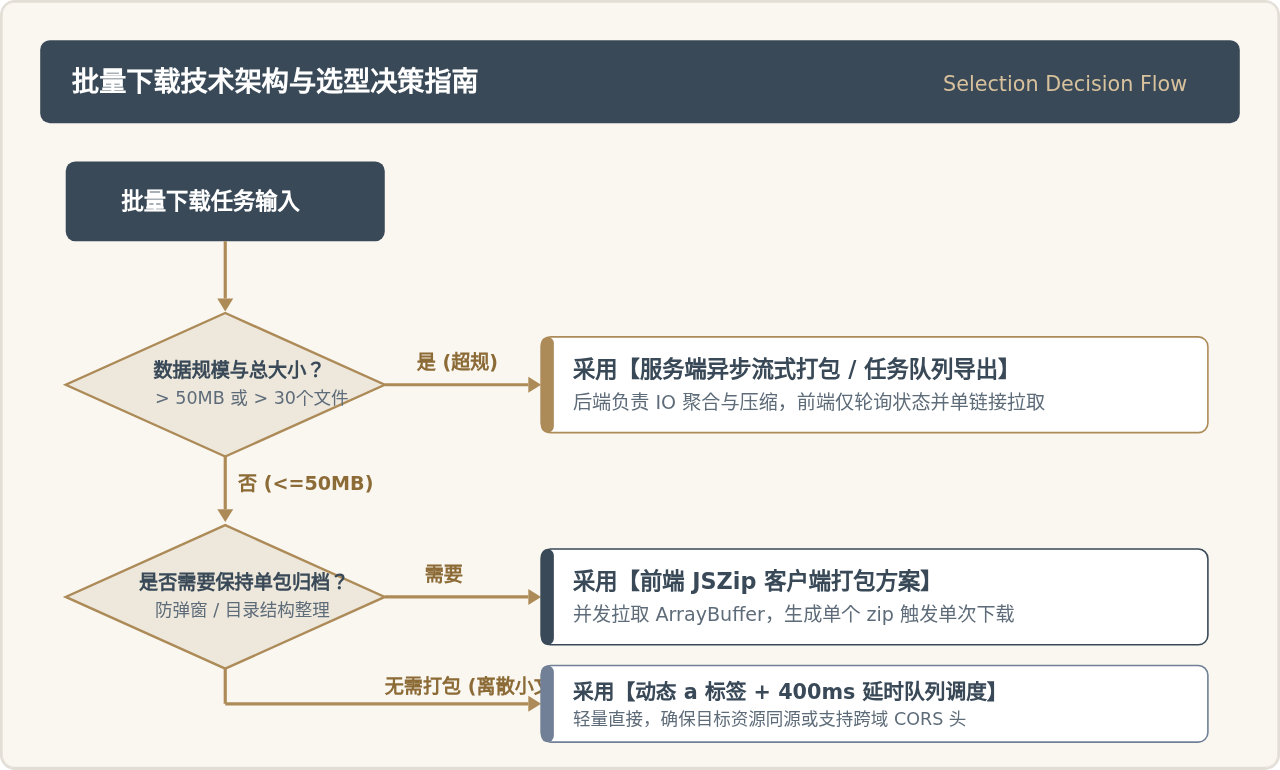
当业务需求涉及 总容量超过 100MB,或 单次下载成百上千个小文件 时,纯客户端方案无论怎么优化调度,都会遭遇移动端闪退或内存溢出的物理上限。此时必须引入以下高级工程方案:
1. 服务端异步任务归档(首选方案)
客户端仅向服务端提交包含 file_ids 的下载请求,服务端在后台工作进程(Worker/Celery)中拉取文件、执行流式压缩,并将打包好的 ZIP 上传至对象存储,返回一个有时效性的下载 URL。前端只需等待任务完成后触发单个文件的下载。这是绝大多数企业级 SaaS 系统的标准做法。
2. 前端流式管道写入(StreamSaver.js / File System Access API)
现代浏览器已开始支持 TransformStream 和 File System Access API(showSaveFilePicker)。利用这些规范,可以让网络拉取的每个数据分片(Chunk)在流经 Service Worker 时即时组装为 ZIP 头,并直接流式刷入用户本地磁盘,完全不经过内存 Blob 的二次缓存,从而实现前端“无限体积”压缩下载。
六、生产环境常见避坑清单
| 潜在问题 | 现象与诱因 | 标准排查与修复方法 |
|---|---|---|
| 内存泄漏 | 批量下载后页面内存居高不下,长时间运行后崩溃 | 在每个 URL.createObjectURL(blob) 触发下载后,必须使用 setTimeout 延时调用 URL.revokeObjectURL(url) 释放内存映射引用。 |
| 跨域图片直接打开 | 点击下载后浏览器并未保存,而是在新标签页中打开了原图 | 跨域资源的 download 属性被忽略。必须改用 fetch(url) 转化为本地 blob: 协议链接后再触发 download。 |
| 批量下载中途被吞 | 列表有 10 个文件,实际只下载了第 1 个,其余全部无反应 | 触发频率过高,被浏览器识别为恶意刷盘。在循环之间加入 await new Promise(r => setTimeout(r, 400)),或改用 JSZip 打包。 |
| 移动端 WebView 无法下载 | 在 iOS / Android 原生 App 内嵌网页中点击无任何响应 | 原生 WebView 默认未实现对 blob: 协议或动态 download 属性的处理。需要客户端开发人员覆写 shouldOverrideUrlLoading 或开放原生下载桥接接口。 |
七、总结
在浏览器环境中实现批量下载,本质上是在用户体验、浏览器安全沙箱规则与系统资源消耗之间寻找平衡:
- 对于数量极少(2~3 个)、同源且体积小的小文件,动态 a 标签配合 400ms 间隔调度是最敏捷轻便的途径。
- 对于文件数量较多、对导出文件命名与归类有严谨要求的中小文件(< 50MB),前端 JSZip 客户端压缩归档能提供极佳的单次交付体验,且免疫拦截。
- 对于超大规模、大容量或音视频报表类资源,切忌在前端硬抗内存压力,交由服务端异步流式归档才是唯一可靠的工程化底线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章