

深入讲解浏览器环境下使用JavaScript实现图片下载并自定义文件名的完整方案。对比HTML5 download属性的限制,结合Fetch API与Canvas画布处理,解决跨域访问、格式转换及内存回收问题。
浏览器JavaScript下载图片并指定文件名:Canvas与Fetch结合实践
作者:页面旅途
时间:2026-10-30
浏览:659
文章目录
在前端开发中,通过 JavaScript 触发图片下载并指定自定义文件名,核心途径是将图片资源转为本地二进制 Blob 数据,再借助动态创建的
<a download="..."> 标签触发保存。本文将详细解析常规链接下载在跨域环境下的局限,并结合 Fetch API 请求与 Canvas 位图绘制两项关键技术,给出覆盖基础改名下载、图片二次编辑与转码导出的完整落地实践。
一、为什么常规的 a 标签 download 属性会失效?
在 HTML5 中,<a> 标签引入了 download 属性,用于告知浏览器该链接应作为文件下载,而非在窗口中打开,其属性值即为默认建议的文件名。例如:
<!-- 理想情况下的下载代码 -->
<a href="https://example.com/images/sample.jpg" download="custom-name.jpg">下载图片</a>
但在实际业务场景中,很多开发者发现该属性常常“失效”:点击链接后,浏览器并没有弹出下载弹窗,更没有应用自定义的文件名,而是直接在当前标签页或新标签页中导航打开了该图片。
这是因为浏览器的同源安全策略(Same-Origin Policy)对 download 属性做出了强制约束:当且仅当目标 URL 与当前页面处于同源关系,或者 URL 使用 blob: / data: 协议时,download 属性指定的自定义文件名才会生效。如果图片链接指向第三方 CDN 或跨域服务器,现代浏览器出于安全防钓鱼考虑,会直接忽略 download 属性,降级为普通的页面导航行为。
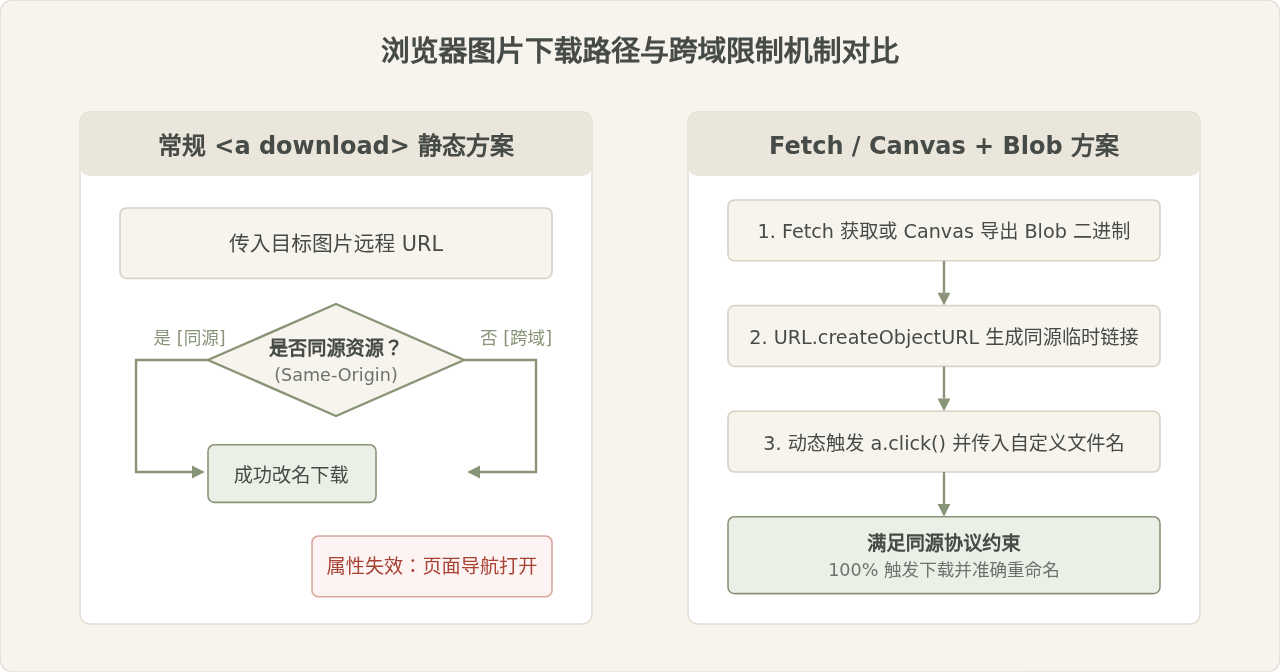
从上图可以看出,解决重命名失效的关键逻辑是:将远程图片下载到浏览器内存中,封装为 Blob 对象,并生成以 blob: 开头的临时同源 URL。此时触发带有 download 属性的链接,浏览器便会严格按照设定的文件名保存文件。
二、通用底层触发:Blob 对象的下载封装
无论数据来自 Fetch 请求的原始响应流,还是来自 Canvas 处理后的位图,触发最终下载的底层逻辑都是一致的。我们首先将这段通用的 DOM 注入与触发逻辑封装为一个独立函数:
/**
 * 接收 Blob 对象并触发浏览器下载
 * @param {Blob} blob - 图片的二进制 Blob 对象
 * @param {string} filename - 期望保存的文件名(包含后缀,如 'avatar.png')
 */
function downloadBlob(blob, filename) {
  // 1. 基于内存中的 Blob 数据创建同源临时访问 URL
  const objectUrl = URL.createObjectURL(blob);

  // 2. 动态创建隐藏的 a 标签
  const link = document.createElement('a');
  link.href = objectUrl;
  link.download = filename || 'downloaded-image';
  link.style.display = 'none';

  // 3. 挂载到 DOM 并触发模拟点击
  document.body.appendChild(link);
  link.click();

  // 4. 清理 DOM 节点与内存中的对象 URL
  document.body.removeChild(link);
  setTimeout(() => {
    URL.revokeObjectURL(objectUrl);
  }, 1000);
}
细节提醒:URL.revokeObjectURL(objectUrl) 用于通知浏览器释放对该 Blob 对象的内部引用,防止单页应用发生内存泄露。由于部分浏览器在执行 link.click() 后需要极短的时间初始化下载任务,立即同步销毁 URL 可能会导致下载中断,因此建议使用 setTimeout 延迟 1 秒左右再执行撤销。
三、方案一:纯 Fetch API 方案(原图无损重命名下载)
如果需求仅是“把远端图片按指定名称下载下来”,且不需要在前端对图片尺寸、水印或画质做任何改动,直接使用 fetch() 是最简洁且性能损耗最小的方案。
/**
 * 通过 Fetch 获取图片 Blob 并下载
 * @param {string} imageUrl - 图片网络地址
 * @param {string} filename - 保存的文件名
 */
async function downloadImageByFetch(imageUrl, filename) {
  try {
    const response = await fetch(imageUrl, {
      method: 'GET',
      mode: 'cors' // 确保发起 CORS 请求
    });

    if (!response.ok) {
      throw new Error(`HTTP 请求失败,状态码: ${response.status}`);
    }

    // 将响应体转换为二进制 Blob
    const blob = await response.blob();
    downloadBlob(blob, filename);
  } catch (error) {
    console.error('Fetch 下载图片失败:', error);
    throw error;
  }
}
前置约束条件:使用 Fetch 下载图片的前提是图片服务器支持 CORS(跨域资源共享),即响应头中包含有效的
Access-Control-Allow-Origin。如果图片所在服务器未配置 CORS,Fetch 请求将直接在控制台抛出跨域拦截错误。
四、方案二:Canvas 结合 Fetch(图片编辑、转码与二次处理)
许多业务不仅仅需要改名下载,还需要对图片进行二次处理,例如压缩体积、修改分辨率、格式转码(例如将 WebP 转换为 JPG)、打水印或裁剪用户头像。此时,必须引入 HTML5 Canvas 画布。
1. 完整操作链路
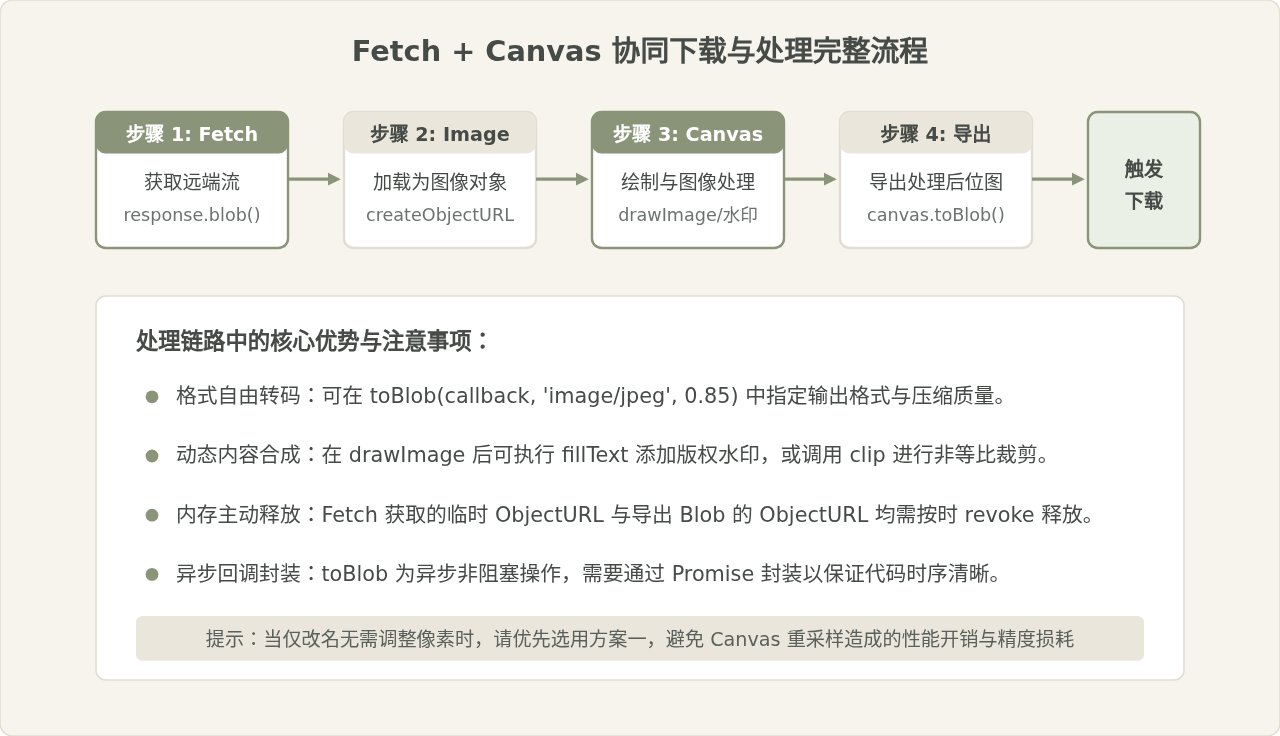
Fetch 与 Canvas 结合时,推荐的标准链路为:先通过 Fetch 获取图片 Blob,将 Blob 转化为临时 URL 赋值给 Image 元素,在图片加载完成后绘制入 Canvas,利用 Canvas API 处理像素,最后调用 canvas.toBlob() 导出并下载。
2. 实战完整代码实现
以下代码演示了完整的集成函数:从指定 URL 获取图片,将其按比例等宽缩放到指定尺寸,并在右下角打上水印文字,最后导出为指定质量的 JPEG 图片并自定义文件名下载。
/**
 * Fetch 获取图片并在 Canvas 中二次编辑后下载
 * @param {string} imageUrl - 图片地址
 * @param {string} filename - 保存的文件名
 * @param {object} options - 处理选项
 */
async function processAndDownloadImage(imageUrl, filename, options = {}) {
  const { maxWidth = 1920, watermarkText = '', quality = 0.92 } = options;

  // 1. 发起 Fetch 请求获取二进制数据
  const response = await fetch(imageUrl, { mode: 'cors' });
  if (!response.ok) {
    throw new Error(`资源下载异常,HTTP ${response.status}`);
  }
  const sourceBlob = await response.blob();
  const sourceUrl = URL.createObjectURL(sourceBlob);

  try {
    // 2. 加载图片到内存中的 Image 对象
    const img = await new Promise((resolve, reject) => {
      const image = new Image();
      image.onload = () => resolve(image);
      image.onerror = () => reject(new Error('图片解析为位图失败'));
      image.src = sourceUrl;
    });

    // 3. 计算等比例缩放尺寸
    let targetWidth = img.naturalWidth;
    let targetHeight = img.naturalHeight;
    if (targetWidth > maxWidth) {
      targetHeight = Math.round((maxWidth / targetWidth) * targetHeight);
      targetWidth = maxWidth;
    }

    // 4. 创建离屏 Canvas 并绘制
    const canvas = document.createElement('canvas');
    canvas.width = targetWidth;
    canvas.height = targetHeight;
    const ctx = canvas.getContext('2d');

    // 绘制主图像
    ctx.drawImage(img, 0, 0, targetWidth, targetHeight);

    // 5. 可选:添加半透明文字水印
    if (watermarkText) {
      ctx.font = '20px sans-serif';
      ctx.fillStyle = 'rgba(255, 255, 255, 0.7)';
      ctx.textAlign = 'right';
      ctx.textBaseline = 'bottom';
      ctx.fillText(watermarkText, targetWidth - 20, targetHeight - 20);
    }

    // 6. 将 Canvas 导出为指定格式的 Blob
    const outputBlob = await new Promise((resolve, reject) => {
      canvas.toBlob(
        (blob) => {
          if (blob) {
            resolve(blob);
          } else {
            reject(new Error('Canvas 导出 Blob 失败'));
          }
        },
        'image/jpeg',
        quality
      );
    });

    // 7. 触发最终下载
    downloadBlob(outputBlob, filename);
  } finally {
    // 务必释放初始的 ObjectURL
    URL.revokeObjectURL(sourceUrl);
  }
}
五、深度辨析:常见迷思与容易混淆的认知
迷思一:“只要我用了 Canvas,就能绕过图片跨域防盗链?”
常见误区:部分开发者认为,既然 <img> 标签可以直接在页面上渲染跨域图片,那么把跨域图片画到 <canvas> 里再调用 canvas.toDataURL() 或 canvas.toBlob() 就能实现“任意跨域图片随心下载”。
客观事实:这种理解恰恰与浏览器的安全机制相反。HTML5 允许在页面上展示跨域图片(视听展示不受 CORS 限制),但一旦将跨域图片绘制到 Canvas 且该图片未获得跨域许可,浏览器就会将该 Canvas 标记为“被污染(Tainted Canvas)”。
被污染的 Canvas 依然能在页面上正常渲染显示,但所有的像素读取接口(包括 toBlob()、toDataURL()、getImageData())都会立即抛出 SecurityError 严重异常,导致导出完全失败。
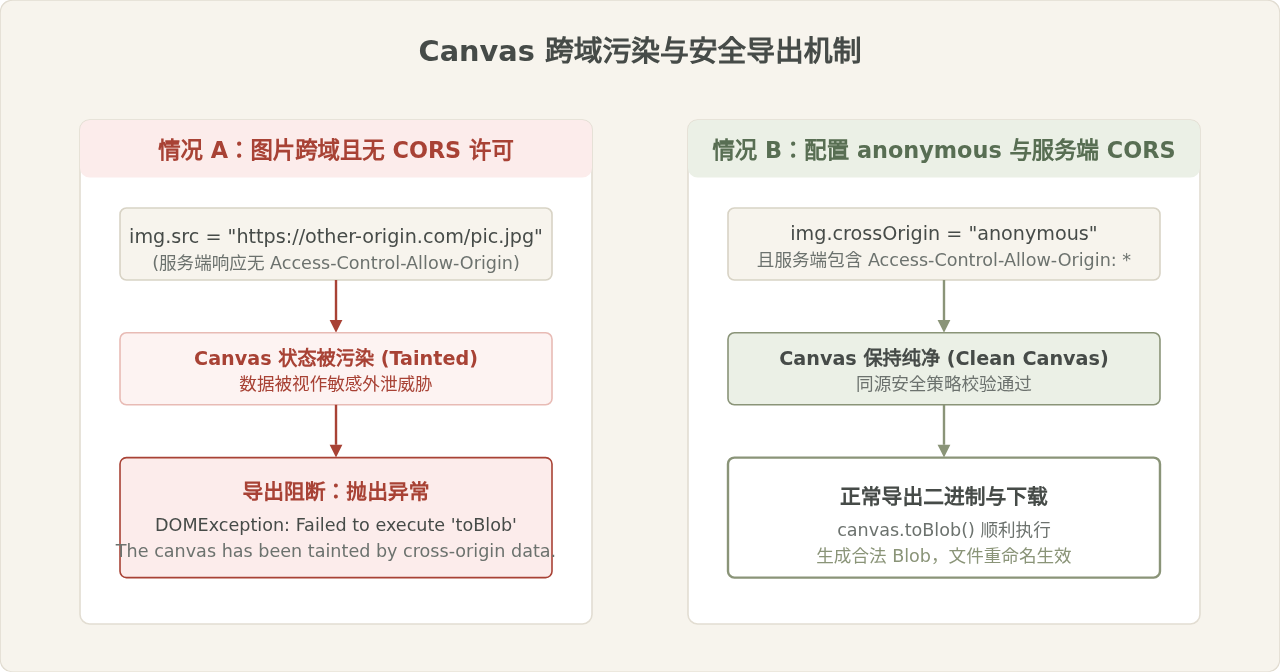
因此,如果图片服务器没有配置 CORS 响应头,纯前端无论如何折腾 Canvas,都无法突破同源限制。此时唯一的解决办法是由业务后端提供反向代理或由服务端直连下载接口。
迷思二:“canvas.toDataURL() 更加直观,为什么要优先选 canvas.toBlob()?”
在早期前端教学中,经常能看到 link.href = canvas.toDataURL('image/png') 的代码写法。这种写法在小图标场景下能够运行,但在真实生产环境中并不推荐,原因如下:
- 体积剧增:Base64 字符串相比原始二进制会有约 33% 的体积膨胀,对于一张 5MB 的高清照片,生成的 Base64 字符串将占用近 7MB 内存。
- 主线程卡顿:
toDataURL()是同步执行的。如果图片分辨率较高(例如 4K 图片),在主线程将数百万像素数据编码为超长字符串会造成明显的页面掉帧与卡顿。 - URL 字符上限:某些浏览器对单个 URL 字符串的长度有隐式限制,超长 Data URL 偶尔会导致下载任务静默失败。
而 canvas.toBlob() 是浏览器原生支持的异步非阻塞 API,且导出的 Blob 直接在底层内存池以二进制格式存储,配合 URL.createObjectURL() 仅生成一个短小的引用标识符,性能和稳定性大幅领先。
六、实践总结与技术选型建议
在掌握了上述底层逻辑后,在面对不同的业务需求时,可以参考以下选型决策:
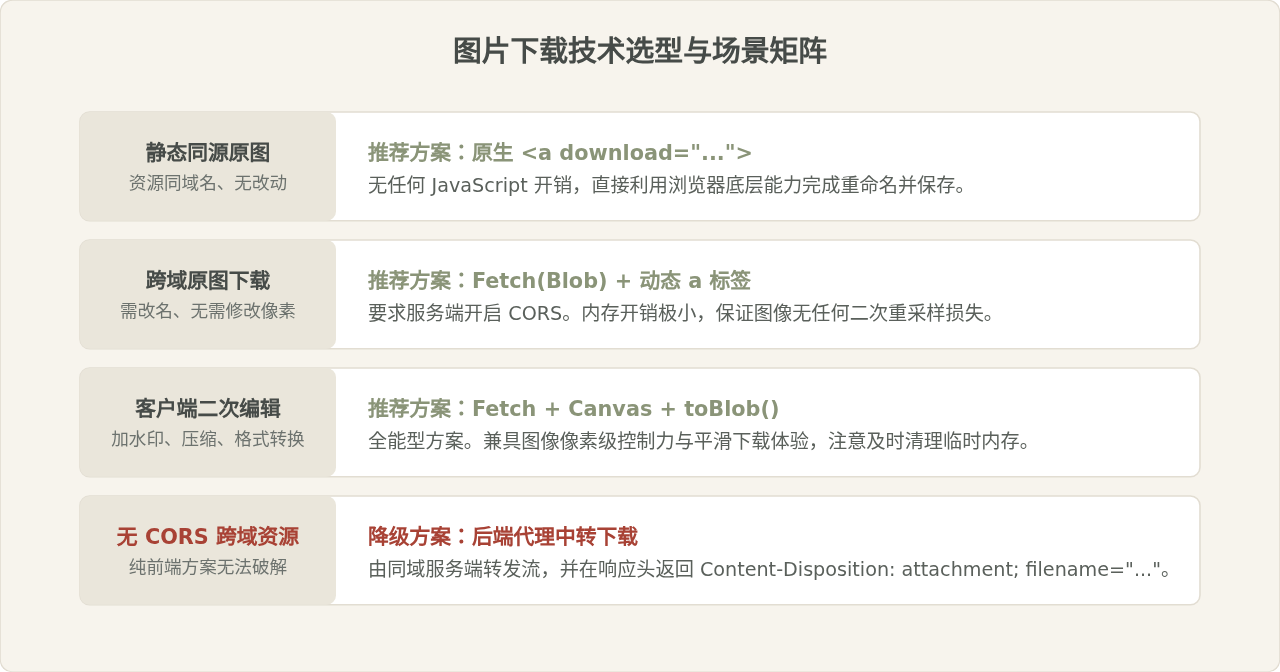
总结而言,在前端实现图片重命名下载的核心逻辑是“将数据转化为同源 Blob 标识符”。当面对纯下载诉求时,使用轻量的 Fetch API 即可满足;当面对画质压缩、水印注入与尺寸调整等更丰富的交互场景时,结合 Canvas 的 toBlob() 是最稳健的工业级标准方案。始终关注同源策略与内存对象的及时销毁,便能构建出健壮的前端图片导出功能。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章