

深入剖析JavaScript前端下载大文件时引起浏览器崩溃的根本原因,详细介绍原生流式下载、Fetch Streams API管道写入、Web Worker与OPFS分片续传等多种落地优化方案及代码实现。
JavaScript下载大文件导致浏览器崩溃的优化方案
作者:巡夜人
时间:2026-10-30
浏览:486
文章目录
在前端业务开发中,通过 JavaScript 下载文件的常规做法是先用 Ajax 或 Fetch 请求资源,将其转换为 Blob 对象,再借助 URL.createObjectURL() 生成伪链接触发下载。当下载文件体积在几十兆以内时,这种方式简单且易于添加进度提示或鉴权头;但当文件体积达到数百兆乃至数吉字节(GB)时,浏览器标签页极易出现卡死、无响应,最终报出“内存不足”(Out of Memory)而彻底崩溃。
导致崩溃的核心原因并不是网络传输慢,而是前端代码将整个文件的全部二进制数据一次性塞进了浏览器的 JavaScript 堆栈和渲染进程内存中。本文将从浏览器内存分配机制切入,说明常规方案引发崩溃的物理原因,并提供包括原生流式直链、Fetch Streams API 管道写入、以及 Web Worker 配合 OPFS 分片落盘在内的多套优化与落地方案。
一、为什么前端下载大文件会导致浏览器崩溃?
要解决崩溃问题,首先需要了解常规代码究竟对浏览器内存做了什么。以下是一段非常典型的“前端下载”代码:
// 常见的引发内存崩溃的代码模式
async function downloadFile(url, fileName) {
  const response = await fetch(url);
  // 1. 将网络返回的全部数据完整加载为内存中的 Blob
  const blob = await response.blob();

  // 2. 为堆内存对象创建临时 blob: URL 引用
  const objectUrl = URL.createObjectURL(blob);

  // 3. 构造 a 标签触发浏览器下载
  const a = document.createElement('a');
  a.href = objectUrl;
  a.download = fileName;
  document.body.appendChild(a);
  a.click();
  document.body.removeChild(a);

  // 即使随后调用了 revoke,此时内存峰值早已突破上限
  URL.revokeObjectURL(objectUrl);
}
看似逻辑严密,但在下载 1.5GB 视频或压缩包时,该逻辑会引发三重内存冲击:
- V8 引擎堆内存限制: 现代浏览器(如 Chromium)对单个渲染进程设置了内存安全上限(64 位系统通常在 2GB 到 4GB 之间)。当调用
await response.blob()时,网络底层必须在内存中分配一块连续的缓冲区,用于组装完整的二进制数据。 - 数据副本叠加与垃圾回收滞后: 从网络流传输到内部 ArrayBuffer,再封装成 Blob,数据在内存中可能产生多份临时拷贝。由于垃圾回收机制(GC)并非实时执行,瞬间激增的内存驻留会导致内存占用直接触达上限。
- 渲染主线程受阻: 内存极度紧张时,V8 会频繁触发全局垃圾回收(Full Mark-Sweep),强制挂起主线程渲染循环,表现为页面光标转圈、点击无反应,直至进程被操作系统或浏览器看门狗强行终止。
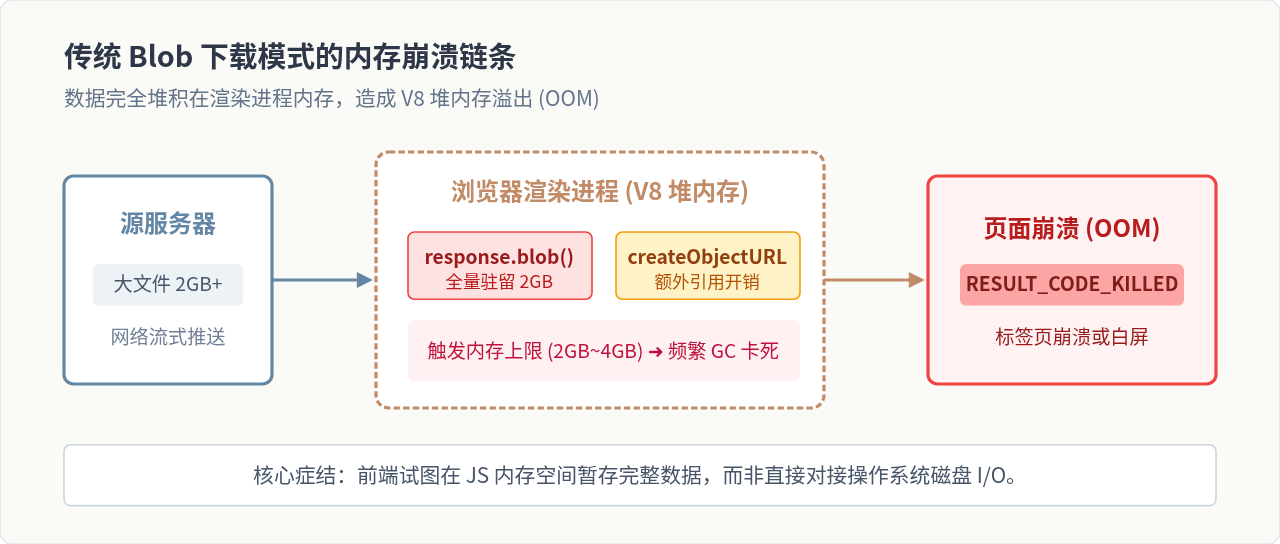
图 1:传统前端全量 Blob 下载模式下的内存积压与崩溃路径
二、优化方案一:回归原生——绕过 JS 堆内存的直链下载
如果所要下载的文件在服务端已经作为实体文件或独立流存在,且不需要前端在请求头中注入特殊的私有 Header,最彻底的优化手段是完全不让数据进入 JavaScript 引擎。
1. 响应头驱动机制
让服务端在响应请求时,配置特定的 HTTP 响应头:
Content-Disposition: attachment; filename="report-archive-2026.zip"
Content-Type: application/octet-stream
只要具备 Content-Disposition: attachment,浏览器底层网络层就会接管下载任务,由系统下载管理器直接将网络流写入本地硬盘。前端页面不消耗任何额外的堆内存,就算文件达到 50GB 也不会引起标签页崩溃。
2. 前端触发实现方式
在前端,可以直接通过创建临时无害的 DOM 链接或重定向发起:
// 原生直链下载:0 内存损耗
function downloadViaDirectLink(fileUrl, fileName) {
  const link = document.createElement('a');
  link.href = fileUrl;
  if (fileName) {
    link.download = fileName;
  }
  link.style.display = 'none';
  document.body.appendChild(link);
  link.click();
  document.body.removeChild(link);
}
常见问题解决:如果下载接口需要鉴权(Authorization Header)怎么办?
直接点击链接或通过 iframe 下载无法注入类似 Authorization: Bearer <token> 的请求头。常见解决途径有两种:
- 短效凭证转换(Ticket / Presigned URL): 先用轻量级 Ajax 请求业务接口申请一个具备短时间时效性(如 60 秒)的签名 URL,例如
https://api.example.com/download/file?ticket=abc123xyz,随后用上述原生直链方式直接打开该签名地址。 - Cookie / Session 自动附带: 将身份凭据下发至同源或关联域名的 HttpOnly Cookie 中,浏览器跳转该链接时会自动带上凭证,实现无缝鉴权。
三、优化方案二:流式落盘——Fetch Streams 与 StreamSaver 管道化
很多业务场景下,前端确实需要使用 fetch 发送复杂的认证头、POST 参数,或者文件内容是由前端动态流式组装而来的。此时,解决崩溃的手段是流式处理(Streaming):边从网络读取一块数据(Chunk),边将这块数据写入磁盘,读完立即释放该 Chunk 的内存占用。
1. 原生 File System Access API 方案
现代桌面 Chromium 浏览器支持原生的 window.showSaveFilePicker(),可以直接在磁盘上创建文件并获取一个 WritableStream 管道:
async function downloadWithFileSystemStream(url, defaultFileName) {
  // 1. 发起网络请求,保持流式通道打开
  const response = await fetch(url);
  if (!response.ok) throw new Error(`HTTP 异常: ${response.status}`);
  if (!response.body) throw new Error('当前环境不支持 ReadableStream');

  // 2. 唤起系统原生保存文件对话框,获得磁盘写入句柄
  const fileHandle = await window.showSaveFilePicker({
    suggestedName: defaultFileName
  });
  const writableStream = await fileHandle.createWritable();

  // 3. 将网络数据流直接管道对接(pipeTo)至磁盘流
  // 期间每个 Chunk(通常 64KB)落盘后即时被内存释放,峰值内存维持在极低水准
  await response.body.pipeTo(writableStream);
  console.log('文件下载并落盘完成');
}
2. 广泛兼容方案:StreamSaver.js 管道模拟
对于不支持 showSaveFilePicker 的浏览器或非安全上下文环境,可以使用成熟的开源方案 StreamSaver.js。其原理非常巧妙:在后台启动一个临时的 Service Worker 拦截请求,前端将 ReadableStream 的数据块逐个 postMessage 发送给 Service Worker,Service Worker 伪装成一个正在下载的真实网络流供浏览器下载管理器捕获,最终实现浏览器自动将流写入磁盘。
// 使用 StreamSaver.js 进行跨浏览器流式下载
async function downloadWithStreamSaver(url, fileName) {
  const response = await fetch(url);
  const fileStream = streamSaver.createWriteStream(fileName, {
    size: response.headers.get('content-length')
  });

  // 如果原生支持 pipeTo
  if (window.WritableStream && response.body.pipeTo) {
    return await response.body.pipeTo(fileStream);
  }

  // 降级兼容:手动循环 reader.read() 消费数据流
  const reader = response.body.getReader();
  const writer = fileStream.getWriter();

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    // 写入当前 64KB 数据块,无需在内存中拼接历史数据
    await writer.write(value);
  }
  await writer.close();
}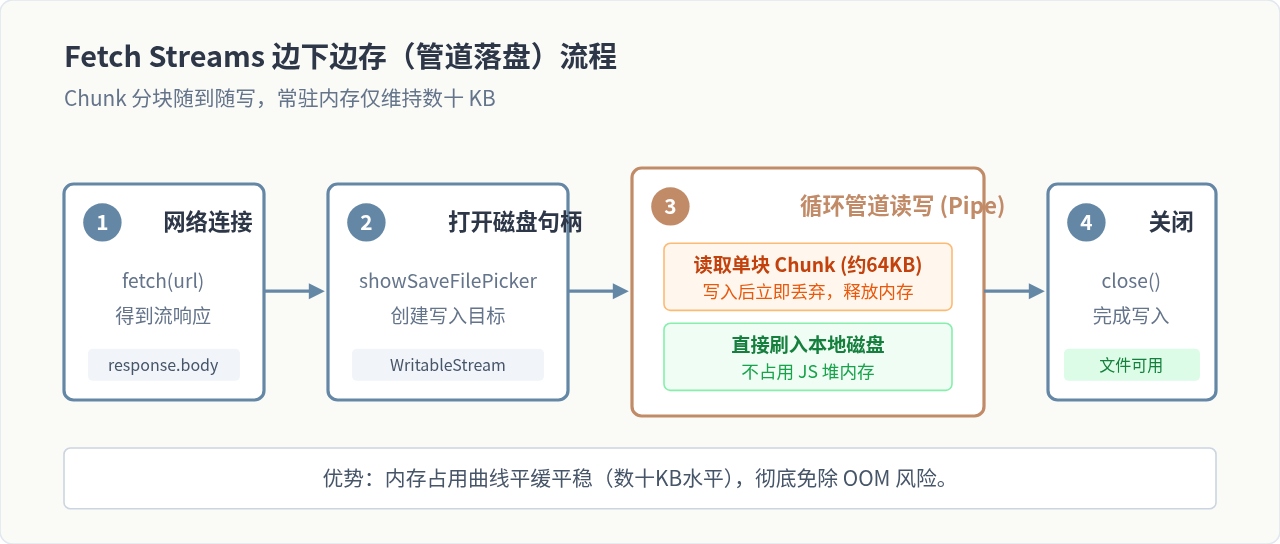
图 2:Fetch Streams 边读边写的流式管道传输步骤
四、优化方案三:大文件分片、Web Worker 与 OPFS 离线聚合
当网络环境不稳定、文件体积高达数吉字节,且要求支持断点续传与多线程并发加速时,单纯依赖单个 HTTP 长连接可能会遭遇网络超时中断。此时,最强韧的方案是利用 HTTP Range 头进行分片,并在后台使用 Web Worker 配合 OPFS(Origin Private File System,源私有文件系统)落盘。
1. 为什么选择 OPFS?
传统的 IndexedDB 存储大文件时存在序列化开销与体积上限,容易造成浏览器数据库异常锁死。而 OPFS 是现代 HTML5 标准提供的私有磁盘沙箱,具备专属的 FileSystemSyncAccessHandle 同步读写句柄(仅能在 Worker 中使用),具备极高的随机读写吞吐能力,且不会占用 JS 堆内存。
2. 分片下载与追加写入核心代码
以下展示在 Web Worker 中通过 Range 头分片获取数据并直接写入 OPFS 的逻辑:
// worker.js: 在独立线程运行,不卡顿页面 UI
self.onmessage = async (e) => {
  const { fileUrl, targetFileName, chunkSize = 10 * 1024 * 1024 } = e.data;

  // 1. 获取文件总大小 (通过 HEAD 请求)
  const headRes = await fetch(fileUrl, { method: 'HEAD' });
  const totalLength = parseInt(headRes.headers.get('content-length'), 10);

  // 2. 在 OPFS 中创建沙箱私有文件
  const root = await navigator.storage.getDirectory();
  const draftHandle = await root.getFileHandle(targetFileName, { create: true });

  // 3. 取得高性能同步写句柄
  const accessHandle = await draftHandle.createSyncAccessHandle();

  let offset = 0;
  while (offset < totalLength) {
    const end = Math.min(offset + chunkSize - 1, totalLength - 1);

    // 分片请求:指定字节区间
    const rangeRes = await fetch(fileUrl, {
      headers: { 'Range': `bytes=${offset}-${end}` }
    });

    const chunkBuffer = await rangeRes.arrayBuffer();

    // 定点写入沙箱文件对应偏移位置
    accessHandle.write(new Uint8Array(chunkBuffer), { at: offset });
    accessHandle.flush();

    offset += chunkBuffer.byteLength;

    // 向主线程通知当前下载进度
    self.postMessage({ type: 'progress', loaded: offset, total: totalLength });
  }

  // 关闭句柄,落盘完毕
  accessHandle.close();
  self.postMessage({ type: 'complete', fileName: targetFileName });
};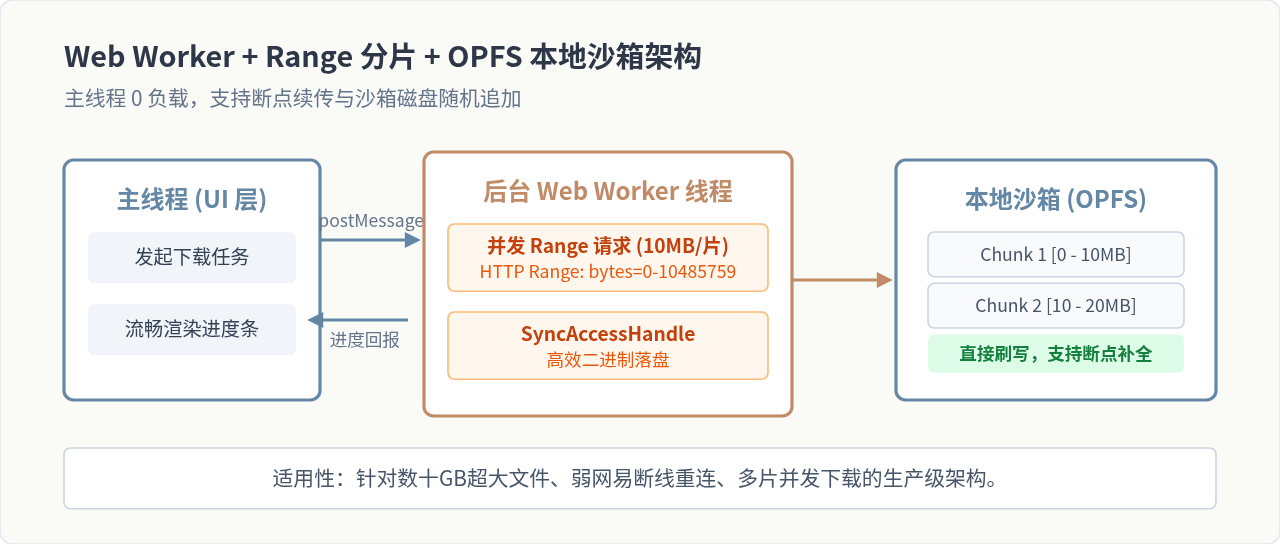
图 3:Web Worker 与 OPFS 分片断点续传的后台处理架构
五、各方案对比与场景选型决策
不同方案在技术门槛、浏览器兼容性以及支持的交互功能上存在明显差异。在实际技术选型中,切忌一味追求最前沿但复杂的架构,应根据业务实际的文件体积与鉴权方式做合理取舍:
| 技术方案 | 内存消耗 | 文件体积极限 | 鉴权自定义能力 | 断点续传支持 | 主要适用场景 |
|---|---|---|---|---|---|
| 传统 Blob 内存拼接 | 极高 (全量堆积) | 约 100MB 以内 | 优秀 (任意请求头) | 较难 | 仅适用于小尺寸报表导出、图片下载 |
| 原生直链 / a 标签 | 无 (0 内存开销) | 无限制 (数十 GB) | 一般 (需 Query 参数或 Cookie) | 依赖浏览器内置下载器 | 静态安装包、视频资源、已有存储直链 |
| Fetch Streams 管道写入 | 极低 (固定 64KB) | 取决于本地磁盘容量 | 优秀 (Fetch 原生 Header) | 需自定义逻辑 | 动态大文件、需要携带 Authorization 头 |
| Worker + Range + OPFS | 极低 (仅维持分片) | 无限制 | 优秀 | 原生完美支持 | 专业网盘、GB 级工业图纸、断点续传系统 |
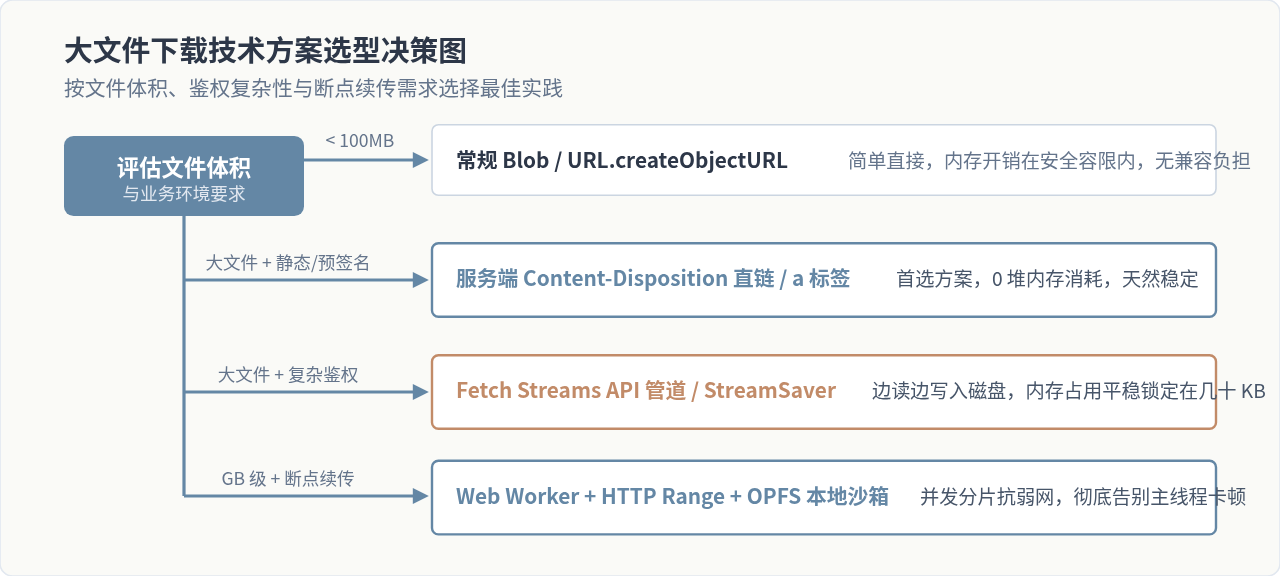
图 4:大文件下载技术方案选型决策图
六、工程落地注意事项
- 必须及时回收已创建的临时 URL: 若在过渡期仍有部分中小文件使用
URL.createObjectURL(blob),在触发a.click()后务必在下一轮事件循环中调用URL.revokeObjectURL(url),否则该内存块会一直驻留在内存中直到标签页关闭。 - 正确配置跨域与响应头暴露出 Content-Length: 当使用 Streams API 或前端计算下载进度时,跨域服务端需在 CORS 响应头中显式加上
Access-Control-Expose-Headers: Content-Length, Content-Disposition,否则前端response.headers.get('content-length')会返回null,无法计算准确的总进度。 - HTTPS 安全上下文要求: 原生文件系统接口(如
showSaveFilePicker、OPFS 的createSyncAccessHandle)均强制要求在安全上下文(HTTPS 或本地localhost)下运行,部署生产环境时须确保网站已启用 SSL。
综上所述,解决 JavaScript 下载大文件导致浏览器崩溃的核心法则在于“切断将全量二进制数据装入 JS 堆内存的链路”。通过服务端直链、浏览器流式管道落盘或后台沙箱分片写入,可以从根本上摆脱 V8 内存限制,实现高稳定性、高体验的大文件下载。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章