
深入解析JavaScript中Array.prototype.sort()方法的核心机制与实战场景。涵盖默认字典序陷阱、比较函数工作原理、多属性对象排序、中文拼音排序、原地修改副作用及现代toSorted()替代方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组排序sort()方法实战实例解析
作者:半夏
时间:2026-10-30
浏览:131
文章目录
JavaScript 中的 Array.prototype.sort() 是日常业务开发中处理数据排布最常用的原生 API 之一。该方法会直接修改原数组并返回该数组的引用。如果不向其传入自定义比较函数,默认会把数组中的所有元素转换为字符串并按照 UTF-16 码元顺序进行字典序排序。理解这一底层机制、掌握 compareFn 比较函数的决策逻辑,以及知晓现代非破坏性替代方案,是写出正确且健壮数组排序代码的关键。
一、sort() 默认行为与常见“数值排序陷阱”
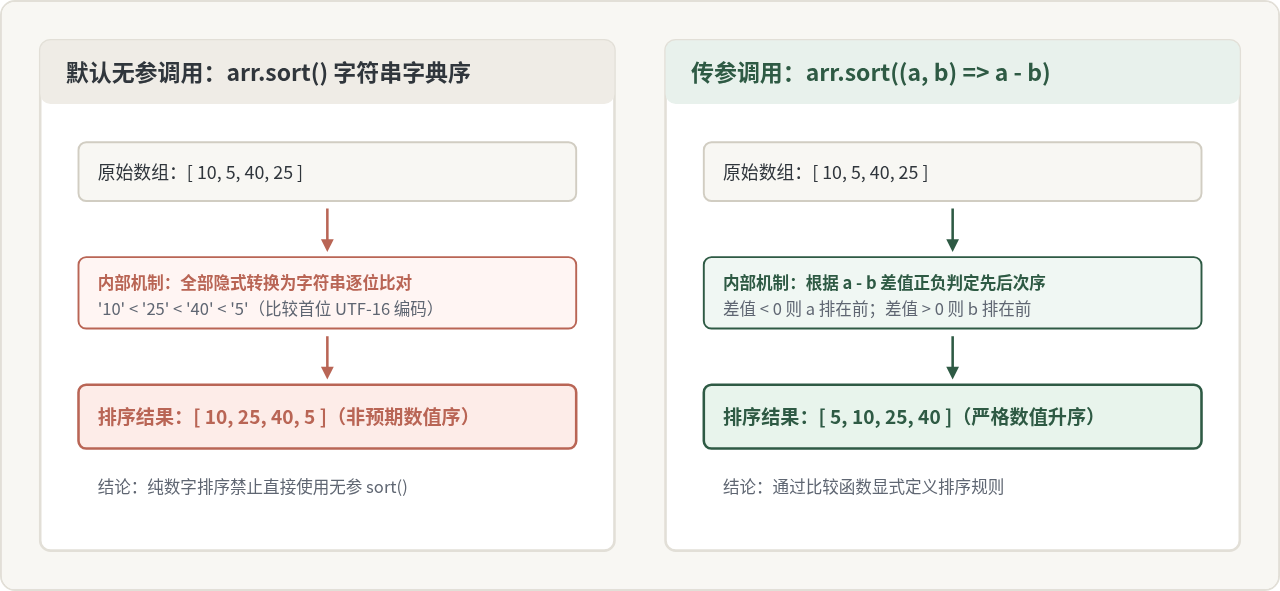
初学者在使用 sort() 时最常遇到的困惑是数值排序结果不合预期。例如对包含数字 [10, 5, 40, 25] 的数组直接调用 sort(),得到的结果并不是升序的 [5, 10, 25, 40],而是 [10, 25, 40, 5]。
const numbers = [10, 5, 40, 25];
numbers.sort();

// 实际输出: [10, 25, 40, 5]
console.log(numbers);
出现这一现象的原因在于:ECMAScript 规范明确规定,在未提供比较参数时,数组元素会被隐式调用 toString() 转换为字符串。在字符串比对中,'10' 的首字符是 '1',Unicode 编码为 49;'25' 的首字符是 '2',Unicode 编码为 50;而 '5' 的 Unicode 编码为 53。按字符逐位比对,'1' < '2' < '4' < '5',因此 10 会排在 5 的前面。
二、比较函数(compareFn)的核心决策逻辑
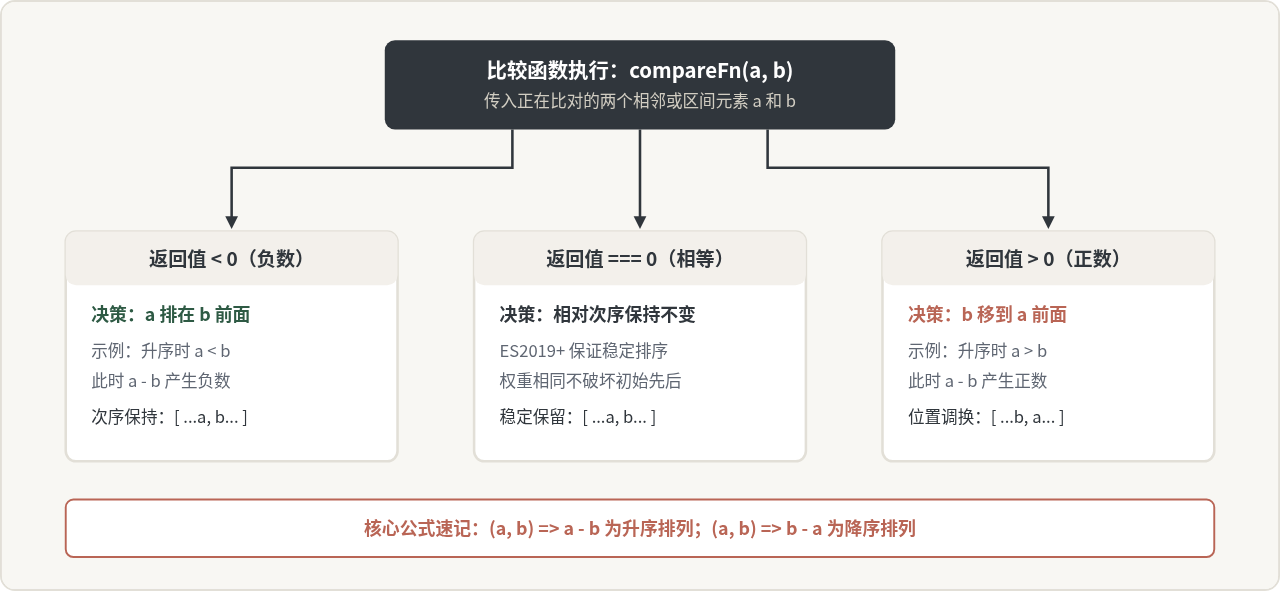
为了精确控制数组元素的顺序,必须向 sort() 传入一个接收两个参数 (a, b) 的比较函数 compareFn。底层排序算法(现代主流引擎如 V8 采用的是 TimSort 混合排序算法)在比对数组元素时,会依据比较函数的返回值来决定两个元素的相对排列位置。
返回值与排序规则的对应契约:
- 小于 0(负数):元素
a会被排在b的前面。 - 等于 0:
a和b的相对位置保持不变。自 ECMAScript 2019(ES10)开始,规范强制要求sort()必须是稳定排序(Stable Sort)。 - 大于 0(正数):元素
b会被排在a的前面。
三、实战场景实例解析
1. 基础数值的升序与降序排列
对于纯数字数组,最简单直接的比较写法是利用数学相减:
const scores = [85, 92, 73, 60, 99, 85];

// 升序排列 (从小到大)
scores.sort((a, b) => a - b);
console.log('升序结果:', scores); // [60, 73, 85, 85, 92, 99]

// 降序排列 (从大到小)
scores.sort((a, b) => b - a);
console.log('降序结果:', scores); // [99, 92, 85, 85, 73, 60]
注意事项:直接使用
a - b 适用于普通有限数值。如果数组中可能出现极大的正数与极小的负数相减(导致溢出),或者存在 Infinity、NaN 等特殊浮点数时,直接做差可能会破坏严格全序关系。更严谨的做法是使用显式的条件判断:
function safeAscending(a, b) {
  if (a < b) return -1;
  if (a > b) return 1;
  return 0;
}
2. 对象数组的多级条件与优先级排序
在实际业务(如电商列表、报表统计)中,通常需要对复合对象进行多条件排序:先按主条件排序,主条件相同时退回次级条件排序。
假设存在一批商品数据,要求优先按价格由低到高(升序)排布;如果价格完全相同,则按销量由高到低(降序)排布。
const products = [
  { id: 101, name: '键盘', price: 299, sales: 1200 },
  { id: 102, name: '鼠标', price: 199, sales: 3400 },
  { id: 103, name: '耳机', price: 299, sales: 2800 },
  { id: 104, name: '支架', price: 99,  sales: 5000 },
  { id: 105, name: '音箱', price: 299, sales: 1500 }
];

products.sort((itemA, itemB) => {
  // 第一优先级:价格升序
  const priceDiff = itemA.price - itemB.price;
  if (priceDiff !== 0) {
    return priceDiff;
  }
  // 第二优先级:销量降序
  return itemB.sales - itemA.sales;
});

console.log(products);
// 排序后顺序:
// 1. 支架 (99元)
// 2. 鼠标 (199元)
// 3. 耳机 (299元, 销量2800)
// 4. 音箱 (299元, 销量1500)
// 5. 键盘 (299元, 销量1200)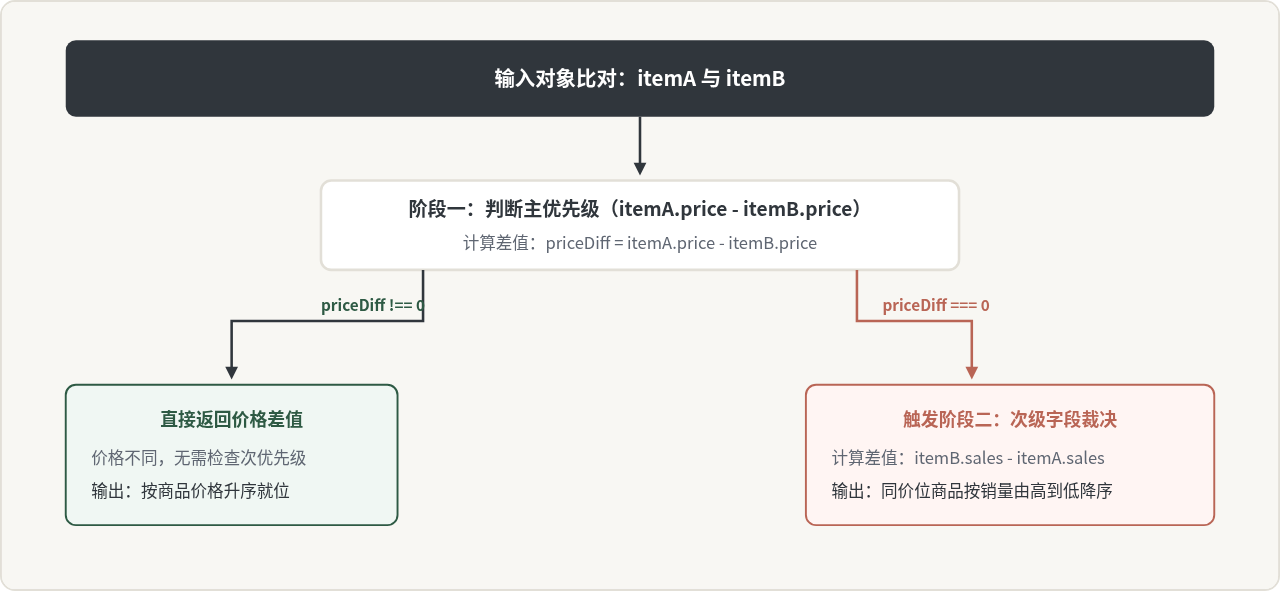
3. 中文字符串与多语言拼音排序(localeCompare)
如果对中文字符串数组直接使用默认的 sort(),其比较依据依然是字符的 Unicode 码点。然而中文字符的 Unicode 顺序并不等于汉语拼音字母表顺序。例如 ['张三', '李四', '王五', '赵六'] 默认排序后,“李”可能会排在最后。
在中文应用场景中,正确的做法是结合 String.prototype.localeCompare 并指定语言环境 'zh-CN':
const names = ['赵六', '张三', '李四', '王五', '安七'];

// 错误做法:按Unicode码点排序
const defaultOrder = [...names].sort();
console.log('默认排序结果:', defaultOrder);
// 结果受限于字符编码分段,并非拼音顺序

// 正确做法:按中文拼音字典顺序升序
names.sort((a, b) => a.localeCompare(b, 'zh-CN'));
console.log('拼音升序结果:', names);
// 输出: ['安七', '李四', '王五', '张三', '赵六']
// 对应首拼: A(安) -> L(李) -> W(王) -> Z(张) -> Z(赵)
4. 基于自定义业务权重字典的映射排序
很多业务流程中,排序依据并非单纯的字母或数值,而是一个预设的工单状态、严重级别或权限等级。例如订单状态按 ['pending', 'processing', 'completed', 'cancelled'] 顺序排列。
处理这类需求的最优模式是通过字典映射权重值:
const orders = [
  { id: 1, status: 'cancelled' },
  { id: 2, status: 'pending' },
  { id: 3, status: 'completed' },
  { id: 4, status: 'processing' }
];

// 定义状态优先级权重字典
const statusPriority = {
  urgent: 0,
  pending: 1,
  processing: 2,
  completed: 3,
  cancelled: 4
};

orders.sort((a, b) => {
  const rankA = statusPriority[a.status] ?? 999;
  const rankB = statusPriority[b.status] ?? 999;
  return rankA - rankB;
});

console.log(orders);
// 状态将精准按照 pending -> processing -> completed -> cancelled 排布
四、避坑指南:副作用、稀疏数组与现代 toSorted()
熟练运用 sort() 的同时,必须警惕其底层特征带来的潜在缺陷与运行时异常。
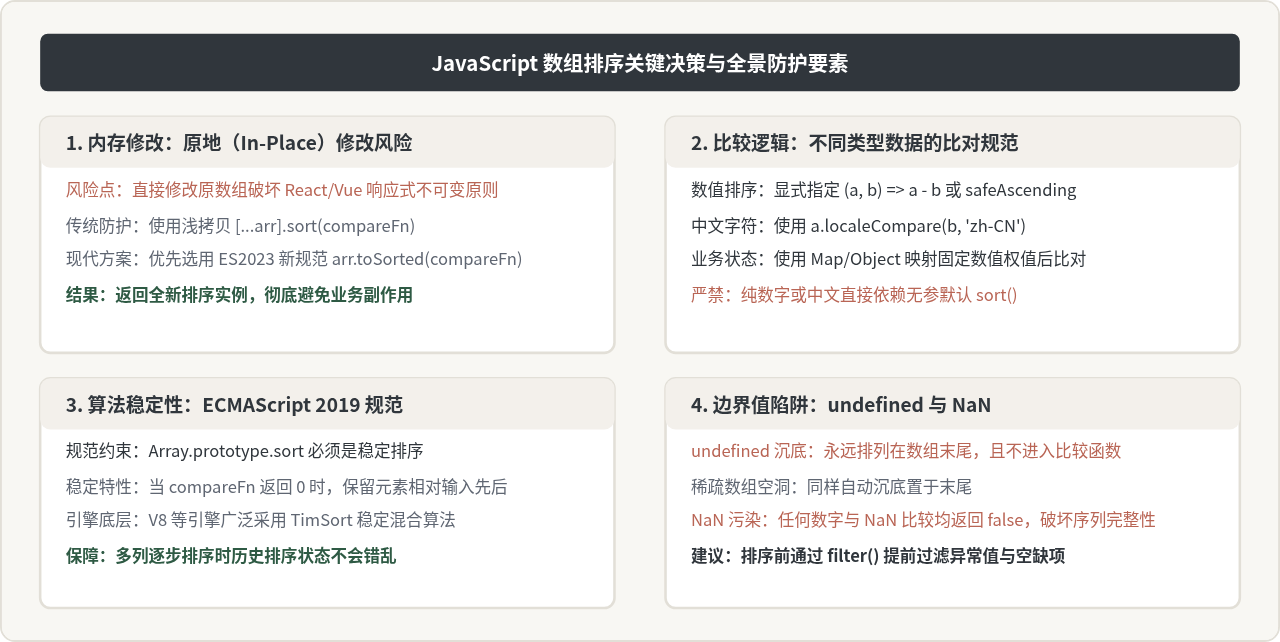
1. 原地修改(Mutation)与响应式状态陷阱
arr.sort() 是一个具有破坏性(Destructive)的操作,它不会开辟新数组,而是直接在原有内存地址上调整索引。在 React、Vue 3 或 Redux 等依赖“不可变数据(Immutability)”或“浅比对(Shallow Compare)”的状态管理框架中,直接对 state 中的数组调用 sort() 会导致组件感知不到数组引用的改变,从而引发视图不更新或调试困难等隐蔽 Bug。
// 错误模式(破坏原数组):
const originalList = [3, 1, 2];
const sortedList = originalList.sort();
console.log(originalList === sortedList); // true!原数组已被篡改

// 传统防破坏方案(浅拷贝后排序):
const safeList = [...originalList].sort((a, b) => a - b);

// 现代 ECMAScript 2023(ES14)原生方案:
const modernList = originalList.toSorted((a, b) => a - b);
console.log(originalList); // [3, 1, 2] 保持未修改
console.log(modernList);   // [1, 2, 3] 返回全新数组
2. 稀疏数组与 undefined 的特殊处理规则
根据规范,数组中的 undefined 无论在升序还是降序模式下,都会被无条件排在数组的最末尾。并且,排序算法在遇到 undefined 元素时,根本不会调用你传入的 compareFn。对于稀疏数组(未赋值的空洞),空洞位置同样会被视同为排在末尾。
五、核心要点总结与查阅表
| 业务场景 | 推荐写法 | 核心原理 / 避坑要点 |
|---|---|---|
| 数字升序排列 | arr.sort((a, b) => a - b) |
差值小于 0 则 a 在前;禁止无参直接调用。 |
| 数字降序排列 | arr.sort((a, b) => b - a) |
差值大于 0 则 b 在前。 |
| 对象多级排序 | (a, b) => (a.x - b.x) || (b.y - a.y) |
利用短路逻辑或 if 分支,主条件相同时退回次优先级。 |
| 中文拼音升序 | (a, b) => a.localeCompare(b, 'zh-CN') |
必须指定语言环境标签,避免按 Unicode 码点顺序排布。 |
| 不可变状态排序 | arr.toSorted(compareFn) |
避免破坏原数组引用,优先推荐 ES2023 原生方法。 |
掌握 sort() 的关键在于明确其数据转换过程与比较契约。通过显式提供 compareFn 规范排序逻辑,结合多语言 localeCompare 与现代不可变数组方法 toSorted(),可以在各种复杂的业务场景中实现稳定、高效、可预测的数组排序。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章