
详解JavaScript中数组去重、排序与深拷贝的常用算法与实用写法,包含Set去重、sort排序、递归深拷贝等完整示例和注意事项。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS常用算法与数据处理实例:数组去重、排序与深拷贝
作者:异步漫步
时间:2026-10-30
浏览:257
文章目录
处理数组和对象是 JavaScript 开发中最频繁的操作。数组去重、排序与深拷贝三个问题看似基础,却各有容易踩坑的细节:去重时引用类型该如何判断,sort() 不传比较函数会怎样,浅拷贝和深拷贝到底差在哪里。本文用完整的代码示例逐一讲清这些问题,每种方法都标注了适用范围和注意事项。
数组去重:从简单到通用
去重的目标是从数组中去除重复元素,只保留唯一值。根据数据类型和场景的不同,常用方法有以下几种。
使用 Set(推荐写法)
Set 本身不允许存储重复值,把数组转为 Set 再转回数组就完成了去重。这是目前最简洁、性能也不错的写法。
const arr = [1, 2, 2, 3, 'a', 'a', true, true];
const unique = [...new Set(arr)];
console.log(unique);
// 输出: [1, 2, 3, 'a', true]需要注意:Set 判断重复使用的是"Same-value-zero"算法,与 === 基本一致,但 NaN 等于 NaN。对于对象和数组等引用类型,Set 比较的是引用地址,不是内容,因此两个内容相同但引用不同的对象不会被去重。
const objArr = [{id: 1}, {id: 1}];
console.log([...new Set(objArr)]);
// 输出: [{id: 1}, {id: 1}]  ← 没有去重,因为是两个不同对象
使用 filter + indexOf
在不支持 Set 的旧环境中,可以用 filter 配合 indexOf 完成去重。原理是:只保留每个元素第一次出现的位置。
function uniqueByFilter(arr) {
  return arr.filter((item, index) => arr.indexOf(item) === index);
}

console.log(uniqueByFilter([3, 1, 2, 3, 2, 1]));
// 输出: [3, 1, 2]
这种写法的时间复杂度是 O(n²),数据量大时明显慢于 Set。同样无法处理引用类型的内容去重。
按对象属性去重
实际项目中更常见的需求是:数组里有一组对象,需要根据某个字段(比如 id)去重。可以用 Map 实现:
function uniqueById(arr, key) {
  const map = new Map();
  for (const item of arr) {
    if (!map.has(item[key])) {
      map.set(item[key], item);
    }
  }
  return [...map.values()];
}

const users = [
  { id: 1, name: 'Alice' },
  { id: 2, name: 'Bob' },
  { id: 1, name: 'Alice Copy' }
];
console.log(uniqueById(users, 'id'));
// 输出: [{ id: 1, name: 'Alice' }, { id: 2, name: 'Bob' }]
这里保留的是第一次出现的对象。如果要保留最后一次出现的,去掉 if 判断,让后面的值直接覆盖即可。
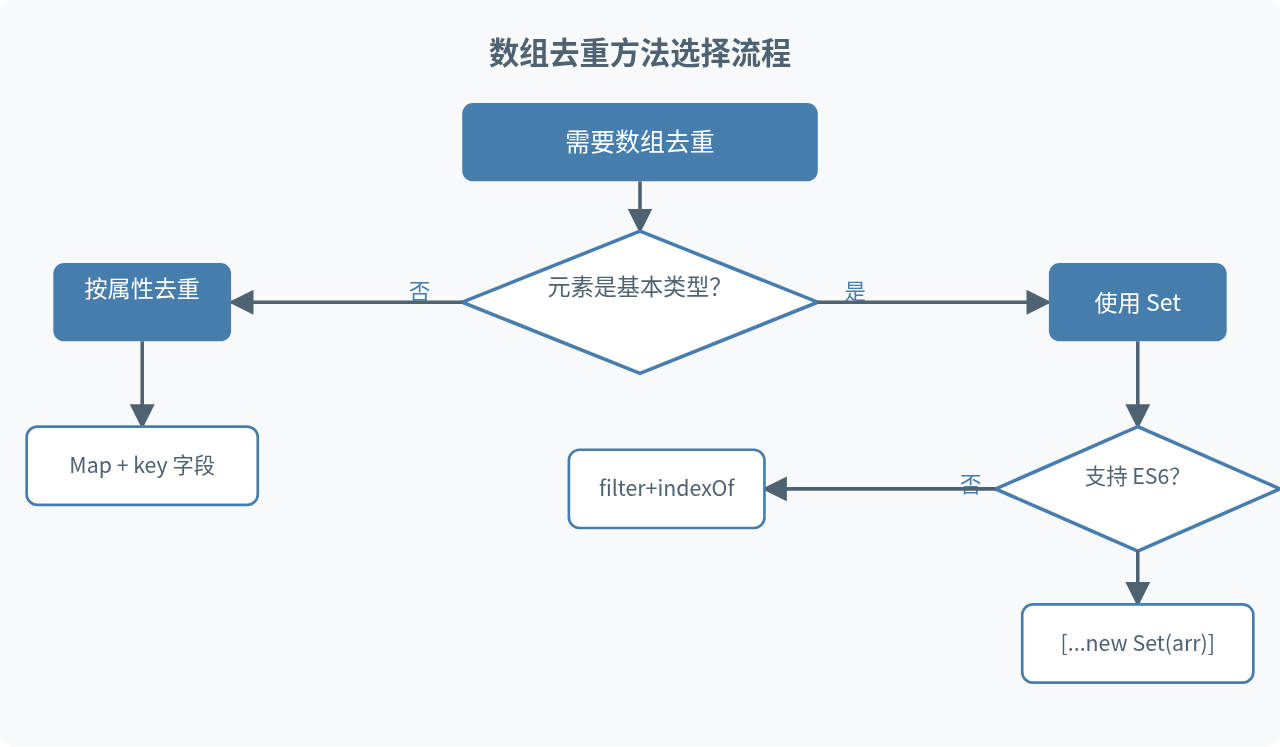
图1:根据数据类型与环境选择去重方法的判断流程
数组排序:sort 用对了才靠谱
JavaScript 的 Array.prototype.sort() 是最直接的排序方式,但不传比较函数时它会把元素转成字符串再按 Unicode 排序,这对数字数组来说几乎一定出错。
const nums = [10, 9, 2, 100, 21];
console.log(nums.sort());
// 输出: [10, 100, 2, 21, 9]  ← 按字符串排序,结果不对
正确的数字排序
给 sort() 传入比较函数,返回负数表示前者排前面,正数表示后者排前面,零表示相等:
// 升序
const asc = [10, 9, 2, 100, 21].sort((a, b) => a - b);
console.log(asc);
// 输出: [2, 9, 10, 21, 100]

// 降序
const desc = [10, 9, 2, 100, 21].sort((a, b) => b - a);
console.log(desc);
// 输出: [100, 21, 10, 9, 2]
按对象属性排序
对象数组按某个字段排序的写法和数字排序类似:
const products = [
  { name: '键盘', price: 299 },
  { name: '鼠标', price: 89 },
  { name: '显示器', price: 1599 }
];

products.sort((a, b) => a.price - b.price);
console.log(products.map(p => p.name));
// 输出: ['鼠标', '键盘', '显示器']
中文按拼音排序
对中文字符串排序时,localeCompare 可以按拼音顺序排列:
const cities = ['北京', '上海', '广州', '成都'];
cities.sort((a, b) => a.localeCompare(b, 'zh-CN'));
console.log(cities);
// 输出: ['北京', '成都', '广州', '上海']
sort 会修改原数组
sort() 是原地排序,会直接修改原数组并返回它。如果不想改变原数组,先用 slice() 或展开运算符复制一份:const sorted = [...arr].sort((a, b) => a - b);
ES2023 新增了 toSorted(),它返回新数组而不修改原数组。Node 20+ 和现代浏览器已支持。
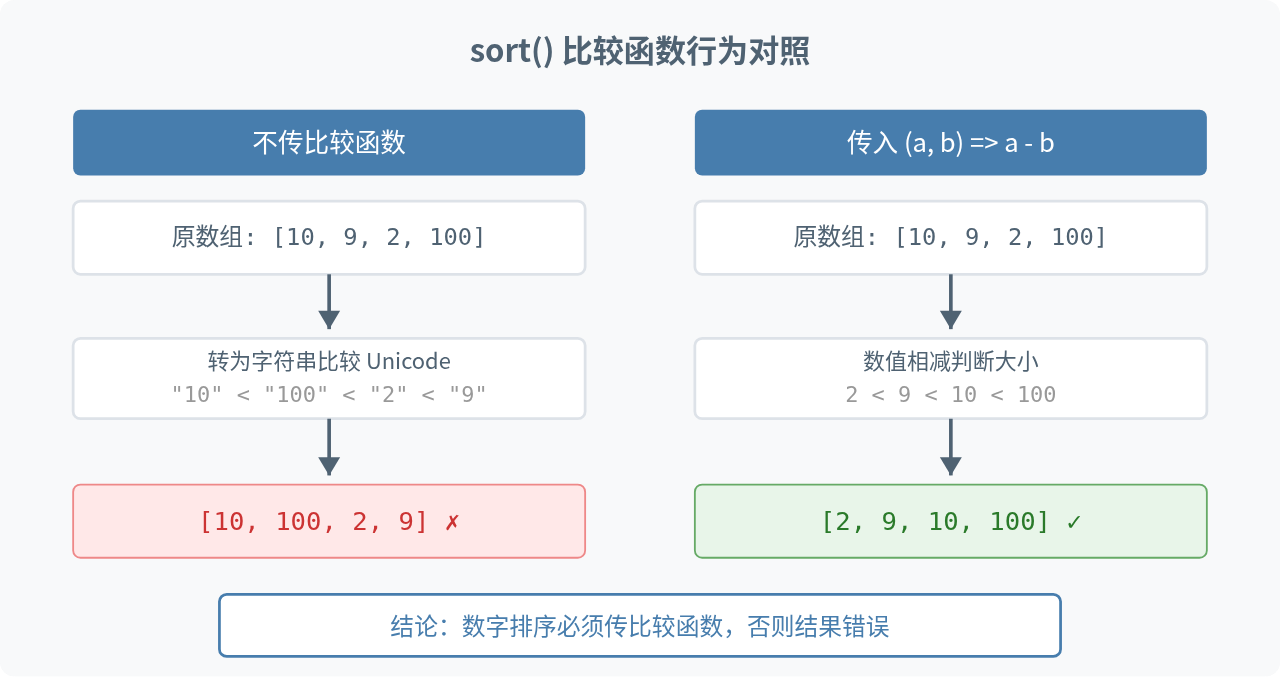
图2:sort() 有无比较函数的结果对比
深拷贝:真正独立的副本
JavaScript 中赋值对象或数组时,变量保存的是引用。修改其中一个变量,另一个也会跟着变。深拷贝的目标是创建一份完全独立的副本,修改副本不影响原始数据。
浅拷贝与深拷贝的区别
先看浅拷贝会导致什么问题:
const original = { name: 'Alice', scores: [90, 85] };
const shallow = { ...original };

shallow.name = 'Bob';       // 不影响 original
shallow.scores.push(70);    // original.scores 也变了!

console.log(original.scores);
// 输出: [90, 85, 70]  ← 浅拷贝没有复制内部数组
展开运算符 ...、Object.assign()、Array.prototype.slice() 都是浅拷贝——只复制第一层属性,嵌套的对象和数组仍然共享引用。
JSON 序列化(简单场景)
最常见的深拷贝方式是 JSON 转换:
const deep = JSON.parse(JSON.stringify(original));这种方式简单有效,但有明确限制:
undefined、函数、Symbol类型的值会被忽略Date对象会变成字符串RegExp、Map、Set会变成空对象- 存在循环引用时直接报错
如果数据结构只包含纯 JSON 兼容的类型(字符串、数字、布尔、数组、普通对象、null),这个方法完全够用。
structuredClone(现代推荐)
ES2022 引入了全局函数 structuredClone(),它支持大多数内置类型,也能处理循环引用:
const original = {
  date: new Date(),
  regex: /test/gi,
  set: new Set([1, 2, 3]),
  nested: { arr: [1, [2, 3]] }
};

const cloned = structuredClone(original);

cloned.nested.arr[1].push(4);
console.log(original.nested.arr[1]);
// 输出: [2, 3]  ← 原始数据不受影响

console.log(cloned.date instanceof Date);
// 输出: true  ← Date 类型被正确保留
structuredClone 不能拷贝函数、DOM 节点和某些特殊对象(如 Error 的自定义属性可能丢失),但覆盖了绝大多数日常场景。Node 17+、Chrome 98+、Firefox 94+、Safari 15.4+ 均已支持。
手写递归深拷贝
在需要完全控制拷贝逻辑或兼容旧环境时,可以手写递归实现。以下版本处理了循环引用和常见内置类型:
function deepClone(obj, cache = new WeakMap()) {
  if (obj === null || typeof obj !== 'object') return obj;
  if (cache.has(obj)) return cache.get(obj);

  // 处理 Date
  if (obj instanceof Date) return new Date(obj.getTime());
  // 处理 RegExp
  if (obj instanceof RegExp) return new RegExp(obj.source, obj.flags);
  // 处理 Map
  if (obj instanceof Map) {
    const map = new Map();
    cache.set(obj, map);
    obj.forEach((val, key) => map.set(deepClone(key, cache), deepClone(val, cache)));
    return map;
  }
  // 处理 Set
  if (obj instanceof Set) {
    const set = new Set();
    cache.set(obj, set);
    obj.forEach(val => set.add(deepClone(val, cache)));
    return set;
  }

  const clone = Array.isArray(obj) ? [] : {};
  cache.set(obj, clone);
  for (const key of Object.keys(obj)) {
    clone[key] = deepClone(obj[key], cache);
  }
  return clone;
}
用 WeakMap 做缓存是关键:遇到已经拷贝过的对象就直接返回缓存的副本,既避免了无限递归,也保持了循环引用关系。
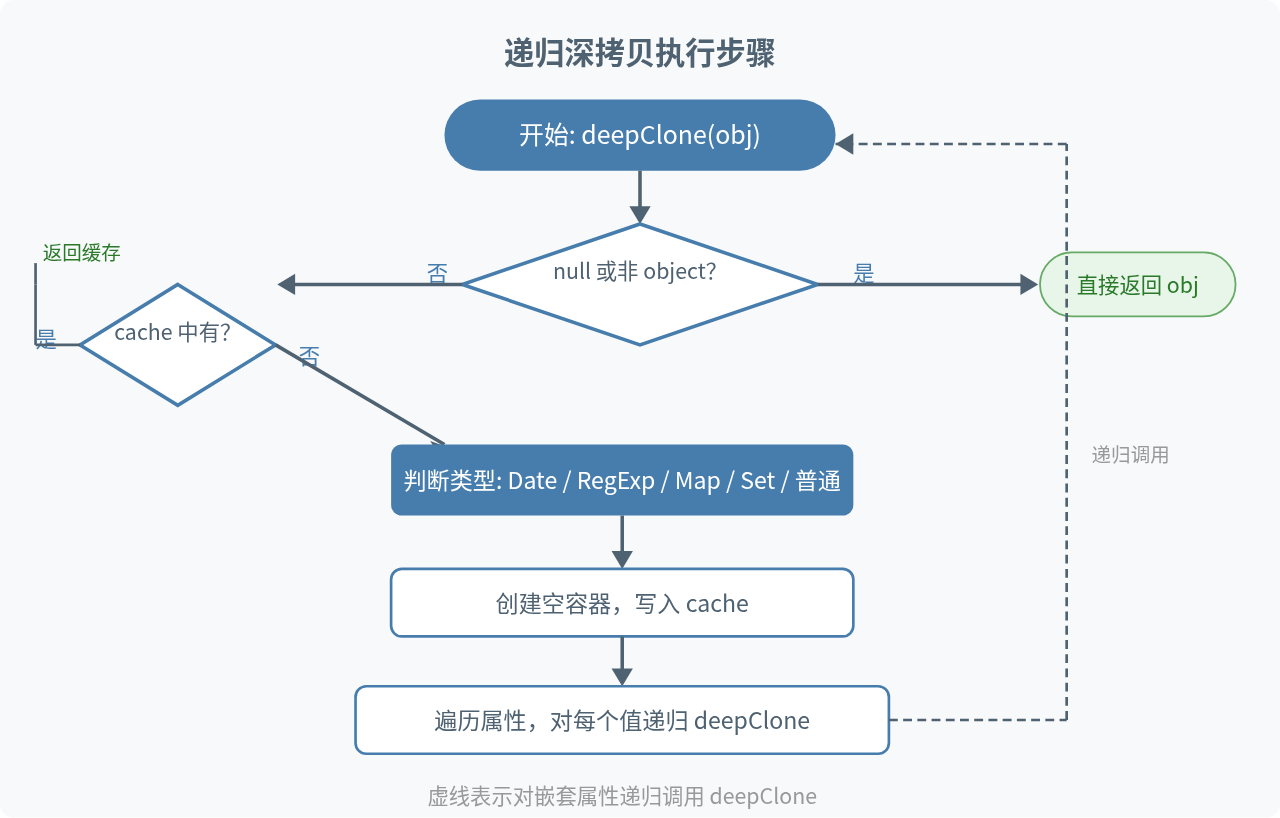
图3:递归深拷贝函数的执行流程与循环引用处理
三种方法的适用场景对比
下面把三个深拷贝方案放在一起做个比较,帮助快速做选择:
| 方案 | 循环引用 | 函数 | Date/RegExp | Map/Set | 适用场景 |
|---|---|---|---|---|---|
| JSON 序列化 | ✗ 报错 | ✗ 丢失 | ✗ 变字符串/空对象 | ✗ | 纯 JSON 数据 |
| structuredClone | ✓ | ✗ 报错 | ✓ | ✓ | 大多数日常场景 |
| 手写递归 | ✓(需 cache) | 可自行处理 | ✓ | ✓ | 需要完全控制或兼容旧环境 |
如果项目已经引入 lodash,_.cloneDeep() 也是成熟可靠的选择,内部处理了绝大多数边界情况。
综合实例:数据清洗管道
实际项目中,去重、排序和深拷贝经常串联使用。下面是一个典型场景:从接口拿到的用户列表可能有重复记录,需要去重后按注册时间排序,再深拷贝一份做后续处理。
// 模拟接口数据
const rawUsers = [
  { id: 3, name: '张三', joinDate: '2024-03-15' },
  { id: 1, name: '李四', joinDate: '2024-01-08' },
  { id: 3, name: '张三', joinDate: '2024-03-15' },
  { id: 2, name: '王五', joinDate: '2024-02-20' },
  { id: 1, name: '李四', joinDate: '2024-01-08' }
];

// 第一步:按 id 去重
const uniqueUsers = [...new Map(rawUsers.map(u => [u.id, u])).values()];

// 第二步:按注册时间升序排序
const sorted = uniqueUsers.sort(
  (a, b) => new Date(a.joinDate) - new Date(b.joinDate)
);

// 第三步:深拷贝一份用于独立加工
const usersCopy = structuredClone(sorted);
usersCopy[0].name = '已修改';

console.log(sorted[0].name);
// 输出: '李四'  ← 原数据不受影响
console.log(usersCopy.map(u => `${u.name}(${u.joinDate})`));
// 输出: ['已修改(2024-01-08)', '王五(2024-02-20)', '张三(2024-03-15)']
这三步的执行顺序可以根据实际需要调整。比如数据量很大时,先去重再排序能减少排序的元素数量;如果需要保留原始数据做对比,则应先深拷贝再做任何修改。
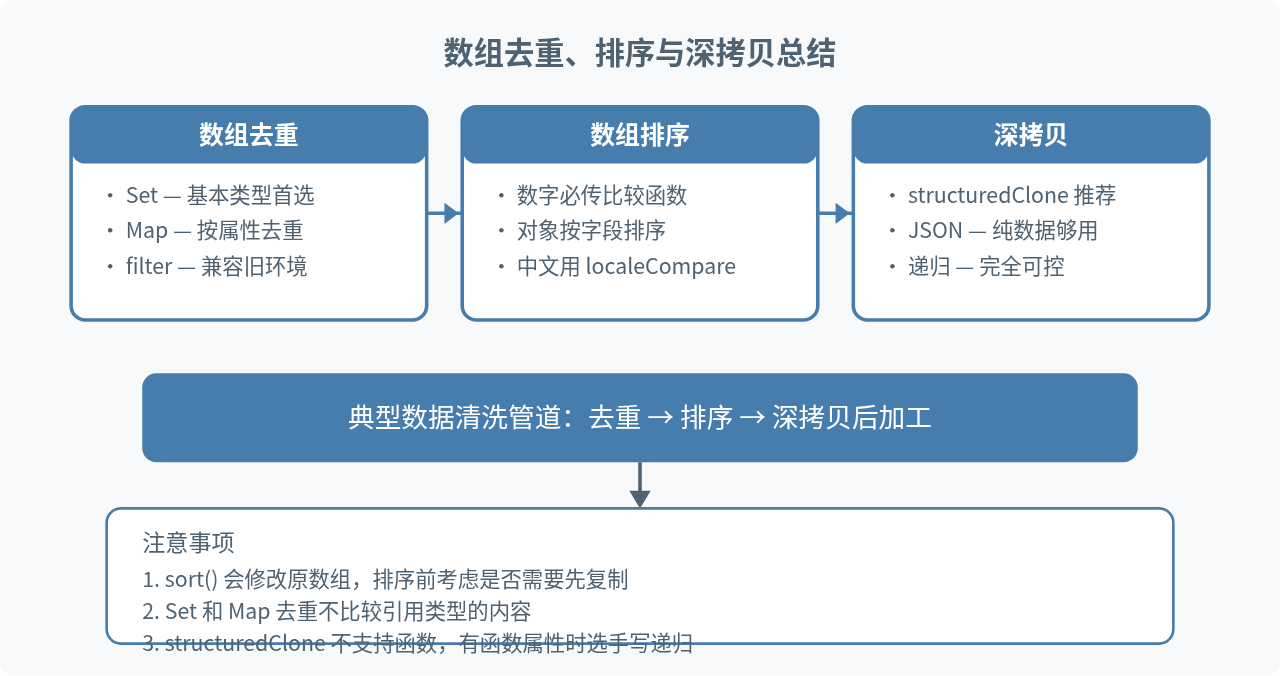
图4:本文三大主题要点总结与数据清洗管道流程
容易踩的坑
去重后丢了顺序? Set 和 Map 都会保持插入顺序,所以用上述方法去重不会打乱原始顺序。但如果去重后还要排序,记得先去重再排序,减少不必要的比较次数。
sort 的稳定性。 ES2019 规范要求 sort() 是稳定排序(相等元素保持原有相对顺序)。V8(Chrome/Node)从 v7.0 起就已经保证稳定。如果需要兼容极旧引擎,可以在比较函数中加入原始索引作为次要排序条件。
深拷贝的性能。 structuredClone 在大对象上比 JSON.parse(JSON.stringify()) 稍慢一些,但差距很小,通常不是瓶颈。手写递归如果没有做缓存去处理循环引用,碰到循环结构会导致栈溢出。
不可枚举属性和原型链。 上面所有深拷贝方法默认只拷贝自身可枚举属性。如果对象通过原型链继承了属性,或者用 Object.defineProperty 设置了不可枚举属性,这些都不会被拷贝。需要保留时要额外用 Object.getOwnPropertyDescriptors() 处理。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章