

本文介绍了一个使用原生JavaScript实现的HTML转Markdown转换函数。该工具通过正则表达式处理HTML标签,优先保护pre和code代码块,依次转换标题、列表等元素,并恢复受保护内容。文章详细解析了转换逻辑、关键步骤及浏览器兼容性限制,提供了完整的源码实现与在线示例。
项目背景与示例
此前因项目需求,需要将部分HTML标签转换为Markdown格式,在不断完善过程中,最终形成了一个相对完整的转换函数。
随后,我将该功能封装为一个独立文件并上传至GitHub,同时提供了两个简单的示例网页供测试使用。
- HTML转换示例页面地址:https://kohunglee.github.io/html2md/example/conversion.html
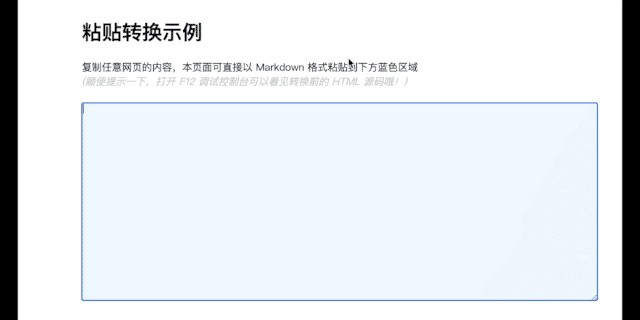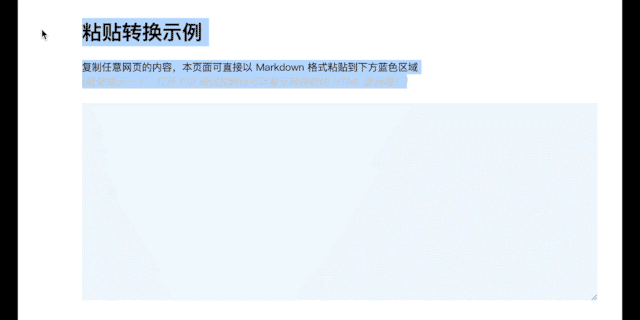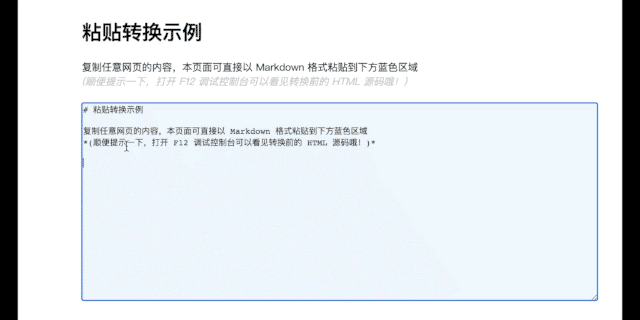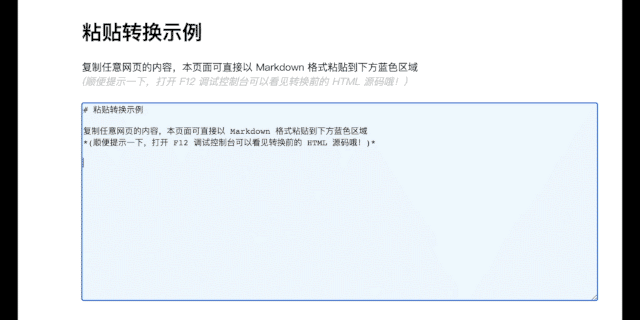
- 直接粘贴并转换为Markdown格式的示例页面地址:https://kohunglee.github.io/html2md/example/Paste_and_convert.html
完整代码仓库位于html2md项目地址。
开发动机与兼容性说明
尽管GitHub上存在许多类似的转换库,但多数对HTML还原的支持不够完善。例如,目前最热门的turndown.js就不支持表格的还原,因此我决定自行开发一个解决方案。
转换逻辑较为复杂,需要仔细处理各个标签的优先级,最终耗时两天才完善到当前可用状态。
需要注意的是,Safari及iOS内置浏览器由于对正则表达式的支持不完整,无法使用该功能。对于Safari用户建议使用Chrome,而iOS设备因无法复制已封装HTML的内容,故无需考虑兼容性问题。
转换逻辑详解
代码的具体实现逻辑如下:
首先声明了一些数组变量,用于存储转换过程中的中间产物。
接着,pureHtml变量作为整个加工过程的原始数据,贯穿处理始终。
函数处理的入口从第112行开始。
第一步,删除<style>和<script>这两个标签及其内部内容。
第二步,将pre标签内的内容先存入数组,然后用‘#preContent#’字符替换原pre标签内容,此操作称为“保护”。由于后续处理涉及复杂逻辑,保护pre标签能确保其代码内容保持原样,因为pre标签本身即为代码块,不应被修改。
第三步处理与pre类似的code标签。先处理pre再处理code的原因是二者存在包含关系:pre内部可包含code,但code内部通常不包含pre。基于此逻辑决定先存储pre再处理code。
第四步,在排除pre和code干扰后,安全删除其他无用属性,并对a标签和img标签的内容进行“保护”,以便后续恢复。
第五步,替换一些简单标签,如标题、斜体、横线等(同时删除一些无关标签),最后依次处理表格和列表。
第六步,按照既定规范,依次将之前“保护”的内容进行恢复。
第七步,删除头部空行(此前曾尝试删除中间多余空行,但效果未保留),转换完成后返回结果。
源码实现
完整源码如下:
/**
* 把 html 内容转化为 markdown 格式 V1.0
*
* @author kohunglee
* @param {string} htmlData 转换前的 html
* @return {string} 转化后的 markdown 源码
*/
function html2md(htmlData){
codeContent = new Array // code标签数据
preContent = new Array // pre标签数据
tableContent = new Array // table标签数据
olContent = new Array // ol标签数据
imgContent = new Array // img标签数据
aContent = new Array // a标签数据
let pureHtml = htmlData
// 源代码
console.log("转换前的源码:" + pureHtml)
// 函数:删去html标签
function clearHtmlTag(sourceData = ''){
return sourceData.replace(/\<[\s\S]*?\>/g,'')
}
// 复原ol标签
function olRecover(olData = ''){
let result = olData
let num = olData.match(/\<li\>/ig).length
for(let i = 1; i <= num; i++){
let line = '[~wrap]'
if(i == 1) line = '[~wrap][~wrap]'
result = result.replace(/\<li\>/i, line + i + '. ')
}
result = result.replace(/\<\/li\>/, '')
return result
}
// 函数:复原img标签
function imgRecover(imgHtml = ''){
let imgSrc,imgTit,imgAlt,result
imgSrc = imgHtml.match(/(?<=src=['"])[\s\S]*?(?=['"])/i)
imgTit = imgHtml.match(/(?<=title=['"])[\s\S]*?(?=['"])/i)
imgAlt = imgHtml.match(/(?<=alt=['"])[\s\S]*?(?=['"])/i)
imgTit = (imgTit != null) ? ` "${imgTit}"` : ' '
imgAlt = (imgAlt != 'null') ? imgAlt : " "
result = ``
return result
}
// 函数:复原a标签
function aRecover(aData = ''){
let aHref = '' + aData.match(/(?<=href=['"])[\s\S]*?(?=['"])/i)
let aTit = '' + aData.match(/(?<=title=['"])[\s\S]*?(?=['"])/i)
let aText = '' + aData.match(/(?<=\<a\s*[^\>]*?\>)[\s\S]*?(?=<\/a>)/i)
let aImg = aData.match(/<img\s*[^\>]*?\>[^]*?(<\/img>)?/i)
let aImgSrc,aImgTit,aImgAlt
aTit = (aTit != 'null') ? ` "${aTit}"` : ' '
aText = clearHtmlTag(aText)
let result = `[${aText}](${aHref}${aTit})`
if(aImg != null){ // 函数:如果发现图片,则更换为图片显示模式
aImgSrc = aImg[0].match(/(?<=src=['"])[\s\S]*?(?=['"])/i)
aImgTit = aImg[0].match(/(?<=title=['"])[\s\S]*?(?=['"])/i)
aImgAlt = aImg[0].match(/(?<=alt=['"])[\s\S]*?(?=['"])/i)
aImgTit = (aImgTit != null) ? ` "${aImgTit}"` : ' '
aImgAlt = (aImgAlt != 'null') ? aImgAlt : " "
result = `[](${aHref}${aTit})`
}
return result
}
// 函数:复原table标签
function tableRecover(tableData = null){
if(tableData[0] == null){ // 如果不存在 th 标签,则默认表格为一层
let result = ''
let colNum = tableData[1].length
for(let i = 0; i < colNum; i++){
result += `|${clearHtmlTag(tableData[1][i])}`
}
result += `|[~wrap]`
for(let j = 0; j < colNum; j++){
result += `| :------------: `
}
result += `|[~wrap]`
return result
}
let colNum = tableData[0].length // 如果存在 th 标签,则按 th 的格数来构建整个表格
let result = ''
for(let i = 0; i < colNum; i++){
result += `|${clearHtmlTag(tableData[0][i])}`
}
result += `|[~wrap]`
for(let j = 0; j < colNum; j++){
result += `| :------------: `
}
result += `|[~wrap]`
for(let k = 0; k < tableData[1].length;){
for(let z = 0; z < colNum; z++,k++){
result += `|${clearHtmlTag(tableData[1][k])}`
}
result += `|[~wrap]`
}
return result+`[~wrap]`
}
// 去掉样式和脚本极其内容
pureHtml = pureHtml.replace(/<style\s*[^\>]*?\>[^]*?<\/style>/ig,'').replace(/<script\s*[^\>]*?\>[^]*?<\/script>/ig,'')
// 储存pre的内容,并替换<pre>中的内容
preContent = pureHtml.match(/<pre\s*[^\>]*?\>[^]*?<\/pre>/ig)
pureHtml = pureHtml.replace(/(?<=\<pre\s*[^\>]*?\>)[\s\S]*?(?=<\/pre>)/ig,'`#preContent#`')
// 储存code的内容,并替换<code>中的内容
codeContent = pureHtml.match(/(?<=\<code\s*[^\>]*?\>)[\s\S]*?(?=<\/code>)/ig)
pureHtml = pureHtml.replace(/(?<=\<code\s*[^\>]*?\>)[\s\S]*?(?=<\/code>)/ig,'`#codeContent#`')
// 储存a的内容,并替换<a>中的内容
aContent = pureHtml.match(/<a\s*[^\>]*?\>[^]*?<\/a>/ig)
pureHtml = pureHtml.replace(/<a\s*[^\>]*?\>[^]*?<\/a>/ig,'`#aContent#`')
// 储存img的内容,并替换<img>中的内容
imgContent = pureHtml.match(/<img\s*[^\>]*?\>[^]*?(<\/img>)?/ig)
pureHtml = pureHtml.replace(/<img\s*[^\>]*?\>[^]*?(<\/img>)?/ig,'`#imgContent#`')
// 获取纯净(无属性)的 html
pureHtml = pureHtml.replace(/(?<=\<[a-zA-Z0-9]*)\s.*?(?=\>)/g,'')
// 标题:标获取<h1><h2>...数据,并替换
pureHtml = pureHtml.replace(/<h1>/ig,'[~wrap]# ').replace(/<\/h1>/ig,'[~wrap][~wrap]')
.replace(/<h2>/ig,'[~wrap]## ').replace(/<\/h2>/ig,'[~wrap][~wrap]')
.replace(/<h3>/ig,'[~wrap]### ').replace(/<\/h3>/ig,'[~wrap][~wrap]')
.replace(/<h4>/ig,'[~wrap]#### ').replace(/<\/h4>/ig,'[~wrap][~wrap]')
.replace(/<h5>/ig,'[~wrap]##### ').replace(/<\/h5>/ig,'[~wrap][~wrap]')
.replace(/<h6>/ig,'[~wrap]###### ').replace(/<\/h6>/ig,'[~wrap][~wrap]')
// 段落:处理一些常用的结构标签
pureHtml = pureHtml.replace(/(<br>)/ig,'[~wrap]').replace(/(<\/p>)|(<br\/>)|(<\/div>)/ig,'[~wrap][~wrap]')
.replace(/(<meta>)|(<span>)|(<p>)|(<div>)/ig,'').replace(/<\/span>/ig,'')
// 粗体:替换<b><strong>
pureHtml = pureHtml.replace(/(<b>)|(<strong>)/ig,'**').replace(/(<\/b>)|(<\/strong>)/ig,'**')
// 斜体:替换<i><em><abbr><dfn><cite><address>
pureHtml = pureHtml.replace(/(<i>)|(<em>)|(<abbr>)|(<dfn>)|(<cite>)|(<address>)/ig,'*').replace(/(<\/i>)|(<\/em>)|(<\/abbr>)|(<\/dfn>)|(<\/cite>)|(<\/address>)/ig,'*')
// 删除线:替换<del>
pureHtml = pureHtml.replace(/\<del\>/ig,'~~').replace(/\<\/del\>/ig,'~~')
// 引用:替换<blockquote>
pureHtml = pureHtml.replace(/\<blockquote\>/ig,'[~wrap][~wrap]> ').replace(/\<\/blockquote\>/ig,'[~wrap][~wrap]')
// 水平线:替换<hr>
pureHtml = pureHtml.replace(/\<hr\>/ig,'[~wrap][~wrap]------[~wrap][~wrap]')
// 表格 <table>,得到数据,删除标签,然后逐层分析储存,最终根据结果生成
tableContent = pureHtml.match(/(?<=\<table\s*[^\>]*?\>)[\s\S]*?(?=<\/table>)/ig)
pureHtml = pureHtml.replace(/<table\s*[^\>]*?\>[^]*?<\/table>/ig,'`#tableContent#`')
if(tableContent !== null){ // 分析储存
tbodyContent = new Array
for(let i = 0; i < tableContent.length; i++){
tbodyContent[i] = new Array // tbodyContent[i]的第一个数据是thead数据,第二个是tbody的数据
tbodyContent[i].push(tableContent[i].match(/(?<=\<th>)[\s\S]*?(?=<\/th?>)/ig))
tbodyContent[i].push(tableContent[i].match(/(?<=\<td>)[\s\S]*?(?=<\/td?>)/ig))
}
}
if(typeof tbodyContent !== "undefined"){ // 替换
for(let i = 0; i < tbodyContent.length; i++){
let tableText = tableRecover(tbodyContent[i])
pureHtml = pureHtml.replace(/\`\#tableContent\#\`/i,tableText)
}
}
// 有序列表<ol>的<li>,储存ol的内容,并循环恢复ol中的内容
olContent = pureHtml.match(/(?<=\<ol\s*[^\>]*?\>)[\s\S]*?(?=<\/ol>)/ig)
pureHtml = pureHtml.replace(/(?<=\<ol\s*[^\>]*?\>)[\s\S]*?(?=<\/ol>)/ig,'`#olContent#`')
if(olContent !== null){
for(let k = 0; k < olContent.length; k++){
let olText = olRecover(olContent[k])
pureHtml = pureHtml.replace(/\`\#olContent\#\`/i,clearHtmlTag(olText))
}
}
// 无序列表<ul>的<li>,以及<dd>,直接替换
pureHtml = pureHtml.replace(/(<li>)|(<dd>)/ig,'[~wrap] - ').replace(/(<\/li>)|(<\/dd>)/ig,'[~wrap][~wrap]')
// 处理完列表后,将 <lu>、<\lu>、<ol>、<\ol> 处理
pureHtml = pureHtml.replace(/(<ul>)|(<ol>)/ig,'').replace(/(<\/ul>)|(<\/ol>)/ig,'[~wrap][~wrap]')
// 先恢复 img ,再恢复 a
if(imgContent !== null){
for(let i = 0; i < imgContent.length; i++){
let imgText = imgRecover(imgContent[i])
pureHtml = pureHtml.replace(/\`\#imgContent\#\`/i,imgText)
}
}
// 恢复 a
if(aContent !== null){
for(let k = 0; k < aContent.length; k++){
let aText = aRecover(aContent[k])
pureHtml = pureHtml.replace(/\`\#aContent\#\`/i,aText)
}
}
// 换行处理,1.替换 [~wrap] 为 ‘\n' 2.首行换行删去。 3.将其他过长的换行删去。
pureHtml = pureHtml.replace(/\\[\~wrap\\]/ig,'\n')
.replace(/\n{3,}/g,'\n\n')
// 代码 <code> ,根据上面的数组恢复code,然后将code替换
if(codeContent !== null){
for(let i = 0; i < codeContent.length; i++){
pureHtml = pureHtml.replace(/\`\#codeContent\#\`/i,clearHtmlTag(codeContent[i]))
}
}
pureHtml = pureHtml.replace(/\<code\>/ig,' ` ').replace(/\<\/code\>/ig,' ` ')
// 代码 <pre> ,恢复pre,然后将pre替换
if(preContent !== null){
for(let k = 0; k < preContent.length; k++){
let preLanguage = preContent[k].match(/(?<=language-).*?(?=[\s'"])/i)
let preText = clearHtmlTag(preContent[k])
preText = preText.replace(/^1\n2\n(\d+\n)*/,'') // 去掉行数
preLanguage = (preLanguage != null && preLanguage[0] != 'undefined') ? preLanguage[0] + '\n' : '\n'
pureHtml = pureHtml.replace(/\`\#preContent\#\`/i,preLanguage + preText)
}
}
pureHtml = pureHtml.replace(/\<pre\>/ig,'```').replace(/\<\/pre\>/ig,'\n```\n')
// 删去其余的html标签,还原预文本代码中的 '<' 和 '>'
pureHtml = clearHtmlTag(pureHtml)
pureHtml = pureHtml.replace(/\<\;/ig,'<').replace(/\>\;/ig,'>')
// 删去头部的空行
pureHtml = pureHtml.replace(/^\n{1,}/i,'')
return pureHtml
}至此,关于原生JS实现HTML转Markdown功能的介绍完毕。如需了解更多相关JS与HTML转换内容,请搜索本站往期文章或继续浏览后续文章,感谢支持。