

本文介绍如何使用 Node.js 编写脚本将 Markdown 文件转换为 PDF。通过结合 markdown-pdf 和 node-fetch 库,脚本能自动解析并下载 Markdown 中的图片链接,确保生成的 PDF 包含完整内容。
前言
Markdown 作为一种轻量级标记语言,在写作和记录方面具有显著优势。然而,并非所有用户都熟悉或习惯直接阅读 Markdown 格式的文件。将 Markdown 转换为 PDF 格式,能够统一文档的排版与样式,使其更易于在不同设备和平台上查看、打印以及分享给不熟悉 Markdown 的用户。
下文将详细讲解如何利用 Node.js 编写脚本,实现从 Markdown 到 PDF 的转换功能。
实现
首先明确需求:当前场景主要关注内容读取,暂不涉及复杂样式处理,但必须确保 Markdown 中的图片链接在生成的 PDF 中能够正常显示。
为实现文档转换,需安装 markdown-pdf 库;同时使用 node-fetch 库来下载图片,并将其嵌入到最终的 PDF 文件中。
pnpm add markdown-pdf node-fetch
node-fetch 是一个轻量级模块,提供了类似浏览器原生 fetch API 的接口,专门用于在 Node.js 环境中发起 HTTP 请求。该库旨在让服务器端代码能够以 Web 前端开发者熟悉的方式进行网络请求操作。
接下来,我们将编写一个基础的 Node.js 脚本,该脚本负责读取 Markdown 文件,下载其中引用的图片,并最终将其转换为 PDF 格式。
import fs from "fs";
import path from "path";
import fetch from "node-fetch";
import markdownPdf from "markdown-pdf";

async function prepareMarkdown(inputFile, outputFile) {
  let data = fs.readFileSync(inputFile, "utf8");
  const regex = /!\[.*?\]\((.*?)\)/g;
  let match;

  while ((match = regex.exec(data)) !== null) {
    const imageUrl = match[1];
    const imageName = path.basename(imageUrl);
    const imagePath = "./images/" + imageName;

    // 确保 images 目录存在
    const directory = path.dirname(imagePath);
    if (!fs.existsSync(directory)) {
      fs.mkdirSync(directory, { recursive: true });
    }

    // 下载图片,如果还未下载
    if (!fs.existsSync(imagePath)) {
      const response = await fetch(imageUrl);
      const buffer = Buffer.from(await response.arrayBuffer());
      fs.writeFileSync(imagePath, buffer);
    }

    // 替换 Markdown 中的图片链接为本地路径
    data = data.replace(imageUrl, imagePath);
  }

  // 将替换后的 Markdown 写入到临时文件
  fs.writeFileSync(outputFile, data);
}

// 将 Markdown 转换为 PDF
async function markdownToPdf(inputFile, pdfFile) {
  const tempFile = "moment.md";
  await prepareMarkdown(inputFile, tempFile);
  markdownPdf()
    .from(tempFile)
    .to(pdfFile, () => {
      console.log("PDF 创建成功");

      fs.unlinkSync(tempFile);
    });
}

markdownToPdf("./如何将 NestJs 应用部署到 vercel.md", "./moment.pdf");
在上述代码中,首先利用正则表达式 regex 匹配 Markdown 文件中的图片链接格式 。该正则表达式旨在捕获 Markdown 图片的 URL 地址。
从获取的 URL 中解析出文件名,并构建本地存储路径。系统会检查图片是否已下载,若未下载,则使用 fetch 获取图片内容并保存至本地,同时将图片路径写入临时路径文件 outputFile。
随后,调用 markdown-pdf 库执行 Markdown 到 PDF 的转换操作。
在终端中执行以下命令以运行脚本:
node index.js
最终执行效果如下图所示:
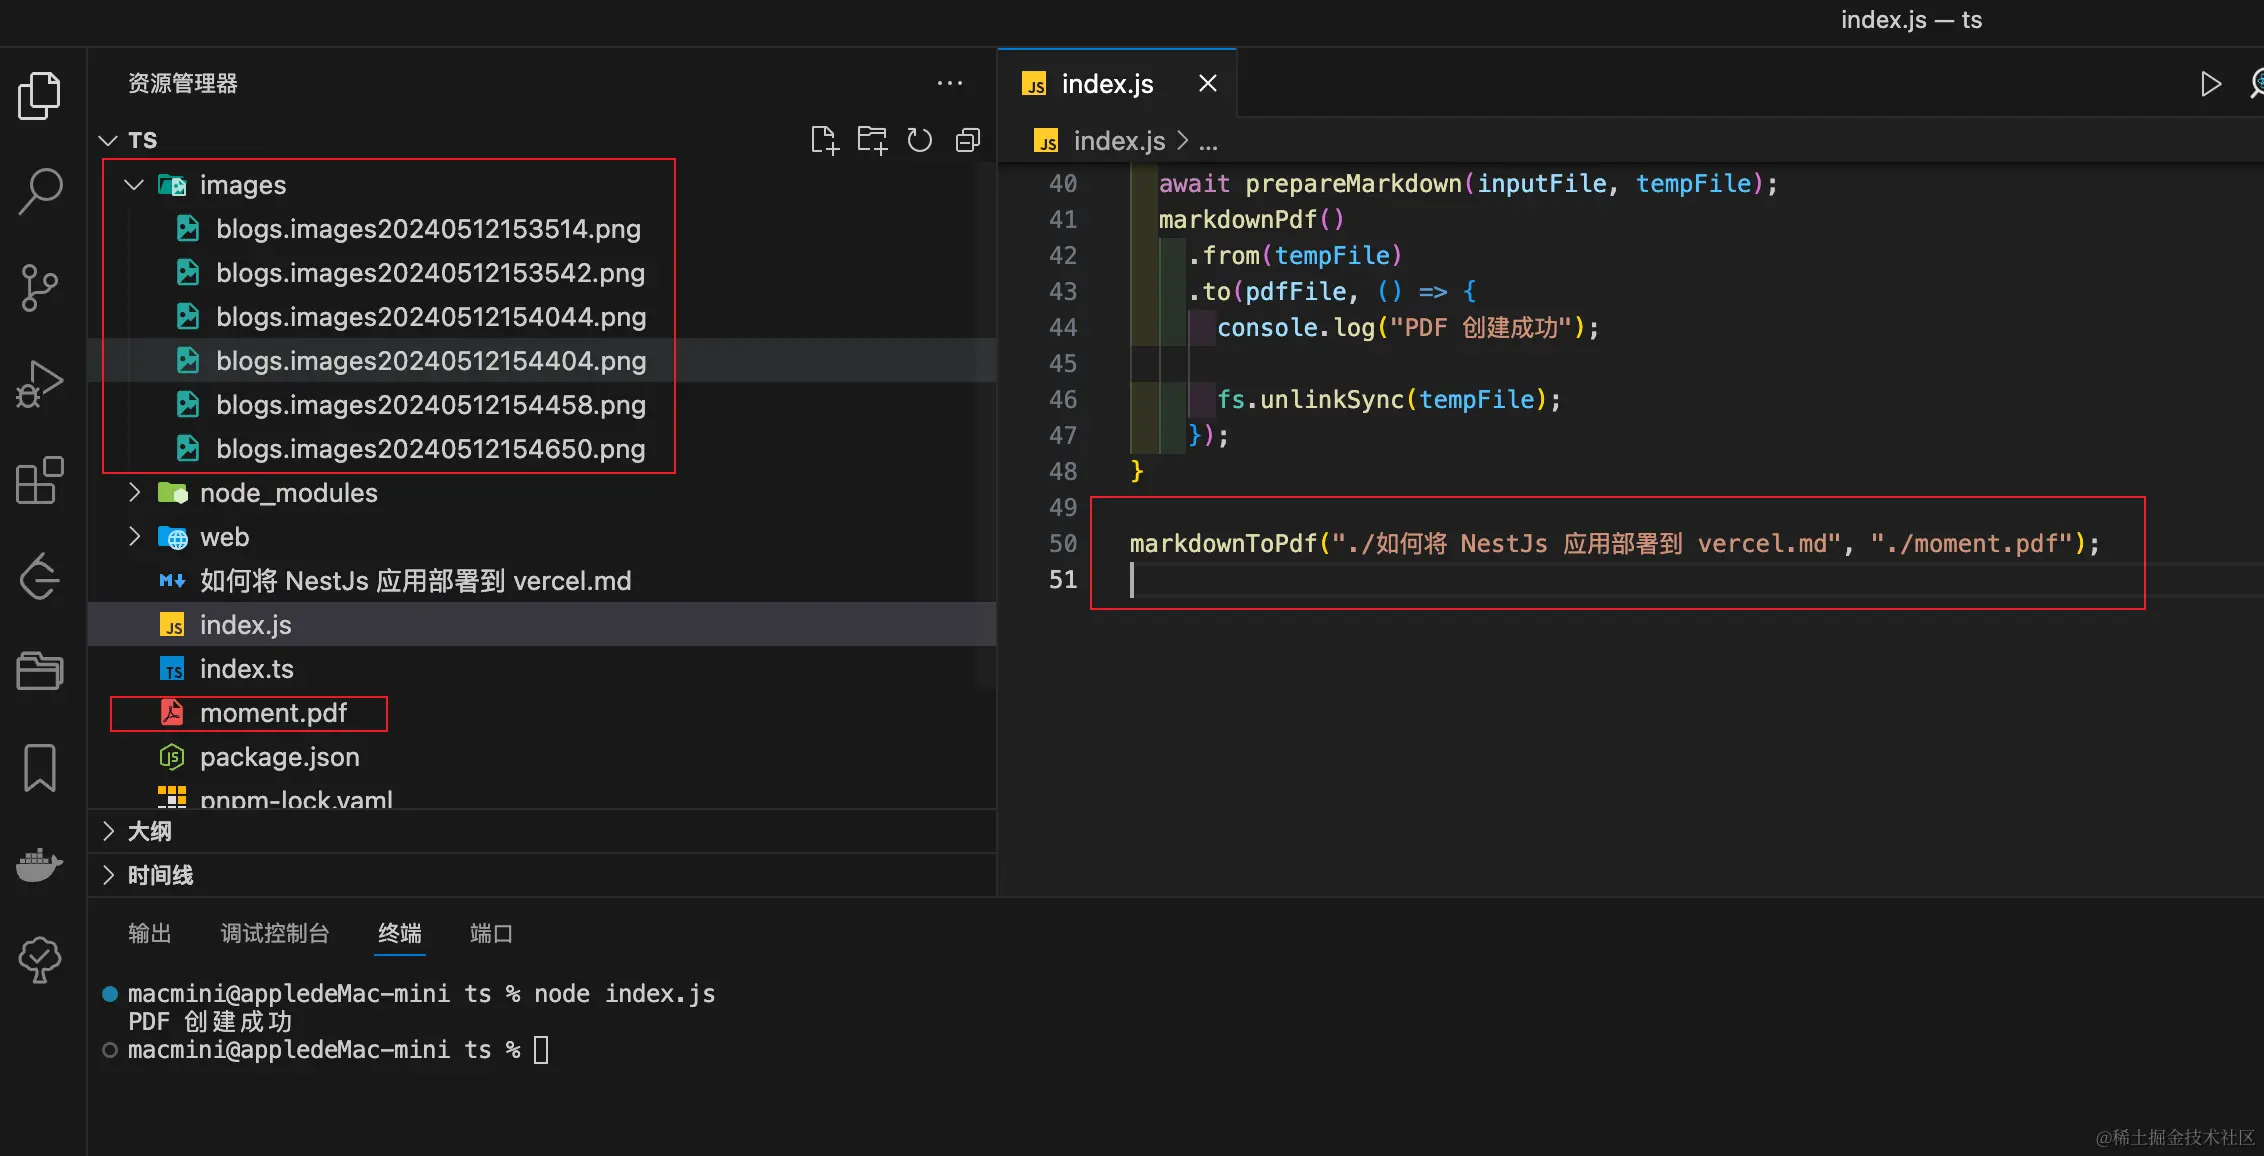
脚本会自动创建一个 images 目录,用于存放刚才下载的图片,同时生成一个 PDF 文件。其最终效果如下图所示:
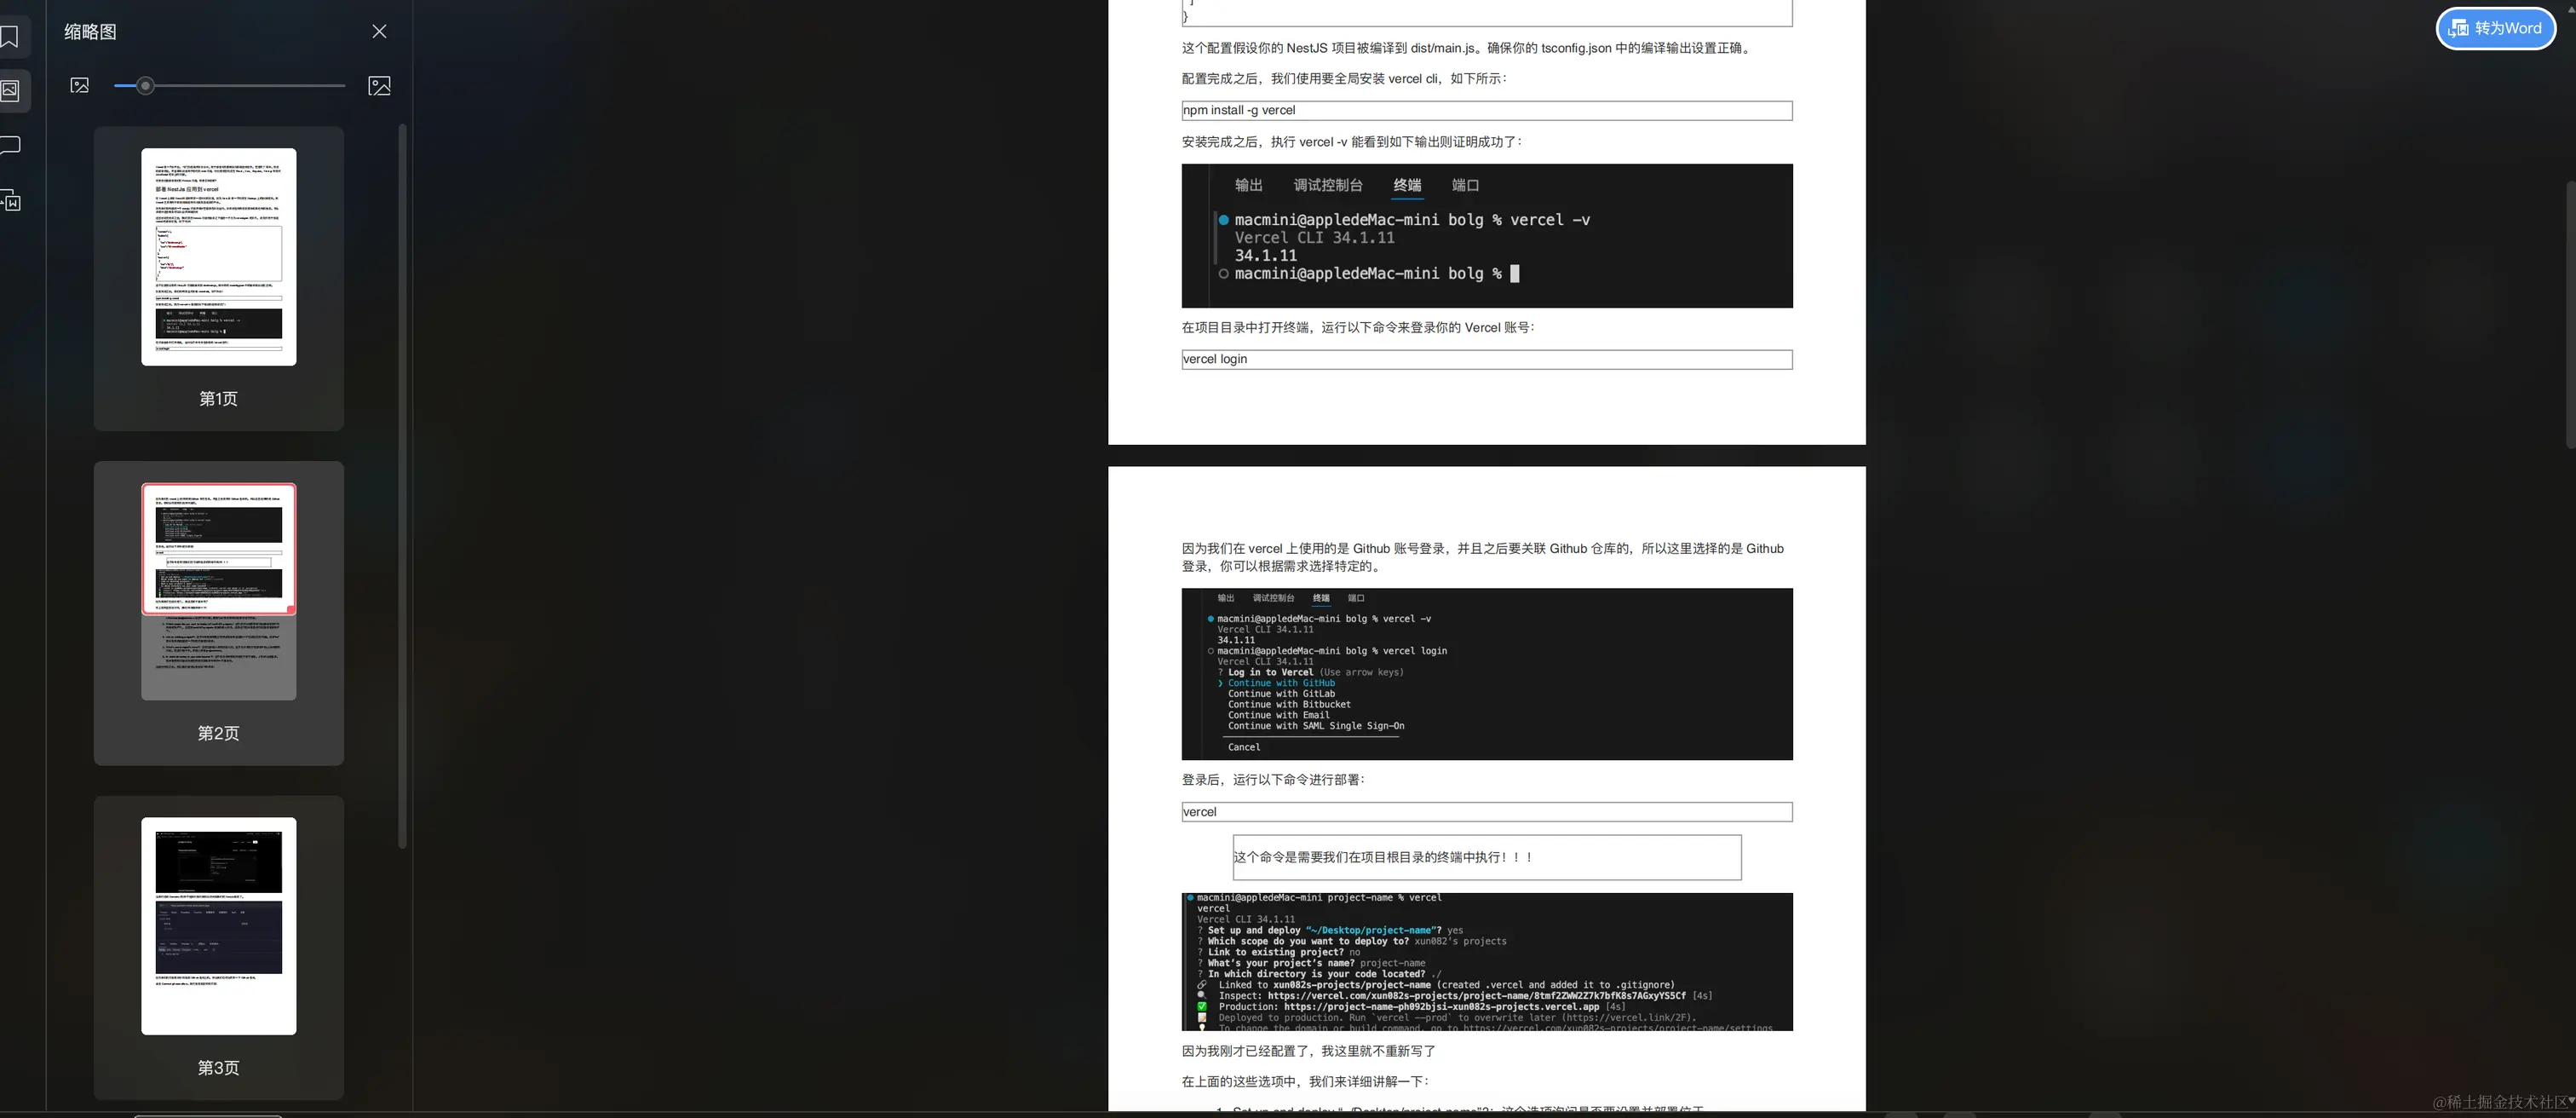
图片和正文内容均能正常显示。若需进一步优化视觉效果,可为内容添加样式,使文档更加美观。
总结
通过上述步骤,我们实现了 Markdown 到 PDF 的转换过程。未来如有需要,可引入 CSS 样式以美化外观,甚至可将其打造为编写简历的实用工具。
至此,关于使用 Node.js 编写脚本实现 Markdown 转 PDF 功能的介绍已完成。如需了解更多 Node.js 与 Markdown 转换相关内容,请搜索本站往期文章或继续浏览后续文章。感谢大家的支持!