

本文详解如何在纯静态HTML页面中通过JavaScript实现本地搜索功能。文章首先介绍了基于DOM遍历的基础方案及其局限性,随后提出利用XML文件存储链接与标题的优化策略。针对开发环境中常见的浏览器同源策略导致的跨域报错,提供了将文件部署至服务器的解决方案,并给出了完整的HTML、CSS及JS代码示例,帮助开发者快速为静态站点添加高效搜索模块。
背景介绍
静态页面主要由HTML、CSS和JavaScript等静态资源构成,这些文件在服务器端不进行动态生成或修改,因此通常具有较快的加载速度。此外,静态内容更利于搜索引擎抓取,非常适合用于展示固定信息的网站,例如企业官网、产品展示页或博客文章等场景。
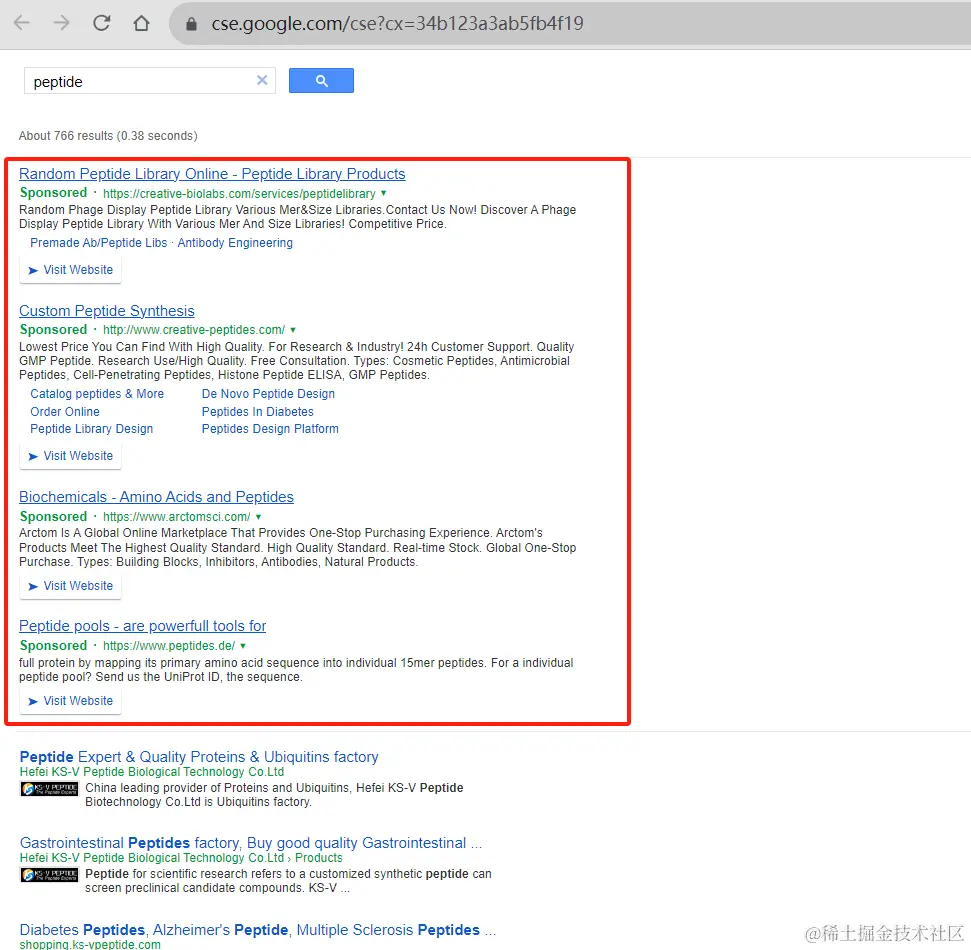
市面上存在许多为网页添加搜索模块的第三方服务,起初我尝试了谷歌站内搜索功能,但体验并不理想。主要问题包括:前几行结果强制显示无法去除的谷歌广告,且搜索结果仅展示谷歌已收录的页面。例如,若网站包含数千个页面(含小语种内容),谷歌实际收录的可能仅几百个,导致80%至90%的结果无法展示,这令人感到无奈,因此需要寻找替代方案。
解决方案概述
经过网络调研与实践,找到了一种相对简单的基于JavaScript实现的搜索功能方案,经过多次调试与完善,最终成功实现了功能复现。
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>Search Example</title>
<style>
#searchInput {
margin-bottom: 10px;
}
.urlset li {
display: none;
}
.pagination {
margin-top: 10px;
}
</style>
</head>
<body>
<input type="text" id="searchInput" placeholder="输入关键字">
<ul class="urlset">
<li class="aurl"><a href="https://www.ks-vpeptide.com/" rel="external nofollow" data-lastfrom="" title="Peptide Expert & Quality Proteins & Ubiquitins factory">Peptide Expert & Quality Proteins & Ubiquitins factory</a></li>
<li class="aurl"><a href="https://www.ks-vpeptide.com/webim/webim_tab.html" rel="external nofollow" data-lastfrom="" title="chat with us">chat with us</a></li>
<li class="aurl"><a href="https://www.ks-vpeptide.com/aboutus.html" rel="external nofollow" data-lastfrom="" title="China Hefei KS-V Peptide Biological Technology Co.Ltd company profile">China Hefei KS-V Peptide Biological Technology Co.Ltd company profile</a></li>
<!-- 此处省略一万条链接 -->
</ul>
<script>
document.getElementById('searchInput').addEventListener('input', function () {
var searchKeyword = this.value.toLowerCase();
var links = document.querySelectorAll('.urlset a');
links.forEach(function (link) {
var title = link.getAttribute('title').toLowerCase();
var url = link.getAttribute('href').toLowerCase();
if (title.includes(searchKeyword) || url.includes(searchKeyword)) {
link.parentNode.style.display = 'block';
} else {
link.parentNode.style.display = 'none';
}
});
});
</script>
</body>
</html>
基础实现效果如下:
至此,我们初步完成了一个基础的搜索功能。对于页面数量较少的个人博客或小型企业网站,该方案已具备实用价值。然而,当页面数量较多(例如超过300个页面)时,上述方案中仅搜索功能相关的代码就接近400行。若在每个页面中重复嵌入这400行代码,总代码量将达到300乘以400的规模,这会显著增加服务器负担,拖慢页面加载速度,并极大增加后期维护的难度。
优化策略
首先,我们将所有链接及其对应的标题整合到一个XML文件中,具体格式如下:
<?xml version="1.0" encoding="UTF-8"?>
<links>
<link>
<url>https://www.ks-vpeptide.com/</url>
<title>Peptide Expert & Quality Proteins & Ubiquitins factory</title>
</link>
<link>
<url>https://www.ks-vpeptide.com/webim/webim_tab.html</url>
<title>chat with us</title>
</link>
<link>
<url>https://www.ks-vpeptide.com/aboutus.html</url>
<title>China Hefei KS-V Peptide Biological Technology Co.Ltd company profile</title>
</link>
<!-- 此处省略一万条<link></link> -->
<link>
<url>https://www.ks-vpeptide.com/buy-h4k12ac.html</url>
<title>Buy h4k12ac, Good quality h4k12ac manufacturer</title>
</link>
<link>
<url>https://www.ks-vpeptide.com/contactnow.html</url>
<title>Send your inquiry directly to us</title>
</link>
</links>
对于页面较多的站点,可以使用工具自动生成XML文件。这里推荐一个可免费生成网站站点地图的工具:sitemap.zhetao.com/。
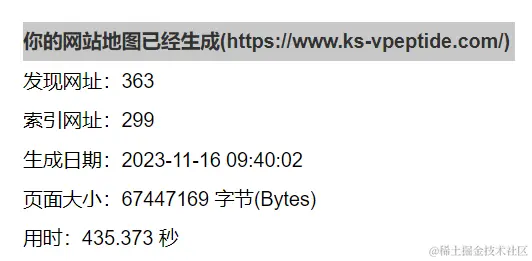
该工具的优点在于提供多种格式供选择,但其缺点是一个站点每180天仅能生成一次,使用频率受限。
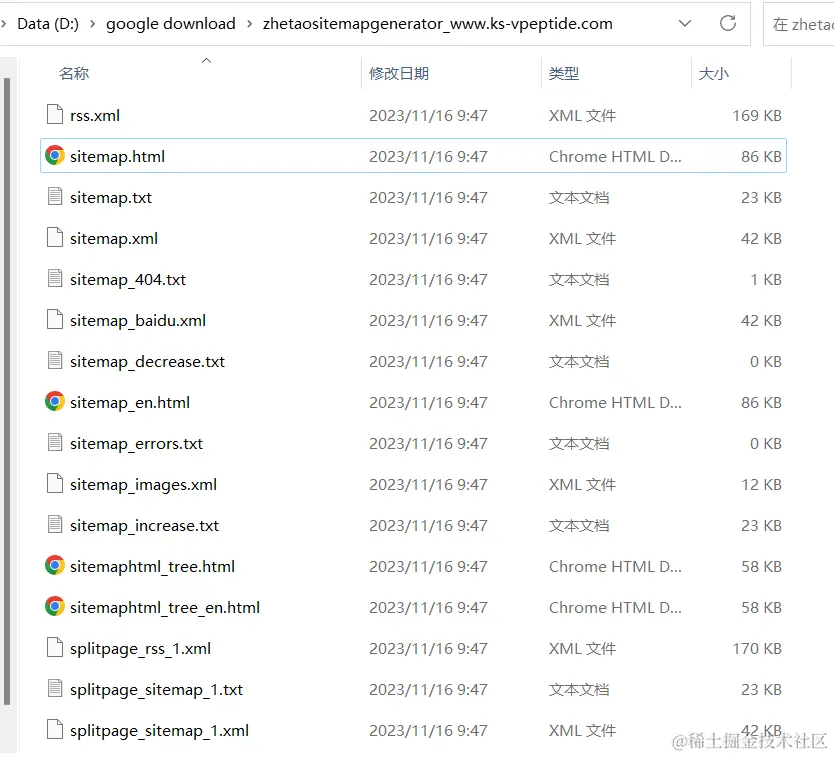
基于上述XML数据源,我们对之前的代码进行了相应修改:
<body>
<!-- hysousuo -->
<input type="text" id="searchInput" placeholder="输入关键字">
<ul class="urlset">
    <!-- 链接将在这里动态加载 -->
</ul>

<script>
    document.getElementById('searchInput').addEventListener('input', function () {
        var searchKeyword = this.value.toLowerCase();
		<!-- your_links.xml 换成你的 xml 名称 -->
        fetch('your_links.xml')
            .then(response => response.text())
            .then(data => {
                var parser = new DOMParser();
                var xmlDoc = parser.parseFromString(data, 'application/xml');
                var links = xmlDoc.querySelectorAll('link');

                links.forEach(function (link) {
                    var url = link.querySelector('url').textContent.toLowerCase();
                    var title = link.querySelector('title').textContent.toLowerCase();
                    var li = document.createElement('li');
                    li.className = 'aurl';
                    li.innerHTML = `<a href="${url}" rel="external nofollow"  rel="external nofollow"  data-lastfrom="" title="${title}">${title}</a>`;
                    document.querySelector('.urlset').appendChild(li);

                    if (title.includes(searchKeyword) || url.includes(searchKeyword)) {
                        li.style.display = 'block';
                    } else {
                        li.style.display = 'none';
                    }
                });
            })
            .catch(error => console.error('Error fetching XML:', error));
    });
</script>
</body>
修改后发现搜索结果无法显示,检查控制台报错信息,发现是浏览器的同源策略(Same-Origin Policy)所致。该策略要求网页中加载的所有脚本(包括JavaScript、CSS、图片等)必须来自同一源(即相同的协议、域名和端口)。
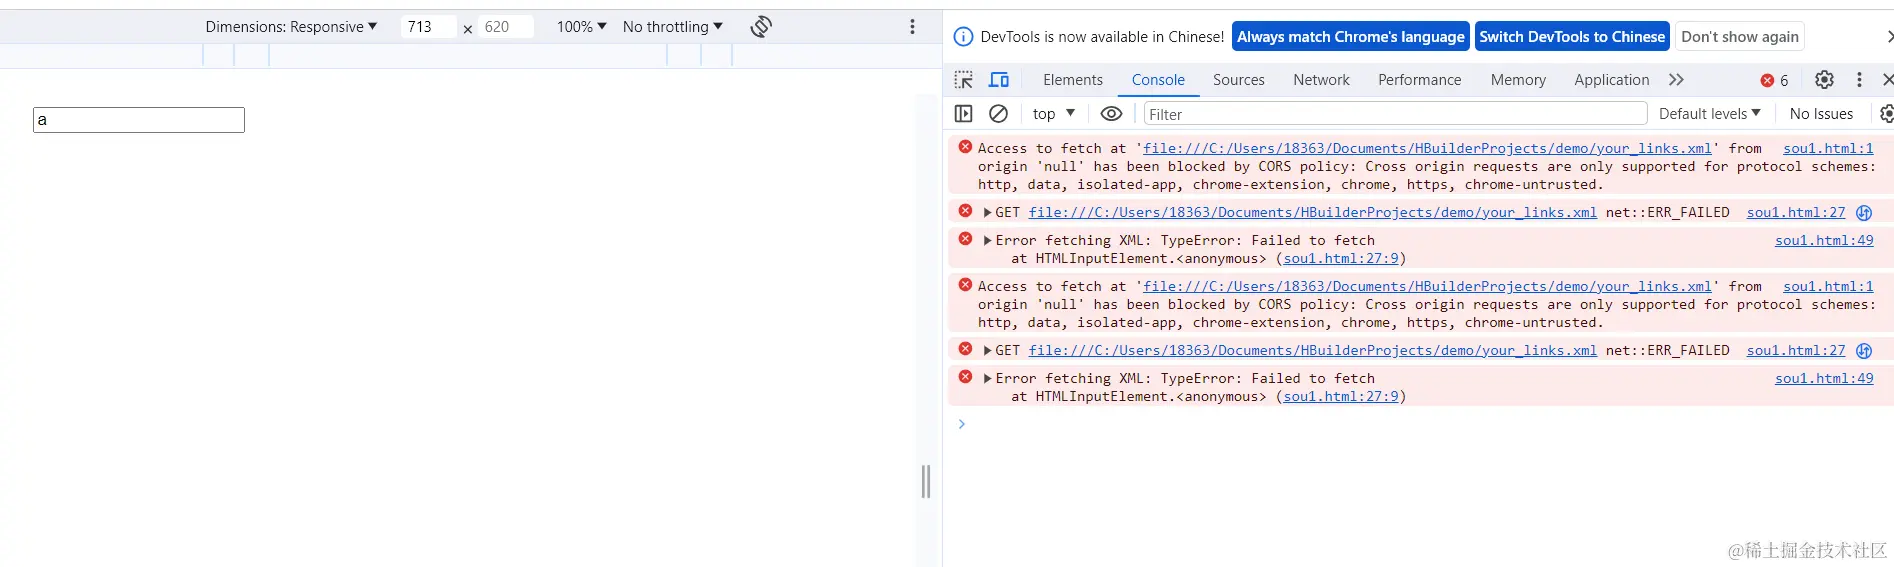
具体而言,我的页面通过file:///协议在本地打开,而XML文件路径为绝对路径C:/Users/18363/Documents/HBuilderProjects/demo/your links.xml。由于file:///协议与C:协议(或本地文件系统路径)被视为不同源,从而触发了跨域请求限制。
解决方法:将相关文件上传至Web服务器环境中运行。经测试,该方案确实解决了跨域问题。
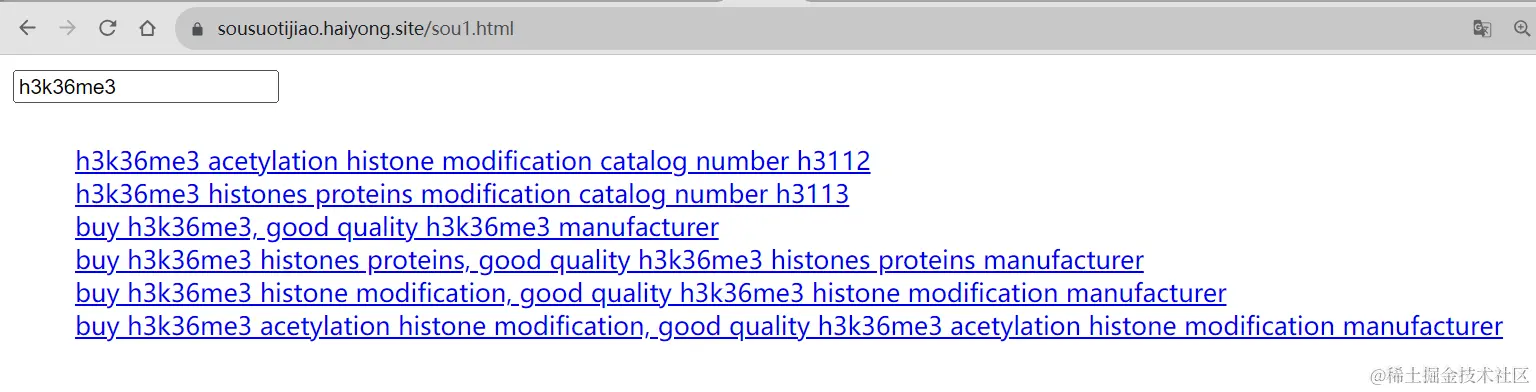
在集成至网站时,我们需要将搜索结果置于页面顶层(即DOM结构的最外层),因此需额外添加一段CSS样式。最终的完整代码如下:
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Search Example</title>
    <style>
        #searchInput {
            margin-bottom: 10px;
        }

        .searchResults {
            position: absolute;
            top: 60px; /* 调整弹窗的垂直位置 */
            left: 10px;
            z-index: 999; /* 确保弹窗在最上层 */
            background-color: white;
            border: 1px solid #ccc;
            padding: 10px;
            display: none;
        }

        .searchResults li {
            list-style-type: none;
        }
    </style>
</head>
<body>
<!-- hysousuo -->
<!-- 搜索框 -->
 <form>
 <input type="text" id="searchInput" placeholder="Search Keywords or Catalog Number">
 </form>
 <!-- 搜索结果 -->
 <ul class="searchResults">
     <!-- 搜索结果将会动态加载到这里 -->
 </ul>

 <!-- JavaScript 代码 -->
 <script>
     const searchInput = document.getElementById('searchInput');
     const searchResultsContainer = document.querySelector('.searchResults');

     searchInput.addEventListener('input', function () {
         const searchKeyword = this.value.toLowerCase();

         // 清空之前的搜索结果
         searchResultsContainer.innerHTML = '';

         if (searchKeyword.trim() === '') {
             // 如果搜索关键字为空,隐藏弹窗并返回
             searchResultsContainer.style.display = 'none';
             return;
         }

         fetch('https://ks-vpeptide.haiyong.site/your_links.xml')
             .then(response => response.text())
             .then(data => {
                 const parser = new DOMParser();
                 const xmlDoc = parser.parseFromString(data, 'application/xml');
                 const links = xmlDoc.querySelectorAll('link');

                 let hasResults = false;

                 links.forEach(link => {
                     const url = link.querySelector('url').textContent.toLowerCase();
                     const title = link.querySelector('title').textContent.toLowerCase();

                     if (title.includes(searchKeyword) || url.includes(searchKeyword)) {
                         const li = document.createElement('li');
                         li.className = 'aurl';
                         li.innerHTML = `<a href="${url}" rel="external nofollow"  rel="external nofollow"  data-lastfrom="" title="${title}">${title}</a>`;
                         searchResultsContainer.appendChild(li);
                         hasResults = true;
                     }
                 });

                 // 根据搜索结果显示或隐藏弹窗
                 searchResultsContainer.style.display = hasResults ? 'block' : 'none';
             })
             .catch(error => console.error('Error fetching XML:', error));
     });

     // 监听输入框失去焦点事件,隐藏搜索结果弹窗
     searchInput.addEventListener('blur', function () {
         // 使用 setTimeout 确保点击搜索结果时能触发链接
         setTimeout(() => {
             searchResultsContainer.style.display = 'none';
         }, 200);
     });
 </script>
最终实现效果展示如下:
当前样式仍有待调整,其他功能基本正常。如有需要帮助,欢迎在评论区留言;若各位有其他添加搜索功能的更佳方案,也欢迎分享供参考。
总结
本文探讨了在静态页面中添加搜索功能的问题、解决方案及优化方法。通过实例演示了如何利用JavaScript动态加载XML数据来实现搜索功能,为需要在静态页面中集成搜索功能的读者提供了具有实际价值的参考。
以上就是使用JS给静态页面添加搜索功能的实现方法的详细内容,更多关于JS静态页面添加搜索功能的资料请关注本站其它相关文章!