

本文介绍如何使用 Node.js 结合 Spider 模块、Cheerio 解析 HTML 以及 HTTP 请求,实现网页文本数据与图片的批量爬取。通过封装核心函数,演示如何获取天气网站结构化数据并保存为 JSON,以及抓取百度图片首页链接并下载保存至本地文件夹,提供完整代码逻辑与实现思路。
Node.js 如何爬取数据与图片
Node.js 爬取数据的方法
在开发网站过程中,往往需要获取特定数据。如果手动从网上复制粘贴,效率较低且繁琐。利用 Node.js 编写爬虫脚本,可以自动化完成所需数据的采集工作。
此处省略背景介绍,直接展示核心实现代码。
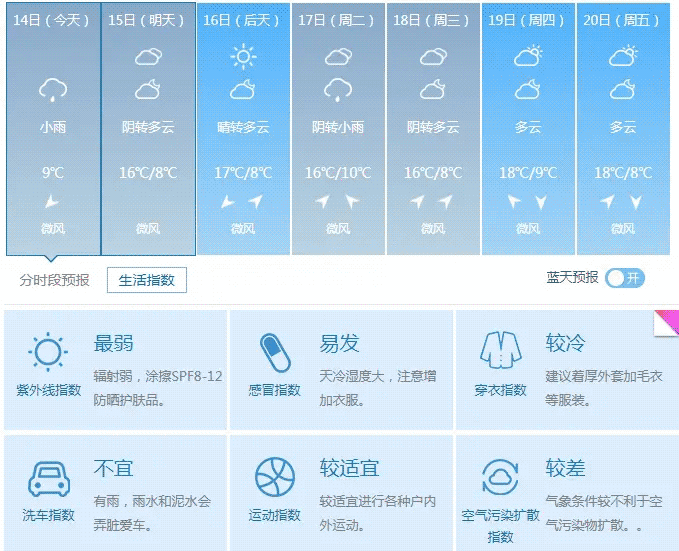
本次示例选取了一个天气查询网站进行数据爬取测试。
运行效果如下所示。
核心依赖模块
首先,需要引入项目所需的核心 Node.js 模块。
//引入核心模块
var http = require("http");
var fs = require("fs");
var cheerio = require("cheerio");
接着,指定目标爬取网站的 URL 地址。
const news = "http://www.weather.com.cn/weather/101010100.shtml";创建 HTTP 服务
随后建立 HTTP 服务,用于接收网络响应数据,并将处理后的结果存储到本地文件系统。
//创建服务
var strHtml = "";
var results = [];
http.get(news,(res)=>{
    //触发接收事件data
    res.on("data",(chunk)=>{
        //接收数据,将数据一点点的追加到没我们定义的空字符串中
        strHtml+=chunk;
    });
    //触发接收完成时间end
    res.on("end",()=>{
        //cheerio类似于jQuery我们在用他之前必须载入文档用(load方法)
        var $ = cheerio.load(strHtml);
        var menew = [];
        //遍历查出来的文本数据
        $("#7d li").each((index,item)=>{
            //定义一个空数组,将数据内容存在里面
            menew.push({id:index,text:$(item).text()});
        });
        //转换JSON字符串
      var res = JSON.stringify(menew);
      //储存到本地
        fs.writeFile("./data1.json",res,(err)=>{
            if(!err) console.log("成功写入");
        })
    });
});
Node.js 爬取图片的实现
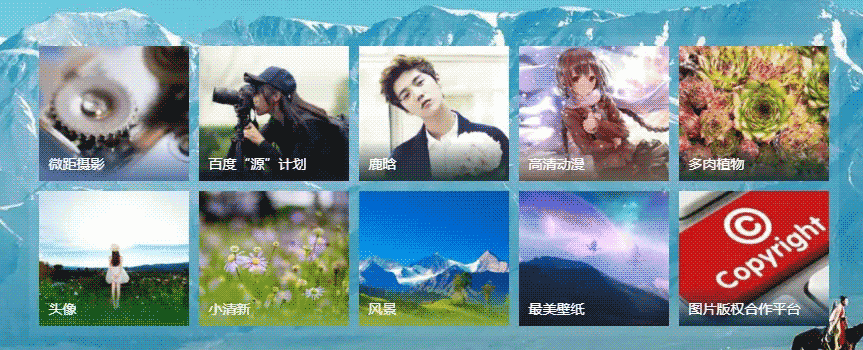
此前曾通过该方法抓取了百度图片首页的部分图片。
图片爬取效果展示。
核心依赖模块
同样,首先需要引入必要的核心模块以支持网络请求与文件操作。
//引入核心模块
var http = require("http");
var https = require("https");
var fs = require("fs");
var cheerio = require("cheerio");
接下来,设定需要爬取图片的目标网站地址。
const news = "http://image.baidu.com/";首要步骤是解析网页,提取出所有图片的 URL 地址。
//创建服务
http.get(imgurl,(res)=>{
    //触发接收事件data
    var imageData = "";
    res.on("data",(chunk)=>{
        //接收数据,将数据一点点的追加到没我们定义的空字符串中
        imageData+=chunk;
    });
    //触发接收完成时间end
    res.on("end",()=>{
        //cheerio类似于jQuery我们在用他之前必须载入文档用(load方法)
        var $ = cheerio.load(imageData);
        var ImgData = [];
        //遍历查出来的文本数据
        $(".img_pic_wrap_layer img").each((index,item)=>{
            //定义一个空数组,将数据内容存在里面
            ImgData.push($(item).attr("src"));
        });
        //循环调用图片函数
        for(var i =0 ; i < ImgData.length ; i ++){
            saveImage(ImgData[i]);
        }
    });
});
封装保存图片函数
根据获取到的图片 URL,编写并封装一个专用函数,用于将图片二进制数据保存为本地文件。
//封装图片函数
function saveImage(imageUrl){
    //创建服务
    https.get(imageUrl,(res)=>{
        //二进制
        res.setEncoding("binary");
        var imageData="";
        //将图片加载到内存中
        res.on("data",(shuju)=>{
            imageData+=shuju;
        });
        //加载完保存图片
        res.on("end",()=>{
            //创建文件夹,如果有择不创建
            if(!fs.existsSync("./img")){
                fs.mkdirSync("./img");
            };
            //保存图片
            fs.writeFile("img/"+Math.random()+'.png',imageData,"binary",(err)=>{
                if(err) throw err;
                console.log("保存成功!!!")
            })
        })
    })
}
若对代码逻辑存在疑问,可前往 GitHub 仓库查看完整源码。
源码获取地址
以上即为使用 Node.js Spider 爬取图片与数据的详细实现过程,更多相关技术资料请参阅本站其他文章。