

本文深入分析JavaScript中document.referrer在各类浏览器中的表现。通过对比IE8、Firefox及Chrome在不同跳转方式下的行为,指出其仅能覆盖约一半场景。重点解析HTTP/HTTPS混合请求中的Referer丢失问题,以及Meta Refresh和Header篡改对流量统计准确性的影响,揭示其作为流量来源判断依据的局限性。
document.referrer的局限性与获取途径
在流量统计系统中,Traffic source(流量来源)是一个针对访次级别的核心概念。当一个新的访次建立时,着陆页(landing page)的来源即被定义为该访次的Traffic source。尽管流量来源的分类繁多,但在当前JavaScript环境下,获取Traffic source的途径仅局限于两种:document.referrer和window.opener。其中,window.opener适用的场景较为有限,而document.referrer的功能则显得非常薄弱,导致在许多实际场景下无法准确判断流量的真实来源。
document.referrer的覆盖范围与浏览器行为测试
document.referrer的覆盖范围分析
从应用角度来看,document.referrer旨在追踪浏览器端的行为。当页面A被加载时,浏览器端可能发生的交互行为主要分为两类:用户手动操作和JavaScript代码执行。
首先考察用户打开页面A时可能执行的操作类型:
| 1 | 直接在地址栏中输入A的地址 |
| 2 | 从B页面左击link A,跳转至A页面 |
| 3 | 从B页面右击link A,在新窗口中打开 |
| 4 | 从B页面右击link A,在新标签页中打开 |
| 5 | 拖动link A至地址栏 |
| 6 | 拖动link A至标签栏 |
| 7 | 使用浏览器的前进、后退按钮 |
需要注意的是,这里的link特指<A>标签,但如果存在特定的事件处理或target属性设置,行为可能会有所不同。
JavaScript打开页面的常见方式包括:
| 1 |
修改window.location |
| 2 |
使用window.open |
| 3 |
点击flash |
上述列举了客户端发起页面跳转的几种主要方法。此外,若通过服务端重定向技术,同样可以使页面A呈现给访问者。
接下来针对具体浏览器进行测试,观察在上述各种情况下document.referrer的具体表现:
| 序号 | 场景 |
IE8.0 | FF3.6 | FF4.0 | chrome |
| 1 | 直接在地址栏中输入A的地址 | " " |
" " |
" " | " " |
| 2 | 从B页面左击link A,A页面替换B页面(target='_self') | √ | √ | √ | √ |
| 3 | 从B页面左击link A,A在新窗口中打开(target='_blank') | √ | √ | √ | √ |
| 3 | 从B页面右击link A,在新窗口中打开 | √ | √ | √ | " " |
| 4 | 从B页面右击link A,在新标签页中打开 | √ | √ | √ | " " |
| 5 | 鼠标拖动link A至地址栏 | / | " " | " " | " " |
| 6 | 鼠标拖动link A至标签栏 | " " | " " | " " | " " |
| 7 | 使用浏览器的前进、后退按钮 | 保持 | 保持 | 保持 | 保持 |
| 8 | 修改window.location打开A页面(同域) | " " | √ | √ | √ |
| 9 | 使用window.open打开A页面 | " " | √ | √ | √ |
| 10 | 点击flash打开A页面 | ||||
| 11 | 服务器重定向至A页面 | " " | " " | " " | " " |
表格中," "表示返回空字符串,√表示能够正确识别来源页,而“保持”意味着使用浏览器的前进或后退按钮时,referrer值不会发生改变。从测试数据可以看出,document.referrer仅能覆盖大约一半的场景。然而,对于一些常用操作,例如利用鼠标将链接拖动至标签栏、或使用浏览器的前进后退功能,它无法做出正确的处理。
document.referrer的数据来源与HTTPS限制
document.referrer的数据来源机制
当浏览器向服务器请求页面A时,会发送HTTP请求。该请求的Header中会包含Referer属性,服务器接收请求后,可提取Header中的Referer信息,用于判断访客是从哪个页面发起的请求。
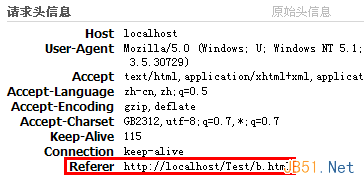
通常情况下,浏览器请求A时发送的Header中Referer的值,即为A页面中document.referrer的值。如上图中请求A页面的Header所示,A页面的document.referrer值为http://localhost/Test/b.html。如果在Header中不包含Referer字段,那么通过document.referrer获取的值将被赋为空字符串。
关于HTTPS请求的特殊处理
如果在普通的HTTP页面上点击了指向HTTPS的链接,HTTPS请求头部通常会附上Referer信息,从而在HTTPS页面中可以通过document.referrer获取到原始HTTP页面的信息。同样,如果从HTTPS页面点击另一个HTTPS链接,请求头部也会附上Referer信息。但是,如果从HTTPS页面点击了HTTP链接,发送的HTTP请求头中将无法包含关于HTTPS页面的信息。这可能是出于对HTTPS页面安全性的一种保护机制。
Referer信息的伪造与Meta Refresh行为
伪造Referer信息的可能性
根据前述分析,document.referrer的值源自HTTP Header中的Referer字段。因此,若要修改document.referrer的值,理论上只需修改请求Header即可。可以将现有的Referer替换为期望的值,或者在原本没有的情况下添加Referer字段。在客户端,篡改Header相对容易。在页面的HTTP请求发出之前,可以利用截包工具进行拦截,分析头部信息并修改Referer。经搜索发现,Firefox用户可以使用RefControl插件方便地修改此值。总之,欺骗Traffic source(流量来源)是轻而易举的事情。
页面强制Refresh的情况
文章撰写后不久,发现遗漏了一种页面跳转方式,即在HTML中使用meta标签强制指定页面进行刷新。例如在b.html中写入以下代码:
具体代码如下:
<meta http-equiv="Refresh" content="5;URL=a.html">执行上述代码后,浏览器会在5秒后自动向服务器发起对a页面的请求。
经过测试,在IE8、FF3.6至FF4.0版本中,均不会带有Referer信息;然而,Chrome浏览器却会将b.html作为Referer添加到请求头部中。