

本文介绍使用JavaScript正则表达式过滤HTML标签及空格的两种实现方案。重点解析去除HTML标签、行尾空白及 字符的正则写法,包括全局匹配、不区分大小写等修饰符的应用,并对关键正则模式的构成进行拆解说明,帮助开发者理解其匹配逻辑。
本文介绍使用JavaScript正则表达式过滤HTML标签及空格的两种实现方案。重点解析去除HTML标签、行尾空白及 字符的正则写法,包括全局匹配、不区分大小写等修饰符的应用,并对关键正则模式的构成进行拆解说明,帮助开发者理解其匹配逻辑。
JavaScript过滤HTML标签与空格的正则实现解析
代码实现如下:
function setContent(str) {
str = str.replace(/<\/?[^>]*>/g,''); // 移除HTML标签
str.value = str.replace(/[ | ]*\n/g,'\n'); // 清除行尾空白
//str = str.replace(/\n[\s| | ]*\r/g,'\n'); // 清除多余空行
return str;
}
测试时发现该代码无法过滤网页中的空格字符(即: )。因此进行了如下改进:
改进后的代码如下:
function removeHTMLTag(str) {
str = str.replace(/<\/?[^>]*>/g,''); // 移除HTML标签
str = str.replace(/[ | ]*\n/g,'\n'); // 清除行尾空白
//str = str.replace(/\n[\s| | ]*\r/g,'\n'); // 清除多余空行
str=str.replace(/ /ig,'');// 移除
return str;
}此方法满足了需求。
接下来简要解释所使用的三个正则表达式(注:本人初学者,解释仅供参考):
第一个:/<\/?[^>]*>/g
在JS中正则表达式以“/”开头,后缀/g表示全局模式,即在整个字符串中应用匹配,而非首次匹配后停止。
<\/?[^>]*> 分解解释:第二个字符“\”为转义字符,用于转义后续的“/”。?匹配0或1个前导字符。注意:并非所有软件都支持此元字符。因此<\/? 匹配HTML标签中的“</”或“<”格式。
接着看[^>]*>。[]表示字符集:
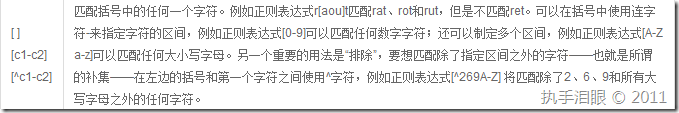
^的含义:匹配行首。例如正则表达式^When in 能匹配字符串"When in the course of human events"的开头,但不能匹配"What and When in the"。即匹配以“When in”开头的文本。
*的含义:匹配0个或多个前导字符。例如正则表达式。* 意味着可匹配任意数量的任何字符
因此[^>]* 意为匹配非>的字符。所以[^>] 可匹配如下模式:
div 所需文字</div 所需文字</p
*与前面的[^>]结合,可匹配以下字符:
div>所需文字</div p>所需文字</p br / 加上末尾的>即可匹配:
div>所需文字</div> p>所需文字</p> br /> 至此完成一对HTML标签的匹配。(多句话,感觉匹配过程略显啰嗦,但不确定具体冗余之处)
第二个:/[ | ]*\n/g:我也未完全理解
第三个:/ /ig:直接查找 字符,后缀/ig表示全局且不区分大小写。g代表全局,i表示不区分大小写。