

本文详解JavaScript中LRU算法的实现。首先分析仅使用Map的缺陷,如哈希冲突导致时间复杂度退化至O(n)。随后介绍标准解法:结合哈希表与双向链表,通过维护节点顺序实现get和put操作的O(1)时间复杂度,并给出完整代码逻辑与结构解析。
许多开发者可能都有同感:LRU算法的理论原理看似简单,但实际编码实现却充满挑战。
直觉上似乎一个Map对象就能搞定,但标准答案往往要求引入双向链表,这让人感到困惑。
思路虽然清晰,但在具体编写代码时,细节处理容易出错,导致调试过程磕磕绊绊。
鉴于LRU在前端开发中应用广泛,且是高频面试题,笔者借此机会整理并分享这一经典算法的实现细节。
LRU简介
LRU全称Least Recently Used(最近最少使用),最初用于操作系统内存管理,如今在前端开发中常用于优化页面性能与资源利用率。
其核心逻辑可直译为:最近最少使用的数据优先级最低,当空间不足时应优先将其移除。
以下是前端场景中应用LRU算法的几个典型例子:
前端路由缓存:在单页应用(SPA)中,将路由信息存入缓存可避免每次访问时重复加载数据,从而提升页面响应速度与用户体验。
图片懒加载优化:针对大型图片库,利用LRU算法缓存已加载图片。当新图片请求到来时,先检查缓存,存在则直接读取,否则从服务器加载。
数据缓存:对于高频读取或计算复杂的数据,使用LRU进行缓存可有效减少重复计算耗时。
字体资源管理:将网站常用字体文件通过LRU算法缓存,有助于加快页面渲染速度并节省网络流量。
综上所述,LRU算法能显著提升前端应用性能与体验,但需根据具体场景选择合适的策略并进行合理配置。
如何实现
接下来我们探讨LRU的具体实现方式,以LeetCode第146题为例进行解析。
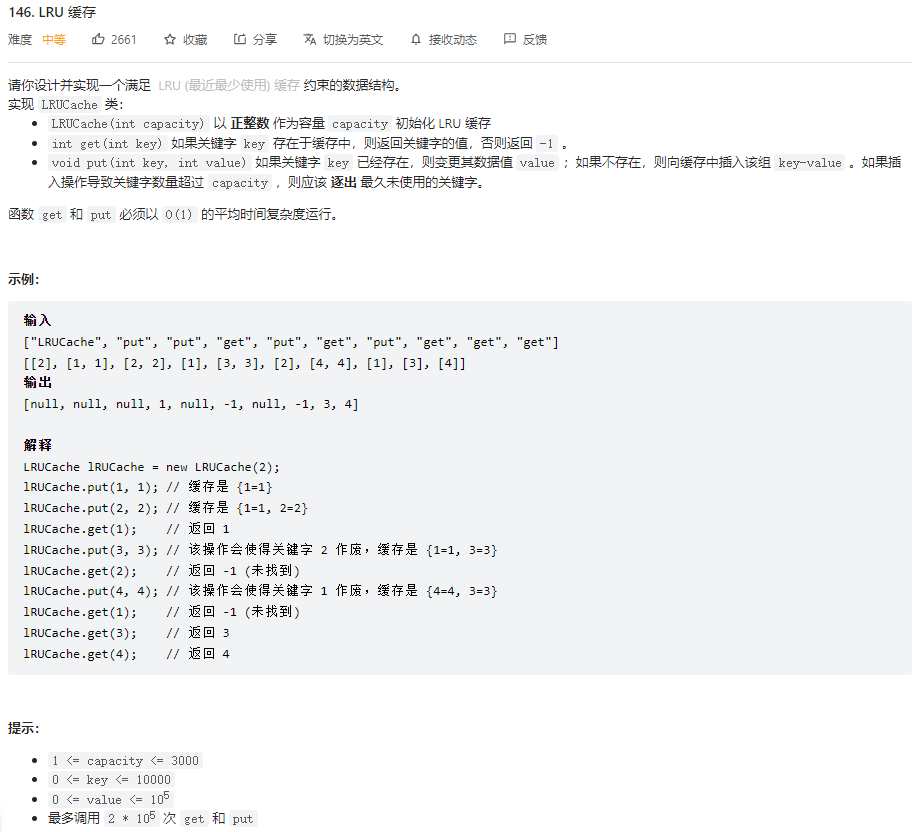
题目要求设计一个LRUCache类,并实现get和put两个核心方法。
题目简述如下:
请设计并实现一个满足LRU(最近最少使用)约束的数据结构。
具体需实现LRUCache类,包含以下功能:
- LRUCache(int capacity):使用正整数capacity初始化LRU缓存容量。
- int get(int key):若关键字key存在于缓存中,则返回其值;否则返回-1。
- void put(int key, int value):若关键字key已存在,则更新其值value;若不存在,则插入该key-value对。若插入后关键字数量超过capacity,则逐出最久未使用的关键字。
实现思路
一种直观的思路是使用Map对象来存储缓存数据。
执行get操作时,先判断key是否存在于Map中。若存在,取出该值暂存为temp,从Map中删除原key,再重新将key与temp存入Map,以此更新其使用顺序。
执行put操作时,同样先判断key是否存在。若不存在,直接存入Map;若存在,则先删除原key,再重新存入新的key-value对。
通过这种方式,保证最近使用的数据始终位于Map的末尾。当容量溢出时,直接删除Map中最早插入的元素(即顶层元素)即可。
具体代码表现为:this.map.delete(this.map.keys().next().value)
var LRUCache = function(capacity) {
	this.capacity = capacity
  this.map = new Map()
}

LRUCache.prototype.get = function(key) {
  if(this.map.has(key)) {
    let temp = this.map.get(key)
    this.map.delete(key)
    this.map.set(key,temp)
    return temp
  } else {
    return -1
  }

}
LRUCache.prototype.put = function(key, value) {
	if(this.map.has(key)) {
    this.map.delete(key)
  }
  this.map.set(key,value)
  if(this.map.size > this.capacity) {
    this.map.delete(this.map.keys().next().value)
  }
}
缺陷
尽管上述实现利用了Map对象,但在最坏情况下,若哈希函数分布不均导致哈希冲突,某些操作的时间复杂度可能退化为O(n)。因此,在处理大规模数据时,建议采用双向链表或其他更高效的数据结构。
假设有一个大小为5的哈希表,使用的哈希函数为key % 5。现插入以下6个键值对:
{key: 1, value: 'a'}
{key: 2, value: 'b'}
{key: 3, value: 'c'}
{key: 4, value: 'd'}
{key: 6, value: 'e'}
{key: 11, value: 'f'}
根据给定的哈希函数key % 5,可将每个键映射到哈希表的一个桶中,具体做法是将键除以5取余数,得到插入桶的索引。
使用此哈希函数插入上述六个键值对后,结果如下:
在索引1的桶中插入{key: 1, value: 'a'}
在索引2的桶中插入{key: 2, value: 'b'}
在索引3的桶中插入{key: 3, value: 'c'}
在索引4的桶中插入{key: 4, value: 'd'}
在索引1的桶中插入{key: 6, value: 'e'}
在索引1的桶中插入{key: 11, value: 'f'}
注意,当插入键为6和11的键值对时,它们均被映射到索引1的桶中,因为它们与1的余数相同。
当出现哈希冲突,即多个键被映射到同一桶时:
此时操作需要遍历整个桶来查找指定键值对,导致操作时间复杂度变为O(n)。
双向链表+哈希表
那么如何达到O(1)的时间复杂度呢?
这需要选用Map进行查询、修改和删除操作,并尽量保持O(1)的复杂度。在常见数据结构中,树和图被排除,栈和队列无法任意查询中间元素也被排除,因此选择链表。若使用单链表,删除节点需O(n)遍历寻找前驱节点,故选用双向链表,以便在删除时也能实现O(1)操作。
核心原则是:最近最多使用的节点始终位于链表尾部,最近最少使用的节点位于链表头部。
双向链表
双向链表的结构包含以下要素:
value:存储的实际值。
prev:指向前一个元素的指针。
next:指向下一个元素的指针。
Head和Tail是虚拟的头部和尾部节点,用于方便定位链表的首尾。
┌──────>┐ ┌───────>┐ ┌───────>┐ head • (x|"three"|•) (•|"two"|•) (•|"one"|x) • tail └<────────┘ └<───────┘ └<─────┘
实现思路
1. 使用一个Map对象存储键值对映射关系。
2. 使用一个双向链表维护键值对的访问顺序。
3. 抽离出addToTail方法(将节点插入末尾)和remove方法(删除节点)。
4. 执行put操作时,判断节点是否在Map中:
- 若存在,获取当前节点值,在双向链表中调用remove删除该节点,再调用addToTail将其添加到末尾。
- 若不存在,创建一个新的双向链表节点,调用addToTail添加到末尾,同时将其加入Map。
- 若插入后节点数量超过容量(this.size > this.cap),则删除当前head节点,并从Map中移除对应的key。
5. 执行get操作时,判断节点是否在Map中:
- 若不存在,返回-1。
- 若存在,获取当前key和value,重新执行put操作以更新其位置。
class ListNode {
  constructor(key, value) {
    this.key = key;
    this.val = value;
    this.prev = null;
    this.next = null;
  }
}

class LRUCache {
  constructor(capacity = 10) {
    this.capacity = capacity;
    // 实际保存的键值对数量
    this.size = 0;
    this.map = {};
    //代表最旧的节点
    this.head = null;
    //代表最新的节点
    this.tail = null;
  }

  get(key) {
    const node = this.map.get(key);
    if (!node) return -1;
    let node = this.map[key];
    this.put(node.key, node.val);
    return node.value;
  }

  put(key, value) {
    if(this.map[key]) {
    	let node = this.map[key]
      node.val = value
      this.remove(node)
      this.addTotail(node)
    } else {
      let node = new ListNode(key,value)
      this.addTotail(node)
      this.map[key] = node
      this.size++
    }
    if (this.size > this.cap) {
      let key = this.head.key;
      this.remove(this.head);
      delete this.map[key];
      this.size--;
    }
  }
  addToTail(node) {
    if(this.tail) {
      this.tail.next = node
      node.prev = this.tail
      this.tail = node
    } else {
      this.tail = node
      this.head = node
    }
  }
  remove(node) {
    if(node.prev) {
      node.prev.next = node.next
    } else {
      this.head = this.head.next
    }
    if(node.next) {
      node.next.prev = node.prev
    } else {
      this.tail = this.tail.prev
    }
    node.prev = node.next = null;
  }
}
以上就是JavaScript实现LRU算法的示例详解,更多关于JavaScript LRU算法的资料请关注本站其它相关文章!