

本文深入解析 big.js 库如何解决 JavaScript 小数精度丢失问题。通过分析 Big 构造函数中的 parse 方法,了解数值如何被转换为内部数组结构;接着拆解 P.plus 方法,详细讲解符号判断、零值处理、位数对齐及逐位相加的核心逻辑,揭示将小数转为整数运算以保精度的实现原理。
前言
在日常前端开发中,小数运算导致结果不准确是常见痛点,其根本原因在于浮点数精度丢失。虽然 big.js、decimal.js 等库能解决此问题,但许多开发者并不清楚其底层实现原理。
本文将逐步剖析 big.js 的部分核心源码,帮助读者理解此类数值处理库是如何应对精度丢失挑战的。
初窥门径 —— 打开调试窗口
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <title>Document</title>
    <script src='https://cdn.jsdelivr.net/npm/big.js@6.2.1/big.min.js'></script>
</head>
<body>
    <script>
        new Big(0.1);
    </script>
</body>
</html>
首先,按下 F12 或 Ctrl+Shift+I 打开 Chrome 开发者工具。
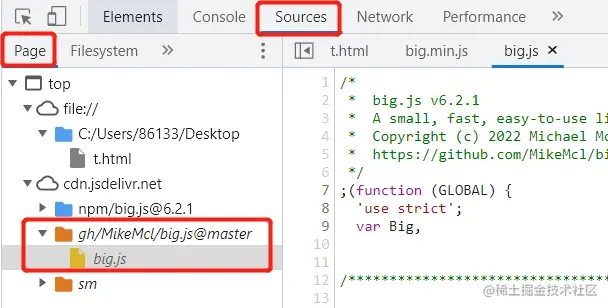
在 Sources 面板的 Page 列表中,定位到未混淆的 big.js 源码文件(注意区分 xxx.min.js 等压缩混淆版本,其可读性较差),这就是我们需要分析的完整源代码。
知根知底 —— Big 构造函数做的好事
首先分析 Big 构造函数的具体行为。
function _Big_() {
    function Big(n) {
        var x = this;
        // 可以通过函数调用的形式来创建 Big 对象
        if (!(x instanceof Big)) return n === UNDEFINED ? _Big_() : new Big(n);
        // 区分是否为 Big 示例.
        if (n instanceof Big) {
            x.s = n.s;
            x.e = n.e;
            x.c = n.c.slice();
        } else {
            // 边界处理
            if (typeof n !== 'string') {
                if (Big.strict === true && typeof n !== 'bigint') {
                    throw TypeError(INVALID + 'value');
                }
                // Minus zero?
                n = n === 0 && 1 / n < 0 ? '-0' : String(n);
            }
            parse(x, n);
        }
        x.constructor = Big;
    }
    ...
    return Big;
}
观察代码可知,构造函数首先执行边界条件处理与入参类型检查,随后调用 parse 函数进行核心解析,最后修正构造函数的指向。
我们将 this 对象加入 watches 监视列表,在 parse 函数执行完毕后设置断点并刷新页面。
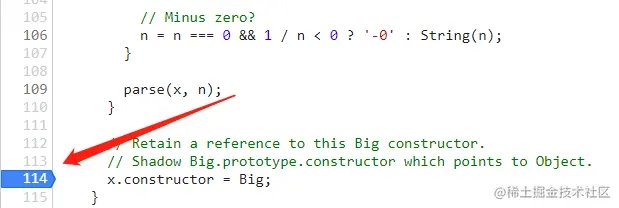
观察经过 parse 函数处理后的数据状态:
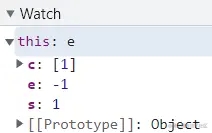
其中,c 是去除首尾 0 后剩余数字组成的数组,e 表示用科学计数法表示 parse 函数入参 x 时的幂指数,s 表示正负号(1 代表正数,-1 代表负数)。
以 new Big(120) 为例,去除首尾 0 后,c 属性的值为 [1, 2];
对于入参 x = 120,其科学计数法表示为 1.2 * 10²,因此 e 的值为幂指数 2,显然 s = 1。同理,new Big(1.2) 对应的值为 c = [1, 2], e = 0(1.2 * 10º), s = 1。
显然,parse 函数负责数据预处理,为后续运算奠定基础。
对细节感兴趣的读者可通过 Ctrl + F 快捷搜索进一步研究。
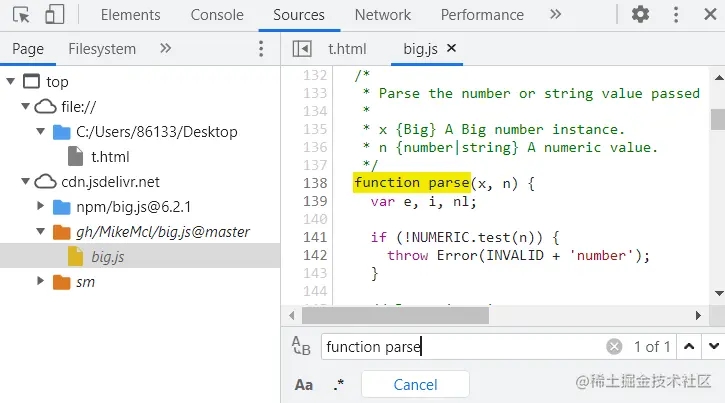
至此,我们已窥得 Big 构造函数的全貌,接下来分析 plus/add 方法的实现。
抽丝剥茧 —— P.plus 源码分析
沿用之前的方法,按 Ctrl+F 搜索 P.plus 并回车,跳转到该方法在源码中的位置。
完整源码
P.plus = P.add = function (y) {
    // 1. 用 x 和 Big 两个变量分别保存 this(调用者) 和 Big 构造函数
    var e, k, t,
        x = this,
        Big = x.constructor;
    // 2. 将入参转化为 Big 对象
    y = new Big(y);
    // 3. 判断是否符号不同,如果不同则直接调用 minus 做减法(1 + (-1)=== 1 - 1)
    if (x.s != y.s) {
        y.s = -y.s;
        return x.minus(y);
    }
    // 4. 分别存储 x 和 y 各自的小数点位置以及 number 数组
    var xe = x.e,
        xc = x.c,
        ye = y.e,
        yc = y.c;
    // 5. Either zero?
    if (!xc[0] || !yc[0]) {
        if (!yc[0]) {
            if (xc[0]) {
                y = new Big(x);
            } else {
                y.s = x.s;
            }
        }
        return y;
    }
    // 6. copy xc 数组
    xc = xc.slice();
    // 7. 补 0(对齐 x 和 y 的长度)
    // Prepend zeros to equalise exponents.
    // Note: reverse faster than unshifts.
    if (e = xe - ye) {
        if (e > 0) {
            ye = xe;
            t = yc;
        } else {
            e = -e;
            t = xc;
        }
        t.reverse();
        for (; e--;) t.push(0);
        t.reverse();
    }
    // 8. 如果 xc 长度大于 yc,则交换它们
    // Point xc to the longer array.
    if (xc.length - yc.length < 0) {
        t = yc;
        yc = xc;
        xc = t;
    }
    e = yc.length;
    // 9. 相加
    // Only start adding at yc.length - 1 as the further digits of xc can be left as they are.
    for (k = 0; e; xc[e] %= 10) k = (xc[--e] = xc[e] + yc[e] + k) / 10 | 0;
    // No need to check for zero, as +x + +y != 0 && -x + -y != 0
    if (k) {
        xc.unshift(k);
        ++ye;
    }
    // Remove trailing zeros.
    for (e = xc.length; xc[--e] === 0;) xc.pop();
    y.c = xc;
    y.e = ye;
    return y;
};
步骤 1 —— 变量定义
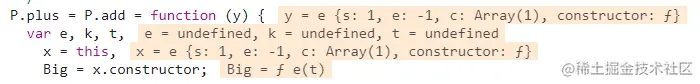
步骤 1 中使用 x 和 Big 两个变量分别保存 this(调用者) 和 Big 构造函数。
步骤 2 —— 处理入参

步骤 2 将入参 y 转换为 Big 实例。
步骤 3 —— 判断符号
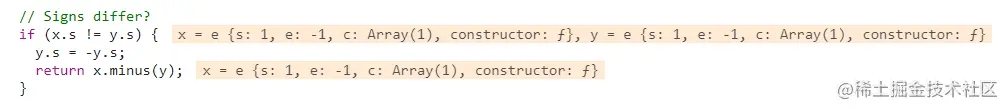
步骤 3 判断 x 和 y 的符号是否不同。若不同,先将 y 取反,调用 minus 方法处理,因为一个数加上一个负数等价于减去该负数的绝对值(即 1+(-1)===1-1 的原理)。
此处符号相同,因此继续执行后续逻辑。
步骤 4 —— 保存属性
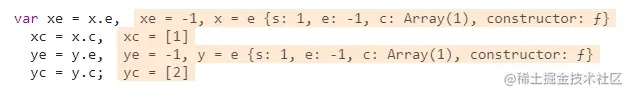
步骤 4 中,保存了 x 和 y 的数字数组及符号位置,具体作用尚待后续分析,继续向下阅读。
步骤 5 —— 处理值为 0 的情况
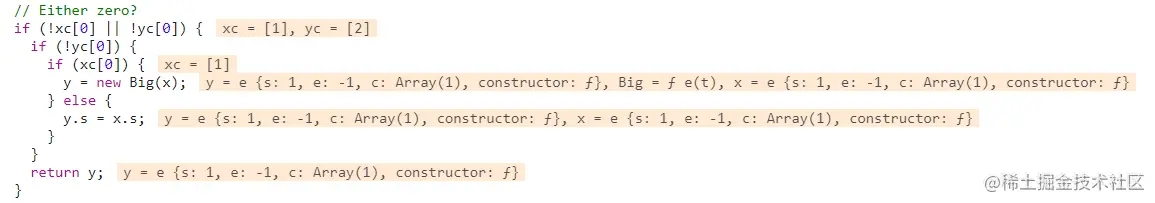
步骤 5 的 if 条件看来不成立,我们自行分析。
if 的判断条件是 !xc[0] || !yc[0],这里用到了步骤 4 保存的变量。xc 即 x 的数字数组(对应 big 实例的 c 属性),yc 同理。需注意,经构造函数调用 parse 解析后,首尾 0 已被移除,!xc[0] 和 !yc[0] 为何可能为 true?必然存在逻辑将其置为 0。查看源码证实确实如此。
function parse(x, n) {
    ...
    // Determine leading zeros.
    for (i = 0; i < nl && n.charAt(i) == '0';) ++i;
    if (i == nl) {
      // Zero.
      x.c = [x.e = 0];
    } else {
      // Determine trailing zeros.
      for (; nl > 0 && n.charAt(--nl) == '0';);
      x.e = e - i - 1;
      x.c = [];
      // Convert string to array of digits without leading/trailing zeros.
      for (e = 0; i <= nl;) x.c[e++] = +n.charAt(i++);
    }
    ...
}
源码注释明确指出,当实例化入参 x 判定为 0 时,x.c 和 x.e 均被置为 0。因此步骤 5 是一个提前返回操作,直接返回与 0 相加的结果。
步骤 6 —— 拷贝 xc 防止数据污染
步骤 6 中拷贝了一份 xc 数组,以避免原始数据被污染。
步骤 7 —— 补 0 对齐
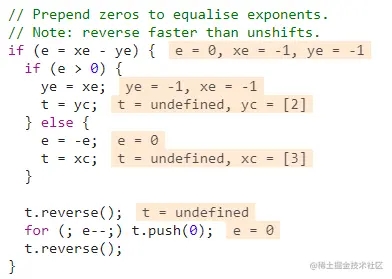
这段代码的作用是补 0,旨在对齐 x 和 y 的长度,便于后续按位置进行运算(类似大整数加法中的补 0 对齐操作)。
例如,对于 big(1.2).plus(120),此时 t = xc = [1, 2],执行 reverse + push + reverse 后变为 [0, 0, 1, 2] 和 [1, 2, 0, 0]。
步骤 8 —— 比较 xc 和 yc 的长短
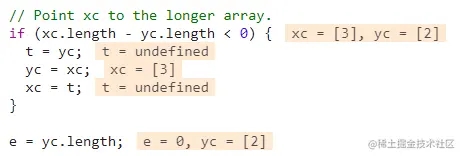
步骤 8 中,将 xc 指向长度较长的数组,yc 指向较短的数组,并将较短的 yc.length 长度存入 e。
步骤 9 —— plus 操作

步骤 9 是核心逻辑,正式执行 plus 操作。
此处涉及大整数相加逻辑,为便于理解,作者制作了动态演示图。
现在明白为何 xc 指向较长数组而 yc 指向较短数组:较短数组前端填充的是 0,这些 0 无需进行相加处理。
至此,P.plus 的源码分析结束。
终章
本文到此结束。纵观解析过程,big.js 的加法操作核心在于将小数全部转换为整数进行相加。既然小数运算会丢失精度,转化为整数计算即可避免。计算完成后再转换回小数格式。更多关于 big.js 解决精度丢失的资料请关注本站其它相关文章!