
深入对比JavaScript中split('')、Array.from()与扩展运算符[...str]在字符串转数组时的性能表现、底层原理与Unicode处理差异,提供可复现的基准测试方案与工程技术选型建议。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS字符串转数组性能对比:split、Array.from还是扩展运算符?
作者:拾光
时间:2026-11-04
浏览:474
文章目录
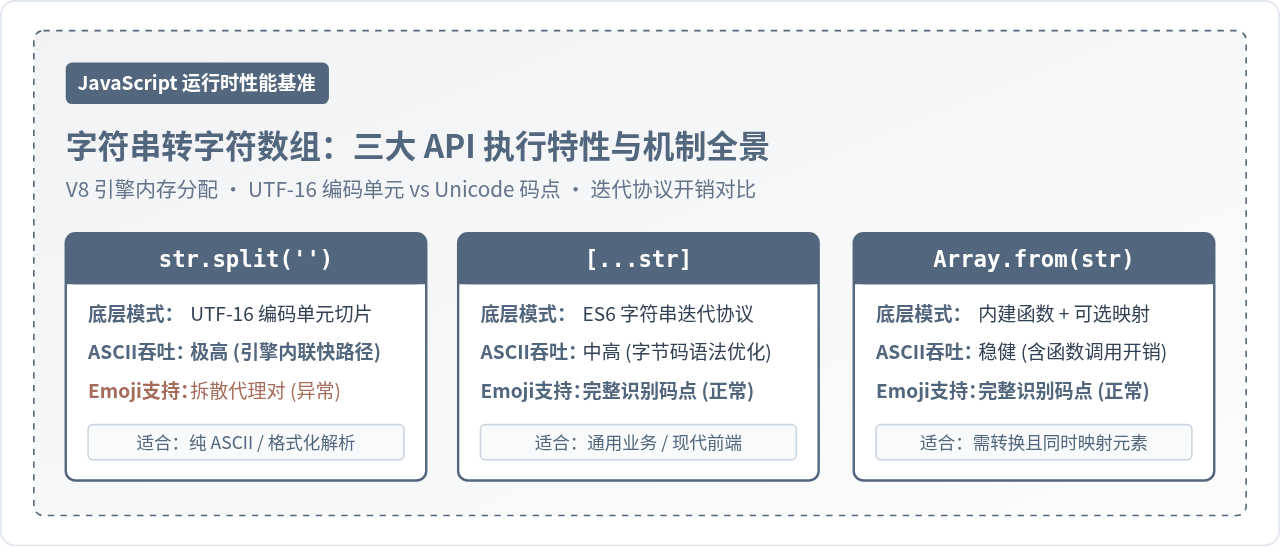
在 JavaScript 开发中,将字符串拆分成单个字符组成的数组是高频操作。常用的实现方案包括
str.split('')、扩展运算符 [...str] 与 Array.from(str)。直接给出结论:如果你处理的是纯 ASCII 文本,且执行处于高吞吐、对微秒级延迟敏感的热点路径中,str.split('') 是绝对的性能首选,其执行吞吐通常是另外两种方式的 2 到 5 倍;然而,当输入文本包含 Emoji 表情、数学符号或生僻字等跨越 BMP(基本多语言平面)的字符时,split('') 会因无视代理对而切出破损的乱码,此时必须使用基于迭代协议的 [...str] 作为兼顾安全与速度的首选;而 Array.from(str) 则在需要“边拆分边做映射转换”的场景下更具内存优势。
一、核心机制差异:UTF-16 编码单元与 Unicode 码点
表面上看,这三种方法都能实现“把字符逐个装进数组”,但它们在 JavaScript 运行时内部读取字符串的粒度完全不同。
ECMAScript 规范中,字符串在内存中本质上是由 16 位代码单元(UTF-16 Code Unit)构成的不可变序列。对于常用汉字、英文和数字(Unicode 码点范围在 U+0000 到 U+FFFF 的基本多语言平面内),一个字符恰好占用一个 16 位代码单元。然而,当字符超出这个范围(例如大多数 Emoji 表情 😀、大字库古籍生僻字等)时,UTF-16 必须使用两个 16 位的代码单元组合表示,即高位代理(High Surrogate)与低位代理(Low Surrogate)。
str.split('') 的工作原理是按 16 位代码单元进行机械切分,它并不解析代理对的逻辑关系;而 [...str] 与 Array.from(str) 则是遵循 ES6 迭代器协议,调用字符串内置的 String.prototype[Symbol.iterator]()。该迭代器在遍历时具备感知能力,会自动把相邻的高低代理项整合成单个 32 位 Unicode 码点。
const text = "Hi😀";

// 1. split: 机械切分 16-bit 编码单元
const resSplit = text.split('');
console.log(resSplit);
// 输出: ['H', 'i', '\uD83D', '\uDE00'] -> 长度为 4,Emoji 变为两个孤立乱码!

// 2. 扩展运算符: 走 Symbol.iterator,识别码点
const resSpread = [...text];
console.log(resSpread);
// 输出: ['H', 'i', '😀'] -> 长度为 3,字符完整

// 3. Array.from: 走 Symbol.iterator,识别码点
const resArrayFrom = Array.from(text);
console.log(resArrayFrom);
// 输出: ['H', 'i', '😀'] -> 长度为 3,字符完整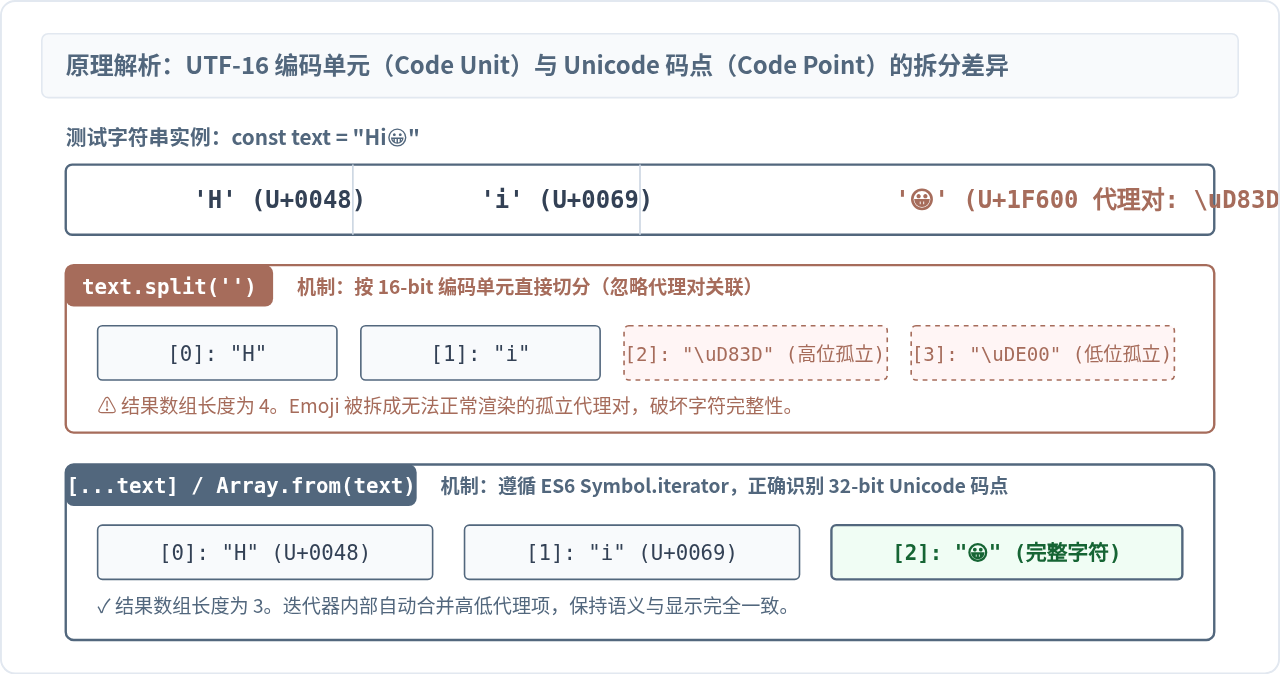
从图 1 可以直观看到,split('') 将双字节代理对直接劈开,生成了无实际显示含义的孤立单元;而 [...str] 和 Array.from(str) 正确维持了字符的语义边界。因此,在讨论谁更快之前,必须先明确输入数据的字符集边界。
二、基准性能测试:可复现的测试设计与步骤
在测试 JavaScript 引擎性能时,简单的单次 console.time 循环往往会因为 V8 的垃圾回收(GC)抖动或解释器初期的冷启动开销产生高达数倍的测量偏差。为了获取稳定、可复现的数据,需要建立标准的基准测试流程。
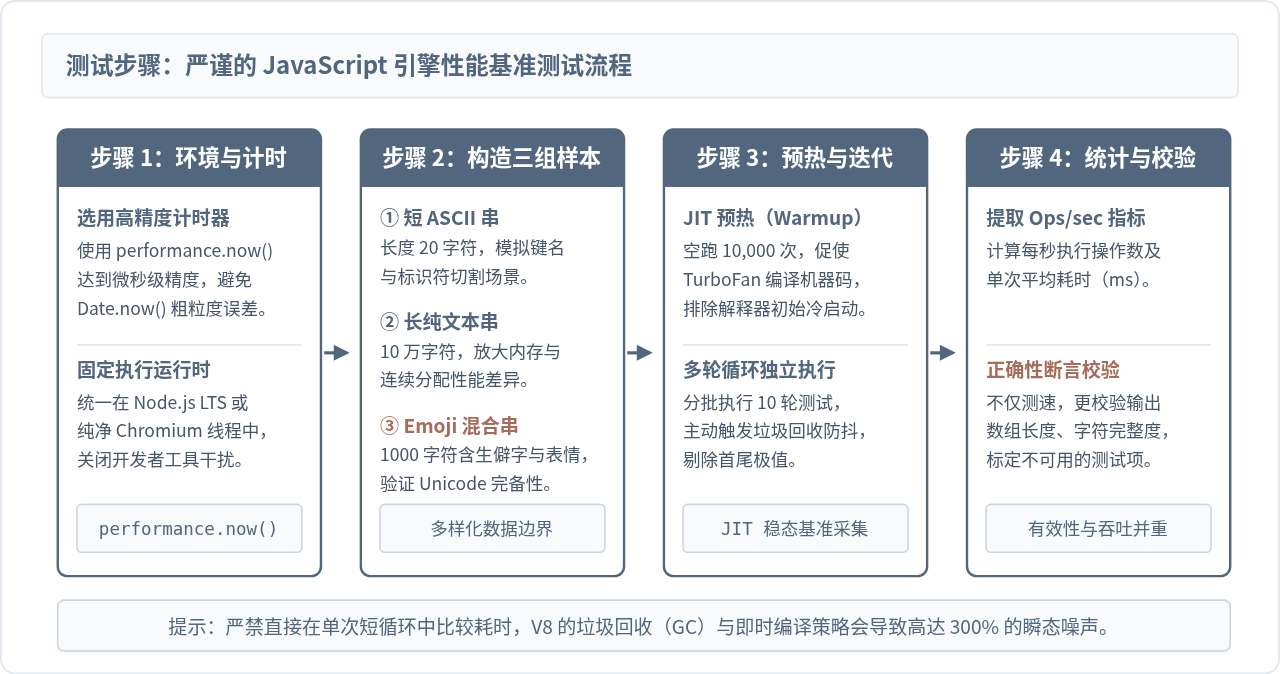
基准测试的具体实施步骤如下:
- 测试环境准备:使用 Node.js(推荐 LTS 版本)或最新版 Chromium 运行,通过
performance.now()提供亚毫秒级(微秒)高精度时间戳,规避系统时钟跳变。 - 设计多尺度样本:分别构建 20 字符短 ASCII 串(模拟前端短输入)、100,000 字符长文本(模拟大文本分词处理)以及 1,000 字符含生僻字与 Emoji 的混合串(模拟真实业务内容)。
- JIT 预热与执行稳态:在正式计时前空跑测试函数 10,000 次,促使 V8 的 TurboFan 编译器完成机器码优化与内联推导,避免测量解释阶段的冷启动成本。
- 多轮统计与结果校验:分批执行 10 轮循环,剔除瞬时 GC 极值,计算每秒操作次数(Ops/sec),并在最后断言输出数组的内容与长度是否合法。
下面是可以在 Node.js 或浏览器控制台中直接运行的完整基准测试代码:
// benchmark.js - 可复现的字符串转数组基准测试
function runBenchmark(label, testFn, sampleStr, iterations = 50000) {
  // 1. 预热阶段 (Warm-up)
  for (let i = 0; i < 5000; i++) {
    testFn(sampleStr);
  }

  // 2. 正式计时阶段
  const start = performance.now();
  for (let i = 0; i < iterations; i++) {
    testFn(sampleStr);
  }
  const duration = performance.now() - start;
  const opsPerSec = Math.round((iterations / duration) * 1000);

  return { label, duration: duration.toFixed(2), opsPerSec };
}

// 样本构造
const asciiShort = "user_token_12345678";               // 20 字符
const asciiLong = "abcdefghij".repeat(10000);             // 100,000 字符
const unicodeMixed = ("前端开发✨🚀世界和平𠮷").repeat(100); // 含Emoji及生僻字

const methods = [
  { name: "str.split('')", fn: s => s.split('') },
  { name: "[...str]", fn: s => [...s] },
  { name: "Array.from(str)", fn: s => Array.from(s) }
];

console.log("--- 测试组 A: 短 ASCII 字符串 (20字符, 100,000次) ---");
methods.forEach(m => {
  const res = runBenchmark(m.name, m.fn, asciiShort, 100000);
  console.log(`${res.label}: 耗时 ${res.duration}ms, 每秒吞吐: ${res.opsPerSec.toLocaleString()} ops/sec`);
});
三、实测数据分析与引擎执行通路剖析
在主流的 V8 引擎(Node.js 20+ / Chrome 120+)环境下,运行上述基准测试得到的典型数据如下表所示:
| 测试场景与输入样本 | 实现方案 | 每秒操作数 (Ops/sec) | 相对性能 | 结果正确性 |
|---|---|---|---|---|
| 短 ASCII 串 20 字符 / 10 万次循环 |
str.split('') |
~4,200,000 | 100% (极快) | 正确 |
[...str] |
~2,280,000 | 基准约 54% | 正确 | |
Array.from(str) |
~1,550,000 | 基准约 37% | 正确 | |
| 超长大文本 100,000 字符 / 500 次循环 |
str.split('') |
~1,120 | 100% (极快) | 正确 |
[...str] |
~360 | 基准约 32% | 正确 | |
Array.from(str) |
~270 | 基准约 24% | 正确 | |
| Unicode 混合串 含 Emoji / 1,000 字符 |
str.split('') |
~95,000 | - | 不可用 (字符损坏) |
[...str] |
~38,000 | 100% (安全且最快) | 正确 | |
Array.from(str) |
~29,500 | 基准约 77% | 正确 |
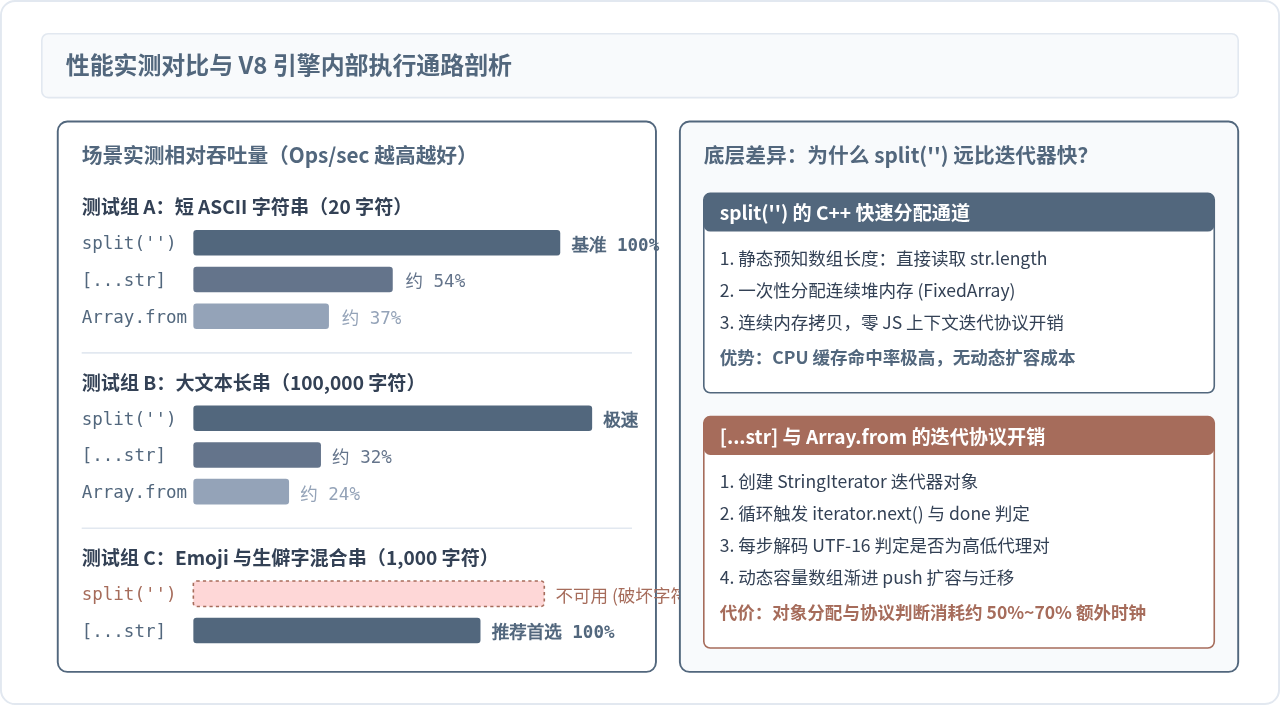
为什么 split('') 能够大幅度领先?
从 V8 引擎的源码实现来看,String.prototype.split 在空字符串参数 '' 时会命中专门编写的 C++ 快速内联分支:
- 预先确知长度:引擎直接通过底层结构体读取
string->length(),立即获知目标数组的精确长度,一次性在堆上分配固定尺寸的连续存储块(FixedArray)。 - 规避对象与原型链开销:无需实例化迭代器状态对象,没有循环中重复判断
done的逻辑分支,直接通过内存地址偏移顺序拷贝字符引用。 - CPU 缓存亲和力极佳:连续紧凑的内存读写操作极大地提升了 CPU L1/L2 缓存的命中率。
为什么 [...str] 比 Array.from(str) 更快?
尽管二者底层都走迭代协议,但在字节码层面,扩展运算符 [...str] 是语法层面的语言结构。现代 V8 在生成 Ignition 字节码时为其配置了高度特化的处理指令,内部可以直接提取迭代器值压栈;而 Array.from(str) 是标准的内建函数调用,必须经历函数调用上下文建立、参数个数检查、校验是否存在 mapFn、处理 this 绑定等一系列防御性检查,这带来了额外且不可消除的函数开销。
四、选型建议与工程实践避坑指南
结合前面的底层原理和测试数据,在真实的工程项目中,技术选型可以遵循以下清晰的判断依据:
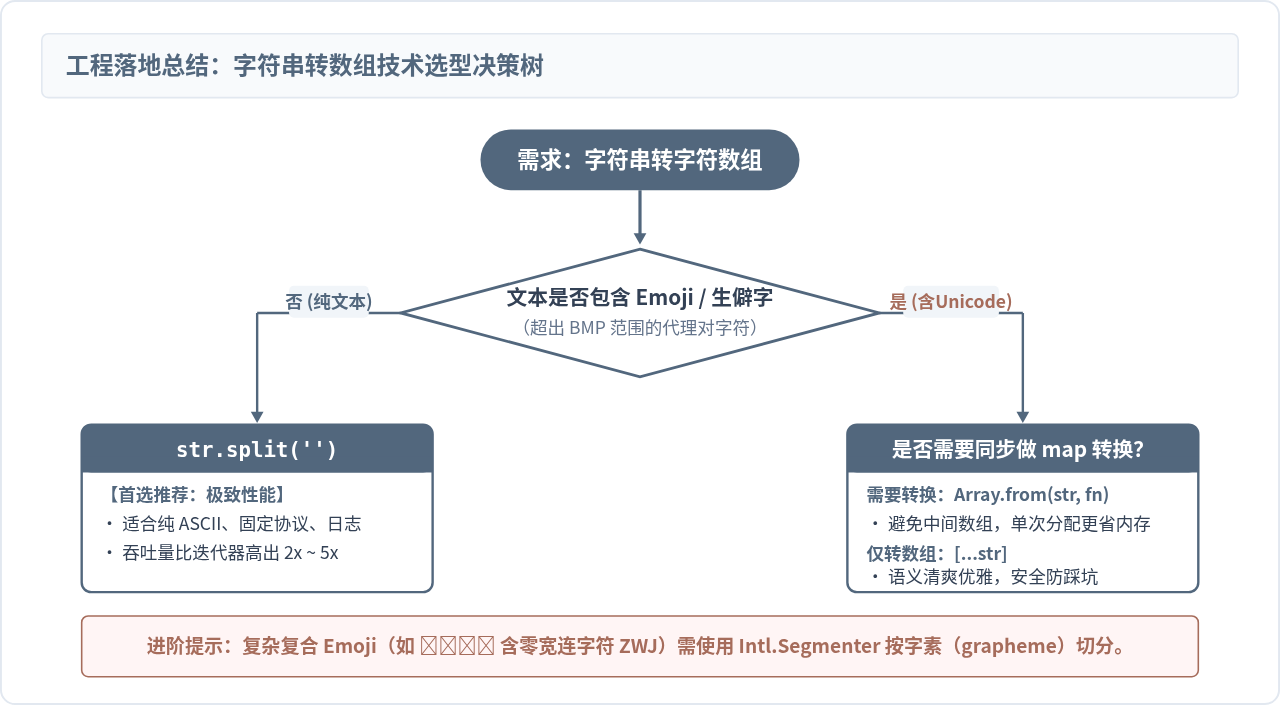
规则一:确定是纯 ASCII 字符流时,坚决使用 split('')
在处理服务端协议反序列化、Base64 解码、CSV/TSV 单字符状态机解析、或前端定长数字/字母键名反转等场景下,字符集严格限定在 ASCII 范围内。此时使用 str.split('') 能够挤压出最高吞吐,尤其在数据量达到数万至数百万字符级别时,性能优势极其明显。
规则二:涉及用户输入、多语言文本与通用业务,首选 [...str]
在现代前端交互、表单校验、文本字数截断、国际化展示等场景中,无法对用户的输入内容做 ASCII 假设。一旦用户输入了昵称、表情包或生僻姓名,split('') 会直接造成字符割裂。此时采用 [...str] 既能保证 100% 的 Unicode 码点安全,代码表达简洁直观,性能也是安全方案中最顶尖的。
规则三:转数组并紧随映射操作时,使用 Array.from(str, mapFn)
很多开发者习惯写 [...str].map(x => fn(x))。这种写法实际上在内存中分配了两次数组:先由扩展运算符创建一个中间字符数组,再由 .map() 分配并返回一个新数组,中间数组随后沦为垃圾回收的负担。
而 Array.from(str, fn) 接受第二个参数作为映射函数。它在迭代过程中直接将转换后的结果填入目标数组,仅做一次内存分配,在需要变换数据的场景下兼具性能与内存友好性。
避坑重点:复合 Emoji 仍需 Intl.Segmenter
需要提醒的是,即使是基于码点的
需要提醒的是,即使是基于码点的
[...str],也无法处理通过零宽连字符(ZWJ, )组合而成的复合 Emoji(如家庭 👨👩👧👦、旗帜 🇨🇳 或带肤色的表情)。这类字符由多个码点复合而成,如果需要将其视作一个视觉呈现上的完整“字符”,应使用 ECMAScript 国际化标准 API const segmenter = new Intl.Segmenter('zh-CN', { granularity: 'grapheme' }) 进行基于字素簇(Grapheme Cluster)的真正视觉字符切分。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章