

首届人形机器人半程马拉松在京举行,引发对行业泡沫的讨论。千寻智能解浚源认为,领域仍处规模定律早期,硬件迭代是主要瓶颈。技术路径已收敛至端到端的视觉-语言-动作模型,核心在于数据采集的工业化。相比大模型,机器人数据具私有壁垒且能形成数据飞轮,商业潜力显著。依托中国供。
具身智能跨过Scaling Law起跑线:千寻智能解浚源访谈
作者:技术拾光
时间:2026-08-12
浏览:467
文章目录
不久前,首届“人形机器人半程马拉松”在北京亦庄成功举办,为热度持续攀升的具身智能行业再添关注焦点。
这场汇聚20支参赛队伍的“钢铁生命竞赛”,将此前多局限于实验室演示的人形机器人推向真实复杂场景接受检验。最终,30%的完赛率(共6支队伍完赛)在收获掌声的同时,也引发了行业思考:具身智能的繁荣背后,是否存在发展泡沫?
针对这一问题,千寻智能具身智能部负责人解浚源分享了他对行业“规模定律”(Scaling Law)的观察。他指出,机器人领域目前仍处于规模定律的极早期阶段。尽管赛道关注度很高,但相比参数规模动辄千亿、万亿的大模型公司,无论是公司体量还是市场估值都仍处在较低水平。当前制约发展的关键,并非算力或资本投入,而是硬件迭代的客观周期——制造可靠的量产机器人、管理大规模数据采集工厂,这些属于制造业范畴,其发展速度自然比纯软件领域要慢。但他同时强调,依托中国强大的供应链体系,产业规模实现每年一个数量级的跃升是完全可期的。
就在上个月,解浚源正式宣布加入具身智能创业公司千寻智能,全面负责具身大模型的研发工作。这位在深度学习框架与系统领域深耕十余年的专家,曾任职亚马逊资深科学家,是知名开源框架MXNet的核心开发者之一,随后又加入字节跳动的应用机器学习部门。他的这次跨界选择,源于一个清晰的判断:机器人产业快速爆发的临界点即将到来,他不想错过这个历史性机遇。
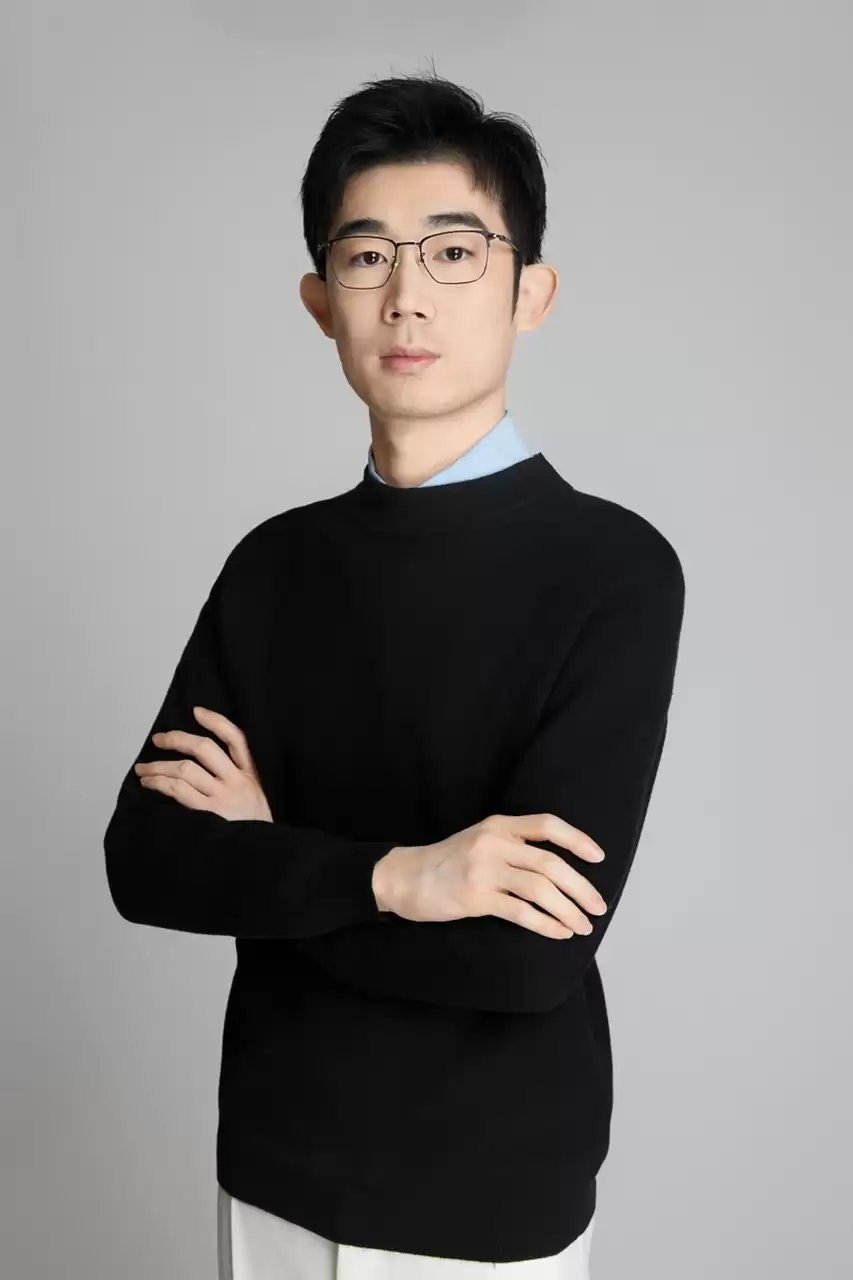
跨界入局:从AI系统到具身智能
从计算机视觉到深度学习框架,再到大模型与如今的具身智能,解浚源的职业生涯堪称一部“跨界演进史”。博士期间主攻CV算法的他,因对工程实践抱有浓厚兴趣,深度参与了MXNet框架的开发与架构工作,并因此在博士三年级选择休学,加入亚马逊AWS团队。此后,他在字节跳动涉猎了推荐系统、联邦学习、AI芯片乃至大模型ToB业务等多个领域。
谈及最终踏入需要与物理世界深度交互的机器人领域,解浚源提到了一个关键契机。今年初,在与同学交流时,他看到了Physical Intelligence公司展示的机器人操作柔性物体(如叠衣服、整理纸箱)的演示视频,这让他感到“眼前一亮”。
“过去的机器人动作往往比较僵硬,能处理的任务非常有限,主要针对杯子这类刚性物体,”他解释道,“而PI的演示展现了机器人处理可形变物体的能力,这代表着一个巨大的能力飞跃。”这一发现促使他深入研究背后的视觉-语言-动作(VLA)等关键技术。他发现,端到端的VLA技术路径已经日益明确,机器人正走上类似大模型从GPT-2到GPT-3/4的演进道路,目前虽处于规模定律的早期,但已展现出巨大潜力。“既然爆发的时刻即将来临,我不想错过。”他说道。
在决定加入该赛道后,解浚源考察了多家公司,最终选择千寻智能,源于团队能力的互补与理念的契合。目前,他带领具身智能部,负责机器学习相关的算法、系统与平台建设。团队中,联合创始人韩峰涛拥有丰富的机器人行业创业经验,首席科学家高阳则在算法研究方向把握大局,而解浚源自身的大厂工程化经验则侧重于技术的落地与实践。
面对多次跨界,如何快速适应新领域?解浚源认为,底层框架与系统的经验是相通的。“不管是CV、搜索推荐广告,还是大模型、机器人,都要用到AI系统和框架,这让我切换业务时比较顺畅。”加入千寻智能后,他迅速梳理并重建了算法工程的基础设施,将擅长的并行计算、算子优化等经验直接应用于新场景。
在具体业务问题上,他依靠对数据的直觉和理解来寻找解决方案。他举了一个实例:在让机械臂夹取电池的项目中,初期夹爪总是因伸入过浅而磕碰失败。通过分析,他发现数据采集时由于操作员过于熟练,常从极限位置直接夹取。于是,他要求采集数据时“把动作弧线拉大”,让机械臂从稍远处开始动作,留出足够的对准空间。模型学习后,问题便迎刃而解。当然,对于机器人动力学等专业领域知识,他也在持续学习和夯实。
技术路径:收敛于VLA与数据挑战
当前,业内对具身大模型的技术路径存在多种讨论。但在解浚源看来,主流方向其实已经收敛。“大方向上比较确定为VLA路线,接下来就是进入规模扩展(Scaling)的阶段。”他类比道,这类似于自动驾驶从过去基于规则的硬编码系统,转向端到端模仿学习后带来的性能飞跃。大模型的发展也已证明,摒弃过多人为规则、采用端到端训练后,模型自主学习的能力往往能超越精心设计的方法。
“具身智能也是如此,”他总结道,“一旦端到端的VLA路线显示出明确优势,技术路线就会收敛。因为走通之后,就没有理由再回头。”
那么,当前最大的挑战是什么?答案是数据。
“数据采集是这轮机器人技术发展最核心的难点。”解浚源指出,这远比传统的AI数据标注复杂,因为它深度涉及物理世界。你需要机器人本体、需要数据采集员,更需要管理好整个供应链体系,以实现高效且多样化的数据采集。
“数据的多样化至关重要。”他进一步解释,如果只是机械地重复标准动作,采集再多数据也意义有限,反而可能导致数据效率下降。真正的难点在于,如何在规模扩张的同时,系统化、可量化地实现动作的多样性,这需要极其精细的流程设计与管理。
如此高度工程化的数据采集,何时能见到显著成果?解浚源的判断是,机器人数据规模每提升一个数量级,其性能都会有肉眼可见的进步——无论是操作简单物体的流畅度,还是能执行任务的数量和复杂度。他预计,未来一至三年,我们将看到机器人从固定工位操作,走向更开放的空间执行复合任务,并能将复杂指令自动拆解为可执行的步骤序列。
“现在最关键的是,如何在硬件客观周期的制约下,尽可能快地把数据规模做起来。速度不能太慢,慢了就会在竞争中落后。”他强调。
谈及千寻智能近期展示的VLA Spirit v1模型在叠衣服任务上的表现,解浚源指出了背后的工程细节:他们对任务成功率要求极高,才能实现“一镜到底”连续叠好三件衣服;其中快速“甩平”衣服的动作,需要精确控制高速运动下的惯性,颇具挑战性。这些细节的攻克,体现的是整套工业化数据采集与迭代管道(pipeline)的成熟能力。
“VLA路线本身很强,开源视觉基础模型也很强大,所以让机器人做出些漂亮动作不算特别难。”他坦言,“更难的是实现工业化迭代,解决成千上万个细节问题,把模型成功率从50%提升到99%。这才是工程化落地的核心能力。”
关于落地场景,解浚源给出了短、中、长期的三阶段展望:短期(一两年内)将聚焦于工厂场景的工程化落地;中期(三至五年)更大的市场机会在于服务业,如物流仓储、商超理货、酒店服务等;长期(十年愿景)则是让机器人进入家庭,成为真正的个人助手。
规模定律:真机数据与独特壁垒
在技术路线上,解浚源旗帜鲜明地属于“真机派”,对仿真(Simulation)技术持谨慎态度。千寻智能也仅将仿真作为极小范围的辅助工具。这主要基于三点考量:
首先,柔性物体的物理仿真是巨大难题。高精度模拟一件衣服的形变,其计算成本和工程复杂度可能远超用真机采集数据。而仅能模拟刚体的仿真器,又无法覆盖现实世界中大量的非刚性物体交互场景。
其次,仿真能带来的知识增益,上限不会超过投入其中的工程量。本质上是用开发人员的精力去替代数据采集员,这个“兑换比”很可能不划算。
最后,也是关键一点,在于成本结构的不同。在美国,显卡(GPU)相对便宜,但在中国,高端显卡的价格非常昂贵。一块H100显卡售价超过20万元,而一台量产机器人的成本远低于此。当机器人生产规模上量后,其成本优势会更加明显。用昂贵的显卡资源进行仿真,相当于放弃了中国在供应链、熟练工程师和规模化制造方面的独特优势。
有人质疑,真机数据采集难以像仿真那样快速大规模扩展,这是否违背了Scaling Law?解浚源对此并不认同。
他认为,真机量产与数据采集并非无法实现规模扩展,只是需要时间。凭借中国的供应链能力,生产一万台机器人并非难事,且其总成本可能低于一万块H100显卡。目前,头部AI公司建设万卡集群可能只需数月,但搭建起万台机器人的数据工厂则需要更长的周期。这源于硬件设计、制造、调试的客观规律,无法单纯依靠资金无限加速。
“但循序渐进是可行的,”他描绘了发展路线图,“今年几百台,明年上千台,后年或许就能突破一万台。”此外,机器人硬件成本主要是生产成本,不存在像高端显卡那样极高的利润率,因此在大规模推广时更具成本优势。
那么,机器人领域的Scaling Law,与大模型有何根本不同?解浚源指出了两个核心区别:数据壁垒与数据飞轮。
大模型领域缺乏真正的数据壁垒。其预训练数据多来自公开网络,大家获取的源头相似;而人工精标数据一旦被用于训练并发布模型,就很容易被竞争对手以“蒸馏”等方式低成本获取。这可能导致先发者反而处于劣势。
“机器人数据则完全不同,”他强调,“所有数据都是私有的、通过自家机器人针对性采集的。这些数据别人拿不走,竞争对手只能拿到最终的模型。而没有持续的数据输入,仅凭现有模型无法实现持续迭代。因此,数据对大模型可能是‘包袱’,对具身智能却是坚实的‘壁垒’。”
此外,大模型目前难以形成有效的“数据飞轮”——即利用海量用户交互数据来闭环优化模型。而机器人在具体场景落地后,可以在提供服务(同时产生盈利)的同时,持续收集新的场景数据,用于迭代和优化模型,从而形成越用越强的正向循环。这种“网络效应”和“数据飞轮”,正是互联网商业模式成功的关键,也是机器人相比大模型更具商业潜力的地方。
当然,高度的数据壁垒是否会阻碍整个行业发展?解浚源认为不会。开源数据集的规模太小,仅适用于学术研究。而工业落地所需的数据规模,并非需要全行业合力才能达到。“一家公司如果拥有一万台机器人,就足以构建起足够的数据壁垒,并独立承担相关的研发与采集成本。”他表示。
最后,他再次从Scaling Law的视角进行总结:具身智能与大模型的共同点是都遵循规模定律;区别在于,具身智能正处在定律非常早期的阶段,犹如旭日初升,而大模型在现有硬件算力条件下已接近当前发展阶段的末期,需要等待下一次硬件革命才能实现数量级的跨越。
“如果相信Scaling Law,”解浚源说,“就会相信具身智能性能进步的空间一定非常巨大。我们现在看到的成果,可能只是冰山刚刚露出水面的一角。”
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章