
本文使用原生JavaScript从零实现一个轻量级二遍扫描汇编器,深入讲解词法切分、符号表构建、语法树解析与机器码发射全过程,提供完整代码与运行验证。

当前位置:首页 > JavaScript 项目实战 > 正文
用JavaScript从零实现简易汇编器:词法分析与语法解析实战
作者:半夏
时间:2026-11-22
浏览:320
文章目录
编译器开发实战
阅读时长:约 15 分钟
运行环境:Node.js 14+ / 现代浏览器
依赖:零第三方库(Pure JavaScript)
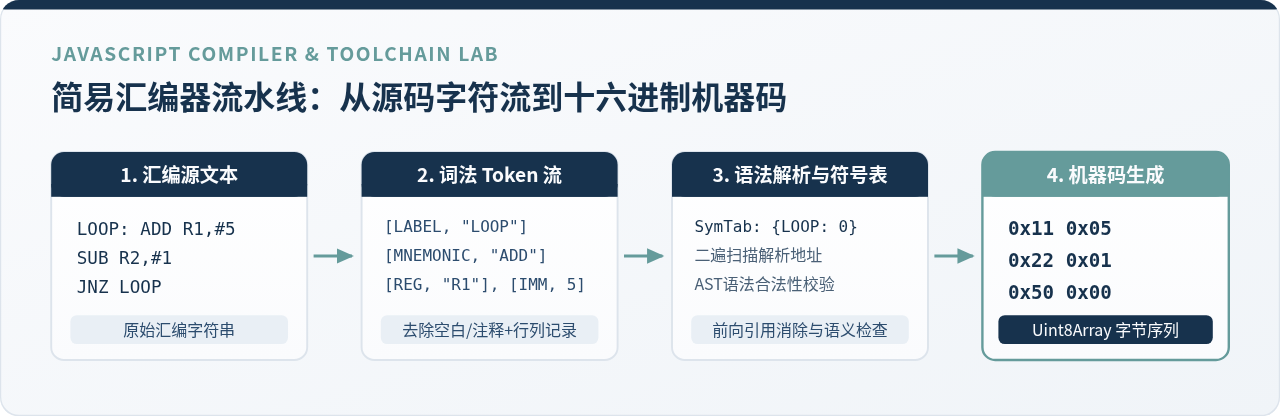
汇编器的本质是完成从人类可读的助记符号到目标硬件可识别机器指令的严格映射。本文将带领读者使用原生 JavaScript 从零构建一个完整的双遍扫描(Two-Pass)汇编器,重点攻破词法分析(Lexer)、符号表构建与语法解析(Parser/AST)核心模块,并在最后生成真实的十六进制机器字节码。
一、设计极简虚拟指令集架构(ISA)
在动手编写解析代码之前,必须先对汇编器所面向的目标机器架构做出精确定义。编译器或汇编器的每个分析阶段,都严格受制于硬件的操作码编码和寻址模式。为了保持实战代码清晰聚焦且不失代表性,本文设计一套紧凑的 8 位虚拟 CPU 指令集架构。
1. 寄存器与指令编码规则
我们规划 4 个通用 8 位寄存器,编号为 R0 到 R3。所有机器指令均统一采用定长 2 字节(16 位)格式,以便精确预估指令尺寸和计算物理地址:
- 字节 0(高字节):操作码(Opcode),占 8 位,唯一标识指令类型及操作数类别。
- 字节 1(低字节):操作数编码(Operand Byte),可存储目标/源寄存器索引组合,或直接存储 8 位立即数与标号跳转绝对地址。
| 助记符 | 指令格式 | 操作码 (Hex) | 功能说明 |
|---|---|---|---|
MOV |
MOV Rd, #imm |
0x10 |
将 8 位立即数加载至目标寄存器 Rd |
MOV |
MOV Rd, Rs |
0x11 |
将源寄存器 Rs 的数值复制至目标寄存器 Rd |
ADD |
ADD Rd, #imm |
0x20 |
将目标寄存器 Rd 与立即数相加,结果存入 Rd |
ADD |
ADD Rd, Rs |
0x21 |
将 Rd 与 Rs 相加,结果存入 Rd |
SUB |
SUB Rd, #imm |
0x30 |
将 Rd 减去立即数,结果存入 Rd |
JMP |
JMP label |
0x40 |
无条件跳转到指定的标号物理内存地址 |
JNZ |
JNZ label |
0x50 |
条件跳转:若上一条运算结果非零,跳转至指定标号 |
HLT |
HLT |
0xFF |
停机指令,无操作数 |
为什么选择 2 字节定长指令?
在 x86 等复杂变长指令集中,单条指令长度从 1 字节到 15 字节不等,物理地址计算需要依赖繁琐的长度查找表;而在定长设计中,程序计数器(PC)每遇到一条有效指令便固定累加 2。这让开发者能够将全部精力聚焦在词法与语法分析的核心骨架上。
二、汇编器双遍扫描(Two-Pass)架构模型
编写汇编器时最常遇到的核心问题是前向引用(Forward Reference)。考虑下面这段代码:
; 示例:前向跳转
      JNZ EXIT    ; 在此时,汇编器并不知道 EXIT 标号位于内存的哪个字节!
      ADD R0, #1
EXIT: HLT
当解析器扫描到 JNZ EXIT 时,EXIT 标号尚未被声明。如果采用单遍扫描,汇编器就必须保留未决符号表,并在后续遭遇标号时进行极其复杂的回溯打补丁(Backpatching)。
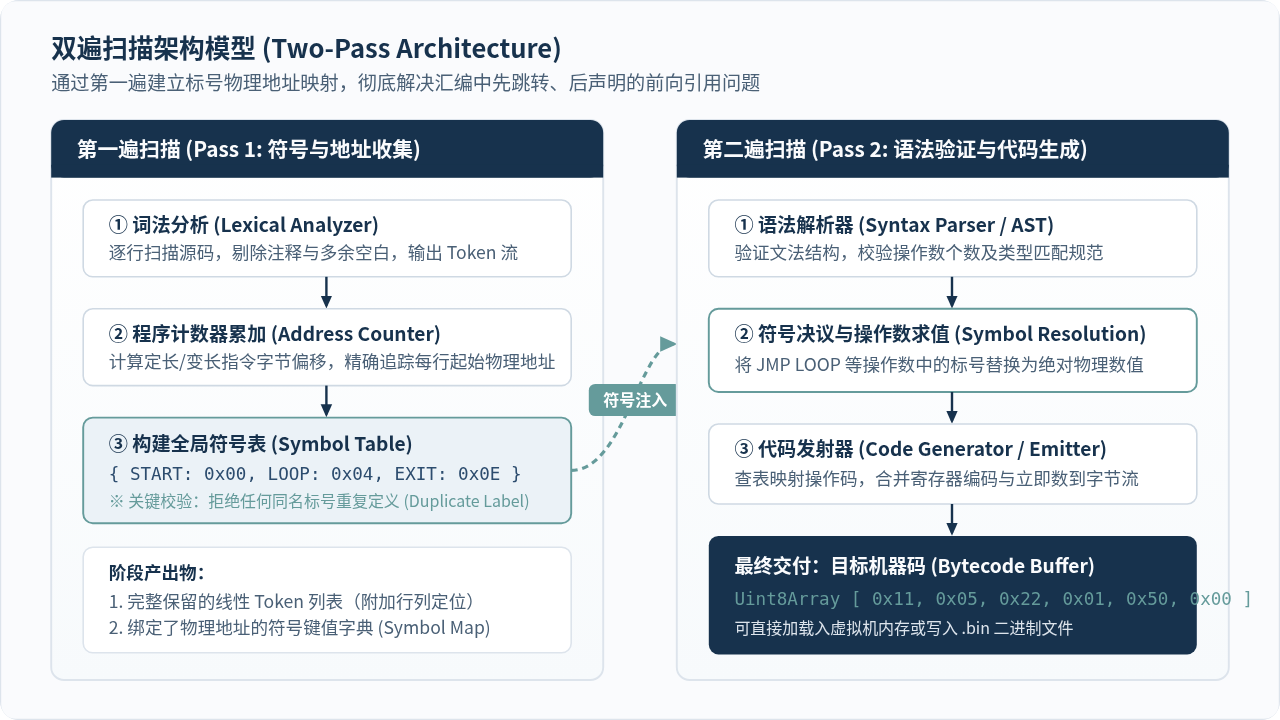
更清晰、稳健的工业通用做法是双遍扫描(Two-Pass Pipeline):
- 第一遍扫描(Pass 1: 符号与地址解析):词法分析器拆解全部源码,地址计数器(PC)按每条指令 2 字节进行推算。当遇到标号定义(如
EXIT:)时,将其与当前的 PC 绝对地址存入全局符号表(Symbol Table)。此阶段仅记录符号,不发射机器码。 - 第二遍扫描(Pass 2: 语法树构建与机器码生成):重新遍历 Token 流,结合第一遍已完备的符号表,对每条指令执行自顶向下的语法验证、类型断言与参数匹配,将所有标号操作数代换为实际物理地址,并组装成字节输出。
三、词法分析器(Lexer)实现:从字符流到强类型 Token
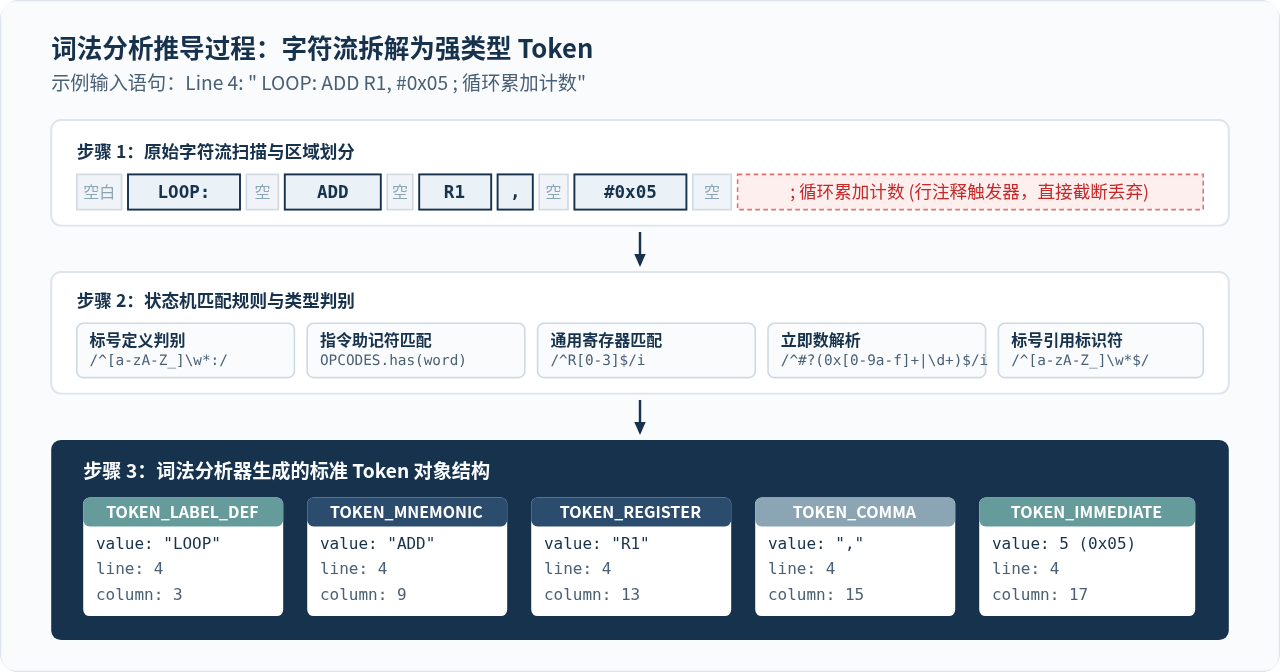
词法分析器(又称 Tokenizer)是编译前端的第一道关卡。它的职责是按顺序读取原始汇编源字符串,剥除对机器执行无意义的空白符和以分号(;)开头的行注释,将剩余字符序列切分为带有行列元信息的 Token。
1. Token 类型枚举与数据结构
每个 Token 对象必须包含四个关键属性:type(Token 类型)、value(解析后的值)、line(所在源码行号)、column(起始列号)。行号与列号在后续语法报错时至关重要。
// Token 类型定义
const TokenType = {
  LABEL_DEF: 'LABEL_DEF',   // 标号定义,例如 "LOOP:"
  MNEMONIC:  'MNEMONIC',    // 助记符,例如 "MOV", "ADD", "JMP"
  REGISTER:  'REGISTER',    // 通用寄存器,例如 "R0", "R1"
  IMMEDIATE: 'IMMEDIATE',   // 立即数,例如 "#5", "0x0A", "10"
  IDENTIFIER: 'IDENTIFIER', // 标号引用,例如 "LOOP"
  COMMA:     'COMMA',       // 逗号分隔符 ","
  NEWLINE:   'NEWLINE',     // 换行符(汇编以行为语句界限)
  EOF:       'EOF'          // 输入流终止符
};
2. 完整词法分析器代码实现
以下提供完整的 Lexer 类。其内部采用游标指针逐字符扫描,利用精确的状态判断和正则表达式识别操作码、寄存器与数值:
class LexerError extends Error {
  constructor(message, line, column) {
    super(`[词法错误] 行 ${line}, 列 ${column}: ${message}`);
    this.name = 'LexerError';
    this.line = line;
    this.column = column;
  }
}

class Lexer {
  constructor(sourceCode) {
    this.src = sourceCode;
    this.cursor = 0;
    this.line = 1;
    this.column = 1;
    this.opcodes = new Set(['MOV', 'ADD', 'SUB', 'JMP', 'JNZ', 'HLT']);
  }

  // 窥视当前字符
  peek() {
    return this.cursor < this.src.length ? this.src[this.cursor] : null;
  }

  // 步进一个字符并更新光标行列
  advance() {
    const char = this.peek();
    this.cursor++;
    if (char === '
') {
      this.line++;
      this.column = 1;
    } else {
      this.column++;
    }
    return char;
  }

  // 词法切分主循环
  tokenize() {
    const tokens = [];

    while (this.cursor < this.src.length) {
      const char = this.peek();

      // 1. 跳过行内空白(制表符与空格)
      if (char === ' ' || char === '	' || char === '
') {
        this.advance();
        continue;
      }

      // 2. 换行符:保留为独立 Token 作为语句边界
      if (char === '
') {
        tokens.push({ type: TokenType.NEWLINE, value: '
', line: this.line, column: this.column });
        this.advance();
        continue;
      }

      // 3. 注释处理:遇到分号则跳过整行剩余字符
      if (char === ';') {
        while (this.peek() !== null && this.peek() !== '
') {
          this.advance();
        }
        continue;
      }

      // 4. 逗号分隔符
      if (char === ',') {
        tokens.push({ type: TokenType.COMMA, value: ',', line: this.line, column: this.column });
        this.advance();
        continue;
      }

      // 5. 立即数处理:匹配以 # 开头或纯数字/十六进制开头的数值
      if (char === '#' || /[0-9]/.test(char) || (char === '-' && /[0-9]/.test(this.src[this.cursor + 1]))) {
        tokens.push(this.readImmediate());
        continue;
      }

      // 6. 标识符、助记符、寄存器或标号定义
      if (/[a-zA-Z_]/.test(char)) {
        tokens.push(this.readWord());
        continue;
      }

      throw new LexerError(`无法识别的非法字符 '${char}'`, this.line, this.column);
    }

    tokens.push({ type: TokenType.EOF, value: null, line: this.line, column: this.column });
    return tokens;
  }

  readImmediate() {
    const startCol = this.column;
    const startLine = this.line;
    let raw = '';

    if (this.peek() === '#') {
      this.advance(); // 吞下立即数指示符 '#'
    }

    while (this.peek() !== null && /[0-9a-fA-FxX-]/.test(this.peek())) {
      raw += this.advance();
    }

    const parsedNum = Number(raw);
    if (Number.isNaN(parsedNum)) {
      throw new LexerError(`无效的立即数格式 "${raw}"`, startLine, startCol);
    }

    // 检查 8 位无符号/有符号数范围 (-128 ~ 255)
    if (parsedNum < -128 || parsedNum > 255) {
      throw new LexerError(`立即数 ${parsedNum} 超出 8 位单字节有效范围 (-128~255)`, startLine, startCol);
    }

    // 统一转换为 0~255 的无符号单字节
    const byteVal = (parsedNum < 0) ? (parsedNum + 256) : parsedNum;
    return { type: TokenType.IMMEDIATE, value: byteVal, line: startLine, column: startCol };
  }

  readWord() {
    const startCol = this.column;
    const startLine = this.line;
    let word = '';

    while (this.peek() !== null && /[a-zA-Z0-9_]/.test(this.peek())) {
      word += this.advance();
    }

    // 判断是否紧随冒号,若有则为标号定义
    if (this.peek() === ':') {
      this.advance(); // 消耗冒号
      return { type: TokenType.LABEL_DEF, value: word.toUpperCase(), line: startLine, column: startCol };
    }

    const upper = word.toUpperCase();

    // 判断寄存器:R0, R1, R2, R3
    if (/^R[0-3]$/.test(upper)) {
      const regIndex = parseInt(upper[1], 10);
      return { type: TokenType.REGISTER, value: upper, regIndex, line: startLine, column: startCol };
    }

    // 判断是否为支持的操作码助记符
    if (this.opcodes.has(upper)) {
      return { type: TokenType.MNEMONIC, value: upper, line: startLine, column: startCol };
    }

    // 既非助记符也非寄存器,判定为引用标号的标识符
    return { type: TokenType.IDENTIFIER, value: upper, line: startLine, column: startCol };
  }
}
四、符号表管理与语法解析器(Parser)实战
在词法分析器将源文本转化为规整的 Token 序列后,汇编器进入语法解析阶段。语法解析器(Parser)需要对语句文法进行严格校验,并在两遍扫描中分别完成“符号地址收集”与“抽象语法树(AST)构建”。
1. 汇编语言的文法规则(BNF 表达)
汇编语言的行结构高度规律,一条典型的汇编代码行可以形式化描述为:
<Line> ::= [<LabelDef>] [<Instruction>] <NEWLINE>
<Instruction> ::= <MNEMONIC> [<Operand> [',' <Operand>]]
<Operand> ::= <REGISTER> | <IMMEDIATE> | <IDENTIFIER>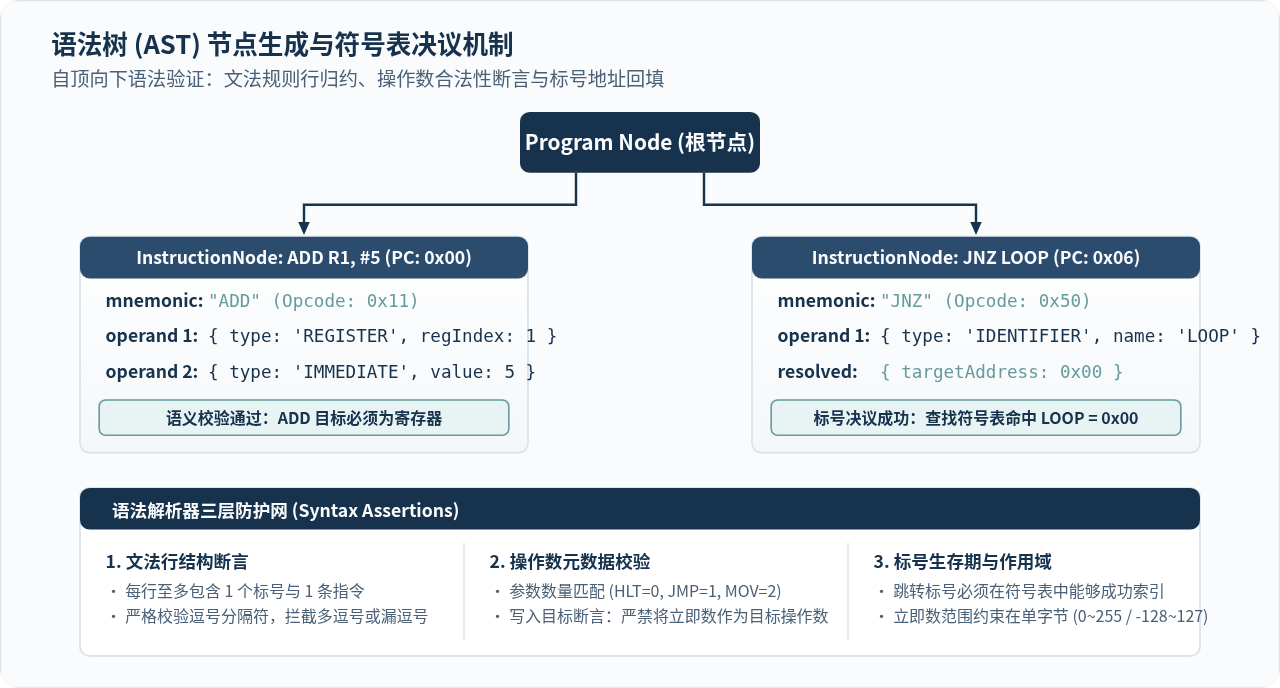
2. 第一遍扫描:符号表抽取与地址累计
在第一遍扫描中,我们维护一个 addressCounter(初始为 0)。遇到 LABEL_DEF 时,记录当前地址;遇到指令时,将地址累加 2。
class ParserError extends Error {
  constructor(message, line, column) {
    super(`[语法错误] 行 ${line}, 列 ${column}: ${message}`);
    this.name = 'ParserError';
    this.line = line;
    this.column = column;
  }
}

// 第一遍扫描:提取标号并检查冲突
function extractSymbols(tokens) {
  const symbolTable = new Map();
  let addressCounter = 0;
  let i = 0;

  while (i < tokens.length) {
    const token = tokens[i];

    // 遇到标号定义
    if (token.type === TokenType.LABEL_DEF) {
      const label = token.value;
      if (symbolTable.has(label)) {
        const prev = symbolTable.get(label);
        throw new ParserError(`标号 "${label}" 重复定义(首次声明于 0x${prev.toString(16).padStart(2, '0')})`, token.line, token.column);
      }
      symbolTable.set(label, addressCounter);
      i++;
      continue;
    }}

    // 遇到指令:累加 2 字节地址
    if (token.type === TokenType.MNEMONIC) {
      addressCounter += 2;
      // 快速跳跃过当前指令的操作数,直到换行或 EOF
      while (i < tokens.length && tokens[i].type !== TokenType.NEWLINE && tokens[i].type !== TokenType.EOF) {
        i++;
      }
      continue;
    }

    // 忽略普通换行与文件终止
    i++;
  }

  return symbolTable;
}
3. 第二遍扫描:完整语法树生成与符号替换
在第二遍扫描中,我们构建真实的 Parser 类。它将 Token 流转化为包含操作码和精确操作数的指令对象(AST),并对语法规则施加严格拦截:
class Parser {
  constructor(tokens, symbolTable) {
    this.tokens = tokens;
    this.symbols = symbolTable;
    this.pos = 0;
    this.currentAddress = 0;
  }

  peek() {
    return this.tokens[this.pos];
  }

  advance() {
    return this.tokens[this.pos++];
  }

  // 解析全部指令并返回 AST
  parseProgram() {
    const instructions = [];

    while (this.peek().type !== TokenType.EOF) {
      // 跳过空行
      if (this.peek().type === TokenType.NEWLINE) {
        this.advance();
        continue;
      }

      // 如果当前行包含标号定义,第二遍直接跳过(地址在第一遍已计算)
      if (this.peek().type === TokenType.LABEL_DEF) {
        this.advance();
        continue;
      }

      // 解析单条指令
      if (this.peek().type === TokenType.MNEMONIC) {
        const instNode = this.parseInstruction();
        instructions.push(instNode);
        this.currentAddress += 2;
        continue;
      }

      const unexpected = this.peek();
      throw new ParserError(`非预期的语句起始 Token "${unexpected.value}"`, unexpected.line, unexpected.column);
    }

    return instructions;
  }

  parseInstruction() {
    const mnemonicToken = this.advance();
    const mnemonic = mnemonicToken.value;
    const operands = [];

    // 收集指令之后、换行符之前的所有操作数 Token
    while (this.peek().type !== TokenType.NEWLINE && this.peek().type !== TokenType.EOF) {
      const t = this.peek();
      if (t.type === TokenType.REGISTER || t.type === TokenType.IMMEDIATE || t.type === TokenType.IDENTIFIER) {
        operands.push(this.advance());

        // 如果后面跟着逗号,消耗逗号并断言下一个 Token
        if (this.peek().type === TokenType.COMMA) {
          this.advance();
          if (this.peek().type === TokenType.NEWLINE || this.peek().type === TokenType.EOF) {
            throw new ParserError(`逗号后缺少操作数`, t.line, t.column + 1);
          }
        }
      } else {
        throw new ParserError(`非法操作数语法元素 "${t.value}"`, t.line, t.column);
      }
    }

    // 语法语义约束检查
    return this.validateAndBuildNode(mnemonicToken, operands);
  }

  validateAndBuildNode(mnemonicToken, operands) {
    const mnemonic = mnemonicToken.value;
    const line = mnemonicToken.line;
    const col = mnemonicToken.column;

    switch (mnemonic) {
      case 'HLT': {
        if (operands.length !== 0) {
          throw new ParserError(`指令 HLT 不接受任何操作数,实际接收到 ${operands.length} 个`, line, col);
        }
        return { type: 'INSTRUCTION', mnemonic, opcode: 0xFF, operandByte: 0x00, address: this.currentAddress };
      }

      case 'JMP':
      case 'JNZ': {
        if (operands.length !== 1) {
          throw new ParserError(`跳转指令 ${mnemonic} 要求恰好 1 个操作数,实际接收到 ${operands.length} 个`, line, col);
        }
        const targetToken = operands[0];
        let targetAddr = 0;

        if (targetToken.type === TokenType.IDENTIFIER) {
          const label = targetToken.value;
          if (!this.symbols.has(label)) {
            throw new ParserError(`未声明的跳转标号 "${label}"`, targetToken.line, targetToken.column);
          }
          targetAddr = this.symbols.get(label);
        } else if (targetToken.type === TokenType.IMMEDIATE) {
          targetAddr = targetToken.value;
        } else {
          throw new ParserError(`跳转指令的目标必须是标号或立即数地址`, targetToken.line, targetToken.column);
        }

        const opcode = (mnemonic === 'JMP') ? 0x40 : 0x50;
        return { type: 'INSTRUCTION', mnemonic, opcode, operandByte: targetAddr, address: this.currentAddress };
      }

      case 'MOV':
      case 'ADD':
      case 'SUB': {
        if (operands.length !== 2) {
          throw new ParserError(`运算指令 ${mnemonic} 要求 2 个操作数(目标寄存器, 源操作数)`, line, col);
        }
        const [dest, src] = operands;

        // 目标操作数必须是通用寄存器
        if (dest.type !== TokenType.REGISTER) {
          throw new ParserError(`指令 ${mnemonic} 的目标操作数必须为通用寄存器 (R0-R3)`, dest.line, dest.column);
        }

        let opcode = 0;
        let operandByte = 0;

        if (src.type === TokenType.IMMEDIATE) {
          // 模式:Rd, #imm
          if (mnemonic === 'MOV') opcode = 0x10;
          if (mnemonic === 'ADD') opcode = 0x20;
          if (mnemonic === 'SUB') opcode = 0x30;
          // 寄存器索引编码在 Opcode 低 2 位
          opcode |= (dest.regIndex & 0x03);
          operandByte = src.value & 0xFF;
        } else if (src.type === TokenType.REGISTER) {
          // 模式:Rd, Rs
          if (mnemonic === 'MOV') opcode = 0x14;
          if (mnemonic === 'ADD') opcode = 0x24;
          if (mnemonic === 'SUB') opcode = 0x34;
          // 低字节中:高 4 位放 Rd,低 4 位放 Rs
          operandByte = ((dest.regIndex & 0x0F) << 4) | (src.regIndex & 0x0F);
        } else {
          throw new ParserError(`指令 ${mnemonic} 的源操作数仅支持寄存器或立即数`, src.line, src.column);
        }

        return { type: 'INSTRUCTION', mnemonic, opcode, operandByte, address: this.currentAddress };
      }

      default:
        throw new ParserError(`不支持的操作码助记符 "${mnemonic}"`, line, col);
    }
  }
}
五、机器码发射器与完整组装运行实战
当语法解析器输出校验合规的 AST 数组后,代码生成(Code Generation)变得水到渠成。每条指令固定为 2 字节,我们只需分配一个 Uint8Array 内存缓冲区,将指令节点的 opcode 和 operandByte 顺序填入即可。
1. 汇编器总控入口函数
function assemble(sourceCode) {
  // 1. 词法分析
  const lexer = new Lexer(sourceCode);
  const tokens = lexer.tokenize();

  // 2. 第一遍扫描:收集符号表
  const symbolTable = extractSymbols(tokens);

  // 3. 第二遍扫描:语法解析与 AST 生成
  const parser = new Parser(tokens, symbolTable);
  const ast = parser.parseProgram();

  // 4. 机器码发射
  const byteCount = ast.length * 2;
  const binaryBuffer = new Uint8Array(byteCount);

  ast.forEach((node, idx) => {
    binaryBuffer[idx * 2] = node.opcode;
    binaryBuffer[idx * 2 + 1] = node.operandByte;
  });

  return {
    symbolTable: Object.fromEntries(symbolTable),
    ast,
    binary: binaryBuffer,
    hexString: Array.from(binaryBuffer).map(b => '0x' + b.toString(16).padStart(2, '0').toUpperCase()).join(' ')
  };
}
2. 编写测试程序并验证运行
我们编写一段用于在虚拟 CPU 上计算 1 + 2 + 3 累加和的汇编程序。该程序包含变量初始化、前向循环标号、条件跳转以及最终的停机指令:
// 测试用例:累加循环
const sampleAssembly = `
; ===================================
; 简易汇编测试:计算累加和
; ===================================
START:
  MOV R0, #0       ; R0 用于存储累加结果
  MOV R1, #3       ; R1 作为计数器初始值

LOOP:
  ADD R0, R1       ; R0 = R0 + R1
  SUB R1, #1       ; R1 = R1 - 1
  JNZ LOOP         ; 若 R1 != 0,回跳至 LOOP

EXIT:
  HLT              ; 停机
`;

// 执行汇编
try {
  const result = assemble(sampleAssembly);
  console.log("=== 符号表 (Symbol Table) ===");
  console.table(result.symbolTable);

  console.log("\n=== 机器码序列 (Bytecode) ===");
  console.log(result.hexString);
} catch (err) {
  console.error(err.message);
}
控制台示例输出(Execution Result)
=== 符号表 (Symbol Table) ===
{
  "START": 0,   // 0x00
  "LOOP":  4,   // 0x04
  "EXIT":  10   // 0x0A
}

=== 机器码序列 (Bytecode) ===
0x10 0x00 0x11 0x03 0x24 0x01 0x31 0x01 0x50 0x04 0xFF 0x00
[解析说明]
0x10 0x00 -> MOV R0, #0  (PC: 0x00)
0x11 0x03 -> MOV R1, #3  (PC: 0x02)
0x24 0x01 -> ADD R0, R1  (PC: 0x04, 标号 LOOP 物理入口)
0x31 0x01 -> SUB R1, #1  (PC: 0x06)
0x50 0x04 -> JNZ 0x04    (PC: 0x08, 前向引用 LOOP 成功替换为物理地址 0x04)
0xFF 0x00 -> HLT         (PC: 0x0A, 标号 EXIT 入口)
六、边界防御与常见解析异常处理
一个成熟的汇编器与玩具脚本的根本差别,在于对非法输入和边界场景的防御能力。在实际编写与调试中,以下四类错误最容易出现,必须在词法与语法阶段及时阻断:
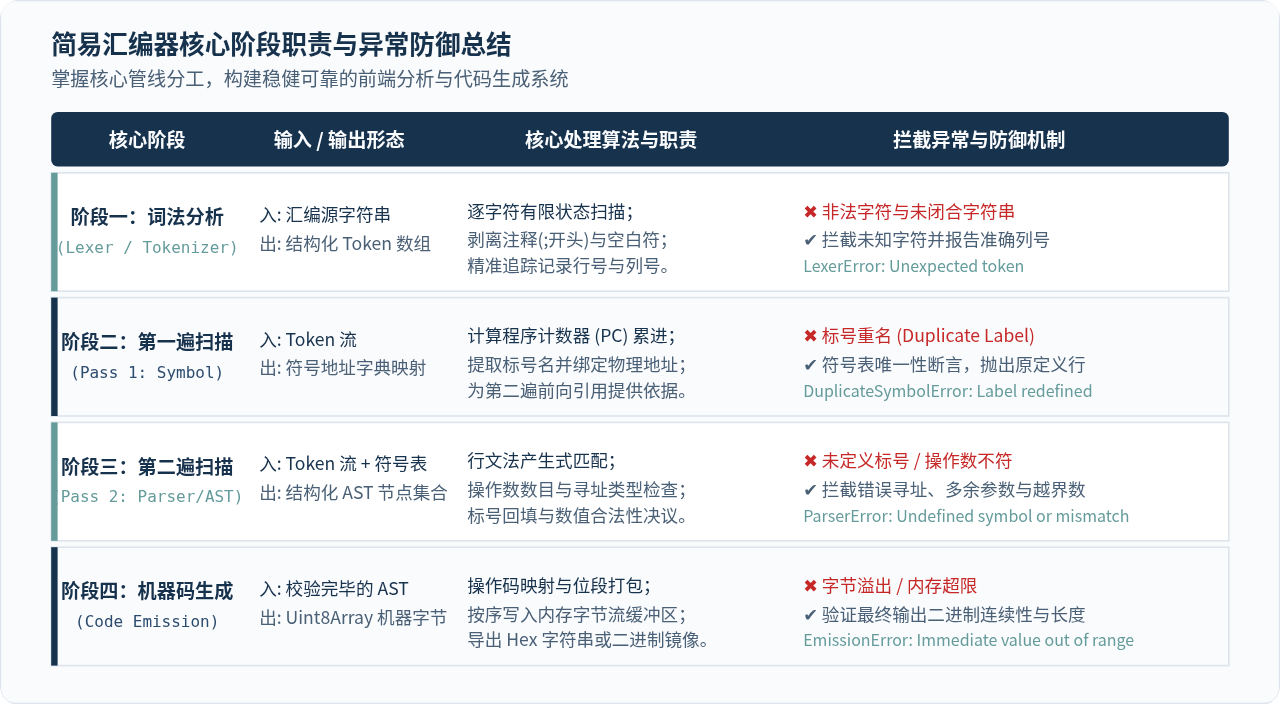
1. 标号未定义与前向引用悬空
当开发者拼写错误或遗漏标号声明时(如 JMP LOOP_END 但源码中只有 LOOP_DONE:),第一遍扫描构建的符号表中不会存在该键。在第二遍扫描的 validateAndBuildNode 中必须显式拦截并报出具体的源码行列位置:
[语法错误] 行 12, 列 7: 未声明的跳转标号 "LOOP_END"2. 操作数类型不匹配与只读目标保护
汇编中不可将立即数作为写入目标。例如 MOV #5, R0 或 ADD #10, #20 在语法层必须被拒。我们在语法解析层对 dest.type !== TokenType.REGISTER 进行了强类型断言,彻底杜绝了此类逻辑硬伤。
3. 标号重名冲突
如果不同子模块使用了相同的标号名称(例如两个函数内部都定义了 EXIT:),程序计数器将发生致命错乱。第一遍扫描时的 symbolTable.has(label) 校验机制能够精准捕捉重名,并提示初次声明的历史地址。
七、总结与架构扩展建议
至此,我们用原生 JavaScript 完整搭建了一个结构严谨、支持双遍扫描的微型汇编器。回顾整个实现过程,核心逻辑清晰划分为四个关键步骤:
- 确立 ISA 规格:定长指令让地址推导规整化,极大简化了解析器与代码发射器的映射逻辑;
- 词法分析(Lexer):利用状态扫描将杂乱字符流整理为带行列坐标的强类型 Token,完成白噪声过滤;
- 双遍扫描(Two-Pass):第一遍解算物理地址建立符号表,从根本上攻破前向引用的未知依赖问题;
- 语法验证与发射(Parser & Emitter):依据文法产生式完成 AST 结构化组装,并映射出最终的机器字节码。
在此基础之上,如果读者希望进一步完善汇编器功能,可以考虑引入伪指令支持(如 .ORG 0x100 重定位基址、.DB 0x01, 0x02 数据定义)、相对寻址偏移计算(PC-relative Offset)以及宏替换(Macro Expansion)机制,从而使编译器前端具备更强大的工程表达能力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章