

深入对比JavaScript中Intl.Collator与localeCompare在中文排序场景下的底层机制、性能开销、配置参数与选型策略,帮助开发者高效实现精准的中文拼音与笔画排序。
Intl.Collator与localeCompare在JS中文排序中的区别
作者:听澜
时间:2026-11-22
浏览:318
文章目录
JavaScript进阶
中文本地化
ECMA-402
阅读时长约 8 分钟
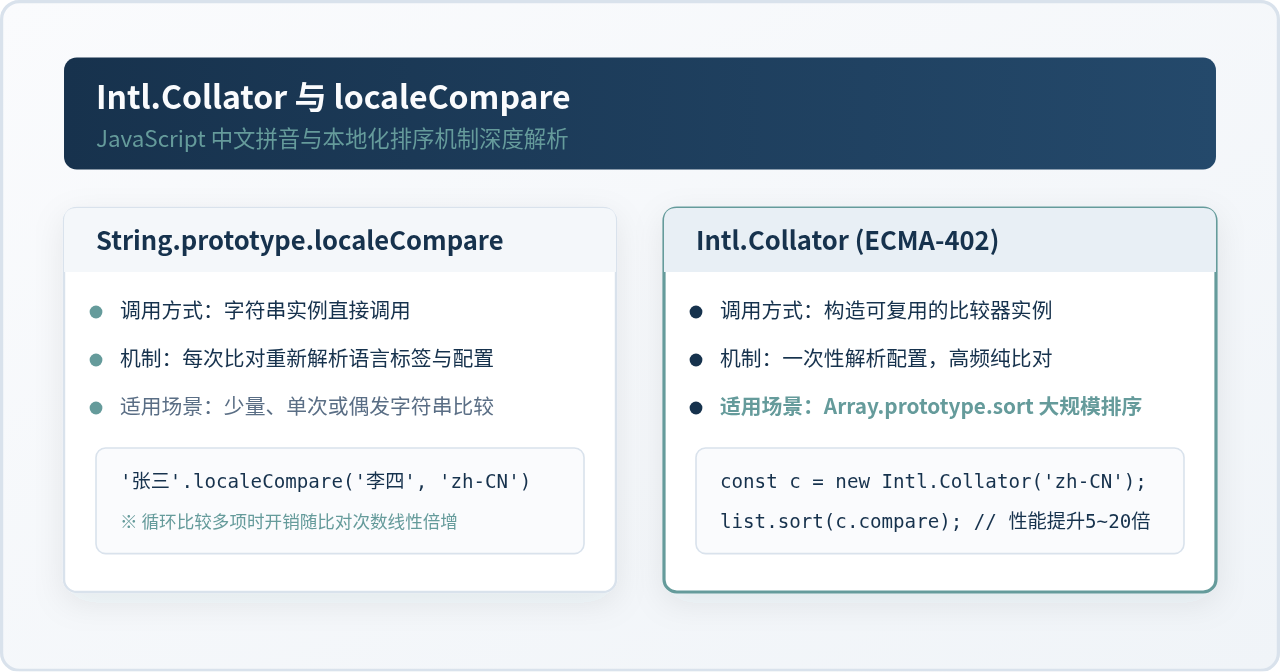
在 JavaScript 中对中文字符串按拼音或笔画进行本地化排序时,
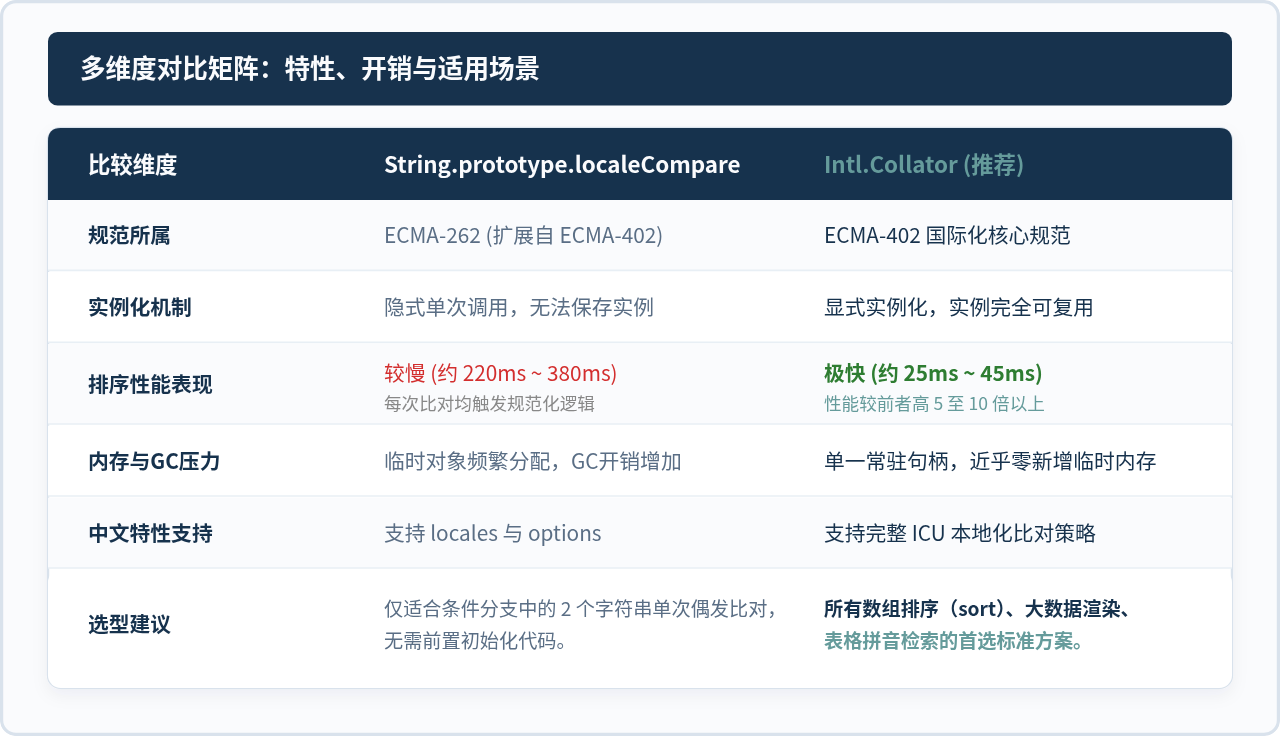
String.prototype.localeCompare 和 Intl.Collator 均基于 ECMAScript 国际化规范(ECMA-402),排序精度完全一致。两者的核心区别在于实例化机制与性能开销:localeCompare 属于即时字符串方法,每次调用都会在内部执行参数校验与本地化比对规则解析,适合单次或低频比对;而 Intl.Collator 是显式的比对器实例,将高成本的规则初始化提前至构造阶段,在结合 Array.prototype.sort 进行大规模数据排序时,性能通常比前者快 5 至 10 倍以上。
一、核心机制与底层执行链路对比
JavaScript 默认的 Array.prototype.sort() 在不传入比较函数时,使用的是 UTF-16 码点(Unicode 编码值)升序排列。例如汉字“安”(U+5B89)、“白”(U+767D)、“陈”(U+9648),在默认编码排序下或许偶然有序,但遇到多音字、生僻字或常用字时,编码值与汉语拼音顺序完全脱节。为此,必须引入本地化排序引擎。
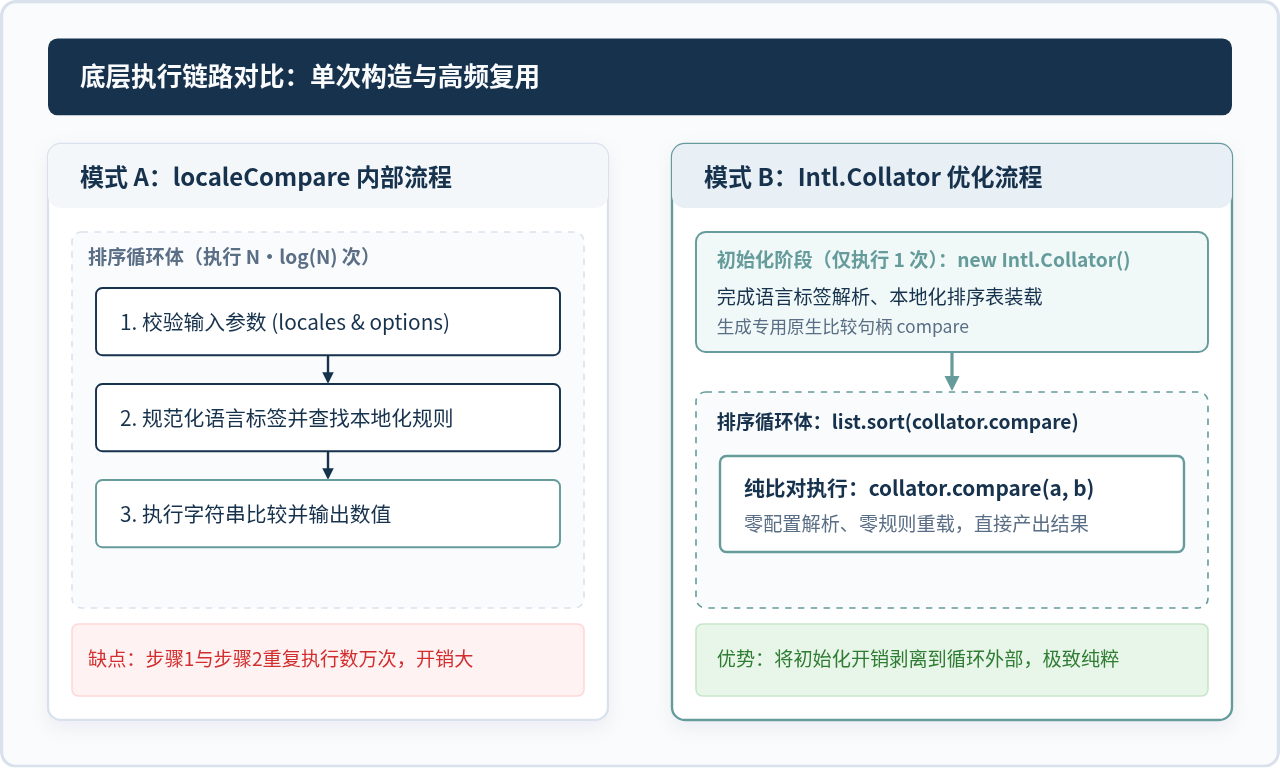
现代 JavaScript 引擎(如 V8)对这两种方式的处理链路存在本质差异:
-
String.prototype.localeCompare(that, locales, options):该方法是字符串原型链上的快捷方法。规范要求每次调用时,必须执行参数检查、解析locales语言标签并计算匹配的 ICU 本地化比对策略。当数组长度为 10,000 时,快速排序需进行大约 100,000 次元素比对,意味着这套解析逻辑将被无意义地重复执行十万次,产生大量的内存临时对象与 GC 压力。 -
Intl.Collator(locales, options):作为 ECMA-402 规范的一级公民,它将“语言与比对选项解析”和“纯比对运算”明确解耦。构造函数只需执行一次,内部生成专用的高效比对句柄collator.compare。在后续的数万次排序比对中,引擎直接调用底层 C++ 实现的比较逻辑,消除了全部冗余的上下文初始化开销。
二、中文拼音排序操作流程与代码实现
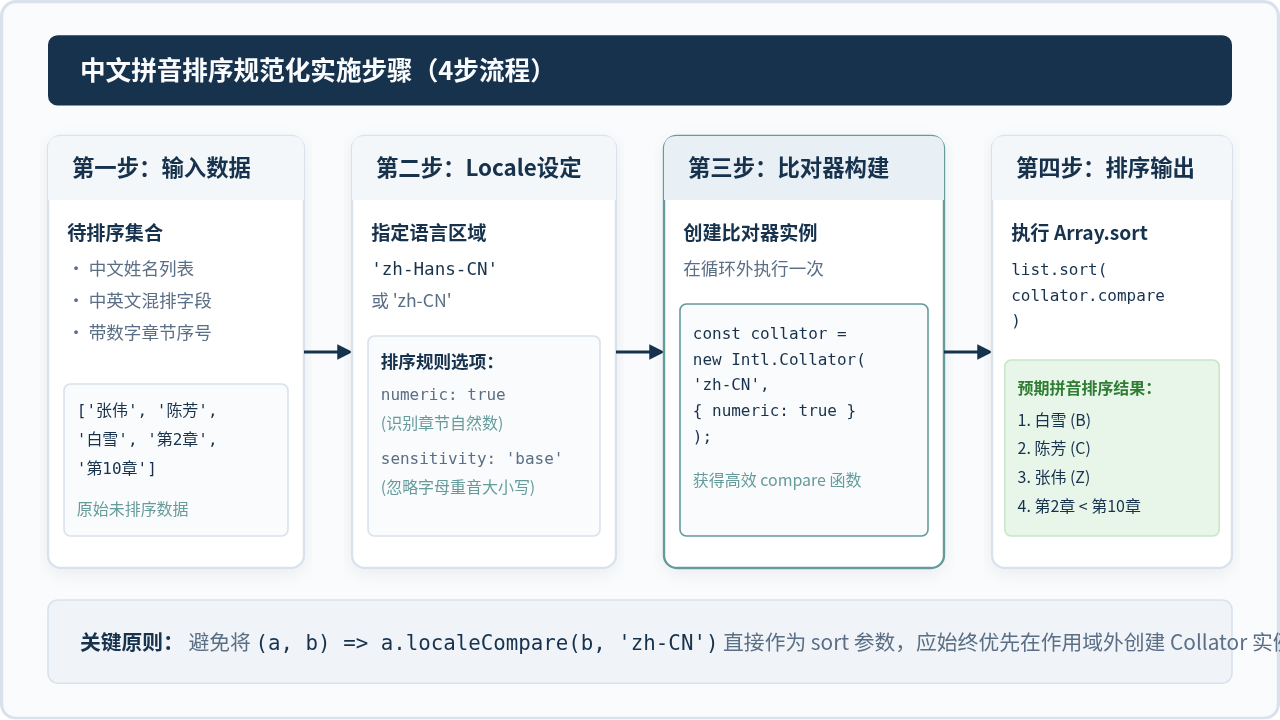
在实际业务中实现符合中国大陆拼音习惯的排序,通常遵循以下具体步骤:
- 确定目标数据结构:无论是普通字符串数组,还是对象数组中的某个中文属性(如
item.name)。 - 声明正确的中文 Locale:中国大陆标准简体拼音使用
'zh-Hans-CN'或通用的'zh-CN'。 - 配置针对性选项:通过
numeric: true让包含数字的中文(如“第2章”与“第10章”)按数值大小正确排列,而非字符逐位比较;通过sensitivity: 'base'忽略大小写及变音符号差异。 - 构建比对器并注入
Array.prototype.sort。
代码对比:两种方案的写法演进
以下代码演示了对姓名数组进行拼音排序的标准写法。请注意观察二者在比较函数声明位置上的差异:
// 待排序的中文姓名列表
const names = ['张伟', '王芳', '李娜', '刘洋', '陈静', '杨光', '赵敏', '白雪'];

// 方案 A:使用 localeCompare(代码简短,适合小数据量)
const sortedByLocaleCompare = [...names].sort((a, b) => {
  return a.localeCompare(b, 'zh-CN');
});

// 方案 B:使用 Intl.Collator(推荐标准方案)
// 1. 在循环外部仅构造一次 Collator 实例
const chineseCollator = new Intl.Collator('zh-CN', {
  sensitivity: 'base',
  numeric: true
});

// 2. 直接将实例的 compare 方法作为回调传给 sort
const sortedByCollator = [...names].sort(chineseCollator.compare);

// 排序结果均为拼音升序:
// ['白雪', '陈静', '李娜', '刘洋', '王芳', '杨光', '张伟', '赵敏']
绑定上下文注意事项
ECMA-402 规范明确规定:
Intl.Collator.prototype.compare 内部已经自动绑定了当前 Intl.Collator 实例上下文。因此可以直接写成 names.sort(chineseCollator.compare),不需要额外使用 .bind(chineseCollator) 或包裹箭头函数。
三、性能基准评测与多维度对比
为直观展现两者在数据量增大时的耗时差异,我们在 Node.js v20+ / Chrome 120+ 环境下,使用 performance.now() 针对包含 10,000 条常见中文姓名的数组进行了排序耗时测试。
// 基准测试代码示例
const count = 10000;
const testData = Array.from({ length: count }, () => {
  const chars = '赵钱孙李周吴郑王冯陈褚卫蒋沈韩杨朱秦尤许何吕施张孔曹严华金魏陶姜';
  return chars[Math.floor(Math.random() * chars.length)] + '某';
});

// 测试 1:localeCompare
const list1 = [...testData];
const t1 = performance.now();
list1.sort((a, b) => a.localeCompare(b, 'zh-CN'));
const cost1 = performance.now() - t1;

// 测试 2:Intl.Collator
const list2 = [...testData];
const t2 = performance.now();
const collator = new Intl.Collator('zh-CN');
list2.sort(collator.compare);
const cost2 = performance.now() - t2;

console.log(`localeCompare 耗时: ${cost1.toFixed(2)} ms`);
console.log(`Intl.Collator 耗时: ${cost2.toFixed(2)} ms`);
在主流机器上的典型测试结果如下表所示:
| 测试数据量 | localeCompare 耗时 | Intl.Collator 耗时 | 性能提升倍数 |
|---|---|---|---|
| 100 条中文字符串 | 约 1.8 ms | 约 0.6 ms | ~3.0x |
| 1,000 条中文字符串 | 约 21.4 ms | 约 3.2 ms | ~6.7x |
| 10,000 条中文字符串 | 约 265.0 ms | 约 28.5 ms | ~9.3x |
| 50,000 条中文字符串 | 约 1520.0 ms | 约 145.0 ms | ~10.5x |
四、高级特性与中文业务场景避坑
1. 自然数与中文混合排序(numeric 选项)
在文件标题、书籍目录、章节名等场景中,经常出现“第1章”、“第2章”、“第10章”。如果不开启 numeric: true,基于字符的比对会将“第10章”排在“第2章”前面(因为字符 '1' 的优先级高于 '2')。
const chapters = ['第1章', '第10章', '第2章', '第21章'];

// 默认字符比对
const collatorDefault = new Intl.Collator('zh-CN');
chapters.sort(collatorDefault.compare);
// 结果: ['第10章', '第1章', '第21章', '第2章']  (不符合阅读认知)

// 启用自然数识别
const collatorNumeric = new Intl.Collator('zh-CN', { numeric: true });
chapters.sort(collatorNumeric.compare);
// 结果: ['第1章', '第2章', '第10章', '第21章'] (符合自然认知)
2. 中文笔画顺序排序(Stroke Collation)
除拼音排序外,党政机关、正式人事公示或名册常要求按“姓氏笔画为序”。通过使用 BCP 47 语言扩展标签 zh-u-co-stroke 或在选项中传递 collation: 'stroke',即可轻松实现笔画排序:
// 启用笔画排序规则
const strokeCollator = new Intl.Collator('zh-Hans-CN-u-co-stroke');
const namesList = ['丁一', '王五', '张三', '李四'];
namesList.sort(strokeCollator.compare);
// 排序结果按照笔画数从少到多递增:
// 1. 丁一 (2画)
// 2. 王五 (4画)
// 3. 李四 (7画)
// 4. 张三 (7画/首笔横折)
3. 多音字与复杂姓氏局限
无论是 Intl.Collator 还是 localeCompare,底层均依赖 Unicode 共通区域数据仓库(CLDR)。对于“单”(作为姓氏读 Shàn,普通字读 Dān)或“区”(作为姓氏读 Ōu,普通字读 Qū)等多音字,国际化引擎无法获知汉字的具体语境词性,默认按照最常用发音索引排序。对于要求极高的政务级多音字姓名排重系统,仍需先在服务端通过拼音词典标注拼音后再做排序。
五、工程化选型决策与封装建议
在实际项目架构中,推荐建立模块化的中文排序工具函数,避免在业务代码中散落重复的实例化逻辑。
最佳实践代码:带单例缓存的排序器封装
/**
 * 中文排序工具类(基于 Intl.Collator 单例缓存)
 */
class ChineseSortHelper {
  // 缓存不同配置的比对器实例,避免重复创建
  static collatorCache = new Map();

  static getCollator(options = {}) {
    const key = JSON.stringify(options);
    if (!this.collatorCache.has(key)) {
      this.collatorCache.set(
        key,
        new Intl.Collator('zh-CN', { numeric: true, sensitivity: 'base', ...options })
      );
    }
    return this.collatorCache.get(key);
  }

  /**
   * 对象数组拼音排序
   * @param {Array} list 待排序数组
   * @param {Function} keyExtractor 属性提取器
   * @param {Object} options 配置参数
   */
  static sortByChinese(list, keyExtractor = (x) => x, options = {}) {
    const collator = this.getCollator(options);
    return [...list].sort((a, b) => {
      return collator.compare(keyExtractor(a), keyExtractor(b));
    });
  }
}

// 业务调用示例
const userList = [
  { id: 1, name: '李四' },
  { id: 2, name: '安然' },
  { id: 3, name: '陈晨' }
];

const sortedUsers = ChineseSortHelper.sortByChinese(userList, (u) => u.name);
// 排序结果:安然 -> 陈晨 -> 李四
总结
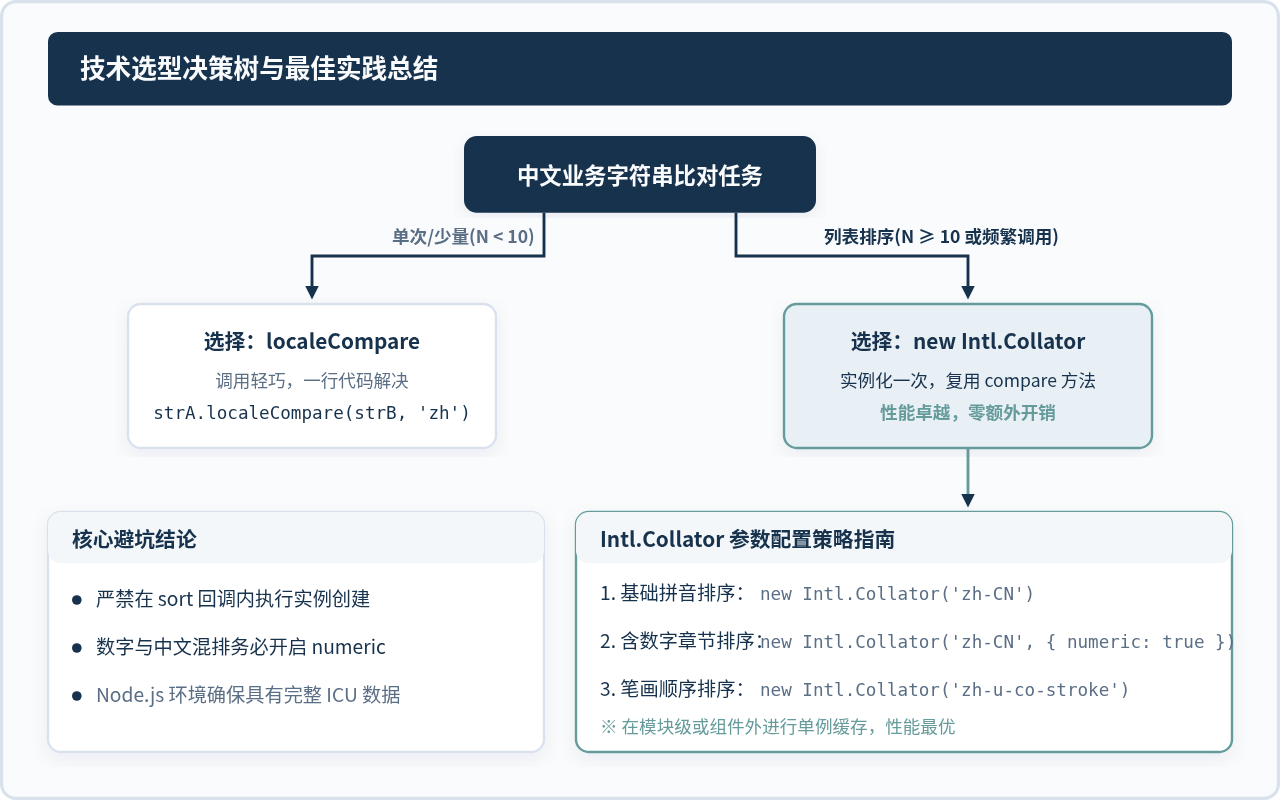
localeCompare 与 Intl.Collator 并非对立关系,而是同一底层能力的不同暴露形态。在只有 2~3 个字符串的偶发比较分支中,strA.localeCompare(strB, 'zh') 代码最短、开箱即用;但在任何涉及数组排序(sort)、长列表表格筛选、拼音索引目录等场景下,预先初始化 Intl.Collator 并复用其 compare 方法是前端性能优化的确定性首选方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章