
深入解析JavaScript中批量插入DOM的高性能方案,对比document.createDocumentFragment与Range.prototype.createContextualFragment的运作原理、使用场景、上下文解析差异及性能最佳实践。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS高性能批量插入HTML:DocumentFragment与createContextualFragment用法
作者:白露
时间:2026-11-21
浏览:91
文章目录
DOM性能优化
原生JavaScript
浏览器渲染原理
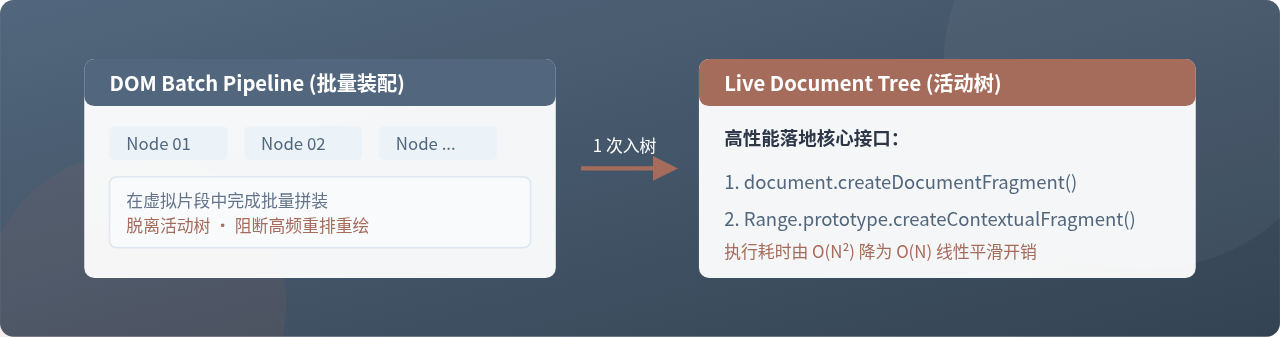
在前端开发中,面对数百甚至数千条数据的视图渲染时,如果直接在循环中调用
appendChild 或拼接 innerHTML,极易引发浏览器高频回流(Reflow)与重绘(Repaint),导致界面卡顿掉帧。解决批量插入性能瓶颈的核心方案有两个:一是基于节点构建的 DocumentFragment(文档片段),二是面向HTML字符串高效解析的 createContextualFragment。本文将深入这两种 API 的底层原理、运行机制、代码实现与选型边界。
从一次常见的渲染卡顿切入
很多开发者在刚开始处理动态列表渲染时,最直观的写法往往是循环操作 DOM。例如从服务端获取到 2000 条商品数据后,在 for 循环中通过 container.innerHTML += template 依次追加,或者在循环体内连续执行 container.appendChild(itemEl)。
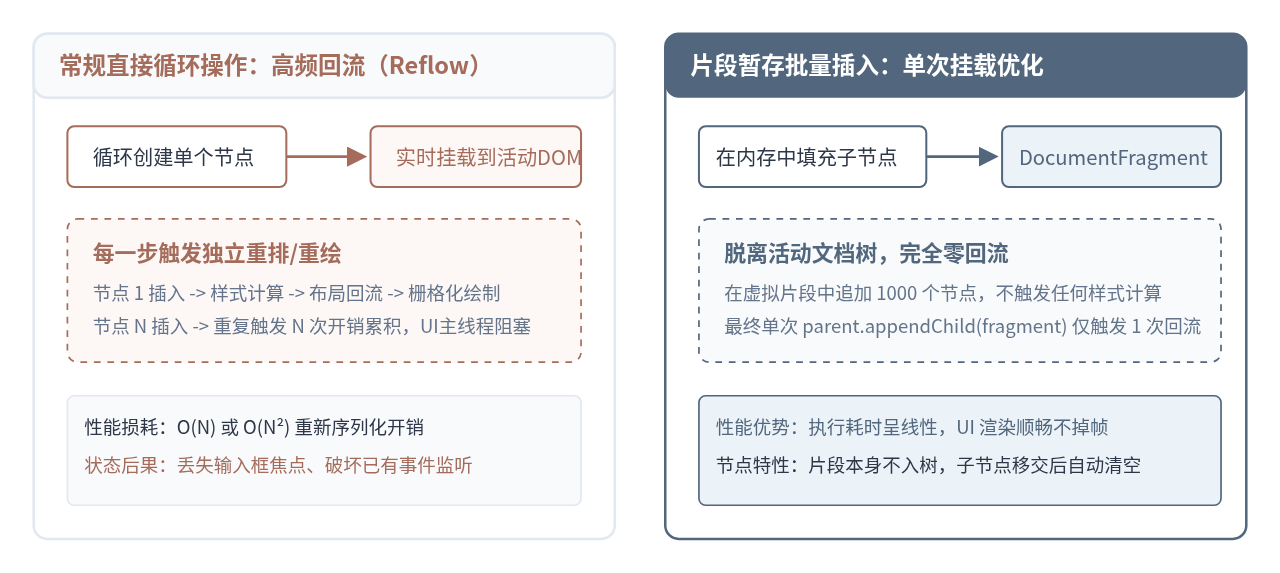
这两种写法看似简单,但对渲染引擎而言成本极其高昂。每一次执行 innerHTML += ...,浏览器都会把当前容器已有的所有子节点序列化为 HTML 字符串,和新字符串拼接后彻底销毁已有 DOM 树重新解析。这不仅造成严重的 CPU 损耗,还会导致已有元素绑定的事件监听和表单状态彻底丢失,时间复杂度直接退化为 O(n²)。
而在循环中连续调用 parent.appendChild(node) 虽然不会销毁旧节点,但每次向活动文档树插入新节点时,只要涉及几何属性或样式变动,浏览器就必须重新评估布局并触发回流与重绘。如果能够在内存中构建一个脱离真实文档树的“轻量暂存容器”,将所有子节点在内存中组装完毕后一次性挂载到真实 DOM 上,浏览器的回流次数就能从 n 次骤降为 1 次。
方案一:原生 DocumentFragment 的核心用法
DocumentFragment 是由 W3C DOM 规范定义的一种轻量级容器节点。它继承自 Node 接口,具有普通节点的所有操作特性(如 appendChild、querySelector 等),但它不是主 DOM 树的一部分。它的 parentNode 始终为 null。
它最关键的一个独特性质是:当把一个 DocumentFragment 插入到真实 DOM 节点时,插入的并不是片段本身,而是片段的所有子节点。在插入动作执行完毕后,原 DocumentFragment 内部的子节点会被瞬间“搬空”,变成一个空片段。
代码示例:基于 DocumentFragment 批量创建列表项
// 假设已有目标容器
const listContainer = document.getElementById('user-list');

// 模拟的大批量数据数组
const dataList = Array.from({ length: 1000 }, (_, i) => ({
  id: i + 1,
  name: `用户_${i + 1}`,
  role: i % 2 === 0 ? '管理员' : '普通成员'
}));

// 第一步:在内存中创建空的文档片段
const fragment = document.createDocumentFragment();

// 第二步:循环构建 DOM 节点并追加到片段中
// 此时全部操作都在内存中进行,真实页面毫无感知,零回流
dataList.forEach(item => {
  const li = document.createElement('li');
  li.className = 'list-item';
  li.dataset.id = String(item.id);

  const nameSpan = document.createElement('span');
  nameSpan.textContent = item.name;

  const roleBadge = document.createElement('span');
  roleBadge.className = 'badge';
  roleBadge.textContent = item.role;

  // 直接在内存节点上绑定事件监听,完全安全
  li.addEventListener('click', () => {
    console.log(`点击了: ${item.name}`);
  });

  li.appendChild(nameSpan);
  li.appendChild(roleBadge);
  fragment.appendChild(li);
});

// 第三步:将整个片段一次性挂载到真实 DOM 树
// 浏览器在此刻仅执行一次重排与重绘
listContainer.appendChild(fragment);

// 验证:此时 fragment.childNodes.length 已经自动变为 0
console.log('挂载后片段子节点数:', fragment.childNodes.length); // 0
注意事项:
由于
DocumentFragment 挂载时发生的是子节点的“剪切转移”而非深度克隆,若需要在多个容器中复用相同的片段内容,必须在挂载前调用 fragment.cloneNode(true),否则后续容器将接收不到任何节点。
方案二:createContextualFragment 字符串上下文解析
DocumentFragment 非常适合面向对象、通过 document.createElement 逐层组装节点的场景。但在日常业务开发中,开发者往往更喜欢使用模板字符串(Template Literals)来编写 HTML 结构,因为字符串拼接更贴近 HTML 的书写直觉。
如果手头已有一长串 HTML 模板字符串,怎样将其转为 DocumentFragment 插入?传统做法通常是创建一个临时的 div 容器,给其 innerHTML 赋值,再把子节点转移出来。然而,临时 div 会引入一层多余的内存包裹,且在解析 <tr>、<td>、<option> 等具有严格父级约束的标签时会直接解析失败。
这就是 Range.prototype.createContextualFragment 大显身手的地方。它是 DOM Parsing and Serialization 规范中提供的标准方法,能够根据指定的上下文节点环境,直接将 HTML 字符串解析成一个包含对应子节点的 DocumentFragment。
执行流程与原理解析
调用该方法前,需要先通过 document.createRange() 创建一个选区对象,并借助 range.selectNodeContents(targetElement) 指明当前字符串将要插入的上下文容器。随后,浏览器会激活与该容器标签上下文匹配的 HTML 解析算法,保证哪怕解析的是孤立的 <tr> 或 <td>,也能被正规的表格模型正确理解与构造。
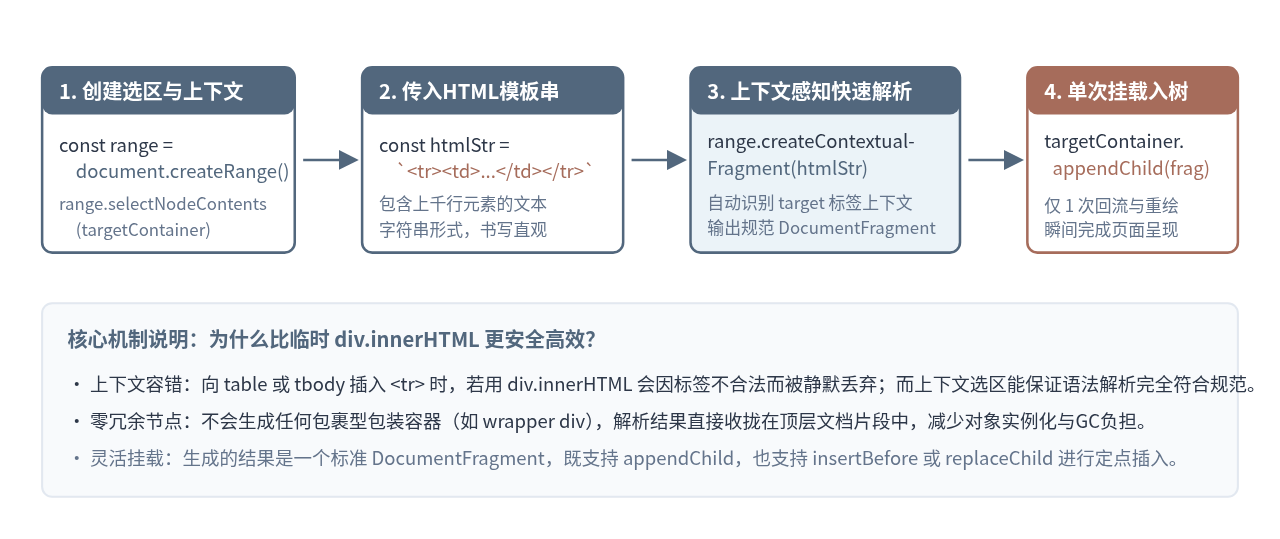
代码示例:批量解析表格行数据
以最容易遇到解析上下文问题的 <tbody> 表格场景为例,演示 createContextualFragment 的标准操作:
// 目标表格体容器
const tbody = document.getElementById('table-body');

// 模拟 1500 条表格数据
const records = Array.from({ length: 1500 }, (_, index) => ({
  orderId: `ORD-2026-${String(index + 1).padStart(5, '0')}`,
  amount: (Math.random() * 1000).toFixed(2),
  status: index % 3 === 0 ? '已支付' : '待处理'
}));

// 第一步:拼接成完整的 HTML 片段字符串
const rowsHtmlString = records.map(item => `
  <tr class="row-item">
    <td>${item.orderId}</td>
    <td>¥${item.amount}</td>
    <td><span class="status-tag">${item.status}</span></td>
  </tr>
`).join('');

// 第二步:创建 Range 并指定上下文
const range = document.createRange();
// 这一步至关重要:设置上下文为 tbody,确保解析器知道当前正在解析 table 行!
range.selectNodeContents(tbody);

// 第三步:直接将字符串解析为 DocumentFragment
const tableFragment = range.createContextualFragment(rowsHtmlString);

// 第四步:一次性挂载到真实 DOM 中,仅触发一次回流
tbody.appendChild(tableFragment);
安全警示(XSS与脚本执行):
与普通的
innerHTML 略有不同,createContextualFragment 解析包含 <script> 标签的字符串时,解析生成的脚本节点在插入真实 DOM 后可能会被浏览器执行。因此,如果模板字符串中包含不可信的用户输入,务必先进行严格的 XSS 过滤(如使用 DOMPurify 或转义函数),切勿直接解析拼接未经校验的外来文本。
全方位对比:四种批量插入方案的技术特征
为了在实际架构与业务开发中做出精准权衡,我们将常规 innerHTML 累加、直接 appendChild、DocumentFragment、以及 createContextualFragment 连同 HTML5 <template> 进行横向对比。
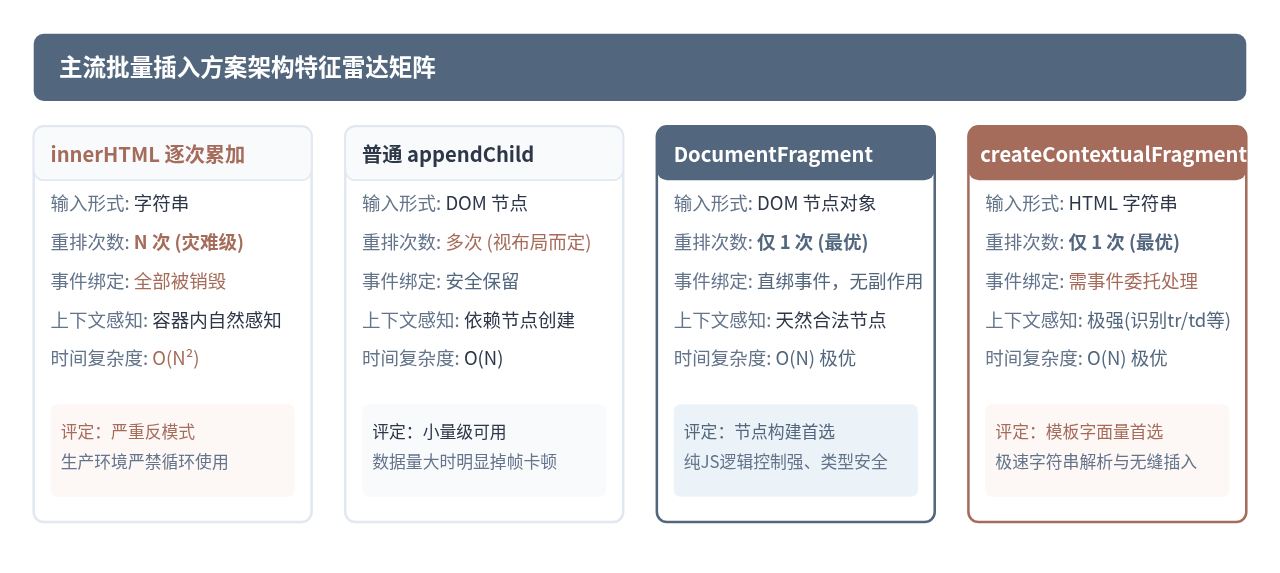
| 对比维度 | DocumentFragment | createContextualFragment | template 元素 (cloneNode) |
|---|---|---|---|
| 数据输入形态 | 真实的 DOM 节点对象 | 原生 HTML 模板字符串 | 预先存在或动态构建的 HTMLTemplateElement |
| 解析开销 | 零 HTML 字符串解析过程,纯 JS 堆对象创建 | 调用底层高效 C++ HTML 解析器 | 初始解析一次,后续通过克隆节点复用 |
| 事件绑定支持 | 可直接在循环中对每个节点 addEventListener |
需在挂载后查询 DOM 节点或借助父容器进行事件委托 | 克隆节点后支持手动追加事件,也可配合事件委托 |
| 上下文特殊标签 | 使用 createElement('tr'),无上下文约束问题 |
通过 range.selectNodeContents 自动匹配 |
template 内容在惰性文档树中,天然支持任意片段 |
| 挂载后自身状态 | 子节点被清空移交(移入真实 DOM) | 同样生成 DocumentFragment,挂载后子节点移交 | template.content 中的模板始终保留,克隆出来的副本移交 |
技术选型与最佳实践决策流
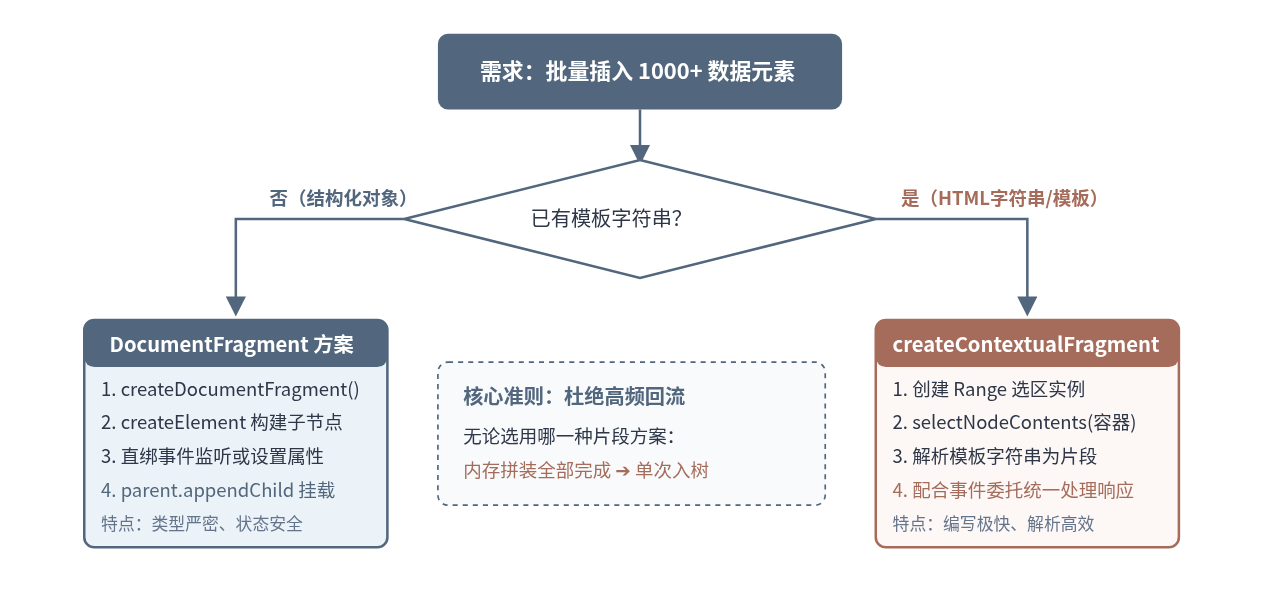
在真实项目落地时,究竟何时使用 DocumentFragment,何时选用 createContextualFragment?通常可以根据以下两个核心条件来决策:数据源形态与事件处理模式。
-
如果你采用数据驱动的细粒度组件构建:
每个生成的项有复杂的内部引用、需要立即绑定特定的闭包回调函数、或者已有现成的 DOM 节点工厂函数,那么采用
document.createDocumentFragment()是最稳健的方式。代码清晰、类型安全且无需经历“HTML字符串化 -> 再次语法解析”的无谓转换。 -
如果你采用模板引擎或 ES6 模板字符串:
结构主要以 HTML 文本形式提供,且已经为列表容器配置了基于冒泡的事件委托(Event Delegation)机制,那么推荐首选
Range.prototype.createContextualFragment。它的解析速度极快,无需手动编写冗长的createElement链条,并且天然解决了孤立特殊标签在普通容器中无法正确解析的痛点。
总结
在没有引入虚拟 DOM(Virtual DOM)库或前端框架的原生 JavaScript 开发场景下,批量插入节点时避免页面卡顿的关键,就在于将频繁的 DOM 操作隔离在内存中完成,只在最终阶段将结果一次性同步至真实文档树。
DocumentFragment 提供了底层的轻量虚拟容器,适合严密、强逻辑、面向 DOM 节点的组装;而 Range.prototype.createContextualFragment 则打通了 HTML 字符串与虚拟文档片段之间的高速通道,兼具模板书写直观与上下文安全解析的双重优势。根据实际数据结构与事件组织形式灵活运用这两者,是编写高性能原生前端界面的必备功底。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章