
深入解析JavaScript中children与childNodes的核心区别,揭示HTML换行与注释被解析为空白文本节点的底层原理,并给出4种只获取HTML元素节点的实用方法与避坑指南。

当前位置:首页 > JavaScript DOM 与事件 > 正文
JS中children与childNodes的区别:怎么只获取元素节点
作者:流萤
时间:2026-11-20
浏览:425
文章目录
分类:JavaScript DOM 编程
nodeType === 1
HTMLCollection vs NodeList
标准规范:W3C DOM Level 1 / Living Standard
在 JavaScript 中,想要仅获取某个容器下的 HTML 标签元素,最直接的答案是使用
element.children,而不是 element.childNodes。children 只返回元素节点(HTMLCollection);而 childNodes 会返回所有子节点(NodeList),包含了代码排版产生的换行符、空格文本节点以及 HTML 注释。如果需要使用数组方法或兼容历史代码,可通过 Array.from(element.children) 或通过 node.nodeType === 1 过滤。
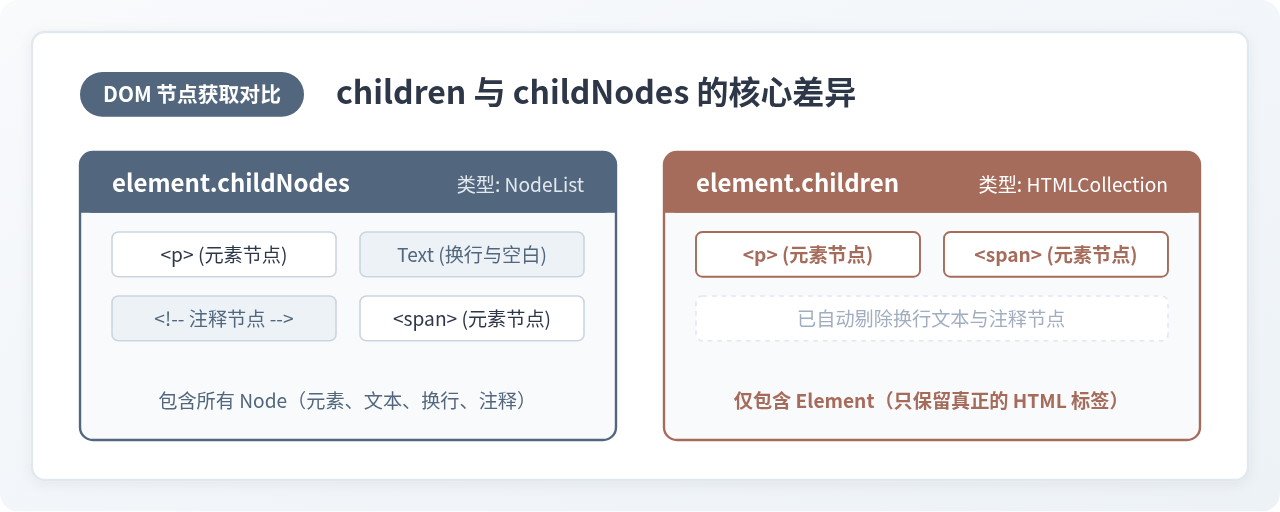
图 0:children 与 childNodes 的核心取值范围对照概览
一、一个普遍存在的困惑:多出来的子节点从何而来
在刚开始操作 DOM 时,很多开发者习惯调用 parent.childNodes 来获取子项,随后试图用索引 parent.childNodes[0] 读取第一个子元素的属性(如 classList 或 style),却经常直接抛出 TypeError: Cannot read properties of undefined 或发现取出来的根本不是预期的标签。
例如下面这段看起来极其普通的 HTML 代码:
<ul id="nav">
  <!-- 菜单列表 -->
  <li>首页</li>
  <li>文档</li>
</ul>
在浏览器控制台中运行以下检查:
const nav = document.getElementById('nav');

console.log('childNodes 长度:', nav.childNodes.length);
console.log('children 长度:', nav.children.length);
childNodes 长度: 5
children 长度: 2
页面上明明只有两个 <li>,为什么 childNodes 的长度却是 5?
答案在于浏览器的 HTML 解析机制。在浏览器构建 DOM 树时,HTML 源码中的每一次回车换行、缩进空格以及 <!-- 注释 -->,都会被解析为独立的节点对象。因此,这 5 个节点分别是:
[0] Text 节点:<ul>标签后到注释之间的换行与缩进空格[1] Comment 节点:<!-- 菜单列表 -->[2] Text 节点:注释结束后到第一个<li>之间的换行与空格[3] Element 节点:<li>首页</li>[4] Text 节点:第一个<li>到第二个<li>之间的换行与空格[5] Element 节点:<li>文档</li>[6] Text 节点:闭合</ul>之前的缩进换行
(注:如果注释与换行紧邻合并,节点数会在 5 到 7 个之间变动)。由此可见,childNodes 忠实记录了 DOM 树上的所有物理节点,而日常业务开发中我们通常只关心“真正的 HTML 标签”,这就产生了根本需求差异。
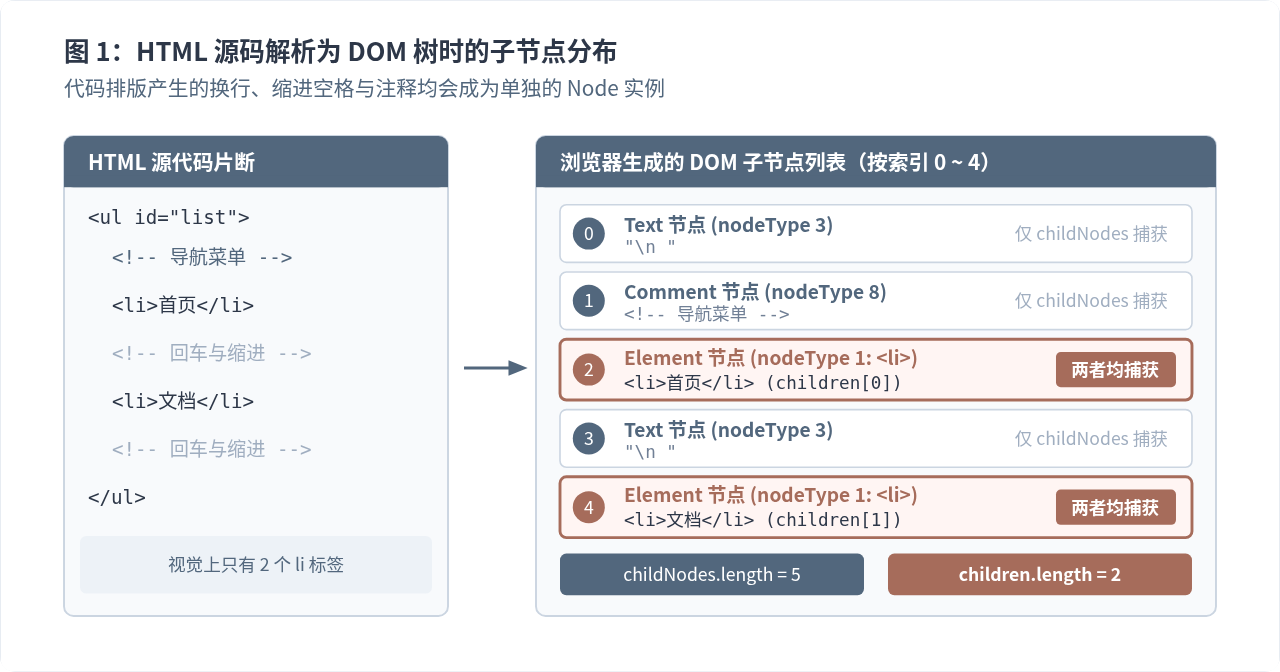
图 1:HTML 源码中的空白与注释在 DOM 树中被解析为独立节点的具体过程
二、children 与 childNodes 的本质区别
从 DOM 规范接口来看,两者的设计意图和所处层级完全不同:
| 特性对比 | element.childNodes |
element.children |
|---|---|---|
| 所属接口 | Node 基础接口(定义于 DOM Level 1) |
ParentNode 扩展接口(Element 继承) |
| 返回值类型 | NodeList |
HTMLCollection |
| 涵盖节点种类 | 所有 Node(元素、文本、换行、注释、CDATA等) |
仅限 Element(元素节点,nodeType === 1) |
| 实时性 (Live) | 动态集合:DOM 发生增删,集合长度实时联动 | 动态集合:DOM 发生增删,集合长度实时联动 |
| 自带遍历方法 | 支持 forEach()、keys()、values()、entries() |
仅支持通过数字索引访问与 item() / namedItem(),无 forEach |
| for...of 迭代 | 支持(实现了 Symbol.iterator) | 支持(实现了 Symbol.iterator) |
这里需要特别澄清一个常见误区:children 和 childNodes 都是动态集合(Live Collection)。这意味着如果通过 JavaScript 新建并插入了一个子节点,或者移除了某个节点,两者的 .length 和索引都会立即发生改变。两者的关键差别仅在于筛选的节点类型不同。
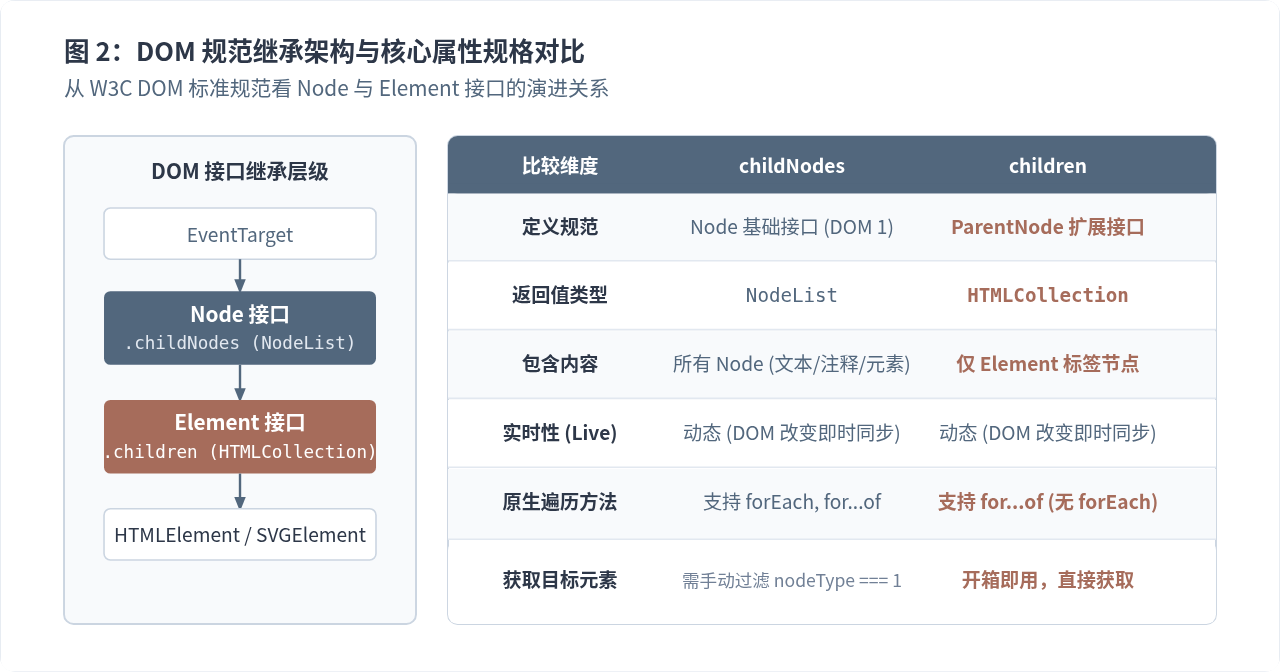
图 2:W3C DOM 规范中 Node 与 Element 接口继承关系及属性特性对比
三、怎么只获取元素节点:4 种实用方案
针对“只获取元素节点”这一明确目标,有四种常见且成熟的实现方式。我们可以根据具体代码环境、迭代需求与性能考量来选择。
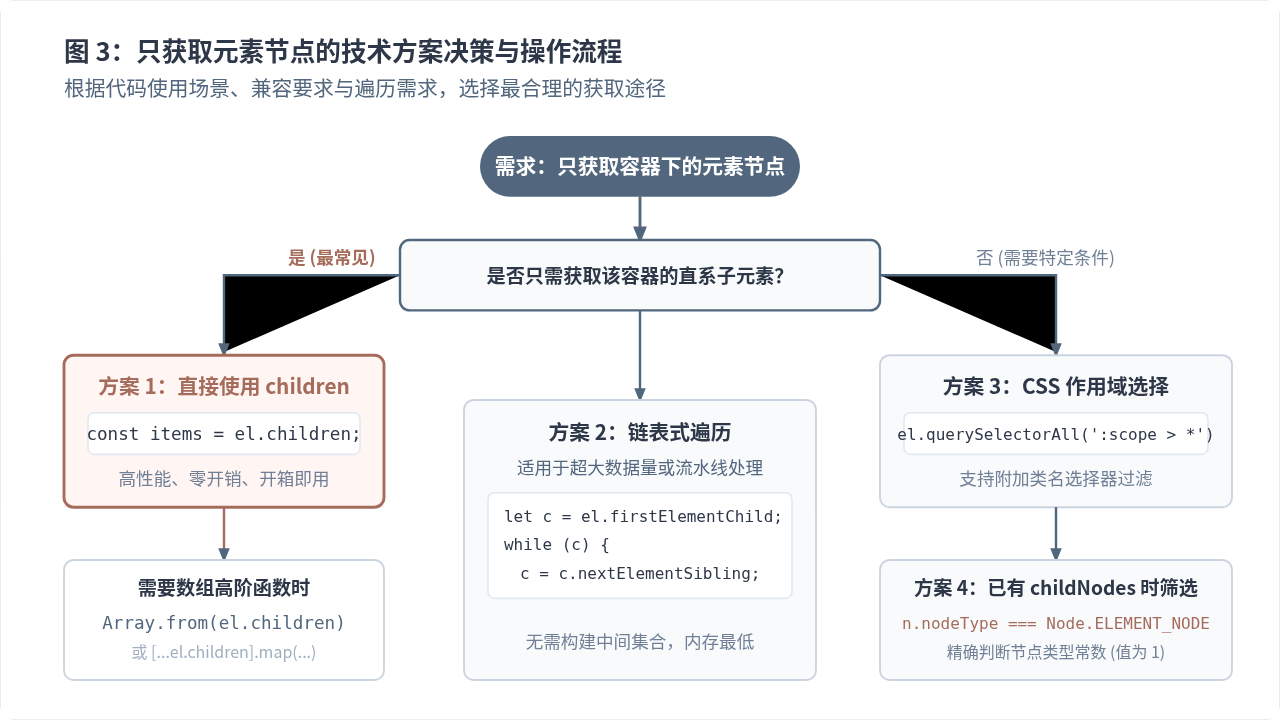
图 3:只获取元素节点的技术方案选择与操作步骤决策流程
方案一:直接使用 element.children(首选标准方案)
这是现代浏览器中最推荐、性能最好且最简洁的原生方案。element.children 是只读属性,它只收集当前元素的直系子元素。
const parent = document.getElementById('container');
const elementChildren = parent.children; // HTMLCollection

// 1. 使用 for...of 直接遍历
for (const child of elementChildren) {
  console.log(child.tagName, child.className);
}

// 2. 如果需要使用 map, filter 等数组方法,先转换为真正数组
const childArray = Array.from(parent.children);
// 或者使用 ES6 展开运算符:
// const childArray = [...parent.children];

const activeItems = childArray.filter(el => el.classList.contains('active'));
console.log('活跃子元素数量:', activeItems.length);
注意:由于
HTMLCollection 原型链上没有 forEach 方法,直接调用 parent.children.forEach(...) 会报错 TypeError: parent.children.forEach is not a function。请务必使用 for...of 或 Array.from(parent.children)。
方案二:使用 querySelectorAll 配合 :scope 选择器
如果需要获取直系子元素,并且可能在获取的同时根据 CSS 属性进行初步筛选,可以使用 querySelectorAll 结合 :scope > *:
const parent = document.getElementById('container');

// :scope 表示当前 parent 容器自身,> * 表示所有直系元素子节点
const elementNodes = parent.querySelectorAll(':scope > *');

// 返回的是 NodeList,原生支持 forEach
elementNodes.forEach(el => {
  console.log('元素标签:', el.tagName);
});
与 children 的区别:querySelectorAll 返回的是静态快照(Static NodeList)。如果后续父容器中动态插入了新的 DOM,该集合不会自动更新。这在防止遍历死循环或需要不可变状态时非常有用。
方案三:在既有 childNodes 上过滤 nodeType === Node.ELEMENT_NODE
当我们在封装底层工具库、编写自定义解析器,或者从上游接口中已经拿到了一个包含各种节点的 NodeList 时,可以通过检查 nodeType 过滤出纯元素节点。
const parent = document.getElementById('container');
const allNodes = parent.childNodes;

// 节点类型常量:Node.ELEMENT_NODE 的数字值为 1
const onlyElements = Array.from(allNodes).filter(node => node.nodeType === Node.ELEMENT_NODE);

console.log('仅保留元素节点:', onlyElements);
Node 接口定义了完整的类型常数,最常见的包括:
Node.ELEMENT_NODE(数值1):例如<div>、<p>、<span>Node.TEXT_NODE(数值3):包含文字内容、纯换行符和缩进空格Node.COMMENT_NODE(数值8):HTML 注释<!-- ... -->Node.DOCUMENT_NODE(数值9):根文档对象document
方案四:链表式遍历(firstElementChild + nextElementSibling)
如果你需要在大规模 DOM 节点树中按顺序逐个处理元素,或者希望在满足某个特定条件时立即中断(break),使用指针链表方式遍历的内存占用最低,完全无需构造中间集合数组:
const parent = document.getElementById('container');

let currentElement = parent.firstElementChild;

while (currentElement) {
  // 执行业务逻辑
  console.log('遍历当前元素:', currentElement);

  // 移向下一个兄弟元素(天然跳过文本与注释节点)
  currentElement = currentElement.nextElementSibling;
}
对应关系非常对称:
firstChild/nextSibling:针对全部节点(包含文本换行)firstElementChild/nextElementSibling:针对纯元素节点
四、避坑指南:动态集合与遍历陷阱
在实际项目中,除了掌握如何获取元素,还需要注意以下两个极其容易引发线上偶发故障的陷阱:
1. 在遍历动态集合时执行增删操作导致漏项
因为 children 是动态的(Live),如果使用递增索引 for (let i = 0; i < children.length; i++) 并在循环体中执行 parent.removeChild(children[i]),每次删除一个元素后,后方所有元素的索引都会向前移一位,同时 length 减 1。这会导致奇数位的元素被跳过、漏删。
// ❌ 错误示范:会导致漏删
const items = parent.children;
for (let i = 0; i < items.length; i++) {
  parent.removeChild(items[i]); // 每次移除后,原索引 i+1 变成了 i,导致部分项被漏跳
}

// ✅ 正确做法一:先转为静态数组再遍历
Array.from(parent.children).forEach(el => el.remove());

// ✅ 正确做法二:倒序遍历
for (let i = parent.children.length - 1; i >= 0; i--) {
  parent.children[i].remove();
}
2. childNodes[0] 并不等价于 firstElementChild
许多初学者为了简便书写 parent.childNodes[0] 试图获取第一个子元素。但只要模板文件经过 Webpack/Vite 格式化保留了换行,childNodes[0] 必定是 #text 节点。如果需要获取第一个或最后一个子元素,永远应当使用 parent.firstElementChild 与 parent.lastElementChild。
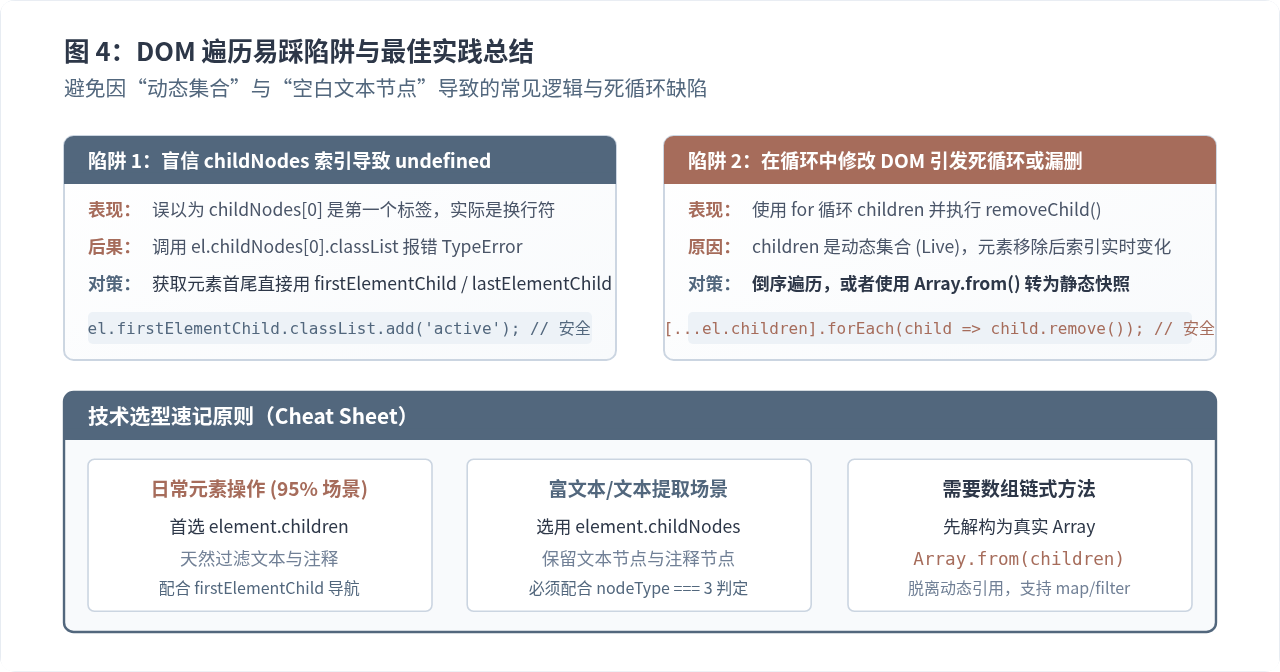
图 4:DOM 遍历易踩陷阱与技术选型速记参考表
五、总结与技术选型建议
回顾本文的核心脉络:
- 核心差异:
childNodes属于Node接口,包含文本、换行、空格和注释;children属于ParentNode接口,只包含 HTML 元素节点。 - 空白节点的由来:源码中任意换行和制表符都会被 HTML 解析器忠实映射为
nodeType === 3的 Text 节点。 - 只获取元素节点的最佳实践:
- 直接读取直系子元素:使用
element.children; - 需要使用数组高阶函数:使用
Array.from(element.children); - 需要附加 CSS 选择器或静态快照:使用
element.querySelectorAll(':scope > *'); - 已有节点集合需要精确剔除:使用
node.nodeType === 1(即Node.ELEMENT_NODE)。
- 直接读取直系子元素:使用
在绝大多数常规前端业务中,只要你的目标是操作样式、绑定事件或提取组件内容,直接使用 children 系列 API 即可彻底规避多余空白节点带来的隐患。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章