
深入对比Node.js环境下jsdom与cheerio在架构原理、执行性能、内存开销与脚本支持等维度的差异,并结合具体场景给出实用选型指南与避坑建议。

当前位置:首页 > Node.js 基础 > 正文
jsdom与cheerio解析HTML的区别及选型建议
作者:南风
时间:2026-11-18
浏览:235
文章目录
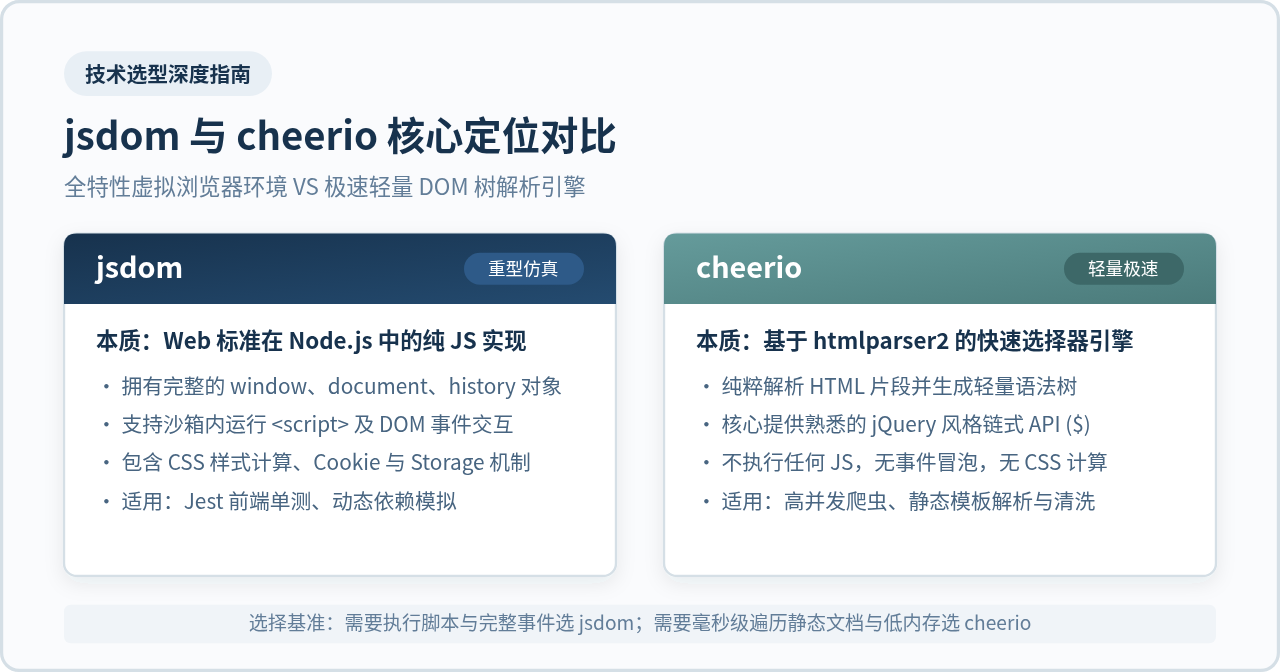
在 Node.js 环境下解析 HTML,选型的核心分水岭非常明确:如果需要运行网页内的 JavaScript、模拟完整的浏览器全局对象(Window、Document)并监听真实 DOM 事件,选 jsdom;如果只需要快速解析静态 HTML 字符串、使用类 jQuery 语法高效提取文本、属性并进行批量数据清洗,选 cheerio。两者并非同义替代品,而是在“全仿真浏览器环境”与“轻量文档选择器”两条完全不同的技术路线上演进,在性能开销与内存占用上存在数十倍的差距。
一、核心定位与底层运行机制
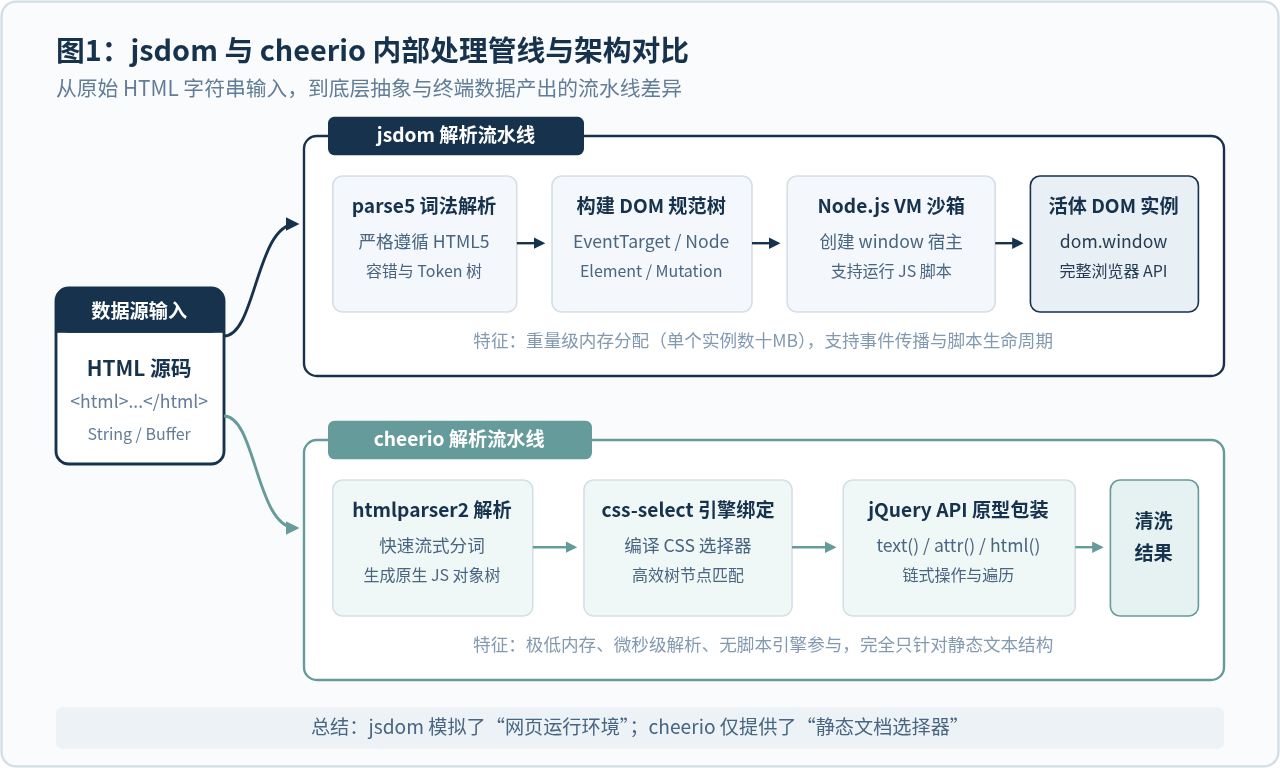
理解两个库差异的第一步,是看它们各自在 Node.js 中把 HTML 解析成了什么对象。
jsdom 是 W3C Web 标准在 Node.js 上的纯 JavaScript 完整实现。当你将一段 HTML 传递给 jsdom 时,它不仅解析标签结构,还会利用 parse5 构建起严格符合规范的完整 DOM 树(包含 Node、Element、Document、EventTarget 等类继承体系)。更关键的是,它会初始化一个虚拟的 Window 宿主对象,并在内部挂载 localStorage、cookieJar、CSS 样式计算器以及 Node.js 的 vm 沙箱。这意味着你可以在服务端执行页面中包含的 <script> 脚本,并且脚本对 DOM 的修改、事件派发和动态监听都能得到完整反馈。
cheerio 则是一个极简、轻量的快速 DOM 包装器。它的底层默认采用 htmlparser2(也可切换为 parse5)进行快速语法分词,直接将 HTML 字符串转换成由普通 JavaScript 简单对象构成的抽象语法树(AST)。在此基础之上,cheerio 封装了绝大部分开发者耳熟能详的 jQuery 核心选择器 API($ 符号语法)。cheerio 不包含浏览器窗口概念,不计算样式,不触发事件冒泡,更不会去执行任何 JavaScript 脚本。它做的事情非常专注:输入一段文本,生成结构树,通过 CSS 选择器快速定位目标并返回内容。
二、关键技术指标全方位对比
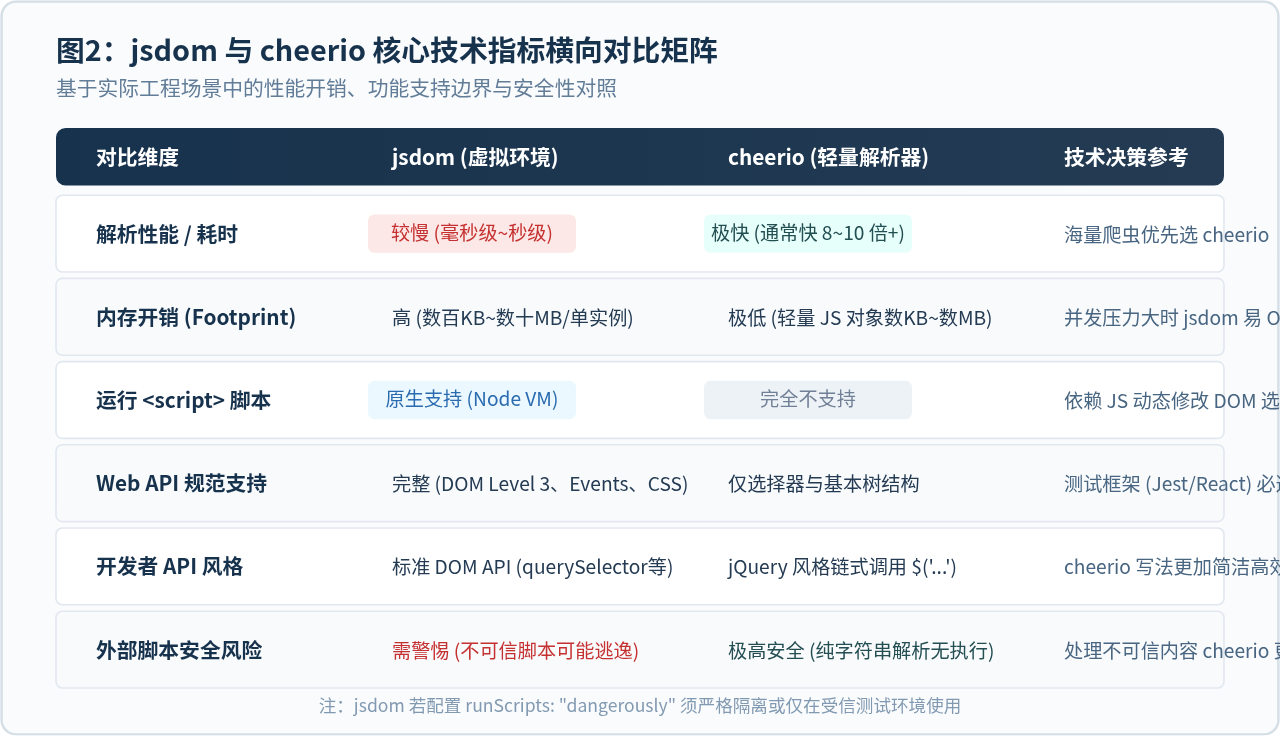
在实际工程场景中,技术选型往往取决于具体性能预算、资源限制和功能边界。以下围绕六个核心维度进行横向拆解:
1. 解析性能与吞吐率
在纯文本解析与节点查找速度上,cheerio 拥有绝对优势。由于无需实例化数十种规范接口与原型链继承,cheerio 解析一份 100KB 的常见网页通常仅需微秒至数毫秒;而在同等规模的文档下,jsdom 建立完整环境往往需要几十毫秒甚至上百毫秒。在需要处理数十万级页面的高吞吐场景下,cheerio 的处理效率通常高出 jsdom 8 到 10 倍以上。
2. 内存消耗与对象开销
jsdom 的单实例内存开销较为庞大。每创建一个 JSDOM 实例,由于需要初始化庞大的 Web API 集合、作用域上下文和标准节点对象,轻则占用数百 KB,若加载复杂页面并执行脚本,单实例内存占用可达数十兆字节。如果不加以显式生命周期控制,极易在循环处理中引发 Node.js 堆内存溢出(OOM)。相比之下,cheerio 构建的节点只是轻量级键值对象,单次解析占用极低,GC 回收轻快顺畅。
3. JavaScript 脚本执行能力
这是两者最不可逾越的鸿沟。cheerio 将 <script> 标签内的代码纯粹当成普通文本节点保存,完全不具备执行脚本的能力。而 jsdom 原生通过 Node.js 的 vm 模块提供了脚本运行能力,只要开启配置项,就能像在真实浏览器中一样让脚本动态写入 DOM、修改属性或监听异步定时器。
4. Web 标准与 API 习惯
在 API 风格上,jsdom 遵循 W3C 原生标准,开发者通过 dom.window.document.querySelector()、addEventListener() 等标准接口与文档交互。而 cheerio 则提供链式调用语法,如 $('div.item').find('a').attr('href'),对于有前端 jQuery 背景或希望编写紧凑提取逻辑的开发者来说,代码更加简练。
5. 服务端安全边界
当处理第三方抓取到的不可信 HTML 时,cheerio 具备天然的安全性,因为它绝不会执行任何外部注入的代码;而在 jsdom 中,如果盲目开启 runScripts: "dangerously",不可信网页中的恶意脚本可能通过 Node.js VM 逃逸攻击宿主进程,造成安全隐患。
三、标准操作步骤与代码对比
在工程项目中,两个库从环境准备、初始化加载、节点提取到最终生命周期收尾,有着规范的操作范式。
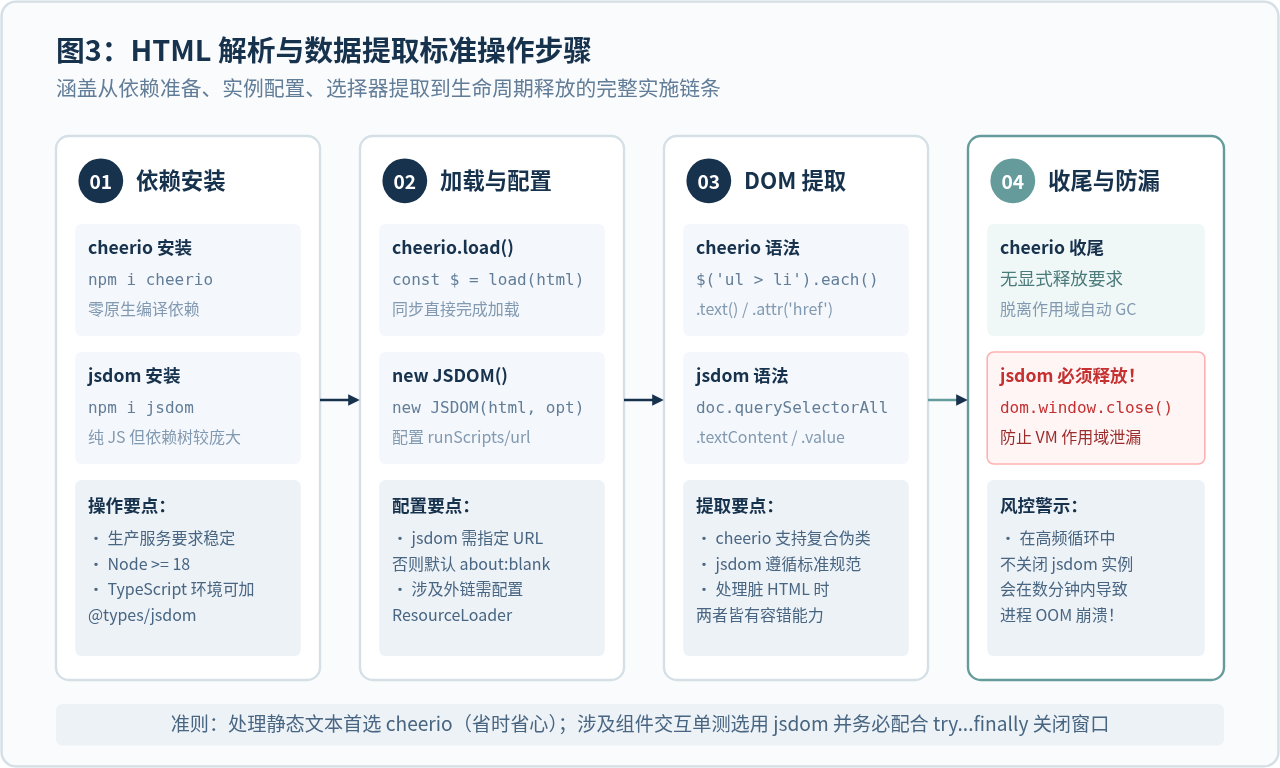
步骤 1:安装依赖
在 Node.js 项目根目录下根据需求安装对应的 npm 包:
# 如果是静态解析、爬虫与清洗任务
npm install cheerio

# 如果是前端单测、虚拟浏览器环境
npm install jsdom
步骤 2:使用 cheerio 提取结构化数据
以下示例展示了使用 cheerio 从静态商品列表中高效提取标题与价格的代码实现:
import * as cheerio from 'cheerio';

// 模拟待解析的 HTML 片段
const html = `
  <div class="product-list">
    <div class="item" data-id="101">
      <h3 class="title">无线降噪耳机</h3>
      <span class="price">¥799</span>
    </div>
    <div class="item" data-id="102">
      <h3 class="title">机械键盘</h3>
      <span class="price">¥499</span>
    </div>
  </div>
`;

// 1. 同步加载 HTML 字符串
const $ = cheerio.load(html);

// 2. 使用 jQuery 风格选择器遍历目标节点
const products = [];
$('.product-list .item').each((index, element) => {
  const id = $(element).attr('data-id');
  const title = $(element).find('.title').text().trim();
  const price = $(element).find('.price').text().trim();

  products.push({ id, title, price });
});

console.log(products);
示例输出:
[
  { id: '101', title: '无线降噪耳机', price: '¥799' },
  { id: '102', title: '机械键盘', price: '¥499' }
]
步骤 3:使用 jsdom 执行脚本并读取动态 DOM
以下示例展示了在服务端利用 jsdom 运行内嵌脚本、动态渲染列表并提取结果的完整过程:
import { JSDOM } from 'jsdom';

// HTML 内部包含生成内容的 JavaScript 脚本
const html = `
  <!DOCTYPE html>
  <html>
    <body>
      <ul id="dynamic-list"></ul>
      <script>
        // 脚本在页面初始化时动态挂载子节点
        const container = document.getElementById('dynamic-list');
        const tasks = ['环境检查', '依赖编译', '执行测试'];
        tasks.forEach(task => {
          const li = document.createElement('li');
          li.textContent = task;
          container.appendChild(li);
        });
      </script>
    </body>
  </html>
`;

// 1. 初始化 JSDOM 实例,显式声明允许运行脚本
const dom = new JSDOM(html, {
  runScripts: "dangerously", // 允许执行内联 JS(请仅用于受信内容)
  resources: "usable"
});

try {
  // 2. 使用标准 W3C DOM API 读取由内部脚本渲染出的节点
  const document = dom.window.document;
  const items = Array.from(document.querySelectorAll('#dynamic-list li'))
    .map(el => el.textContent);

  console.log(items);
} finally {
  // 3. 关键收尾:务必调用 close() 关闭窗口,销毁虚拟机沙箱与计时器
  dom.window.close();
}
示例输出:
[ '环境检查', '依赖编译', '执行测试' ]重要注意事项:jsdom 资源显式释放
在循环或长时间运行的服务中反复创建 JSDOM 实例时,务必将提取逻辑放入 try...finally 块中,并在 finally 内显式调用 dom.window.close()。若遗漏该步骤,虚拟窗口内的事件监听器和沙箱上下文将无法被 V8 垃圾回收器及时回收,从而导致严重的内存泄漏。
四、技术选型决策树与场景建议
根据项目核心指标与技术诉求,可以按如下逻辑链条快速确定选型方案:
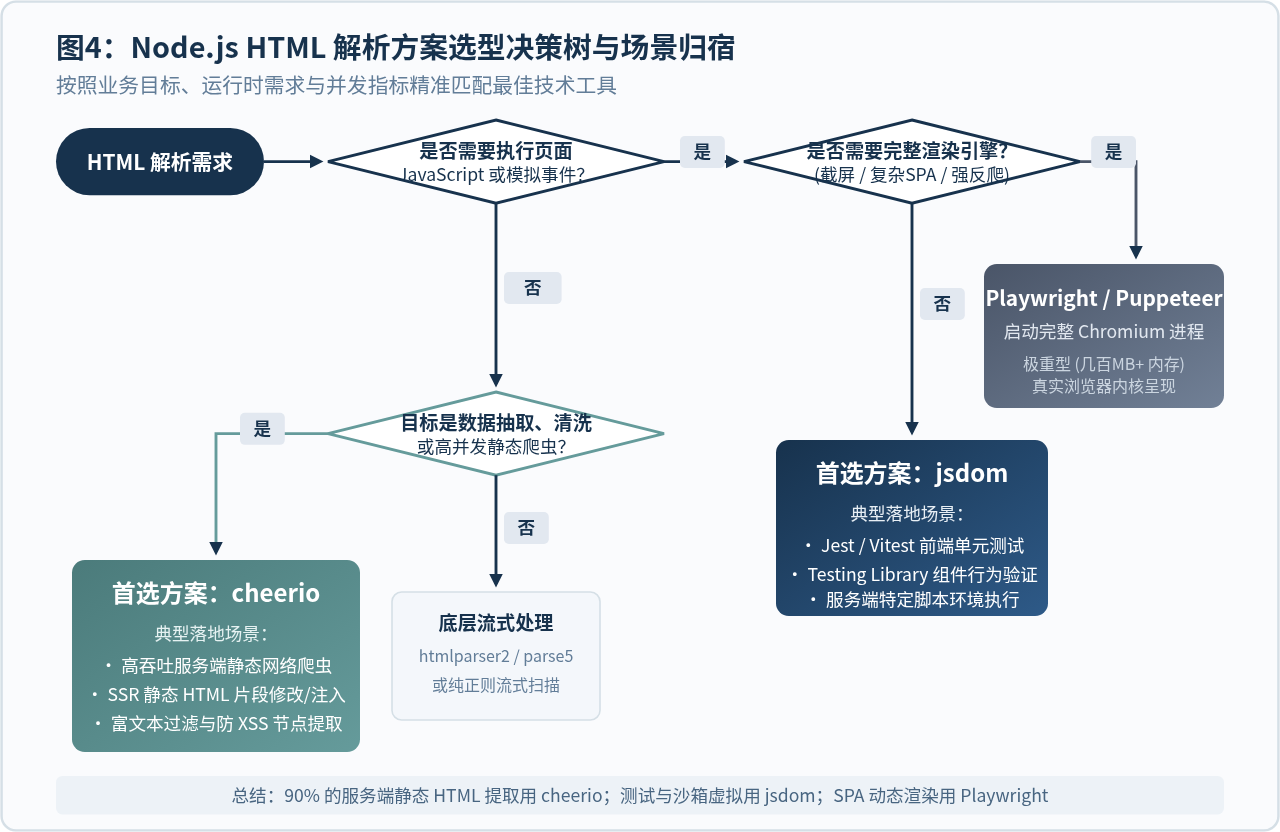
场景 1:网络爬虫与高并发服务端数据抓取
明确选型:cheerio。
现代大多数网络爬虫在抓取服务端渲染(SSR)页面、静态文档或通过 REST API 配合抓取的静态 HTML 片段时,首要指标是单机吞吐量和低资源消耗。cheerio 启动开销几乎为零,内存占用极小,能在数秒内并发处理数万个网页解析任务。只要目标数据存在于服务端返回的初始 HTML 源码中,cheerio 是最理想的选择。
场景 2:前端组件与应用的单元测试(如 Jest / Vitest)
明确选型:jsdom。
在 React、Vue、Svelte 等组件库的测试中(如搭配 @testing-library/react),测试代码需要触发真实的按钮点击、表单输入、输入失焦(blur)、事件冒泡以及检查 document.activeElement。cheerio 根本不具备这些交互模型,因此 jsdom 是前端单测工程的事实标准。
场景 3:静态 HTML 转换与防 XSS 富文本清洗
明确选型:cheerio。
在博客系统、CMS 或服务端生成(SSG)管线中,经常需要对用户上传的 HTML 补全外链 rel="noopener" 属性、重写图片 CDN 地址或过滤危险标签。cheerio 提供了强大的 html() 输出能力与精准的选择器定位,执行稳定且无额外环境负担。
场景 4:页面高度依赖客户端 JS 异步渲染或复杂反爬
明确选型:都不选,转向 Playwright 或 Puppeteer。
这是一个极具普遍性的选型陷阱。部分开发者在面对由 React/Vue 构建的纯单页应用(SPA)时,期望用 jsdom 加载外链打包文件(bundle.js)并等其渲染完毕。虽然 jsdom 理论上支持资源加载,但它缺乏真实的排版引擎、WebGL/Canvas 硬件加速、现代 WebAssembly 支持以及复杂的网络协议栈,运行庞大的现代打包脚本极易报错或静默卡死。如果页面数据必须依赖真实浏览器渲染,或者存在复杂的设备指纹反爬校验,应直接选择 Playwright 或 Puppeteer 运行无头 Chromium 实例。
五、生产环境避坑指南
在落实具体开发时,以下细节是实际排错中最容易忽视的重点:
- 非法与残缺 HTML 的容错机制:网络上获取的 HTML 常常存在未闭合标签或标签嵌套错误。cheerio 的
htmlparser2会尽可能容忍并修正结构;jsdom 使用的parse5则完全遵循 HTML5 规范的容错算法(自动补全<tbody>、移动非法位置的标签)。在编写选择器时,注意审查实际解析出的父子层级,避免因为选择器路径过于死板而匹配落空。 - cheerio 伪类与严格 CSS 选择器的区别:cheerio 扩展支持了类似
:first、:last、:eq(n)等 jQuery 专有伪类。如果未来有可能将逻辑迁移至标准 DOM 环境,建议优先使用标准的:nth-child()或原生数组切片。 - 字符编码预处理:无论是 jsdom 还是 cheerio,传入的字符串都必须是完成转码后的 UTF-8 文本。若目标页面是 GBK/GB2312 编码,必须在传给解析器之前使用
iconv-lite完成解码,否则会出现乱码并破坏标签结构。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章