
深入讲解Node.js调用Python脚本时如何优雅处理异步数据返回,涵盖标准流监听、分包粘包规避、缓冲区强制刷新、常驻Worker进程及超时守护等实用方案。

当前位置:首页 > Node.js 基础 > 正文
Node.js调用Python时怎么处理异步数据返回
作者:栖木
时间:2026-11-17
浏览:209
文章目录
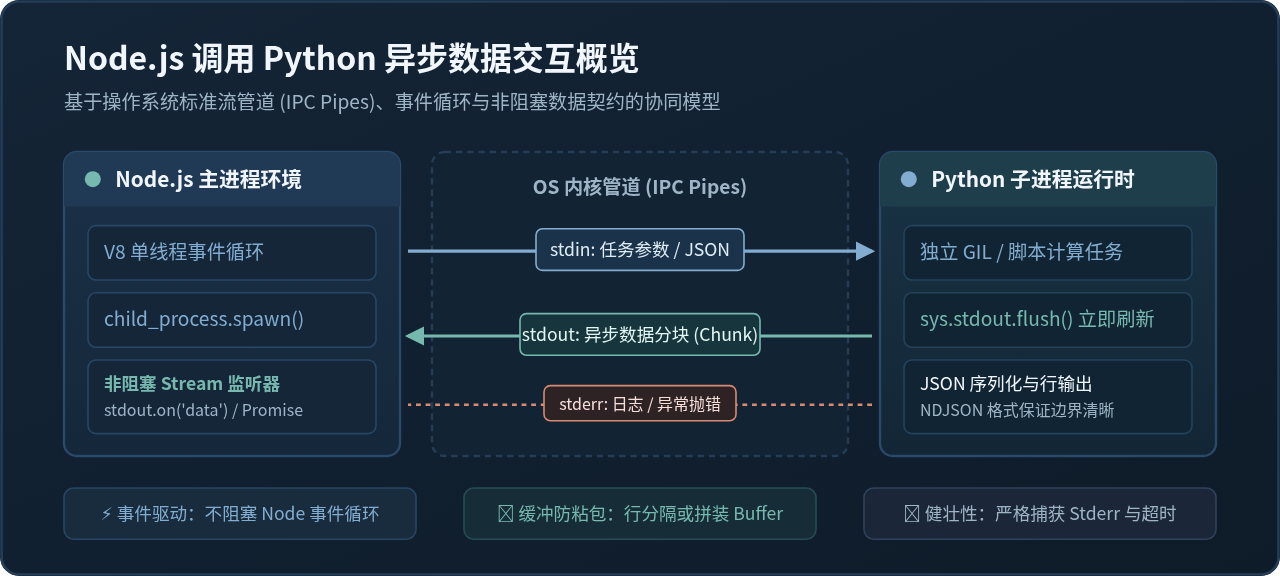
假设你正在使用 Node.js 搭建一套图像处理与文本分析服务:客户端上传用户图片与大段文字,Node.js 负责处理高并发网络 I/O、权限校验与请求调度;而在需要执行文本分词、复杂矩阵运算或深度学习模型推断时,系统需要调用底层的 Python 脚本。由于单次计算耗时数秒,且数据以标准输出流分批返回,若处理不当,极易出现 Node.js 事件循环被阻塞、返回数据包被截断导致 JSON 解析失败、甚至 Python 默认块缓冲机制使结果迟迟不被 Node.js 接收等问题。
处理 Node.js 调用 Python 异步数据返回的核心方案,在于利用操作系统管道(OS Pipes)建立非阻塞的流式通信,并将底层的可读流事件与 Node.js 的 Promise 或异步迭代器进行对齐绑定。根据业务对延迟、频次与数据量的不同要求,主要分为三条解决路径:单次任务的标准子进程(child_process.spawn)封装、高频任务的 Stdio 常驻长进程(NDJSON 协议)、以及重型长周期任务的异步服务或消息队列解耦。
一、异步调用 Python 的底层通信机制
在 Node.js 中,调用外部程序最基础的方式是使用内置的 child_process 模块。很多开发者在初次接触时容易混淆 exec 与 spawn:exec 会派生一个系统 shell 并将所有标准输出缓冲到内存中,当缓冲区(默认通常为 1MB)溢出或执行时间过长时极易报错;而 spawn 则直接发起系统调用衍生独立子进程,并通过操作系统的标准流管道(stdin、stdout、stderr)以异步流(Stream)的方式实时传输数据。
当 Python 进程在独立线程或进程中运行时,Node.js 主线程的事件循环(libuv)完全不会受到其 CPU 密集型计算的阻塞。Python 计算完成后,通过写入自身的文件描述符 1(stdout),操作系统将字节流推送到 Node.js 端的可读流中,触发 data 事件。
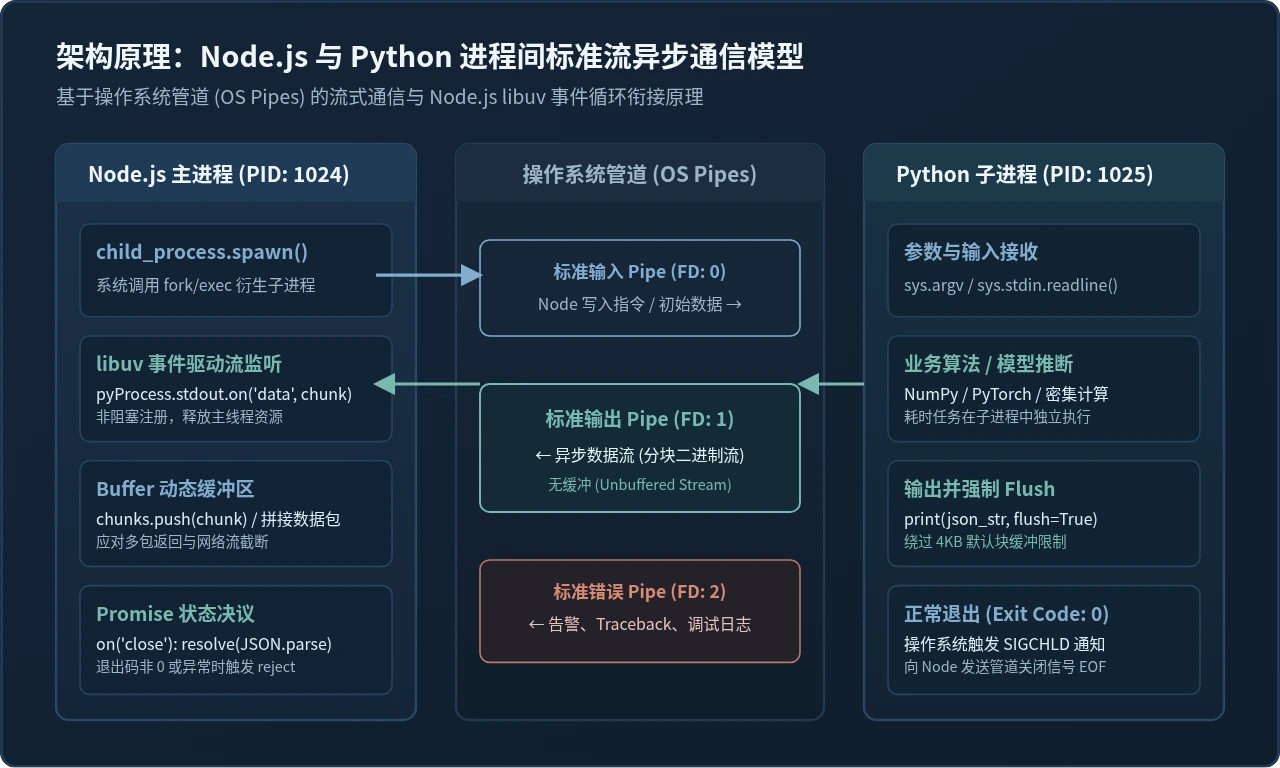
核心通信原则: Node.js 与 Python 运行在两个完全隔离的操作系统进程中,拥有独立的内存空间与运行环境。所有跨语言的数据交互本质上都是字节流序列化与反序列化的过程。保证数据完整性的前提是双方必须约定明确的数据边界(如完整 EOF 信号或换行符
)。
二、方案一:基于 child_process.spawn 的标准流处理与 Promise 封装
对于执行频次较低、单次运行耗时适中的脚本调用,最稳妥的做法是利用 child_process.spawn,并将其包装为一个返回 Promise 的异步函数。这样既保留了流式异步的非阻塞特性,又能无缝融入 async/await 的现代异步控制流。
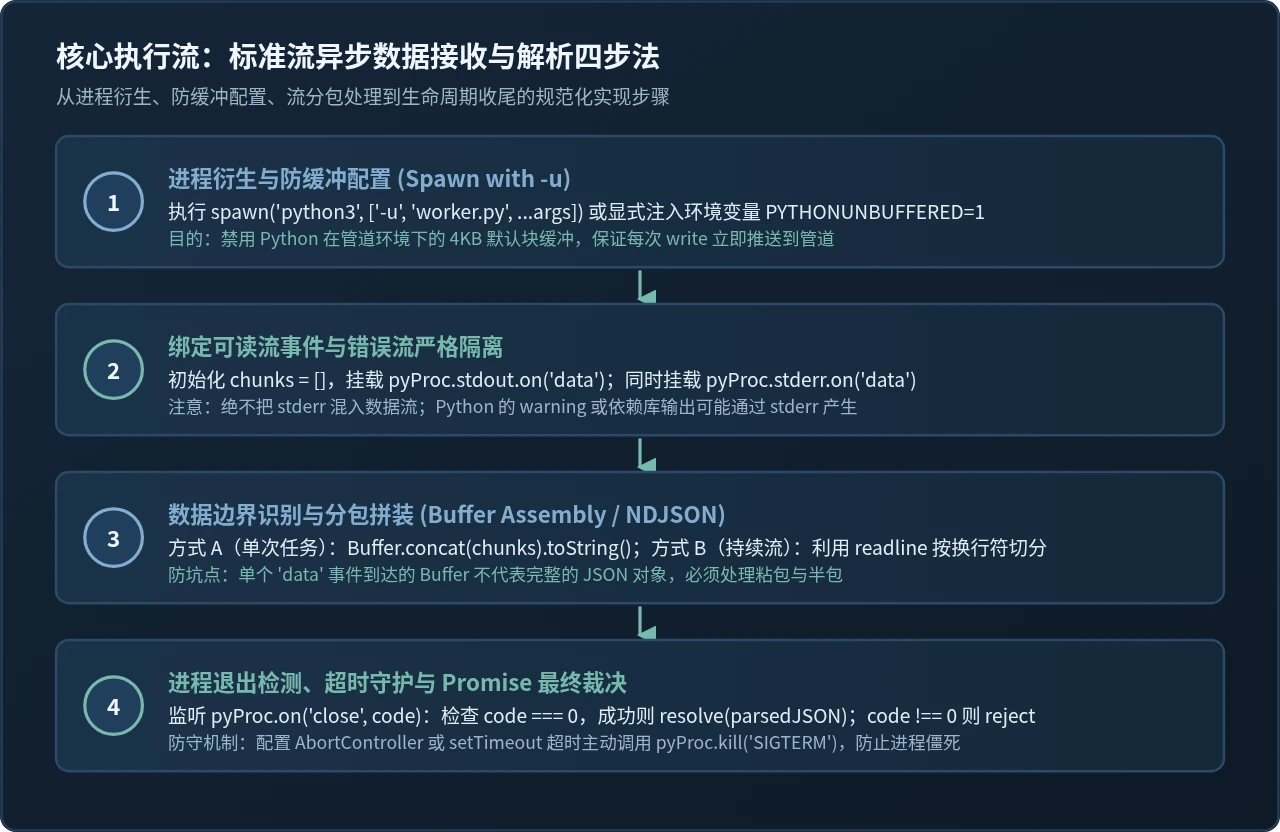
1. Node.js 端封装实现
在下面的示例中,我们创建 runPythonScript 函数。代码中创建了两个 Buffer 数组分别收集 stdout 和 stderr,在子进程完全退出时(close 事件)统一进行 Buffer 拼装并解析 JSON,同时配置了防挂死的超时保护:
// bridge.js
const { spawn } = require('child_process');
const path = require('path');

/**
 * 异步调用 Python 脚本并返回解析后的 JSON 数据
 * @param {string} scriptPath Python 脚本绝对路径
 * @param {Array<string>} args 传递给脚本的位置参数
 * @param {number} timeoutMs 超时时间(毫秒),默认 15000ms
 * @returns {Promise<any>} 解析后的异步数据
 */
function runPythonAsync(scriptPath, args = [], timeoutMs = 15000) {
  return new Promise((resolve, reject) => {
    // 关键点 1:使用 '-u' 参数强制禁用 Python 标准输出的块缓冲
    const pyProcess = spawn('python3', ['-u', scriptPath, ...args], {
      env: { ...process.env, PYTHONUNBUFFERED: '1' }
    });

    const stdoutChunks = [];
    const stderrChunks = [];
    let isSettled = false;

    // 关键点 2:超时守护,防止 Python 陷入死循环导致连接泄漏
    const timer = setTimeout(() => {
      if (!isSettled) {
        isSettled = true;
        pyProcess.kill('SIGTERM');
        reject(new Error(`Python 脚本执行超时 (>${timeoutMs}ms)`));
      }
    }, timeoutMs);

    // 关键点 3:异步累加 stdout 数据分块
    pyProcess.stdout.on('data', (chunk) => {
      stdoutChunks.push(Buffer.from(chunk));
    });

    // 关键点 4:严格隔离 stderr,用于故障排查
    pyProcess.stderr.on('data', (chunk) => {
      stderrChunks.push(Buffer.from(chunk));
    });

    // 监听子进程启动失败事件(如未安装 python3 或找不到脚本路径)
    pyProcess.on('error', (err) => {
      clearTimeout(timer);
      if (!isSettled) {
        isSettled = true;
        reject(new Error(`无法启动 Python 子进程: ${err.message}`));
      }
    });

    // 关键点 5:监听进程退出事件
    pyProcess.on('close', (code, signal) => {
      clearTimeout(timer);
      if (isSettled) return;
      isSettled = true;

      const stdoutRaw = Buffer.concat(stdoutChunks).toString('utf-8').trim();
      const stderrRaw = Buffer.concat(stderrChunks).toString('utf-8').trim();

      if (code !== 0) {
        return reject(new Error(`Python 进程退出异常 (退出码 ${code}, 信号 ${signal}): ${stderrRaw || '无错误日志'}`));
      }

      if (!stdoutRaw) {
        return resolve(null);
      }

      try {
        const parsed = JSON.parse(stdoutRaw);
        resolve(parsed);
      } catch (parseErr) {
        reject(new Error(`解析 Python 返回的 JSON 失败: ${parseErr.message}。原始输出: "${stdoutRaw}"`));
      }
    });
  });
}

// 使用示例:
async function main() {
  try {
    const result = await runPythonAsync(path.join(__dirname, 'worker.py'), ['--input', 'hello world']);
    console.log('成功获取 Python 异步返回数据:', result);
  } catch (err) {
    console.error('调用失败:', err.message);
  }
}

main();
2. Python 端配合实现
编写配套的 worker.py 脚本。Python 端在输出数据时,必须确保写入纯粹的 JSON 字符串,并且显式执行刷新:
# worker.py
import sys
import json
import time

def process_data(text_input):
    # 模拟耗时计算或模型处理
    time.sleep(1.2)
    return {
        "status": "success",
        "processed_text": text_input.upper(),
        "char_count": len(text_input),
        "metrics": {
            "confidence": 0.985,
            "latency_ms": 1200
        }
    }

def main():
    # 从命令行参数中提取输入
    input_str = sys.argv[2] if len(sys.argv) > 2 else "default input"

    # 业务计算
    output_dict = process_data(input_str)

    # 将结果序列化为 JSON 字符串并输出
    json_output = json.dumps(output_dict, ensure_ascii=False)
    sys.stdout.write(json_output + "
")
    # 关键点:显式调用 flush,保证数据脱离 Python 内部缓冲区
    sys.stdout.flush()

if __name__ == "__main__":
    main()
三、核心避坑:数据包粘包截断与 Python 缓冲机制
在实际生产环境中,很多团队按照上述逻辑编写代码后,往往在数据量增大或多并发时遭遇难以复现的奇怪报错。最典型的两处隐患便是标准输出块缓冲与流式分包不完整。
1. Python 管道环境下的 4KB 块缓冲问题
当 Python 直接在终端(TTY)中运行时,sys.stdout 默认采用行缓冲(Line Buffered)模式,即遇到
就会把数据推送到终端;但在被 Node.js 作为子进程管道调用时,操作系统会将其判定为非交互式管道(Block Buffered),Python 内部会开启 4KB 大小的块缓冲。这意味着:如果你的输出数据小于 4KB,Python 会一直把数据压在内存缓冲区中,直到进程彻底退出或缓冲区填满才写入管道。
解决办法:在 Node.js 调用时必须传入 -u 命令行标志,或者在 spawn 的 env 选项中设置 PYTHONUNBUFFERED=1。同时,Python 代码中每次写完数据建议显式调用 sys.stdout.flush()。
2. 数据分块(Chunks)与 JSON 截断(半包与粘包)
网络或管道底层的 data 事件触发频率完全取决于操作系统的 I/O 调度,单次 data 事件吐出的 chunk 只是一个裸字节数组(Buffer),绝不保证恰好包含一个完整的 JSON 字符串。如果在 stdout.on('data', chunk => JSON.parse(chunk)) 中直接解析,一旦数据体积超过系统单次包上限(通常为 64KB),JSON 字符串就会被拦腰切断,引发反序列化崩溃。
禁忌写法: 切勿在
data 事件回调内直接执行 JSON.parse(chunk)!单次 data 事件仅代表有一批字节到达,可能既包含前一个对象的后半部分,又包含后一个对象的前半部分。单次脚本应在 close 事件后通过 Buffer.concat() 整体解析;持续流场景则应通过 readline 模块进行行切分。
四、方案二:基于 Stdio 的常驻 Worker 进程持续异步通信
如果每来一次请求就 spawn 一个新的 Python 进程,在某些轻量脚本下尚能支撑;但如果 Python 脚本需要导入庞大的第三方库(如 PyTorch、TensorFlow、spaCy、Pandas 等),仅仅 Python 虚拟机的启动和模块导入(冷启动)就会耗费 1 到 3 秒。这在高频 API 服务中是不可接受的。
此时最有效的架构是:常驻一个后台 Python Worker 进程,通过标准输入输出作为全双工 IPC 通道,基于换行符分隔的 JSON(NDJSON)进行多次异步请求复用。
1. Node.js 客户端(带请求 ID 映射的非阻塞客户端)
// persistent_worker.js
const { spawn } = require('child_process');
const readline = require('readline');
const crypto = require('crypto');

class PythonWorkerPool {
  constructor(workerScriptPath) {
    this.workerScriptPath = workerScriptPath;
    this.pendingRequests = new Map(); // reqId -> { resolve, reject, timer }
    this.initProcess();
  }

  initProcess() {
    this.process = spawn('python3', ['-u', this.workerScriptPath], {
      env: { ...process.env, PYTHONUNBUFFERED: '1' }
    });

    // 使用 readline 按行解析 Python 的 stdout 输出
    this.rl = readline.createInterface({
      input: this.process.stdout,
      crlfDelay: Infinity
    });

    this.rl.on('line', (line) => {
      if (!line.trim()) return;
      try {
        const message = JSON.parse(line);
        const { reqId, result, error } = message;
        if (this.pendingRequests.has(reqId)) {
          const { resolve, reject, timer } = this.pendingRequests.get(reqId);
          clearTimeout(timer);
          this.pendingRequests.delete(reqId);
          if (error) {
            reject(new Error(`Python 运算错误: ${error}`));
          } else {
            resolve(result);
          }
        }
      } catch (err) {
        console.error('收到无法解析的行数据:', line, err);
      }
    });

    this.process.stderr.on('data', (chunk) => {
      console.warn(`[Python Worker stderr]: ${chunk.toString('utf-8').trim()}`);
    });

    this.process.on('close', (code) => {
      console.error(`Python Worker 异常退出,退出码: ${code}`);
      // 拒绝当前所有在等待中的请求
      for (const [reqId, { reject, timer }] of this.pendingRequests.entries()) {
        clearTimeout(timer);
        reject(new Error('Python Worker 进程意外终止'));
      }
      this.pendingRequests.clear();
      // 可在此加入指数退避自动重启逻辑
    });
  }

  /**
   * 异步派发计算任务
   */
  execute(action, payload, timeoutMs = 10000) {
    return new Promise((resolve, reject) => {
      const reqId = crypto.randomUUID();
      const timer = setTimeout(() => {
        if (this.pendingRequests.has(reqId)) {
          this.pendingRequests.delete(reqId);
          reject(new Error(`Worker 请求超时 (${timeoutMs}ms)`));
        }
      }, timeoutMs);

      this.pendingRequests.set(reqId, { resolve, reject, timer });

      // 组装带 ID 的数据协议包并写入 stdin,末尾必须带换行符
      const packet = JSON.stringify({ reqId, action, payload }) + '
';
      this.process.stdin.write(packet);
    });
  }

  destroy() {
    if (this.process) {
      this.process.stdin.end();
      this.process.kill('SIGTERM');
    }
  }
}

module.exports = { PythonWorkerPool };
2. Python 常驻端(循环读取 stdin)
# persistent_worker.py
import sys
import json
import traceback

def compute(action, payload):
    if action == "vectorize":
        # 模拟模型处理
        return {"dimensions": 512, "norm": 1.0, "vector_sample": [0.12, 0.45, -0.32]}
    elif action == "echo":
        return payload
    else:
        raise ValueError(f"未知操作类型: {action}")

def main():
    # 循环读取 stdin 行流
    for raw_line in sys.stdin:
        line = raw_line.strip()
        if not line:
            continue
        try:
            req = json.loads(line)
            req_id = req.get("reqId")
            action = req.get("action")
            payload = req.get("payload")

            # 执行业务逻辑
            res_data = compute(action, payload)

            # 返回成功响应
            resp = {
                "reqId": req_id,
                "result": res_data,
                "error": None
            }
        except Exception as e:
            resp = {
                "reqId": req.get("reqId") if 'req' in locals() else None,
                "result": None,
                "error": f"{str(e)} | Trace: {traceback.format_exc()}"
            }

        # 必须写入换行符并刷新,确保 Node 端的 readline 触发
        sys.stdout.write(json.dumps(resp, ensure_ascii=False) + "
")
        sys.stdout.flush()

if __name__ == "__main__":
    main()
五、方案三:重型长周期计算与分布式解耦
当 Python 执行的任务不是几百毫秒级别的轻计算,而是持续数秒、数分钟甚至更久的重型批处理(例如音视频转码、大语言模型微调、复杂报表全库统计)时,无论是单次 spawn 还是常驻 Stdio 进程,都暴露出单机架构的瓶颈:
- Node.js 必须长期挂起 Promise,如果 Node.js 实例意外重启,所有内存中的回调状态全部丢失;
- 长时间运行的子进程一旦发生内存泄漏,容易直接打垮整台服务器的内存;
- 计算任务与 Web API 紧密耦合在同一台机器上,无法根据负载独立水平扩展。
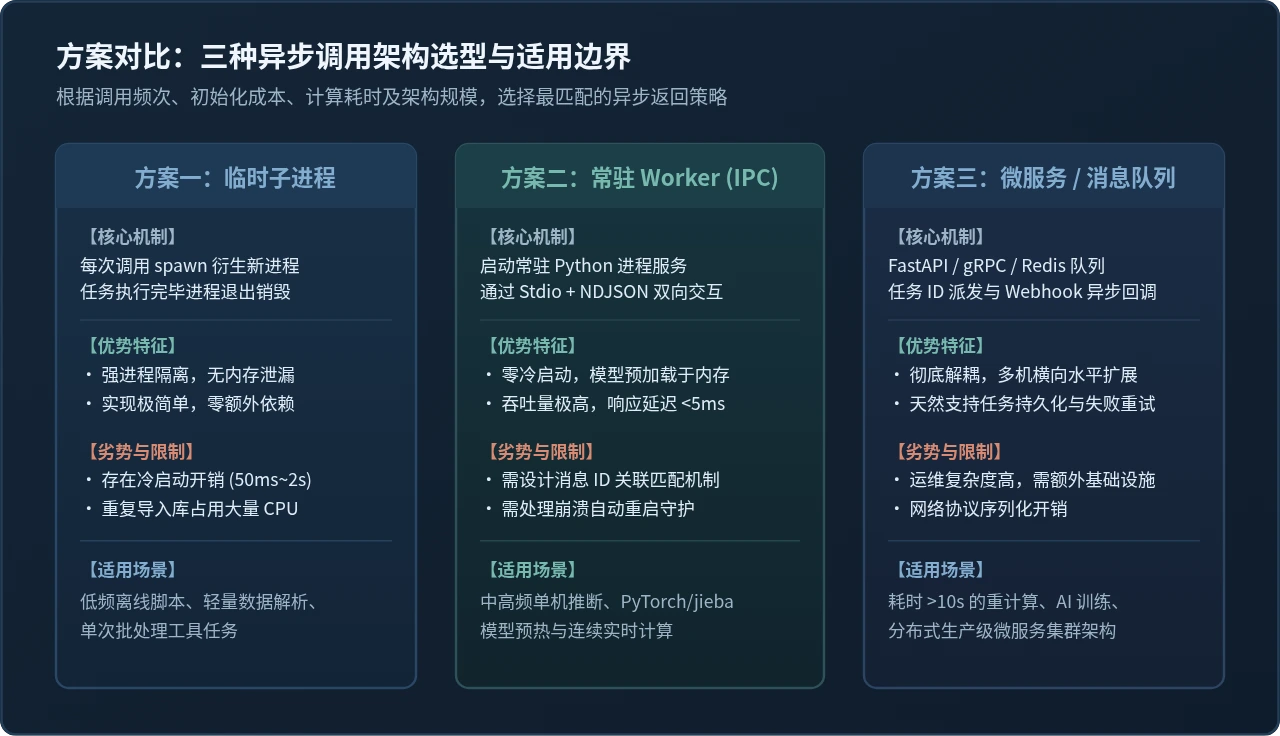
架构选型决策矩阵
| 对比维度 | 方案一:单次子进程 (spawn) | 方案二:常驻 Worker (Stdio IPC) | 方案三:异步微服务 / 消息队列 |
|---|---|---|---|
| 调用延迟 | 较高(存在 50ms~2s 冷启动开销) | 极低(<5ms 管道延迟) | 中等(网络传输与消息入队延迟) |
| 吞吐能力 | 低(频繁 fork 消耗系统资源) | 高(单机内存复用与高频交互) | 极高(支持跨机器集群水平伸缩) |
| 适用耗时 | 100ms ~ 5s 内的短任务 | 10ms ~ 2s 连续计算 | >5s 的中长周期任务、离线作业 |
| 架构复杂度 | 极简,仅需 Node.js 内置模块 | 中等,需维护双向消息协议与保活 | 较高,需引入 Redis/RabbitMQ/FastAPI |
六、健壮性防护:超时守护、错误隔离与进程管理
在生产环境中调用外部子进程,稳定性往往取决于边缘异常的处理能力。以下四项防护措施是避免服务器陷入故障的核心关键:
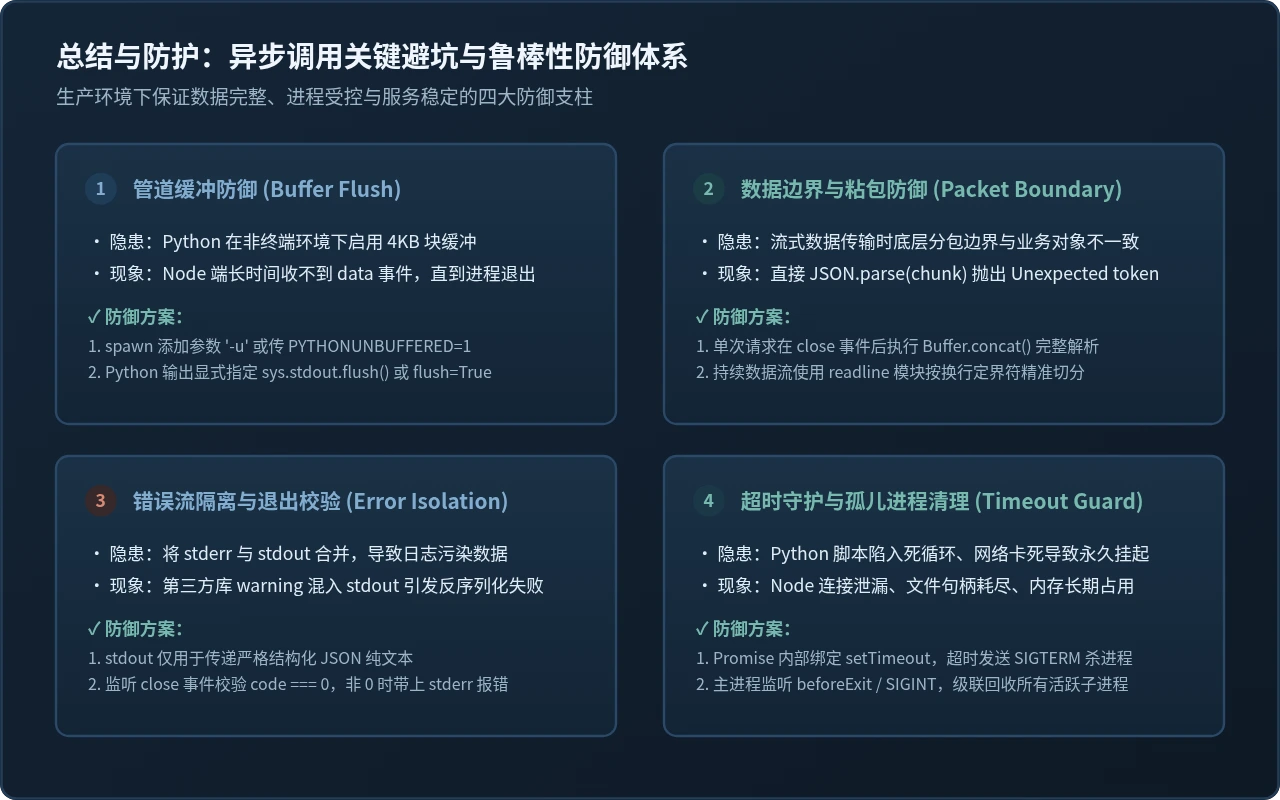
- 标准错误流严格隔离(Stderr Isolation): Python 的第三方依赖库(如 C 扩展、Cython 或 TensorFlow)经常会在初始化阶段往
stderr打印显卡驱动提示、废弃警告(DeprecationWarning)或调试日志。如果简单粗暴地将 stdout 与 stderr 混在一起,JSON 反序列化将 100% 报错。标准做法是:数据只走 stdout,stderr 仅供日志采集。 - 必须绑定 error 与 close 双重生命周期:
error事件在子进程无法衍生(如执行文件不存在、权限不足、系统进程上限)时触发;而close事件在子进程的标准输入输出流关闭后触发。二者必须均有错误处理机制,且在任何一个触发后及时清理定时器与状态。 - 防止孤儿进程与僵尸进程(Zombie Processes): 当 Node.js 服务收到终止信号(如容器编排平台发送的
SIGTERM或SIGINT)准备优雅下线时,必须级联杀掉自己派生的所有 Python 子进程,否则这些子进程将脱离父进程成为系统孤儿进程,持续消耗内存。 - 内存与缓冲区防爆破(MaxBuffer 保护): 对于可能输出海量数据的 Python 脚本,应当限制数据收集上限。例如在
stdout.on('data')中统计接收到的字节总量,一旦超出预设阈值(如 20MB),立即主动中止进程并报错,避免 Node.js 进程因堆内存耗尽而崩溃。
七、总结
处理 Node.js 调用 Python 时的异步数据返回,本质上是在事件驱动模型与多进程管道之间建立桥梁。在开发时,建议遵循以下落地策略:
- 对于低频短批处理,直接采用
child_process.spawn封装 Promise,务必携带-u标志与超时终止机制; - 对于需要加载重型模型的中高频计算,优先构建基于 Stdio 与 NDJSON 协议的常驻 Worker 进程,消除反复启动虚拟机的冷启动延迟;
- 对于计算时间超过 10 秒的长周期重算,尽早转向基于消息队列与独立微服务的异步任务分发体系,保证主服务的响应性能与水平弹性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章