

针对浏览器端使用JavaScript解析XML数据时常见的中文乱码问题,系统剖析乱码发生的根本原因与数据流机制,提供基于Fetch API、TextDecoder、XMLHttpRequest及FileReader的完整解决方案与全链路排查清单。
浏览器端JS解析XML出现中文乱码怎么解决
作者:交互手记
时间:2026-11-17
浏览:610
文章目录
前端数据解析与字符集治理
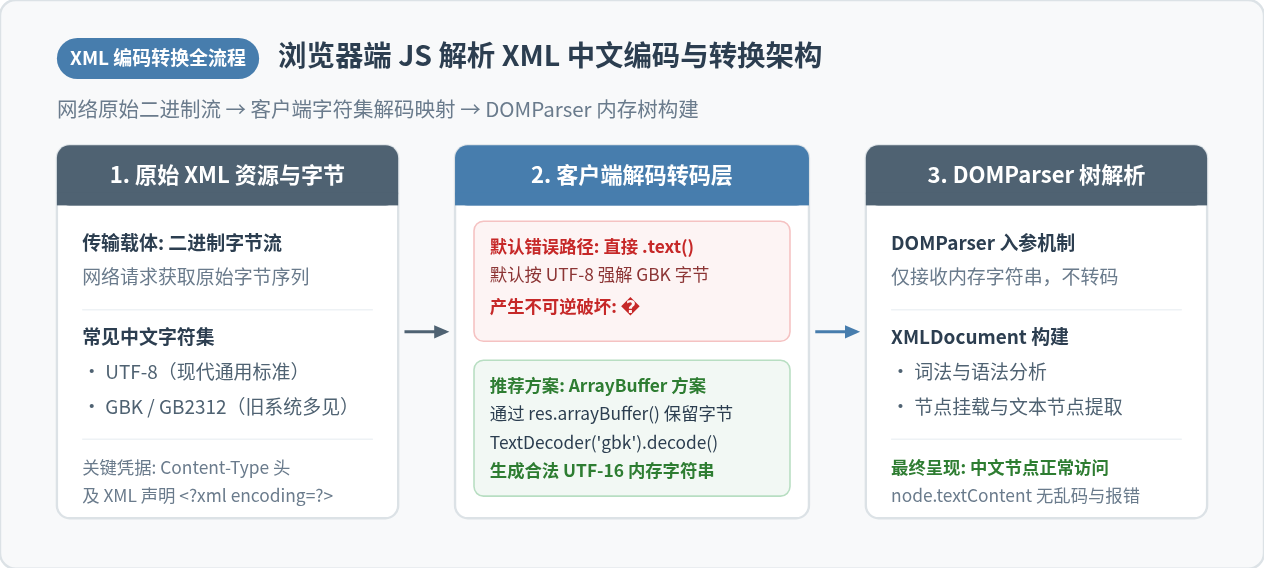
图 0:浏览器端 XML 数据流转、字符集解码映射与 DOMParser 内存构建架构
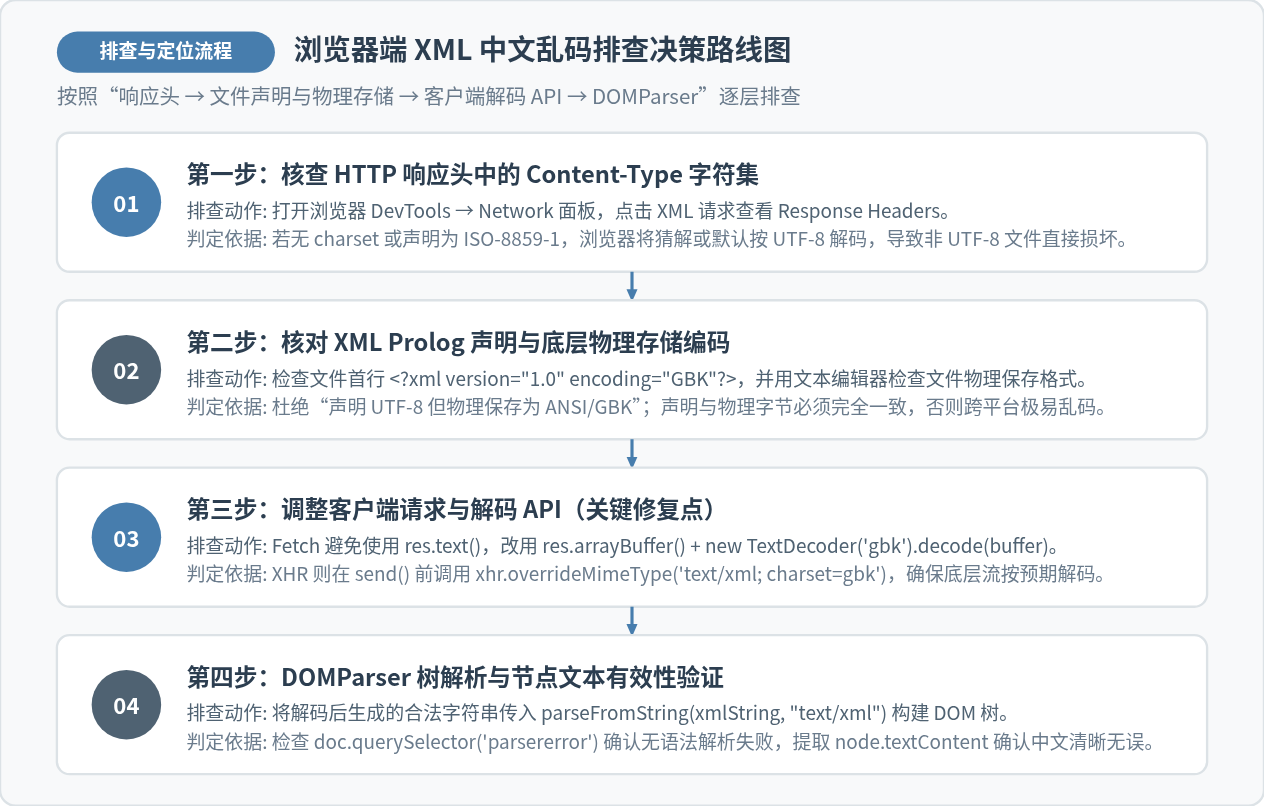
图 1:浏览器端 XML 中文乱码排查决策四步路线图
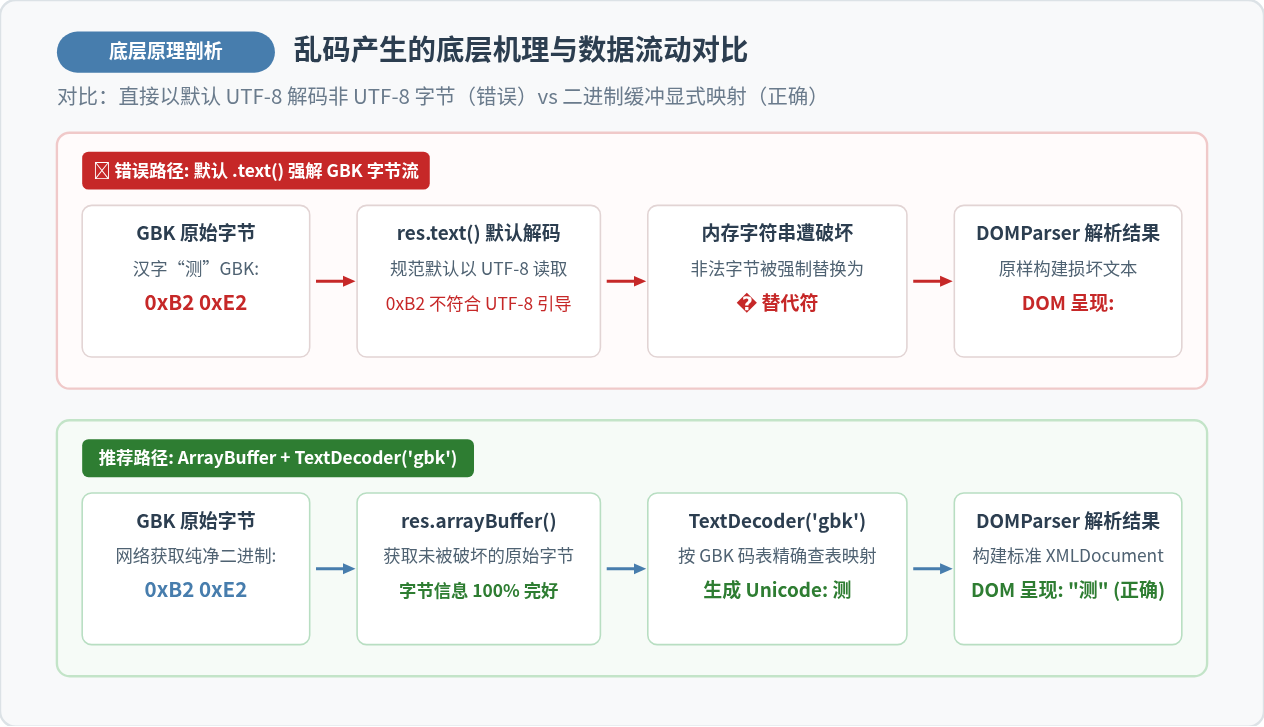
图 2:乱码发生的底层机理与数据流转对比示意图
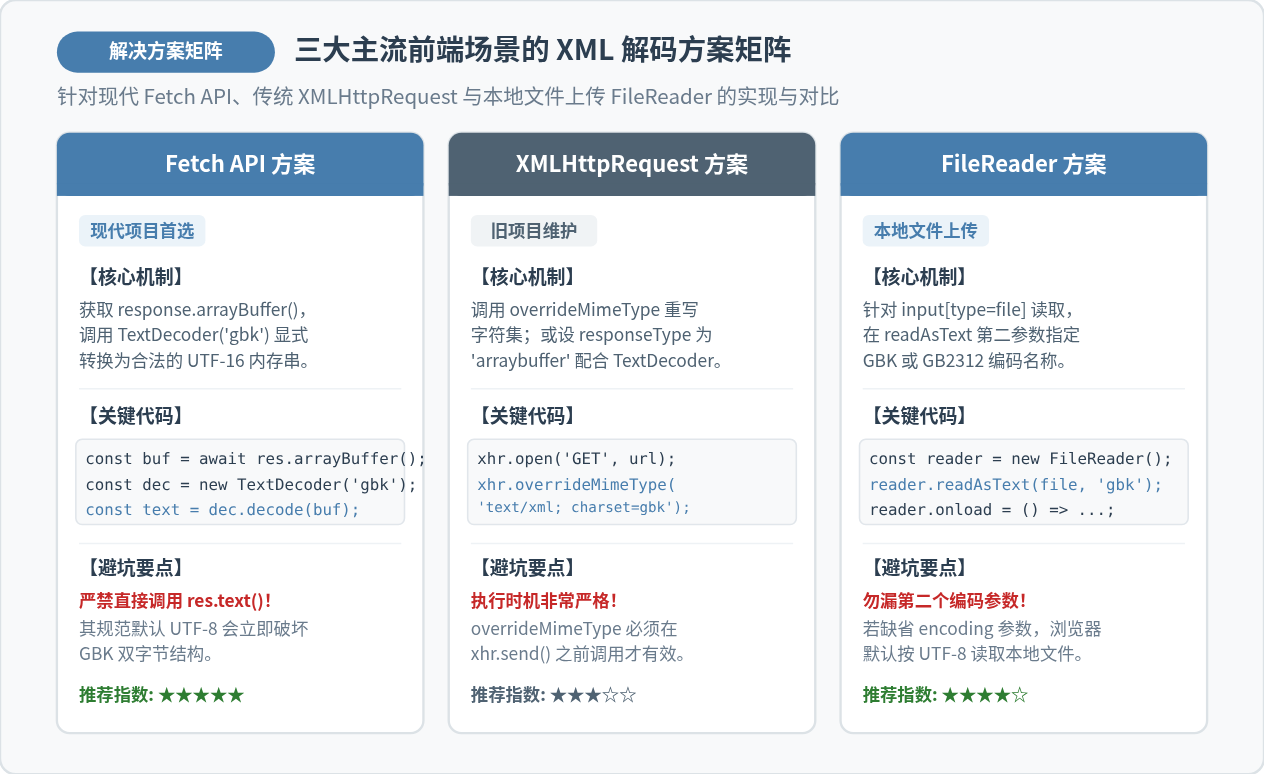
图 3:三大主流前端场景(Fetch API、XMLHttpRequest、FileReader)的 XML 解码技术方案矩阵
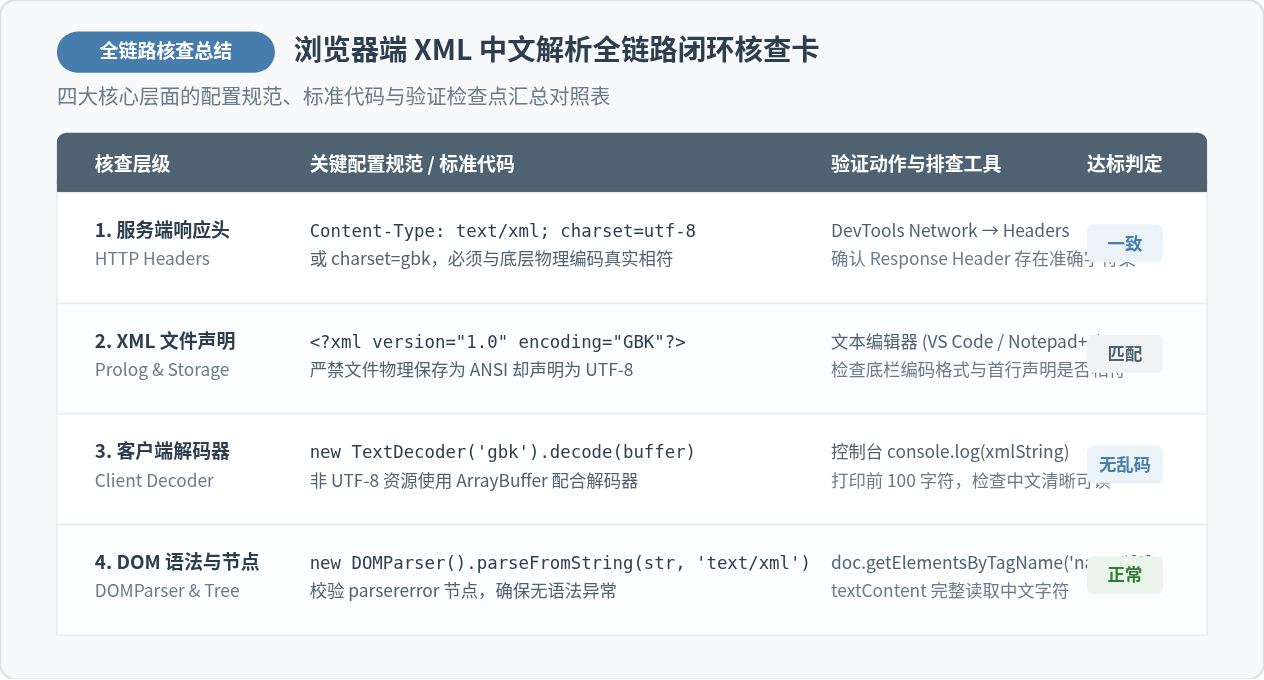
图 4:浏览器端 XML 中文解析全链路闭环核查卡
适用场景: Web 前端 / 接口对接 / 本地文件处理
关键技术: DOMParser / TextDecoder / ArrayBuffer / XHR
浏览器端使用 JavaScript 解析 XML 出现中文乱码,核心诱因并非 DOMParser 内部解析器损坏了内容,而是在网络传输或本地文件读取的二进制字节流转换为 JavaScript 内存字符串的过程中,采用了不匹配的字符编码规则(最常见的是将 GBK/GB2312 编码的字节流默认当作 UTF-8 进行强行解码)。解决该问题的标准路径是:在字符转换阶段截获纯净的二进制字节流(ArrayBuffer),借助标准 TextDecoder API 显式按源文件字符集将其解码为合法的 UTF-16 内存字符串,再交由 DOMParser 进行树结构解析;若使用传统 XMLHttpRequest,则在请求发送前通过 overrideMimeType 强制纠正 MIME 字符集。下文将完整梳理乱码根因、四步排查流程、主流场景实现方案与验证清单。
一、乱码现象判定与四步排查法
面对中文乱码时,首先需要通过乱码的具体形态快速判断故障发生的阶段。在浏览器环境下,中文乱码主要呈现为两种截然不同的形态:
-
黑色菱形问号或普通问号(如
�或???):这是最典型的“不可逆字节破坏”。产生原因是服务端下发的 XML 文件底层采用 GBK 或 GB2312 编码(每个汉字占 2 个字节),但前端使用fetch().text()或未指定字符集的方式直接读取。由于 GBK 的双字节序列违反了 UTF-8 的前导位字节规范,浏览器的 UTF-8 解码引擎将其判定为非法字节,强制用 Unicode 替换字符�(即黑色菱形问号)代替。一旦字节被替换,后续无论如何转换字符串都无法恢复原始内容。 -
形如“äýúã”或“计算机”的西欧多字节乱码:这种现象通常被称为 Mojibake。产生原因是源文件本身是合法的 UTF-8 编码,但在传输或解析时,HTTP 响应头中声明了
ISO-8859-1(Latin-1)或Windows-1252,导致浏览器将原本代表一个汉字的 3 个 UTF-8 字节,误当作 3 个独立的单字节拉丁字符分别显示。
理解了乱码形态后,切忌盲目尝试各种 encodeURI 或字符串替换黑魔法。应当按照标准排查路线图逐层核验:
依据图 1 所示,排查应严格遵循以下顺序推进:
-
检查网络响应头(HTTP Response Headers):打开浏览器 DevTools 的 Network 面板,定位请求的 XML 文件,查看
Content-Type响应头。注意其是否包含charset=...。若服务端未提供或提供了错误的字符集声明,浏览器将启用缺省逻辑导致解析偏差。 -
核验 XML 声明与物理保存格式:检查 XML 文件首行是否有
<?xml version="1.0" encoding="GBK"?>。更重要的是使用文本编辑器(如 VS Code)查看文件底栏显示的真实存储编码,确认是否存在“声明为 UTF-8 但文件物理存储为 ANSI/GBK”的编码分裂情况。 - 调整客户端接收与解码方式:避免直接调用预设了 UTF-8 的便捷方法。改用保留原始字节的 API 获取二进制缓冲,再按真实编码进行解码。
-
DOMParser 解析与语法检验:将解码完成的合法字符串交付
DOMParser,并通过 DOM API 提取节点文本确认内容复原。
二、深入底层:为什么 DOMParser 救不了已乱码的字符串
许多开发者在遇到乱码时,常试图在 DOMParser 上寻找配置项,比如期望传参指定编码,或者寄希望于 XML 内部的 encoding="GBK" 声明能让解析器自动修正。然而,这种理解脱离了浏览器 JavaScript 的内存模型。
DOMParser.prototype.parseFromString(str, mimeType) 方法接收的第一个参数是一个已经存在于 JavaScript 虚拟机内存中的字符串。在 JavaScript 规范中,所有内存字符串都采用 UTF-16 编码表示。当调用该方法时,“从字节流到字符”的解码动作早已由网络层或文件读取层执行完毕。
如图 2 所示,如果上游网络请求在读取阶段就误把 GBK 字节按 UTF-8 解释,传入 DOMParser 的字符串本身就已经是包含 � 的坏串。DOMParser 作为语法分析器,仅负责将传入的字符构建为标签树,无法逆向推测损坏前的原始字节。因此,解决乱码的关键控制点必须前移至“获取原始字节并实施正确解码”的环节。
三、方案一:Fetch API 结合 TextDecoder 解析非 UTF-8 XML(推荐方案)
在现代 Web 应用中,fetch 是主流的网络请求方式。由于 response.text() 在规范中强制默认使用 UTF-8,当遇到 GBK、GB2312 或 Big5 编码的 XML 时,必须调用 response.arrayBuffer() 读取纯净的二进制流,再实例化 TextDecoder 显式指定编码进行转换。
1. 基础实现代码
/**
 * 请求并解析 GBK 编码的 XML 资源
 * @param {string} url - 目标 XML 文件或接口地址
 * @returns {Promise<XMLDocument>} 解析后的 XML DOM 对象
 */
async function fetchAndParseGbkXml(url) {
  // 1. 发起网络请求获取响应对象
  const response = await fetch(url);
  if (!response.ok) {
    throw new Error(`网络请求失败: HTTP ${response.status}`);
  }

  // 2. 核心操作: 获取未受字符集污染的二进制 ArrayBuffer,切勿调用 response.text()
  const buffer = await response.arrayBuffer();

  // 3. 显式使用 gbk 字符集解码器将字节映射为标准的 JavaScript UTF-16 字符串
  const decoder = new TextDecoder('gbk');
  const xmlString = decoder.decode(buffer);

  // 4. 将正确解码的字符串交由 DOMParser 进行 XML 树结构解析
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlString, 'text/xml');

  // 5. 校验是否存在 XML 语法解析异常 (如未闭合标签等)
  const parserError = xmlDoc.querySelector('parsererror');
  if (parserError) {
    throw new Error(`XML 语法解析失败: ${parserError.textContent}`);
  }

  return xmlDoc;
}

// 执行调用示例
fetchAndParseGbkXml('/api/data-gbk.xml')
  .then(xmlDoc => {
    const items = xmlDoc.getElementsByTagName('item');
    console.log('解析成功,第一项标题:', items[0].getAttribute('name'));
    console.log('中文内容:', items[0].textContent);
  })
  .catch(err => {
    console.error('解析流程异常:', err);
  });
2. 健壮的自适应字符集解析函数
在生产环境中,有时接口下发的编码可能是动态的(既可能有 UTF-8,也可能有 GBK)。我们可以编写一个通用的自适应解析器,优先读取响应头的 charset,若未指定则预读 XML 声明中的 encoding,最后以 UTF-8 兜底:
/**
 * 自适应字符集的 XML 请求与解析器
 * @param {string} url - XML 资源地址
 * @returns {Promise<XMLDocument>}
 */
async function fetchXmlAdaptive(url) {
  const res = await fetch(url);
  const buffer = await res.arrayBuffer();

  // 1. 尝试从 HTTP 响应头的 Content-Type 中提取 charset
  let charset = 'utf-8';
  const contentType = res.headers.get('content-type');
  if (contentType) {
    const match = contentType.match(/charset=([^;]+)/i);
    if (match && match[1]) {
      charset = match[1].trim().toLowerCase();
    }
  }

  // 2. 如果响应头未声明字符集,预读前 200 字节探查 XML Prolog 中的 encoding
  if (charset === 'utf-8') {
    const probeView = new Uint8Array(buffer.slice(0, 200));
    const probeStr = String.fromCharCode(...probeView);
    const prologMatch = probeStr.match(/<\?xml[^>]*encoding=["']([^"']+)["']/i);
    if (prologMatch && prologMatch[1]) {
      charset = prologMatch[1].trim().toLowerCase();
    }
  }

  // 3. 采用确定的字符集执行解码
  const decoder = new TextDecoder(charset);
  const xmlString = decoder.decode(buffer);

  // 4. 解析为 DOM
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlString, 'text/xml');
  const parserError = xmlDoc.querySelector('parsererror');
  if (parserError) {
    throw new Error(`XML 语法错误: ${parserError.textContent}`);
  }

  return xmlDoc;
}
四、方案二:XMLHttpRequest 场景下的重写 MIME 与二进制读取
在需要维护既有项目或使用第三方基于 XHR 封装的库时,可以通过 xhr.overrideMimeType 或 responseType = 'arraybuffer' 解决乱码。
方式 A:使用 overrideMimeType 强制重写字符集(简便高效)
XMLHttpRequest 提供了原生重写响应类型的接口。通过在发送请求前强制将字符集设定为目标编码,浏览器在填充 xhr.responseXML 时就会依据该编码进行双字节解析。
function loadXmlWithOverrideMime(url, charset = 'gbk') {
  return new Promise((resolve, reject) => {
    const xhr = new XMLHttpRequest();
    xhr.open('GET', url, true);

    // 注意:overrideMimeType 必须严格在 open() 之后、send() 之前调用!
    xhr.overrideMimeType(`text/xml; charset=${charset}`);

    xhr.onload = function() {
      if (xhr.status >= 200 && xhr.status < 300) {
        // 如果正确设置了 charset,浏览器生成的 responseXML 将包含正常中文
        const xmlDoc = xhr.responseXML;
        if (!xmlDoc) {
          reject(new Error('未能生成合法 XMLDocument'));
          return;
        }
        resolve(xmlDoc);
      } else {
        reject(new Error(`HTTP 异常: ${xhr.status}`));
      }
    };

    xhr.onerror = () => reject(new Error('网络通信发生故障'));
    xhr.send();
  });
}
注意事项:调用
xhr.overrideMimeType 的时间点非常严苛,必须在 open() 之后、send() 之前执行。一旦调用过晚,底层的网络数据缓冲可能已经开始按照缺省规则解析,导致重写失效。
方式 B:XHR 配合 ArrayBuffer 与 TextDecoder(稳健推荐)
如果在部分特殊宿主环境(如某些移动端内嵌 WebView)中 overrideMimeType 对 responseXML 的支持不一致,最稳妥的做法是将 xhr.responseType 设为 'arraybuffer',手动交由 TextDecoder 和 DOMParser:
function loadXmlWithXhrBuffer(url, charset = 'gbk') {
  return new Promise((resolve, reject) => {
    const xhr = new XMLHttpRequest();
    xhr.open('GET', url, true);
    xhr.responseType = 'arraybuffer'; // 获取原始二进制

    xhr.onload = function() {
      if (xhr.status >= 200 && xhr.status < 300) {
        const decoder = new TextDecoder(charset);
        const xmlText = decoder.decode(xhr.response);
        const xmlDoc = new DOMParser().parseFromString(xmlText, 'text/xml');
        resolve(xmlDoc);
      } else {
        reject(new Error(`请求失败: ${xhr.status}`));
      }
    };

    xhr.onerror = () => reject(new Error('网络异常'));
    xhr.send();
  });
}
五、方案三:本地文件上传(FileReader)场景下的中文处理
另一种常见的业务场景是用户在浏览器中通过 <input type="file" accept=".xml"> 上传本地 XML 文件,前端直接解析展示内容。如果用户上传的文件是采用 GBK 保存的,若直接调用 reader.readAsText(file),同样会出现中文乱码。
本地文件读取的完整实现
FileReader.prototype.readAsText(blob, encoding) 提供了第二个可选参数 encoding。当未提供时,浏览器默认使用 UTF-8;对于中文 GBK 文件,显式传入 'gbk' 或 'gb2312' 即可:
// 绑定文件输入控件事件
document.getElementById('xmlFileInput').addEventListener('change', function(event) {
  const file = event.target.files[0];
  if (!file) return;

  const reader = new FileReader();

  // 关键操作: 第二个参数显式指定编码为 'gbk'
  reader.readAsText(file, 'gbk');

  reader.onload = function(e) {
    const xmlContent = e.target.result;
    const parser = new DOMParser();
    const xmlDoc = parser.parseFromString(xmlContent, 'text/xml');

    const errorNode = xmlDoc.querySelector('parsererror');
    if (errorNode) {
      console.error('本地 XML 解析失败:', errorNode.textContent);
      return;
    }

    console.log('本地 XML 解析成功,根节点:', xmlDoc.documentElement.nodeName);
  };

  reader.onerror = function() {
    console.error('读取本地文件失败:', reader.error);
  };
});
六、服务端与文件源头协同配置规范
前端的各种转码与防御性代码属于下游补救措施。从软件工程角度,彻底杜绝乱码的最优解是在文件生成与网络响应层做好规范化协同:
-
服务端明确下发 charset 响应头:无论 XML 实际采用何种编码,服务端均应在
Content-Type中明确附带该字符集,例如Content-Type: text/xml; charset=utf-8或Content-Type: application/xml; charset=gbk。
以 Nginx 配置静态 XML 服务为例:
以 Node.js / Express 接口为例:location ~* \.xml$ { charset utf-8; add_header Content-Type "text/xml; charset=utf-8"; }app.get('/api/xml-data', (req, res) => { res.setHeader('Content-Type', 'application/xml; charset=utf-8'); res.send(xmlContentBufferOrString); }); -
保证物理存储与声明绝对统一:如果 XML 首行声明为
<?xml version="1.0" encoding="UTF-8"?>,在磁盘保存时必须确保文件是以无 BOM 的 UTF-8 格式存储。严禁在 Windows 记事本中以“ANSI”格式保存却在 XML 声明中写encoding="UTF-8"。
七、全链路排查验证与落地总结
为了确保修改后的代码在不同网络环境和浏览器版本中都能稳定运作,可以通过下表梳理的核查卡进行全流程自检与验证:
| 核查环节 | 核心检查项与规范 | 排查验证工具与方法 | 合格判定 |
|---|---|---|---|
| 1. 网络传输层 | HTTP 响应头包含明确的 Content-Type: ...; charset=... |
DevTools → Network → Headers 栏目 | 字符集与文件实际编码相符 |
| 2. 源文件存储层 | 物理文件保存编码与文件头部 XML Prolog 声明完全匹配 | VS Code 底栏编码显示 / file -i filename.xml |
无“声明 UTF-8 实际为 ANSI”冲突 |
| 3. 客户端解码层 | 非 UTF-8 资源使用 res.arrayBuffer() + TextDecoder |
控制台执行 console.log(decodedString.slice(0, 100)) |
字符串输出中文清晰,无 � |
| 4. DOM 构建层 | DOMParser.parseFromString(str, 'text/xml') 构建 |
检测 doc.querySelector('parsererror') 是否为空 |
无语法报错,textContent 取值正确 |
总结而言,解决浏览器端 JS 解析 XML 中文乱码的核心思路在于:切断错误解码链路,将字符集的控制权收回前端应用层。只要在底层数据还是二进制字节流(ArrayBuffer)的阶段,使用正确的字符集(如 TextDecoder('gbk'))将其还原为合法的 JavaScript 内存字符串,后续的 DOMParser 就能自然无误地构建出完美的 XML DOM 树。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章