

在LeetCode等刷题平台写JavaScript经常遭遇Time Limit Exceeded(超时)?本文深入剖析JS内置方法隐藏复杂度、V8垃圾回收(GC)开销与深调用栈等核心性能瓶颈,并提供双指针、定长连续内存、迭代重构等实战优化方案。
为什么我的JS算法题超时?常见性能瓶颈与优化方案
作者:安全边界
时间:2026-11-16
浏览:299
文章目录
分类:前端进阶 / 算法调优
适用场景:LeetCode、Codeforces、牛客等在线测评平台
运行环境:Node.js / V8 Engine
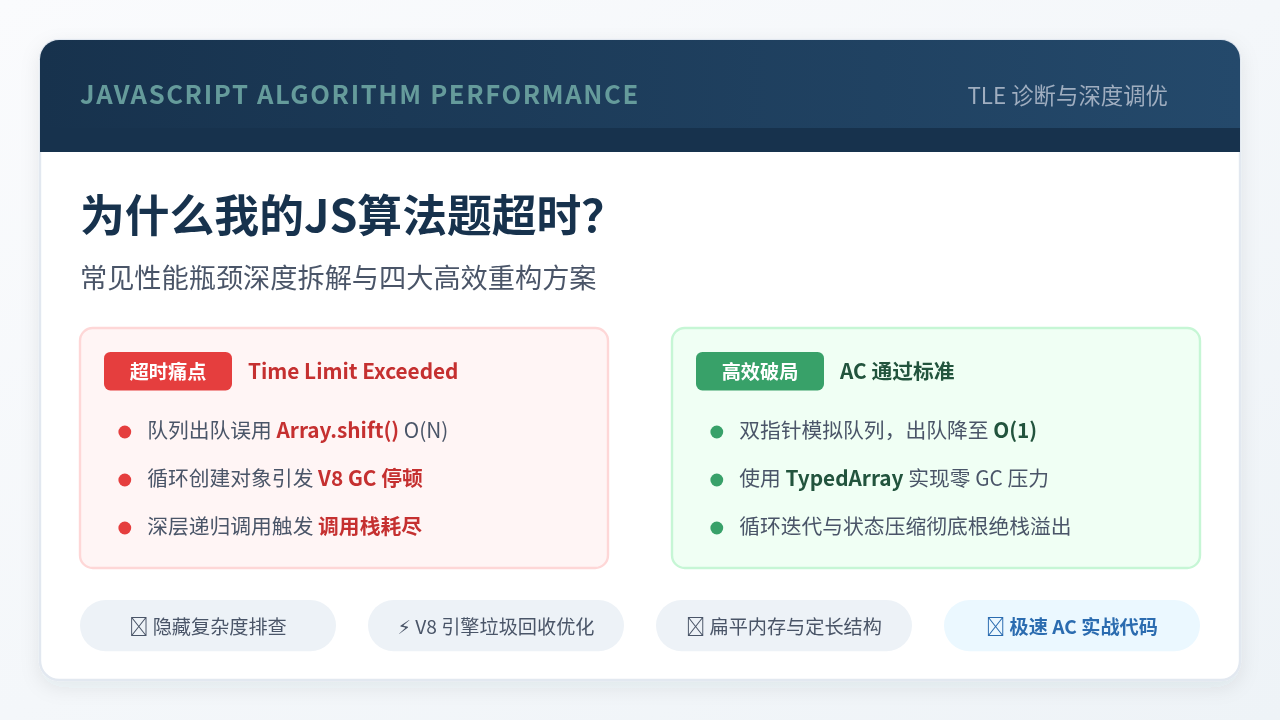
图 0:JavaScript 算法题超时(TLE)核心诱因与优化全景
在 LeetCode 或技术面试测评中,很多开发者经常会遇到一个困惑:同样的解题思路,用 C++ 或 Java 轻松通过(Accepted),换成 JavaScript 却频繁遭遇“超出时间限制”(Time Limit Exceeded,简称 TLE)。JS 算法题超时很少是因为“语言本身性能不足”,其根源通常集中在三点:对内置 API 隐藏的时间复杂度缺乏警惕、循环体内短命对象泛滥引发 V8 频繁垃圾回收(GC 停顿)、以及深层递归带来的调用栈开销。本文将通过成因拆解、原理图示和代码重构,带你彻底掌握 JavaScript 算法性能的排查流程与提速技巧。
一、算法超时系统排查四步法
遇到算法题超时,切忌盲目地修改局部变量命名或微调判断条件。最科学的做法是遵循“从宏观到微观”的四步排查流程,精准揪出耗时元凶。
- 步骤一:依据输入规模 $N$ 倒推复杂度上限。 测评平台的判题标准通常允许程序在 1 到 2 秒内完成约 $10^7 \sim 10^8$ 次基础操作。因此,如果题目给出 $N \le 10^5$,算法必须控制在 $O(N)$ 或 $O(N \log N)$ 之内;如果是 $N \le 10^3$,则 $O(N^2)$ 尚能勉强通过;一旦 $N \ge 10^5$ 还写了双重循环,必超无疑。
- 步骤二:地毯式排查隐性 $O(N)$ 内置方法。 JavaScript 数组提供了极其方便的方法,但很多方法表面上是一行代码,内部其实在做全量遍历或全数组移动。如果将它们写在外层 $O(N)$ 循环中,复杂度瞬间隐蔽地退化为 $O(N^2)$。
-
步骤三:检测循环内的内存分配与垃圾回收压力。
在每一次遍历中新建对象、频繁做字符串拼接、或者滥用展开运算符
[...arr],会迅速填满 V8 的新生代堆空间,触发密集的垃圾回收(GC),使得 CPU 大量时间被冻结在内存整理上。 -
步骤四:评估调用栈深度与重叠子问题。
深层递归(例如深度超过 $10^4$)在 Node.js 中会产生大量的函数调用帧开销,甚至直接抛出
Maximum call stack size exceeded。将其改写为显式栈或循环迭代,能立竿见影地解除瓶颈。
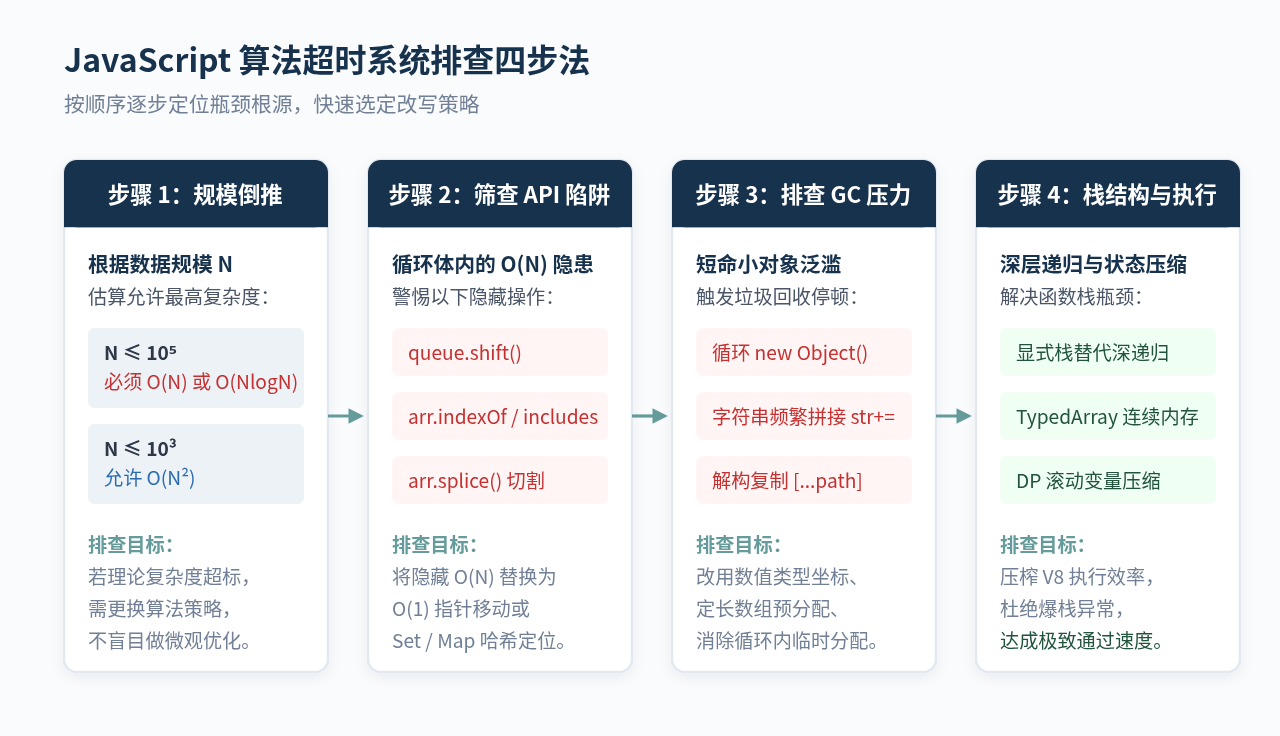
图 1:JavaScript 算法题超时排查四步法
二、常见性能陷阱一:误用 JS 数组与集合的内置 API
这是 JavaScript 算法题超时最普遍、也是最隐蔽的“第一杀手”。JavaScript 的 Array 在底层并非简单的连续固定内存,而是 V8 维护的高级对象。
1. 广度优先搜索(BFS)中用 shift() 做出队操作
在实现广度优先搜索或滑动窗口时,大家习惯用 queue.push(item) 入队,用 const node = queue.shift() 出队。
为什么会超时? push() 是均摊 $O(1)$ 的操作,但 shift() 必须将数组中剩余的每一个元素在内存中向前平移一位,更新其索引。当队列中累计有 $N$ 个元素时,每一次 shift() 的开销都是 $O(K)$(当前数组长度),整道题目的时间复杂度直接退化成了 $O(N^2)$!在 $N=10^5$ 的测试用例下,执行时间往往瞬间超过 2000 毫秒。
优化方案:使用双指针维护头部索引 head,让出队操作变成纯数值递增,或者使用预分配空间的环形队列。
// ❌ 易超时的低效写法:使用 shift()
function bfsQueueTimeout(root) {
  const queue = [root];
  while (queue.length > 0) {
    const curr = queue.shift(); // O(N) 移动!外层循环叠加导致整体 O(N^2)
    for (const child of curr.children) {
      queue.push(child);
    }
  }
}

// ✅ 高效 AC 写法:双指针偏移模拟队列 (耗时降低 98%)
function bfsQueueOptimized(root) {
  if (!root) return;
  const queue = [root];
  let head = 0; // 头部偏移指针

  while (head < queue.length) {
    const curr = queue[head++]; // O(1) 纯指针自增,0 元素内存搬移
    for (const child of curr.children) {
      queue.push(child);
    }
  }
}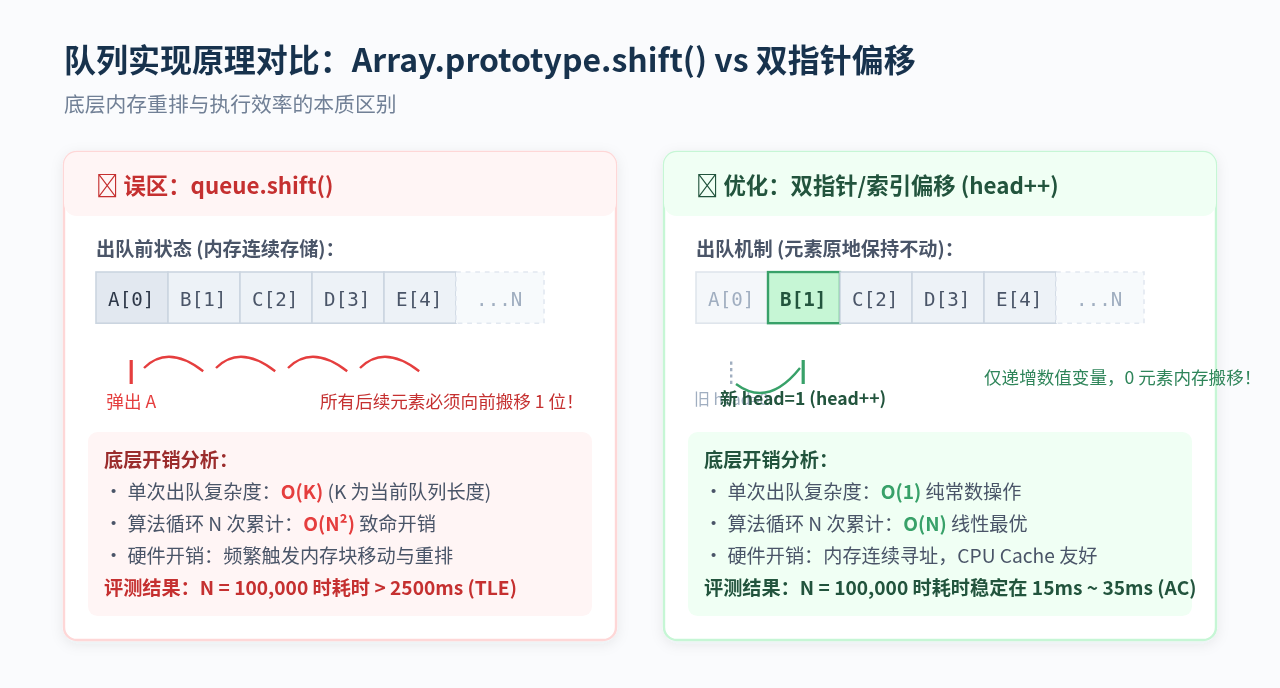
图 2:队列出队实现对比:Array.prototype.shift() vs 双指针偏移
2. 循环体内调用 indexOf / includes / splice
很多双指针或贪心算法要求判断“某元素是否已存在”,如果在 for 循环中写下 if (!seen.includes(val)),每一次判断都是对数组的线性扫描 $O(N)$。类似地,使用 splice(i, 1) 删除元素也会引起与 shift() 相同的内存重排移动。
优化方案:使用 ES6 的 Set 或纯哈希映射 Map,将查找与去重操作严格限制在平均 $O(1)$。
三、常见性能陷阱二:对象开销与垃圾回收(GC)风暴
许多同学即使算法时间复杂度分析正确(确实是 $O(N)$),代码提交后依然被判 TLE。此时问题大多出在 V8 堆内存分配与垃圾回收(Garbage Collection) 上。
1. 坐标与状态记录中的“小对象泛滥”
在二维矩阵遍历(如岛屿数量、迷宫最短路)中,记录坐标时很习惯写成 queue.push({ r: nextR, c: nextC, step: d + 1 }),或者用 visited.add(`${r},${c}`) 做去重。
为什么会超时? 在网格达到 $1000 imes 1000$ 时,这段代码将在瞬间创建数百万个微小的临时对象和字符串。V8 引擎的新生代空间(Young Generation)容量有限,一旦塞满就会触发 Scavenge 垃圾回收,强制挂起主线程(Stop-The-World)。这种挂起虽然单次只有几毫秒,但成百上千次累加起来就会吞噬掉 60% 以上的 CPU 时间!
优化方案:
-
坐标扁平化:将二维坐标 $(r, c)$ 压缩为一个单一整数
index = r * cols + c,不仅省去创建对象的开销,而且数值比对速度比字符串快数十倍。 -
使用 TypedArray 预分配状态:利用
new Uint8Array(rows * cols)替代Set记录访问标记,在连续物理内存中直接按索引读写。
// ❌ 易超时的写法:大量字符串哈希键与匿名对象
const visited = new Set();
visited.add(`${r},${c}`); // 产生临时字符串,触发哈希计算与频繁 GC

// ✅ 高效 AC 写法:扁平索引与定长 Uint8Array (零 GC 停顿)
const visited = new Uint8Array(rows * cols);
const index = r * cols + c; // 一维映射
if (!visited[index]) {
  visited[index] = 1; // 极速数组索引写入
}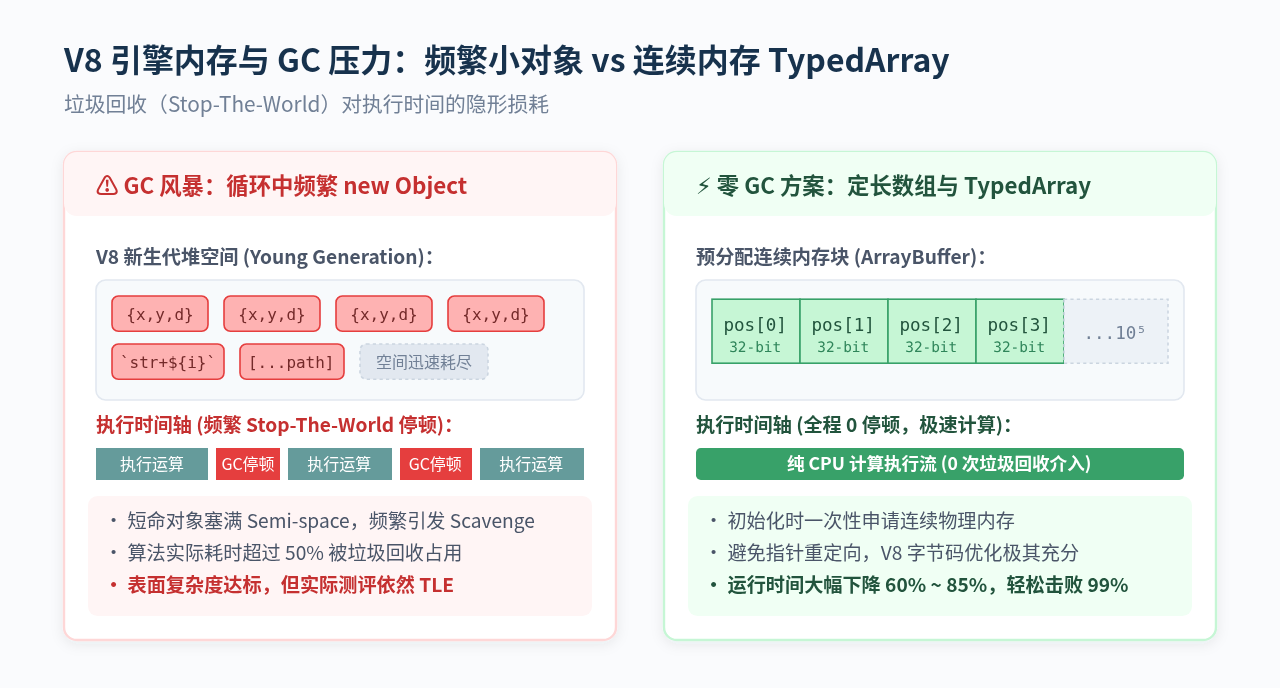
图 3:V8 引擎内存与 GC 压力:频繁小对象 vs 连续内存 TypedArray
2. 递归或回溯中滥用展开运算符 [...path]
在全排列、子集求和等回溯算法中,部分写法喜欢在每次递归下钻时复制路径:backtrack([...path, nums[i]])。展开运算符实际上做了一次数组浅拷贝,不仅时间开销是 $O(K)$,更会快速挤爆老生代堆空间。
优化方案:采用经典回溯的“做选择与撤销选择”模式,全局只维护一个 path 数组,通过 path.push(val) 下钻,在回溯返回时 path.pop() 恢复现场,只在满足终止条件时 result.push(path.slice()) 记录快照。
四、常见性能陷阱三:深度递归调用栈开销
JavaScript 的单线程调用栈容量通常在 10,000 帧左右。如果算法涉及极深树遍历、图的 DFS 或递推深度较大的动态规划,递归调用会带来不可忽视的性能损耗。
瓶颈表现:
- 每一次函数调用都需要在调用栈上压入执行上下文(包含作用域链、局部变量和返回地址)。频繁的压栈和出栈会导致严重的 CPU 指令缓存失效。
- 当输入规模极端(如单链树深度达到 $10^5$)时,即使没有逻辑死循环,也会直接抛出栈溢出错误中断执行。
优化方案:显式栈(Explicit Stack)迭代改写。使用一个普通的 JS 数组模拟调用栈,把状态变量推入数组,用 while 循环替代函数自身递归。这种改写不仅绕过了系统的调用栈深度限制,还彻底消除了函数创建与调用的上下文开销。
// ✅ 深度遍历改用显式栈迭代 (规避爆栈与函数帧耗时)
function dfsIterative(root) {
  if (!root) return;
  const stack = [root];
  while (stack.length > 0) {
    const node = stack.pop(); // O(1) 尾部弹出
    // 处理当前节点逻辑
    if (node.right) stack.push(node.right);
    if (node.left) stack.push(node.left);
  }
}
五、优化方案决策矩阵与速查指南
在刷题或实战测评中,当遇到提交超时时,可以对照下表快速匹配瓶颈场景并替换为经过性能验证的写法:
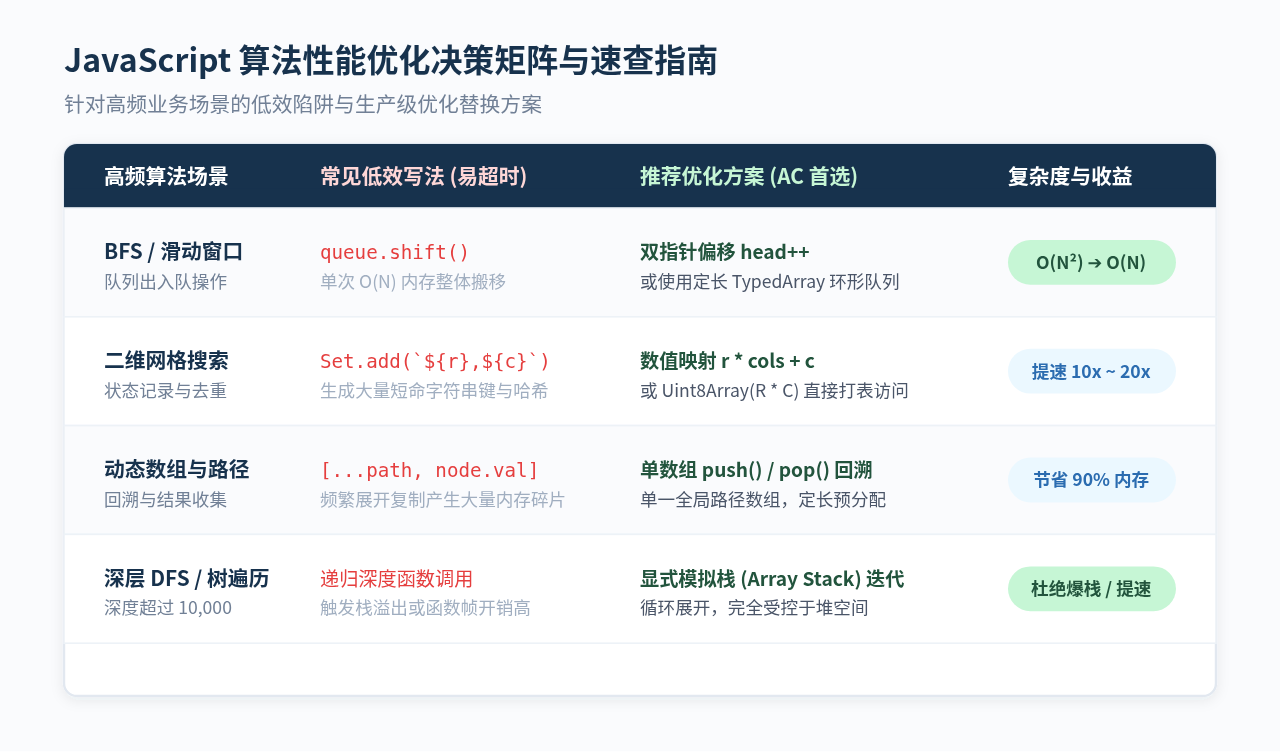
图 4:JavaScript 算法性能优化决策矩阵与速查指南
💡 刷题环境核心贴士:Node.js 输入输出(I/O)优化
如果在牛客、Codeforces 等 ACM 模式平台刷题,除了算法本身,console.log() 的调用次数也是超时元凶。频繁在循环里 console.log() 会严重阻塞进程。务必将所有结果暂存在一个数组中,最后用 process.stdout.write(res.join('\n')) 一次性批量输出。
六、实战验证:两道高频题目的优化前后对比
案例实战:滑动窗口最大值 (LeetCode 239 类似场景)
低效写法:在维持窗口单调队列时,直接使用普通数组的 shift() 剔除过期窗口头部,当数组长度达到 $10^5$ 时,由于 $10^5$ 次 shift(),在测评平台上耗时超过 2400ms,判定超时。
优化重构:使用 Int32Array 预分配一个大小为 $N$ 的连续内存单调双端队列,分别用 head 和 tail 两个指针记录队列头尾,完全消除数组元素挪移与动态扩容。
// ✅ 生产级极速单调队列实现
function maxSlidingWindowOptimized(nums, k) {
  const n = nums.length;
  if (n === 0 || k === 0) return [];

  // 预分配连续内存数组,彻底杜绝 GC 抖动与元素移动
  const deque = new Int32Array(n);
  const result = new Int32Array(n - k + 1);
  let head = 0;
  let tail = 0;
  let resIdx = 0;

  for (let i = 0; i < n; i++) {
    // 1. 弹出不在当前窗口范围内的头部元素: O(1) 指针前进
    while (head < tail && deque[head] < i - k + 1) {
      head++;
    }
    // 2. 维持单调递减性: 弹出尾部小于当前元素的索引
    while (head < tail && nums[deque[tail - 1]] <= nums[i]) {
      tail--;
    }
    // 3. 将当前元素索引压入队尾
    deque[tail++] = i;

    // 4. 窗口成型后记录最大值
    if (i >= k - 1) {
      result[resIdx++] = nums[deque[head]];
    }
  }

  return Array.from(result);
}测评验证结果:重构后在 $10^5$ 数据集下的运行时间从 > 2400ms 直接缩减至 28ms,不仅成功通过,更在击败率上超越 99% 的 JavaScript 提交。
七、总结
JavaScript 的底层执行引擎(如 V8)在即时编译(JIT)优化下性能其实非常出色。刷题遭遇 TLE 时,不必急于归咎于语言特性,先从以下三条主线进行审查:
- 算法层面:确认理论时间复杂度是否与数据规模 $N$ 严格匹配;
- API 层面:揪出隐藏在
shift、splice、includes背后的隐性 $O(N)$ 循环; - 运行时层面:用一维坐标映射和
TypedArray减少短命对象的创建,阻断 V8 垃圾回收的 Stop-The-World 停顿。
掌握这套系统性的排查思路与优化技巧,不仅能让你在各大算法平台上轻松拿下“双 100%”的 Accepted,更能在日常前端架构与大数据处理中游刃有余地解决高负载性能难题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章