
深入解析如何利用ES6中的Array.prototype.reduce实现一行代码提取JavaScript数组中目标元素出现的所有下标位置,剖析其执行原理、性能权衡与进阶用法。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
用ES6 reduce一行代码获取JavaScript数组元素所有位置
作者:木棉
时间:2026-11-14
浏览:291
文章目录
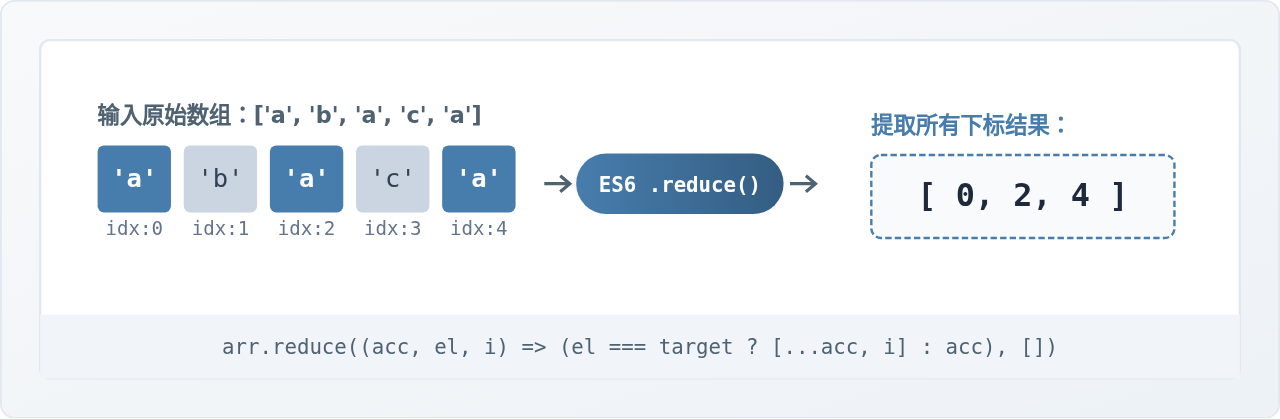
在日常 JavaScript 开发中,原生 Array.prototype.indexOf() 方法仅能返回目标元素在数组中第一次出现的下标位置。如果数组中存在多个重复元素,单次查找就会丢失后续位置。利用 ES6 的 reduce 高阶函数,我们可以用简洁明了的一行代码遍历数组并直接收集全部匹配下标,避免编写繁琐的传统循环。
核心一行代码与运行示例
获取数组中指定元素全部下标最紧凑的 ES6 实现如下:
const getAllIndices = (arr, val) =>
  arr.reduce((acc, el, i) => (el === val ? [...acc, i] : acc), []);
我们传入一个包含多次重复字母的数组进行验证:
const letters = ['a', 'b', 'a', 'c', 'a', 'd'];
const result = getAllIndices(letters, 'a');

console.log(result);
// 示例输出: [0, 2, 4]
当查找目标不存在于数组中时,该函数会直接返回空数组 [],行为严谨安全,无需额外的边界判定分支。
为什么 reduce 能够轻松胜任此任务
Array.prototype.reduce 绝不仅能用来求和。它的回调函数天然支持接收四个参数,而我们正好利用了其中的前三个:
- 累加器 (accumulator, 简称 acc):保存每一步处理后的聚合结果。在此场景下,我们将初始值设定为空数组
[],用它来充当结果收集器。 - 当前元素 (currentValue, 简称 el):遍历过程中当前访问的数组项。
- 当前索引 (currentIndex, 简称 i):当前元素在数组中的下标,这正是我们需要获取的核心数据。
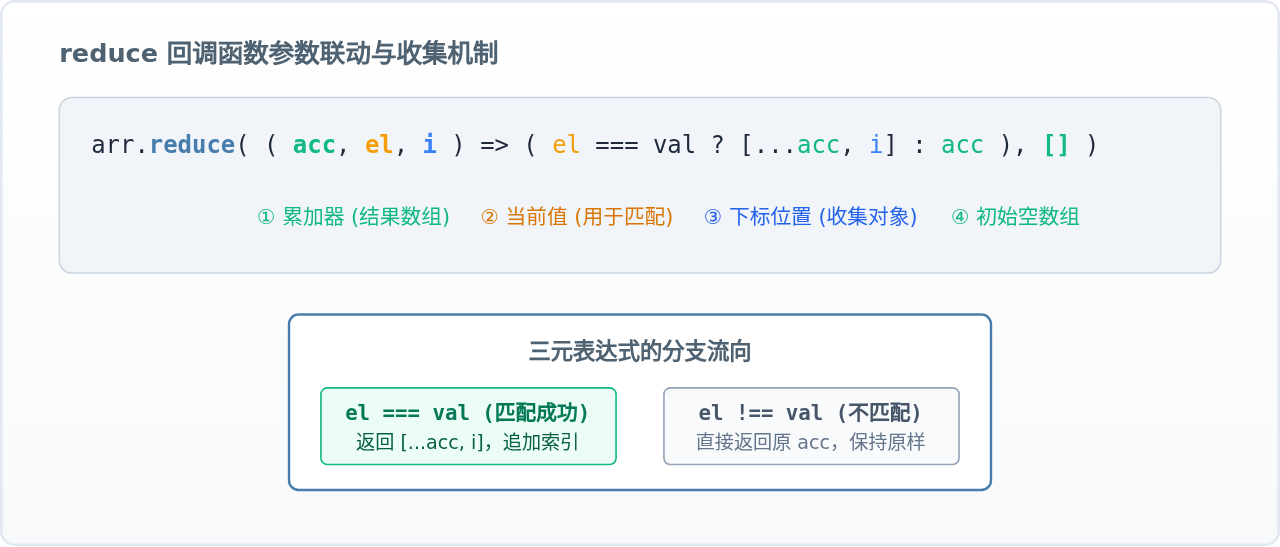
传统使用 filter() 过滤元素时,回调中虽然也能拿到索引 i,但 filter 最终返回的是元素本身的集合,而不是索引;若想用 map() 先把索引映射出来再过滤,就需要经历两次数组完整遍历。而 reduce 把“条件筛选”和“结果聚合”合并在单次遍历中,逻辑极其紧凑。
执行推导:遍历过程中状态如何转移
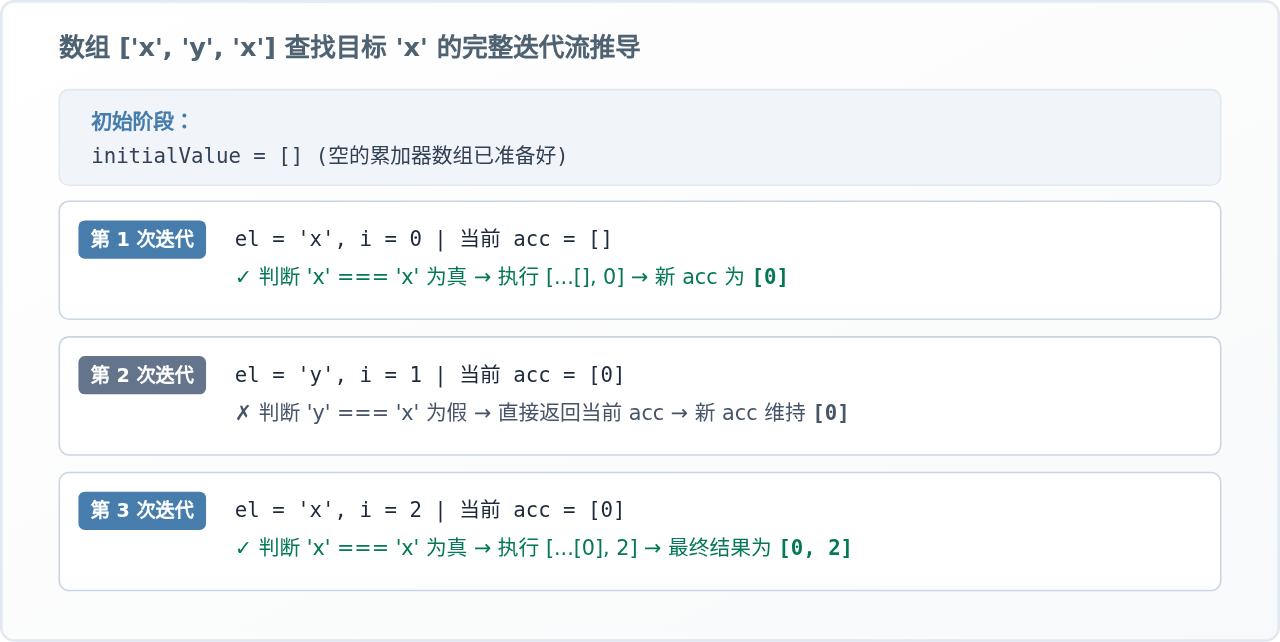
为了直观展现这行代码的工作过程,我们以数组 ['x', 'y', 'x'] 查找 'x' 的完整运行过程为例,追踪累加器在每次迭代时的变化:
性能陷阱与优化变体:展开运算 vs 逗号表达式
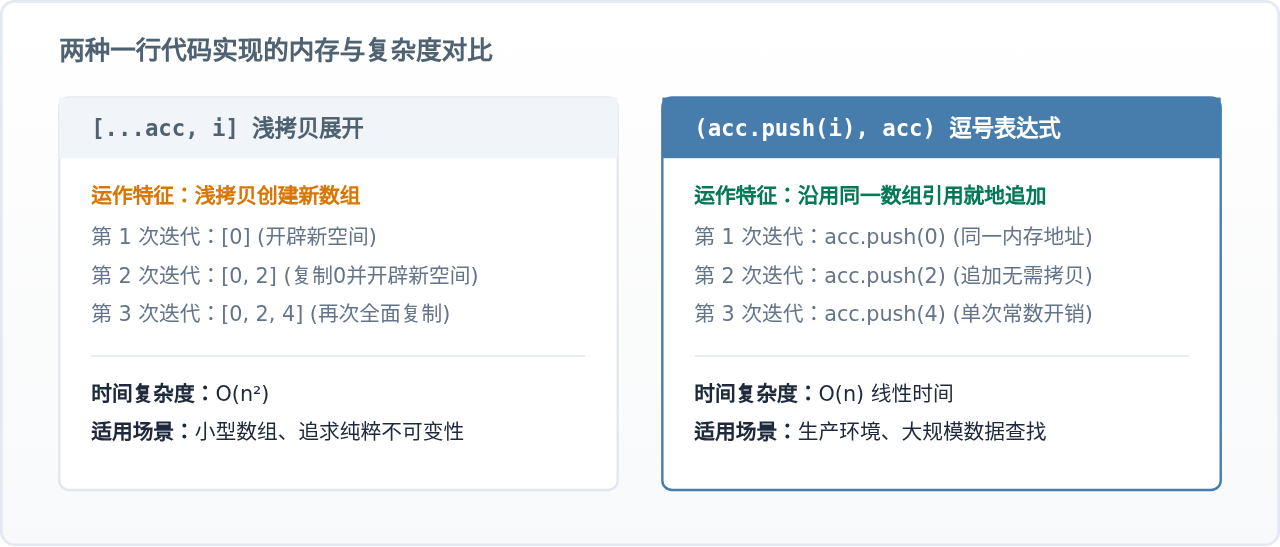
虽然 [...acc, i] 的写法符合函数式编程中“不可变数据(Immutability)”的理念,但在数组长度达到数万或更大规模时,每次扩展运算符都会创建一个新数组并复制原有元素,导致时间复杂度上升至 O(n²),造成额外的内存开销与垃圾回收压力。
如果我们依然追求一行代码的高效实现,可以利用 JavaScript 的逗号操作符或逻辑与短路表达式,改用 push 就地修改累加器:
// 方案 A:逗号表达式(就地追加并返回累加器)
const getAllIndicesFast = (arr, val) =>
  arr.reduce((acc, el, i) => (el === val ? (acc.push(i), acc) : acc), []);

// 方案 B:逻辑与与逗号组合(极致紧凑)
const getAllIndicesCompact = (arr, val) =>
  arr.reduce((acc, el, i) => (el === val && acc.push(i), acc), []);
在逗号表达式 (acc.push(i), acc) 中,JavaScript 会依次执行 push 操作并返回最后一个表达式的值(即 acc 本身)。这样既保证了纯粹的一行箭头函数语法,又将时间复杂度压到了纯线性的 O(n)。
进阶拓展:支持断言函数(Predicate)匹配
实际开发中,我们往往不仅仅需要精确匹配某个基础类型值,还可能需要按条件查找对象属性、数值区间或正则匹配项。将固定比较 el === val 替换为可执行的谓词函数,可以使这行代码更加通用:
// 接受谓词函数的一行通用实现
const findIndicesBy = (arr, predicate) =>
  arr.reduce((acc, el, i) => (predicate(el, i) ? (acc.push(i), acc) : acc), []);

// 示例 1:获取所有偶数的下标
const nums = [10, 15, 20, 25, 30];
console.log(findIndicesBy(nums, n => n % 2 === 0));
// 输出: [0, 2, 4]

// 示例 2:查找特定对象属性的位置
const users = [
  { id: 1, active: true },
  { id: 2, active: false },
  { id: 3, active: true }
];
console.log(findIndicesBy(users, u => u.active));
// 输出: [0, 2]
关于 NaN 与稀疏数组的注意事项:
1. 如果需要查找数组中的 NaN,由于在 JavaScript 中 NaN === NaN 返回 false,直接使用严格相等会漏掉匹配项。应在断言中使用 Number.isNaN() 或 Object.is(el, val)。
2. 原生 reduce 会自动跳过稀疏数组的空槽位(empty slot)。若数组存在 [1, , 1],第 1 个空槽不会触发回调,遍历直接在下标 0 和 2 处触发,这通常完全符合实际查找的预期。
方案横向选型与总结
在 JavaScript 中获取全部匹配项位置,不同方案的权衡如下表:
| 实现方式 | 代码行数 | 遍历次数 | 时间复杂度 | 主要特点与适用场景 |
|---|---|---|---|---|
| ES6 reduce (逗号表达式) | 1 行 | 1 次 | O(n) | 代码极简、性能极佳,最推荐的一行方案 |
| ES6 reduce (展开语法) | 1 行 | 1 次 | O(n²) | 严格不可变无副作用,适合小型数组 |
| map + filter 链式调用 | 1 行 | 2 次 | O(n) | 产生中间映射数组,存在多余内存分配 |
| 传统 for 循环 / while + indexOf | 5~8 行 | 1 次 | O(n) | 逻辑分散,样板代码多,缺乏函数式表达力 |
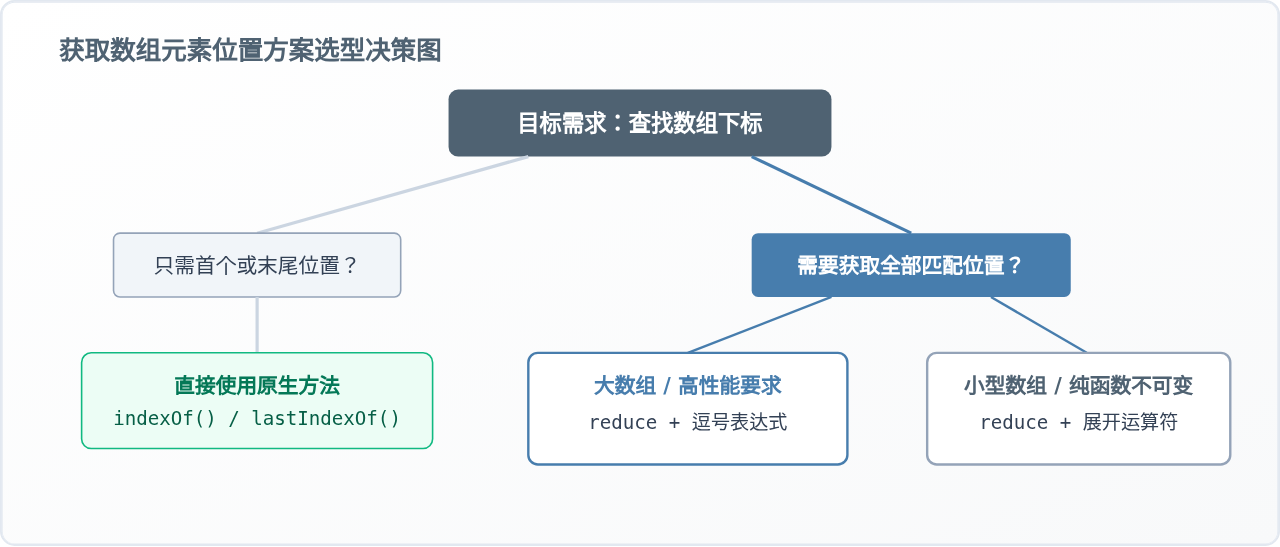
通过合理运用 ES6 reduce 的当前索引参数与累加器机制,我们不仅能在单行代码内优雅解决“获取所有匹配位置”的需求,还能通过就地追加的逗号表达式兼顾极致性能与函数式代码的清爽结构。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章