
深入解析在JavaScript中通过正则将字符串转为数组时触发Invalid regular expression特殊字符报错的底层机制,提供原生字符串规避策略、动态正则安全转义函数与多场景完整代码实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组正则特殊字符报错
作者:函数茶馆
时间:2026-11-13
浏览:411
文章目录
在 JavaScript 中使用正则表达式将字符串切割转换为数组时,若分隔符中包含
+、*、?、(、[、. 等特殊符号,直接使用 new RegExp(delimiter) 会触发 SyntaxError: Invalid regular expression: Nothing to repeat 等语法崩溃,或者发生全局通配切割的严重逻辑错误。解决该问题的关键是:固定单符号优先退回原生字符串切割 str.split('+'),而涉及多重条件或动态输入的分隔场景,必须通过转义函数将元字符替换为字面量转义形式。
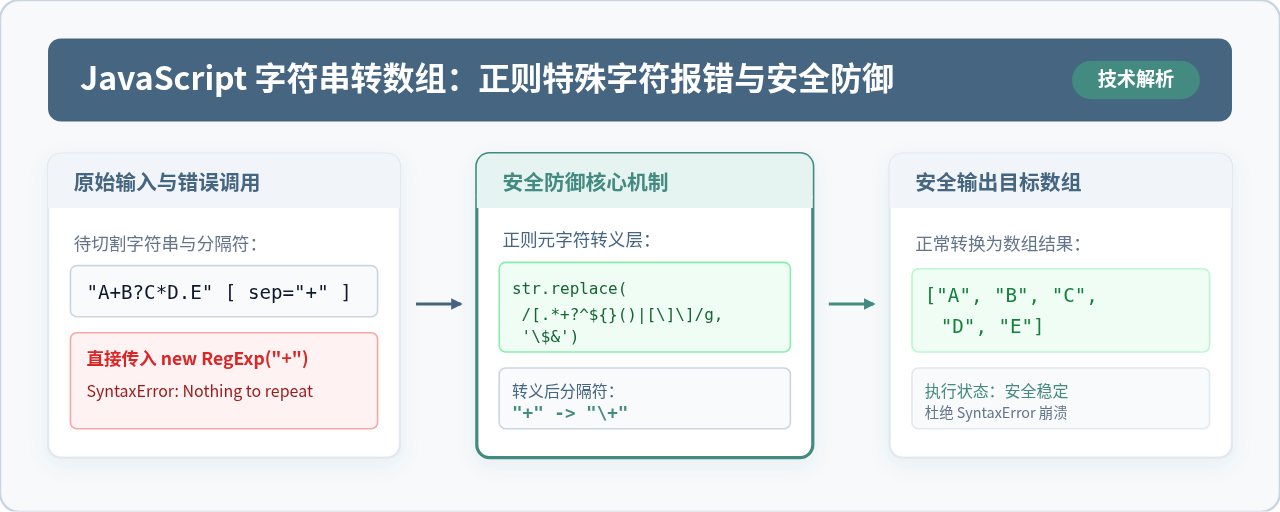
技术架构全景:未转义正则入参崩溃机理与安全转义过滤链路
一、报错表现与触发根源
很多开发者在编写字符串转数组逻辑时,习惯性地把分隔符传入 RegExp 构造函数或者直接书写正则。例如当解析公式或复合格式文本时,执行如下代码:
// 场景 1:以加号作为分隔符切分字符串
const formula = "apple+banana+orange";
const delimiter = "+";

// 常见错误写法:直接将变量组装进正则
const result = formula.split(new RegExp(delimiter));
// 运行时抛出异常:
// SyntaxError: Invalid regular expression: /+/: Nothing to repeat
这个报错的意思是:JavaScript 正则解析器将 + 判定为“重复量词”(表示匹配前面的字符 1 次或多次),但由于该字符处于正则表达式的起始位置,前面没有任何可被修饰的原子字符,词法语法树构建失败,引擎直接抛出 SyntaxError 并中断后续代码运行。
典型报错速查:
SyntaxError: Invalid regular expression: /+/: Nothing to repeat(加号、星号、问号开头)SyntaxError: Invalid regular expression: /[/: Unterminated character class(缺少配对中括号)SyntaxError: Invalid regular expression: /(/: Unterminated group(缺少配对圆括号)SyntaxError: Invalid regular expression: /\/: \ at end of pattern(末尾孤立反斜杠)
除了显式的语法报错,还存在一种极其隐蔽但危害更大的“静默逻辑错误”。例如开发者试图以英文句号 . 拆分域名或版本号:
const version = "1.2.3";
// 错误写法:直接把 "." 丢给正则
const parts = version.split(new RegExp("."));

// 结果既不报错,也不符合预期,输出为:
console.log(parts); // ["", "", "", "", "", ""]在正则表达式中,. 是特殊元字符,代表“匹配除换行符之外的任意单个字符”。执行 split 时,字符串中的每个数字与点都被当成分隔符全数匹配抹除,最终切出全空数组。
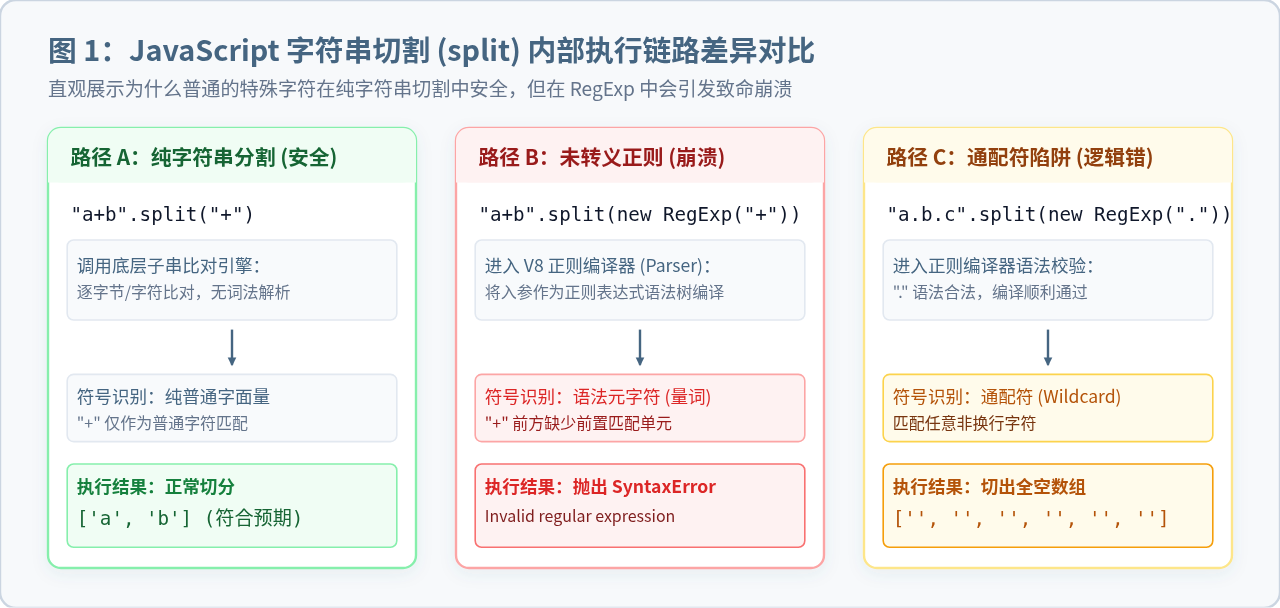
图 1:JavaScript 字符串切割 (split) 内部执行链路差异对比
二、必须警惕的 14 个正则元字符清单
在 ECMAScript 规范中,以下 14 个字符被定义为正则语法元字符(Syntax Characters):\、^、$、.、|、?、*、+、(、)、[、]、{、}。只要分隔符包含其中任何一个,都无法作为纯文本直接传给 new RegExp()。
| 字符类别 | 代表符号 | 正规语法作用 | 未转义直接 split 的后果 |
|---|---|---|---|
| 重复量词 | + * ? {} |
指定前置单元的重复频次 | 抛出 SyntaxError: Nothing to repeat 或 Incomplete quantifier |
| 分组与集合 | ( ) [ ] |
捕获组、分组运算、字符类范围 | 抛出 Unterminated group 或 Unterminated character class |
| 锚点与通配 | . ^ $ |
通配任意单字、匹配行首与行尾 | 不报错但逻辑崩塌:. 切出全空数组;^ 切出多余首部空串 |
| 转义与分支 | \ | |
转义引导符、多模式逻辑“或” | \ 抛出结尾语法错;| 产生空模式导致每个字符被逐一拆散 |
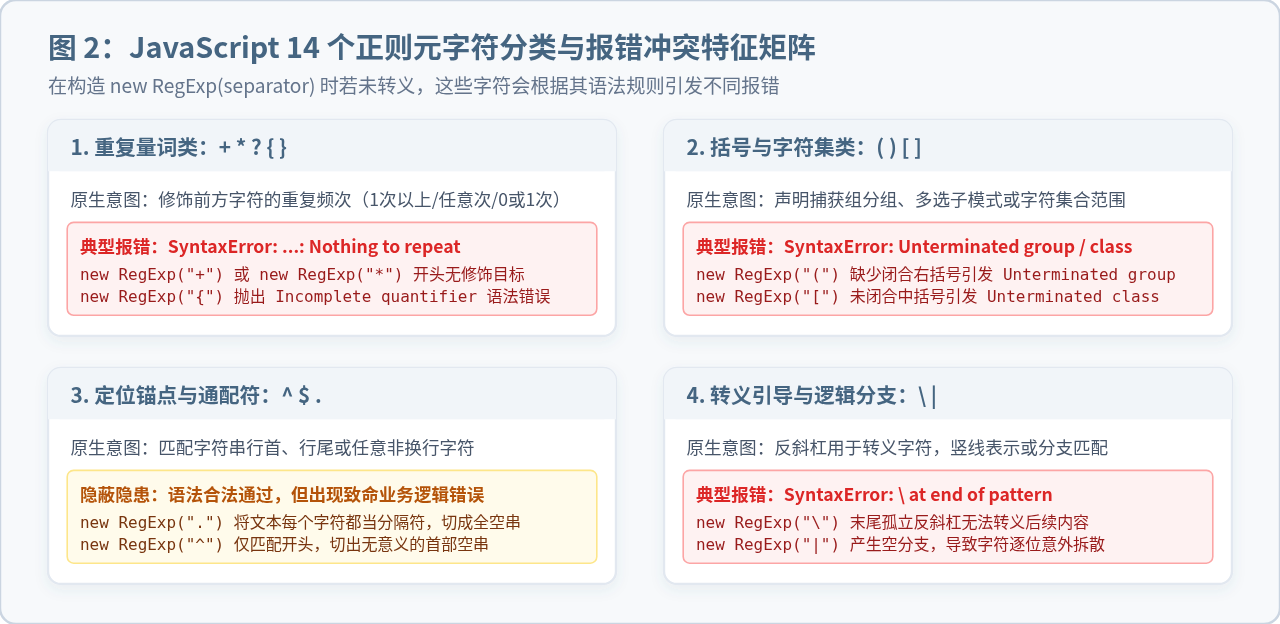
图 2:JavaScript 14 个正则元字符分类与报错冲突特征矩阵
三、排查与安全修复标准步骤
修复此问题的思路非常明确:根据实际业务场景判断是否必须使用正则。若不需要正则,立即退回简单高效的原生字符串;若必须动态使用正则,则建立前置转义机制。
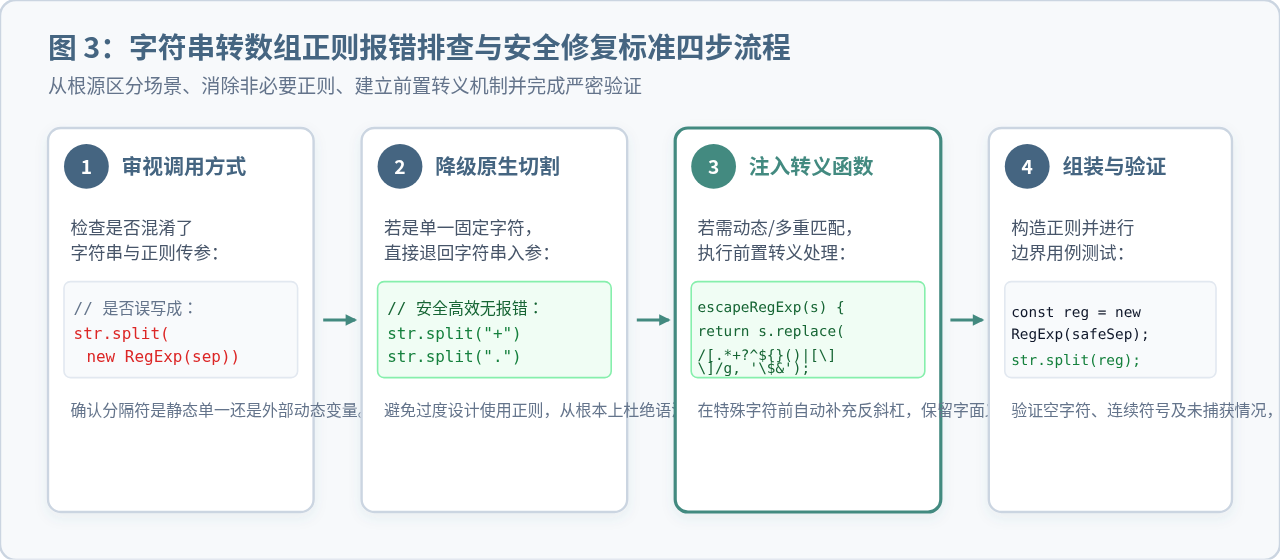
图 3:字符串转数组正则报错排查与安全修复标准四步流程
第 1 步:审视调用方式,杜绝多余的正则构建
许多初学者之所以踩坑,是因为混淆了 String.prototype.split 的参数类型。在 Java 等语言中,split() 默认入参就是正则表达式;但在 JavaScript 中,split 既接收正则表达式,也完全支持普通字符串。
如果你只是按固定的单一字符(如 "+"、"."、"?")进行切割,根本不需要 new RegExp(),直接传入字符串字面量即可:
// 错误写法(过度设计,引发崩溃):
const arrBad = "a+b+c".split(new RegExp("+")); // SyntaxError

// 正确做法(原生字符串比对,安全且性能更高):
const arrGood = "a+b+c".split("+");
console.log(arrGood); // ["a", "b", "c"]
性能与安全提示:对于固定单一子串,纯字符串
str.split(str) 走的是底层 V8 的精确字符串匹配算法,既不需要正则编译,也没有语法解析开销,彻底杜绝特殊字符报错。
第 2 步:针对动态变量,实现标准的正则转义函数
如果分隔符来自外部输入(如用户在搜索框输入的标点、从接口获取的动态配置),或者需要一次性按多个特殊符号联合切割,就必须用到正则。在传入 new RegExp() 之前,必须对所有元字符进行转义。
以下是经过广泛验证的标准 escapeRegExp 实现:
/**
 * 将字符串中的正则表达式元字符转义为纯字面量表示
 * @param {string} string 待转义的原始分隔符字符串
 * @returns {string} 转义后的安全正则字符串
 */
function escapeRegExp(string) {
  // 匹配所有 14 个特殊元字符,并在匹配项前添加反斜杠
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}原理解析:$& 是 replace 方法中的特殊替换模式,代表“当前正则匹配到的子串本身”。通过 \\$&,原本的 "+" 会被安全替换为 "\+",原本的 "." 会被替换为 "\."。
第 3 步:组装 RegExp 并执行安全转换
完成转义后,再将安全的字符串传入 RegExp 构造函数,即可确保正则语法树正确识别为字面匹配:
function safeSplit(str, rawDelimiter) {
  if (typeof str !== 'string') return [];
  if (!rawDelimiter) return [str];

  // 1. 转义特殊字符
  const safePattern = escapeRegExp(rawDelimiter);

  // 2. 构造安全正则并切割
  const regex = new RegExp(safePattern);
  return str.split(regex);
}

// 验证测试:
console.log(safeSplit("foo+bar+baz", "+")); // ["foo", "bar", "baz"]
console.log(safeSplit("192.168.1.1", "."));  // ["192", "168", "1", "1"]
console.log(safeSplit("a?b?c", "?"));        // ["a", "b", "c"]
console.log(safeSplit("x(1)y(2)z", "("));    // ["x", "1)y", "2)z"]
四、常见复合场景与完整实战示例
场景 1:支持多种混合特殊符号同时切割
实际开发中常常遇到一段文本中混合了多种特殊符号(例如同时包含 +、/、?、|),要求把它们统一当作分隔符转为数组:
function splitByMultipleSymbols(text, symbolList) {
  if (!symbolList || symbolList.length === 0) return [text];

  // 将每一个符号分别做安全转义,再使用 | (或) 分支拼接
  const escapedList = symbolList.map(item => escapeRegExp(item));
  const combinedPattern = escapedList.join('|');

  // 构造统一正则,例如: /\+|\?|\/|\|/
  const regex = new RegExp(combinedPattern);
  return text.split(regex);
}

const mixedString = "前端+后端?运维/测试|产品";
const symbols = ["+", "?", "/", "|"];

const tags = splitByMultipleSymbols(mixedString, symbols);
console.log(tags);
// 结果输出:["前端", "后端", "运维", "测试", "产品"]
场景 2:连续特殊字符分割与空项清洗
当文本中出现连续的特殊符号(如 "data+++info??debug")时,普通的 split 会在数组中生成大量无意义的空字符串 ""。可以通过量词 + 合并连续分隔符,或在拆分后使用 filter(Boolean) 清理:
function splitAndCompact(text, delimiter) {
  // 转义后添加量词 +,表示匹配一个或多个连续的分隔符
  const safePattern = escapeRegExp(delimiter) + '+';
  const regex = new RegExp(safePattern);

  return text.split(regex).filter(item => item.trim().length > 0);
}

const messyData = "cpu+++mem???disk++++net";
console.log(splitAndCompact(messyData, "+"));
// 输出: ["cpu", "mem???disk", "net"]
场景 3:包含 Unicode 与 Emoji 表情符号的单字拆分
如果你的目标是将字符串拆分成每一个单独的字符,很多教程会建议 str.split('')。但在处理包含 Emoji 或特殊生僻字的现代字符串时,由于 UTF-16 代理对(Surrogate Pairs)机制,split('') 会将一个 4 字节的 Emoji 强行砍成两个乱码字符:
const textWithEmoji = "代码👍开发🎉";

// 错误做法:传统 split('') 导致乱码截断
console.log(textWithEmoji.split(''));
// ["代", "码", "\uD83D", "\uDC4D", "开", "发", "\uD83C", "\uDF89"]

// 现代标准做法:使用 ES6 展开运算符或 Array.from
const safeChars = [...textWithEmoji];
console.log(safeChars);
// ["代", "码", "👍", "开", "发", "🎉"] (完美保持单字完整)
五、选型建议与技术总结
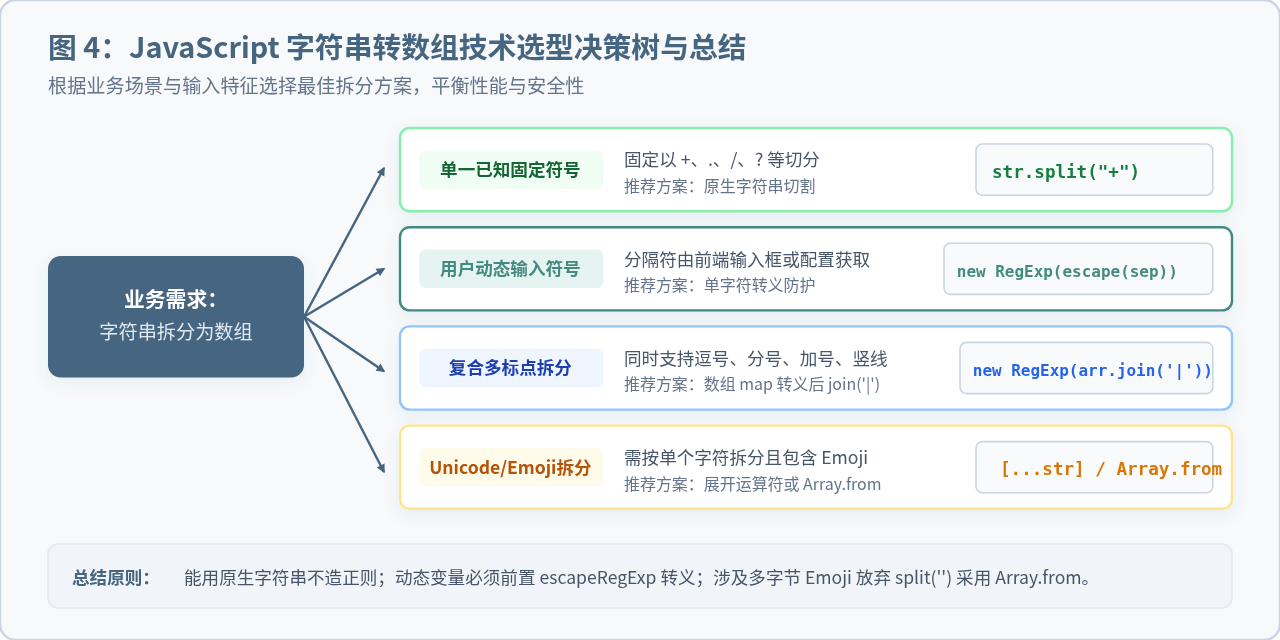
图 4:JavaScript 字符串转数组技术选型决策树与总结
针对“js字符串转数组正则特殊字符报错”这一问题,在编写健壮的前端或 Node.js 代码时,建议遵循以下三条防御性编程准则:
- 不过度引入正则:若分隔符为固定的标点字符,坚决使用
str.split(string),原生字符串比对不会触发正则语法解析,不仅零报错,执行效率也显著优于正则构造。 - 外部输入必经转义:任何来自用户输入、URL 参数或服务端接口的动态分隔符,一旦需要传入
new RegExp(),必须统一经过escapeRegExp处理,防止正则语法错误导致应用崩溃,同时防范 ReDoS 正则拒绝服务风险。 - 字符级拆分采用迭代器:当需要将整段文本拆分为单字符数组且文本可能包含 Emoji 或多语言符号时,放弃
split(''),优先采用[...str]或Array.from(str)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章