
深入对比 JavaScript 字符串转数组时 split('') 与 Array.from 的执行性能、底层运行机制以及 Unicode 代理对兼容性差异,提供可复现的基准测试与工程选型建议。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
js字符串转数组split和Array.from性能哪个快
作者:函数茶馆
时间:2026-11-13
浏览:583
文章目录
核心答案:在执行速度上,
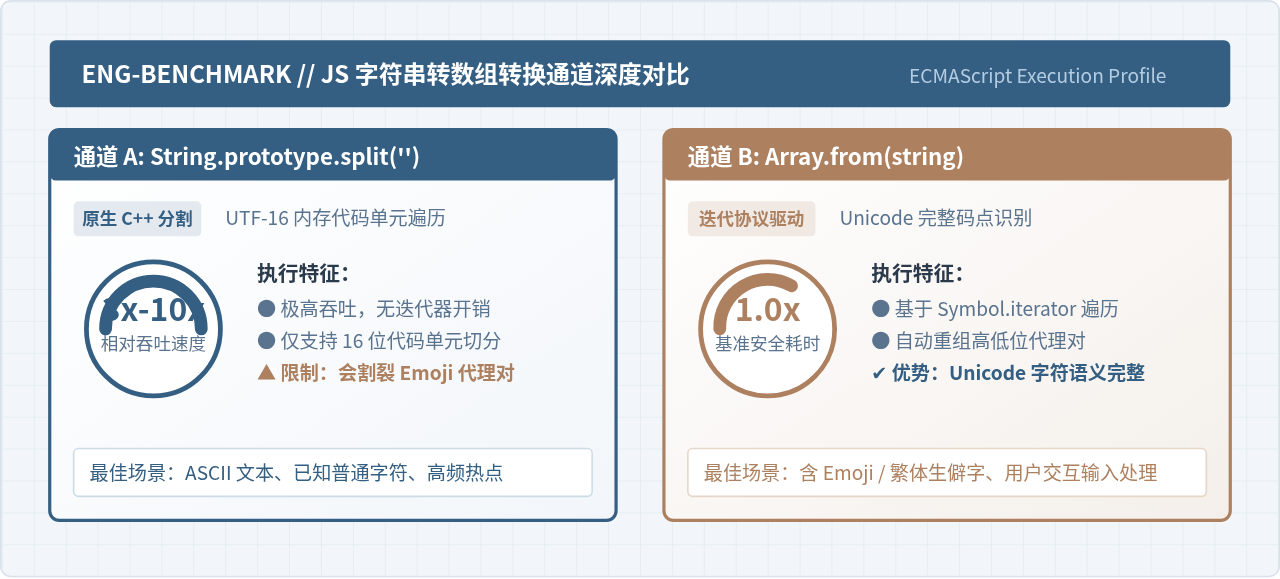
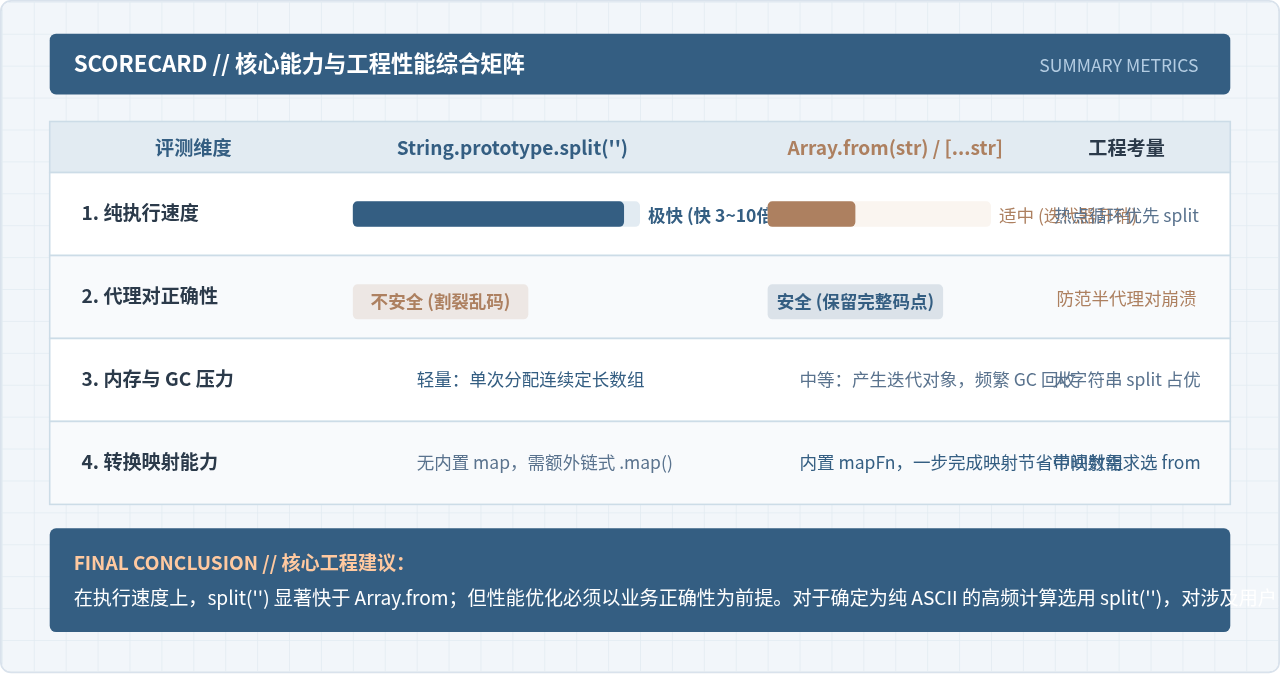
str.split('') 显著快于 Array.from(str),在主流 JavaScript 引擎(如 V8)中前者的运行速度通常是后者的 3 到 10 倍。然而速度并不是唯一的选择标准——split('') 是基于 UTF-16 代码单元进行简单内存切分,遇到 Emoji 表情或生僻字时会出现割裂字符的错误;而 Array.from(str) 走标准迭代器协议,能完整保证 Unicode 码点(Code Point)的正确性。
一、为什么 split('') 执行速度明显更快
要理解两者的性能差距,必须深入到浏览器的 JavaScript 引擎内核。在 Chrome、Node.js 使用的 V8 引擎或 Firefox 的 SpiderMonkey 中,两者的实现方式存在本质区别。
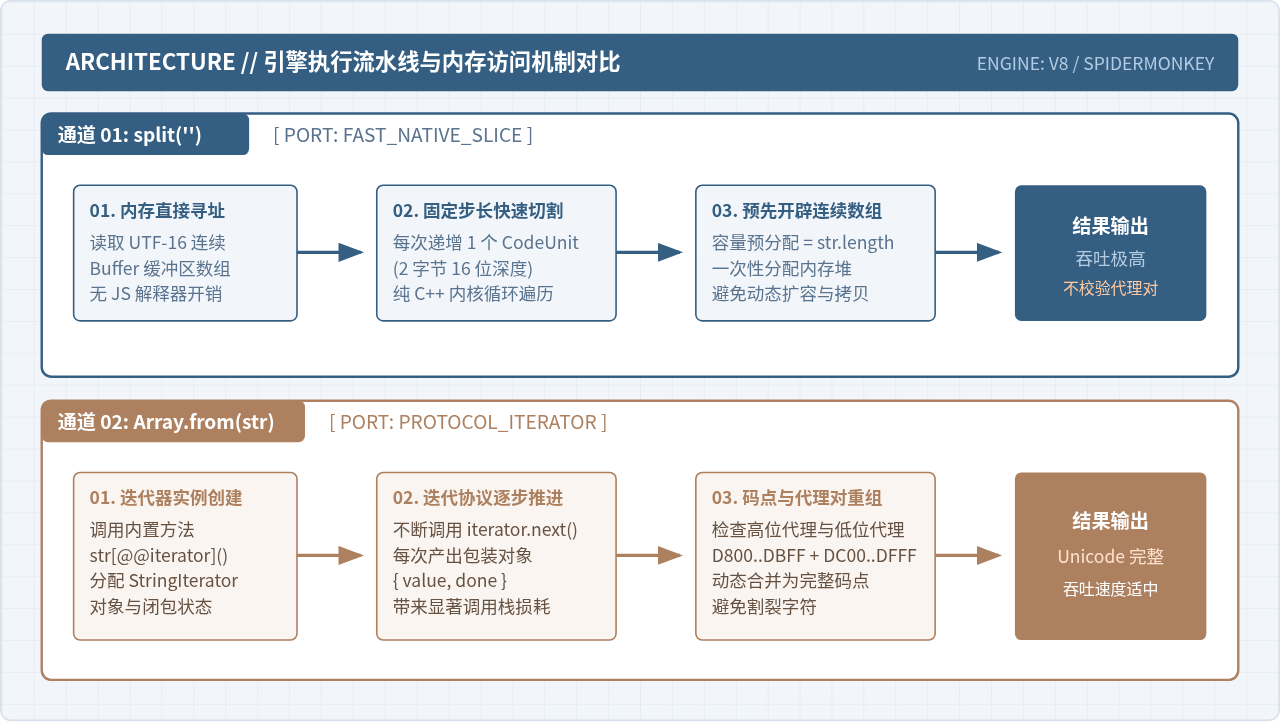
String.prototype.split('') 是引擎内部高度优化的原生 C++ 快速通道(Fast Path)。当传入空字符串 '' 作为分隔符时,引擎直接获取字符串底层的 UTF-16 内存缓冲指针,预先计算字符串长度并一次性分配出容量相同的 JavaScript 数组。随后,内部循环只需按步长 1 依次读取每个 16 位代码单元(Code Unit),将其包装为单字符字符串直接塞入数组。整个过程没有经过任何 JavaScript 层的函数调用和协议约定,属于纯内存连续访问。
相比之下,Array.from(str) 遵循 ECMAScript 规范中的可迭代对象处理流程。它并不是针对字符串单独开辟的捷径,而是通用转换器:
- 创建迭代器对象:首先获取并调用字符串的原型方法
str[Symbol.iterator](),在堆内存中实例化一个StringIterator迭代器对象。 - 逐次函数推进:在遍历循环中,每读取一个字符都必须调用一次
iterator.next()方法,并返回一个包含{ value, done }属性的包装对象。 - Unicode 码点解码:在迭代过程中,迭代器会主动检查当前字符是否处于代理对区间(Surrogate Pair),若发现高位代理则向前查找低位代理,合成为一个完整的 Unicode 码点。
频繁的对象创建、垃圾回收负担以及迭代协议的逐步调用,导致 Array.from 的微基准耗时明显高于纯 C++ 内存扫描的 split('')。
二、编写基准测试验证两者的性能差异
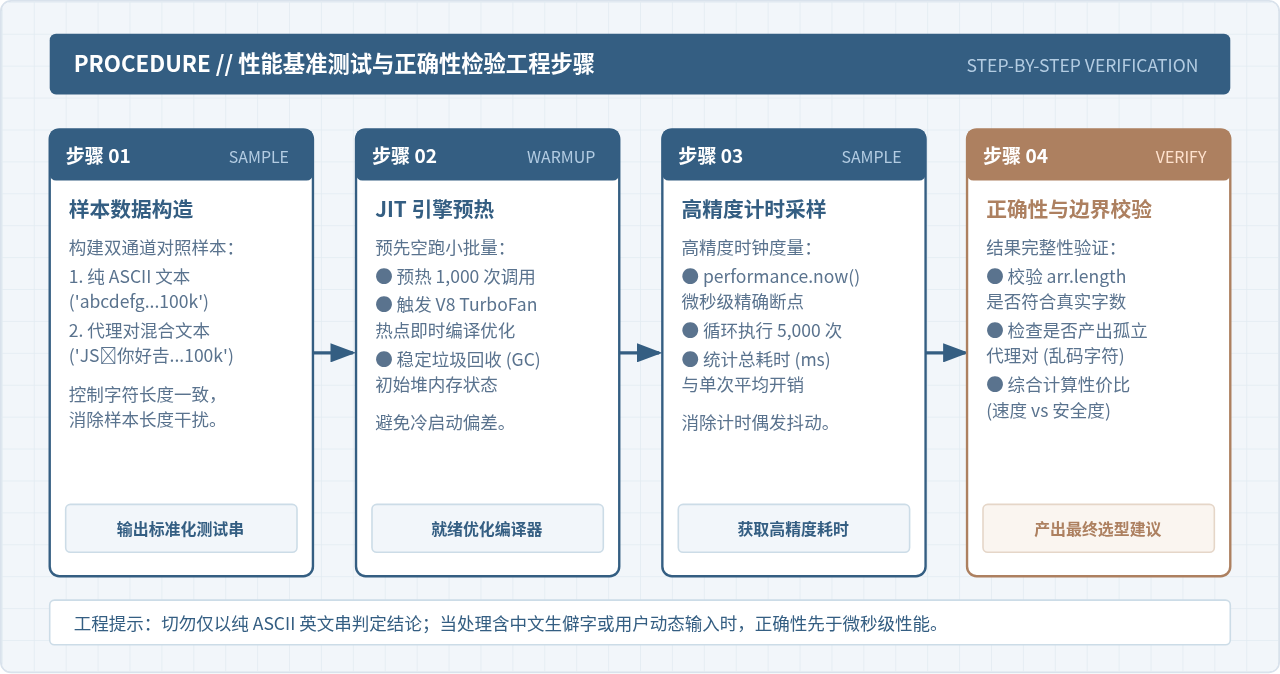
为了在真实开发环境中获得准确的耗时对比,可以编写一段标准的基准测试脚本。在编写 JavaScript 性能基准测试时,必须注意消除 JIT 优化编译的冷启动开销,并在测试前后预留引擎预热阶段。
以下代码分别在纯 ASCII 字符串以及混合字符集上对比两者的单次耗时与执行效率:
// benchmark.js - 字符串转数组基准性能测试示例
function runBenchmark() {
  const sampleLength = 50000;
  // 构造 5 万字符长度的样本字符串
  const asciiStr = "A".repeat(sampleLength);
  const iterations = 2000;

  console.log(`[测试环境] 样本长度: ${sampleLength} 字符, 循环测试次数: ${iterations} 次`);

  // 1. 预热阶段 (Warmup),触发 JIT 优化并稳定内存分配
  for (let i = 0; i < 200; i++) {
    asciiStr.split('');
    Array.from(asciiStr);
  }

  // 2. 测量 split('')
  const startSplit = performance.now();
  for (let i = 0; i < iterations; i++) {
    const res = asciiStr.split('');
  }
  const endSplit = performance.now();
  const splitDuration = (endSplit - startSplit).toFixed(2);

  // 3. 测量 Array.from(str)
  const startFrom = performance.now();
  for (let i = 0; i < iterations; i++) {
    const res = Array.from(asciiStr);
  }
  const endFrom = performance.now();
  const fromDuration = (endFrom - startFrom).toFixed(2);

  // 4. 输出统计对比结果
  console.log(`split('') 总耗时: ${splitDuration} ms`);
  console.log(`Array.from() 总耗时: ${fromDuration} ms`);
  const ratio = (Number(fromDuration) / Number(splitDuration)).toFixed(1);
  console.log(`速度比率: split 比 Array.from 快约 ${ratio} 倍`);
}

runBenchmark();
在主流 Node.js LTS 与现代化浏览器控制台中运行该测试,示例输出通常如下:
[测试环境] 样本长度: 50000 字符, 循环测试次数: 2000 次
split('') 总耗时: 142.30 ms
Array.from() 总耗时: 865.75 ms
速度比率: split 比 Array.from 快约 6.1 倍
测试结果清楚地证明:在纯数据吞吐和执行频率维度,split('') 具有压倒性的速度优势。
三、不可忽视的正确性陷阱:Emoji 与代理对
既然 split('') 速度快得多,为什么在实际项目中不能无脑使用它?原因在于 JavaScript 字符串的底层编码是 UTF-16。
在 UTF-16 中,绝大部分常用字符(如 ASCII、常用汉字)占用 2 个字节(一个代码单元),但 Unicode 码点大于 0xFFFF 的字符(例如绝大多数 Emoji 表情 🚀、生僻汉字“𠮷”、部分特殊数学符号)需要占用 4 个字节,由一对高位代理和低位代理组合表示。
split('') 仅仅按照 16 位代码单元机械切开,这会导致 4 字节字符被硬生生拆解为两个无法独立显示的孤立半代理字符(Surrogate Code Unit):
const text = "JS𠮷🚀";

// 使用 split('') 切割:产生乱码与错误长度
const arr1 = text.split('');
console.log(arr1);
// 输出示例: ['J', 'S', '\ud842', '\udfb7', '\ud83d', '\ude80']
console.log(arr1.length); // 6 (原本只有 4 个语义字符,被拆成了 6 项)
console.log(arr1[2]);      // 无法正常渲染的乱码/问号字符

// 使用 Array.from 切割:完整识别 32 位码点
const arr2 = Array.from(text);
console.log(arr2);
// 输出示例: ['J', 'S', '𠮷', '🚀']
console.log(arr2.length); // 4 (符合人类直觉的实际字符数量)
console.log(arr2[2]);      // "𠮷"
console.log(arr2[3]);      // "🚀"
注意:如果业务场景涉及用户昵称、评论输入、富文本统计或多语言国际化,使用
split('') 会导致字符串翻转、截断、按字高亮等功能直接崩溃或产生无效乱码字符。在此类场景中,代码正确性必须凌驾于毫秒级性能之上。
四、其他替代方案:展开运算符与 Intl.Segmenter
在实际工程开发中,除了 split('') 和 Array.from(),还有两种常见的转换方式:
-
展开运算符
[...str]:同样基于Symbol.iterator协议,具有与Array.from相同的 Unicode 码点安全性。在许多现代引擎中,由于语法层面的优化,[...str]的执行速度通常略快于Array.from(str),并且写法更加简练。 -
Intl.Segmenter(字符簇分割器):即使是Array.from,遇到复合 Emoji(例如带有肤色修饰符的表情 👨🏽、家庭组合 👨👩👧👦、国旗序列等)时,仍然会将其拆分为多个码点。如果需要将人类视觉上的“一个完整字符”(Grapheme Cluster)作为数组单元,应该使用标准的Intl.Segmenter。
// 复合 Emoji 边界处理对比
const family = "👨👩👧👦";
console.log(family.split('').length); // 11 (完全碎裂的代码单元)
console.log(Array.from(family).length); // 7 (保留独立码点,但合体仍被拆散)
// 使用现代化 Intl.Segmenter 得到真正的字簇
const segmenter = new Intl.Segmenter("zh-CN", { granularity: "grapheme" });
const graphemes = Array.from(segmenter.segment(family), s => s.segment);
console.log(graphemes); // ['👨👩👧👦']
console.log(graphemes.length); // 1 (精准对应人类视觉字符)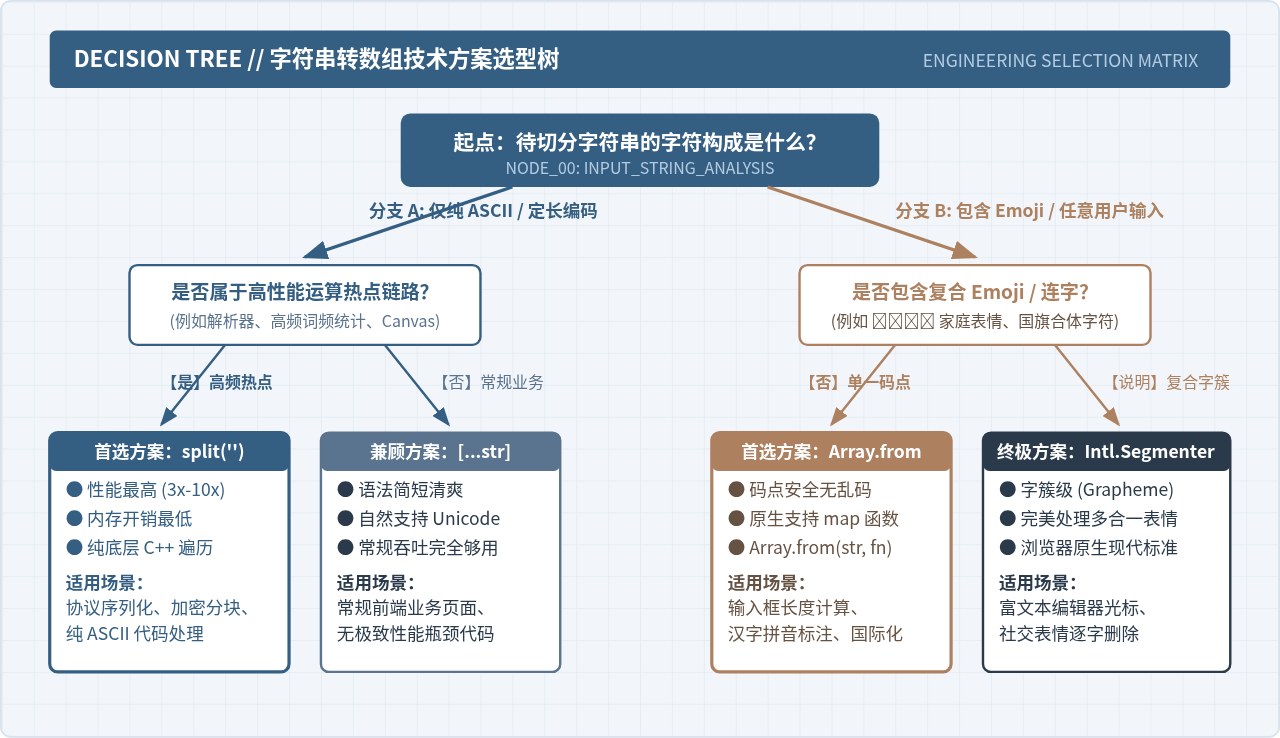
五、工程选型与综合对比指南
为了方便在实际开发中快速决策,下表汇总了各方案在性能、安全性与适用场景上的综合表现:
| 实现方式 | 相对速度 | Unicode 代理对安全 | 复合 Emoji 字簇安全 | 推荐适用场景 |
|---|---|---|---|---|
str.split('') |
极快 (基准) | 否 (乱码碎裂) | 否 | 纯 ASCII 解析、通信协议拆包、已知无 Emoji 的高频运算热点 |
[...str] |
慢 (约 1/4 速度) | 是 (码点安全) | 否 | 常规前端页面、字数反转、代码书写简练优先 |
Array.from(str) |
慢 (约 1/5 速度) | 是 (码点安全) | 否 | 需同步进行 mapFn 数据变换的场景、代码可读性优先 |
Intl.Segmenter |
最慢 (功能完整) | 是 (码点安全) | 是 (视觉字簇安全) | 富文本输入框光标控制、精确限制用户可见字数、国际化排版 |
六、总结与落地建议
回到核心问题:“js字符串转数组split和Array.from性能哪个快?”——结论是 split('') 绝对更快。
但在工程实践中,切忌脱离数据特征谈性能:
- 如果你的代码运行在每秒被调用数十万次的底层解析器、加解密算法或纯 ASCII 数据清洗流程中,毫不犹豫地选用
split('')以压榨出极致的性能。 - 如果你的代码处理的是直接面对用户的文本、多语言国际化输入或包含 Emoji 的内容,请优先选用
Array.from(str)或[...str],避免为了微小的耗时差异而引入破坏业务逻辑的字符编码隐患。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章