

深入解析JavaScript大字符串转数组时的性能瓶颈与V8堆内存放大机制,提供基于indexOf游标滑动、Generator惰性迭代、分块缓冲及流式读取的具体优化方案。
js字符串转数组大字符串性能优化
作者:性能诊所
时间:2026-11-13
浏览:618
文章目录
JavaScript 运行机制
内存优化
V8 引擎调优
假设在浏览器前端处理用户上传的 120MB 审计日志文本,或者在 Node.js 服务中接收数十万条明细组成的导出数据,直接执行
bigStr.split('
')
将大字符串切分为数组,往往会导致内存占用瞬间飙升数倍,引发数百毫秒甚至数秒的垃圾回收(GC)卡顿,极端情况下更会直接导致浏览器标签页崩溃或抛出 JavaScript heap out of memory。大字符串转数组的核心瓶颈不在于字符匹配本身,而在于一次性实例化数百万个字符串对象与巨型指针数组造成的内存急剧膨胀与全量垃圾回收停顿。针对该问题,有效的优化路径是依据使用场景分别采用游标滑动迭代、批量定长缓冲、流式通道处理以及异步工作线程卸载。
常规 split() 处理大字符串的性能恶化根源
在日常开发中,对于几十字节或几千字节的小字符串,str.split(separator) 是最便捷的方法。然而,当输入字符串体积达到数十兆字节或上百兆字节时,该方法的内部执行开销呈现出非线性的暴增。要解决大字符串转数组的性能问题,首先需要理解 V8 引擎在执行该操作时的底层资源消耗过程。
1. 内存膨胀效应与指针开销
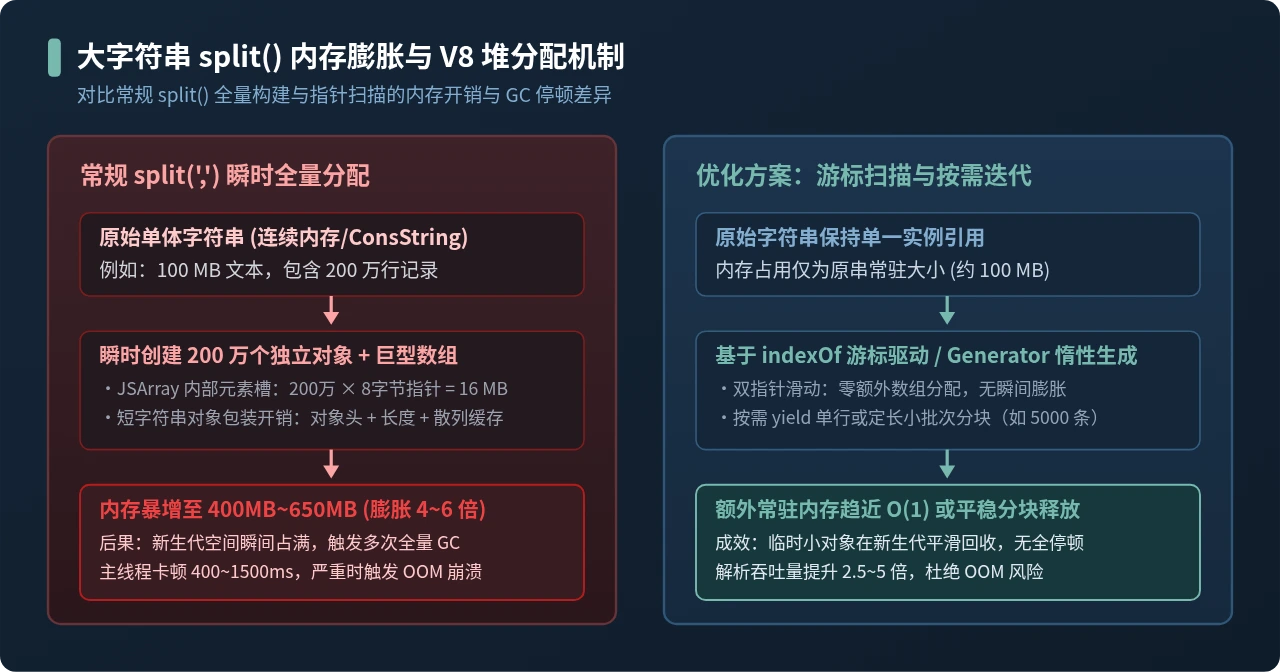
一个 100MB 的纯文本字符串,在被加载到内存中时可能以连续的扁平字符串(SeqString)或多个分段拼接的树状结构(ConsString)存在。当调用 split('
') 时,引擎必须一次性完成两项巨大的分配任务:
- 创建巨型 JSArray 容器:如果文本包含 200 万行,引擎需要分配一个容量至少为 200 万的数组。在 64 位系统上,仅存储这 200 万个元素指针的底层连续槽位就需要消耗
2,000,000 × 8 字节 ≈ 16MB的内存空间。如果预估长度不准确,数组在动态扩容时还会发生多次连续内存搬迁。 - 分配数百万个独立的字符串包装对象:原字符串被切碎为 200 万个独立的子字符串。在 V8 中,每个 JavaScript 字符串对象不仅包含字符数据,还包含对象头(Map 指针)、哈希码字段、长度字段以及可能的切片指针(SlicedString)。一个原本只有几个字符的小行,加上对象头结构后,占用的内存往往是其实际文本字节数的数倍。
因此,原本仅占用 100MB 的单体文本,在 split() 执行完毕后,堆内存占用往往会激增到 450MB 至 700MB,膨胀倍率高达 4 到 7 倍。
2. 垃圾回收全停顿(Stop-the-World GC)
V8 的垃圾回收分为处理存活时间较短对象的新生代(Scavenge)和处理长期存活对象的老生代(Mark-Sweep / Mark-Compact)。一次性生成上百万个对象会瞬间将新生代的两个半空间(Semi-space)填满,导致大量对象被强制晋升(Evacuation)至老生代。老生代内存迅速触及阈值后,会触发全量垃圾回收(Major GC)。在此期间,JavaScript 主线程会被挂起数秒,造成界面无响应或后端网络请求超时。
优化方案一:使用 Generator 游标迭代实现惰性消费
在绝大多数业务场景中,程序将字符串转为数组的最终目的并不是永久保留这个巨大的数组,而是为了遍历其中的每一项(例如逐行过滤、解析 CSV 字段、校验格式或逐条发送给下游)。如果后续操作是逐项处理的,最彻底的优化手段就是完全不生成完整的数组对象,而是通过生成器(Generator)进行按需产出。
通过底层的 String.prototype.indexOf 配合双指针进行滑动查找,每次仅定位下一个分隔符并截取当前子串,由 yield 发射给调用方。
/**
 * 基于双指针与 indexOf 的惰性行迭代器
 * @param {string} text - 待解析的大字符串
 * @param {string} delimiter - 分隔符,默认为换行符
 * @yields {string} 逐项产出的子字符串
 */
function* tokenizeLazy(text, delimiter = '
') {
  const len = text.length;
  const delimLen = delimiter.length;
  if (len === 0) return;

  let start = 0;
  let next = text.indexOf(delimiter, 0);

  while (next !== -1) {
    yield text.substring(start, next);
    start = next + delimLen;
    next = text.indexOf(delimiter, start);
  }

  // 处理末尾未以分隔符结尾的最后一段数据
  if (start <= len) {
    yield text.substring(start);
  }
}

// 消费端:仅维持单行临时变量,额外内存增量几乎为 O(1)
for (const line of tokenizeLazy(bigText, '
')) {
  if (line.length > 0) {
    processSingleRecord(line);
  }
}
性能关键点:
indexOf 在 V8 内部由高度优化的汇编和 SIMD 指令实现,比 JavaScript 层面手写逐字符循环或正则匹配快数倍。在生成器单步循环中,每次产出的子字符串在使用完毕后迅速离开作用域,始终停留在新生代并以极低代价被回收,老生代堆内存几乎保持平稳。
优化方案二:必须获取数组时的分块批量缓冲与预分配
如果下游接口或第三方库必须接收一个标准数组,无法使用迭代器,那么目标就转变为:如何以最小的堆峰值和最少的垃圾回收停顿生成数组。
此时不应直接调用原生 split(),也不应使用无限制的 arr.push()。JavaScript 数组在动态扩展时,当容量不足时会按照倍增策略重新申请连续内存并复制原有元素,频繁触发扩容搬迁会极大浪费 CPU 周期并产生内存碎片。合理的方法是分块批量解析(Chunking)。
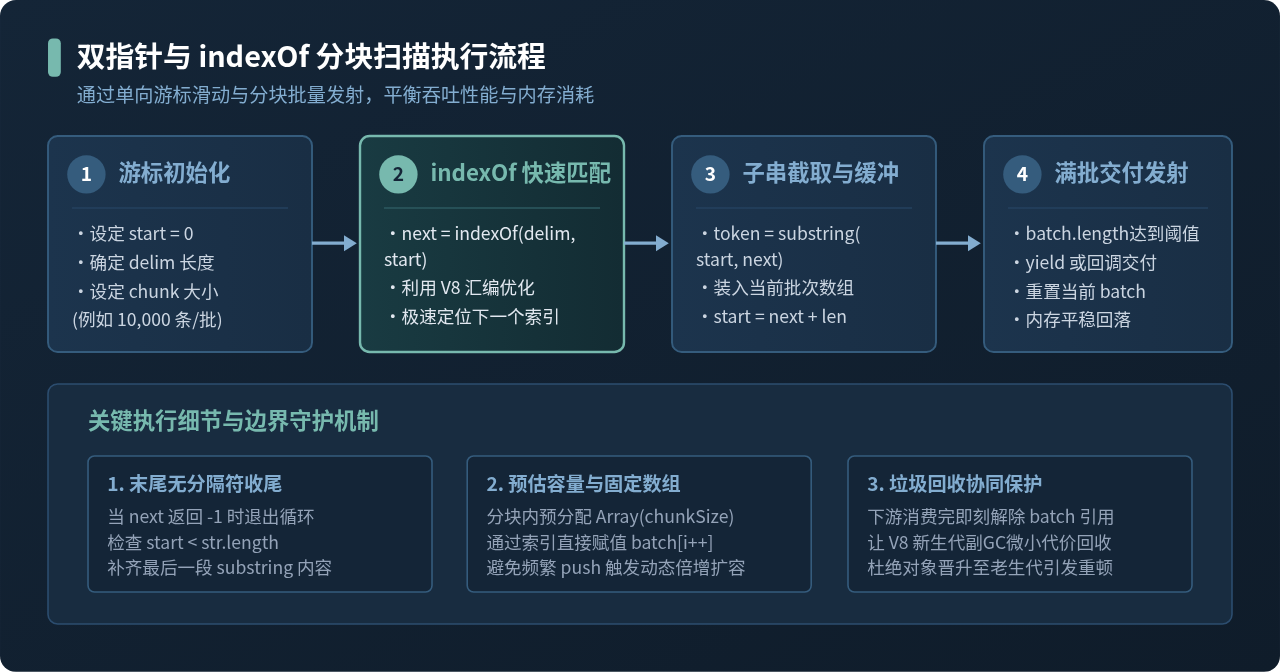
分块解析将连续的游标滑动过程划分为固定容量的批次(例如每批 10,000 或 20,000 条),分批交付给下游处理并适时释放引用,或者在确需合并为大数组时通过预估容量减少扩容开销:
/**
 * 分块批量解析大字符串
 * @param {string} text - 待解析的大文本
 * @param {string} delimiter - 分隔符
 * @param {number} chunkSize - 单批次容量(建议 5000 ~ 20000)
 * @param {function} onChunk - 每批次就绪时的回调函数
 */
function tokenizeInChunks(text, delimiter, chunkSize, onChunk) {
  const len = text.length;
  const delimLen = delimiter.length;
  let start = 0;
  let next = text.indexOf(delimiter, 0);

  let chunk = new Array(chunkSize);
  let count = 0;

  while (next !== -1) {
    chunk[count++] = text.substring(start, next);
    start = next + delimLen;

    if (count === chunkSize) {
      onChunk(chunk);
      chunk = new Array(chunkSize);
      count = 0;
    }

    next = text.indexOf(delimiter, start);
  }

  // 收尾:处理剩余元素
  if (start <= len) {
    chunk[count++] = text.substring(start);
  }

  if (count > 0) {
    chunk.length = count; // 截断末尾多余槽位
    onChunk(chunk);
  }
}

// 使用示例:分批写入数据库或分批执行并行分析
tokenizeInChunks(massiveLogString, '
', 10000, (batch) => {
  saveBatchToStore(batch);
});
通过预先指定 new Array(chunkSize) 并通过直接索引赋值 chunk[count++],排除了底层数组动态扩容的昂贵代价,并且内存消耗始终被限制在当前处理批次的规模以内。
正则表达式与 matchAll / exec 的性能陷阱与抉择
许多开发者尝试使用正则表达式处理复杂分隔符(例如 str.split(/
?
/) 或 str.match(/[^
]+/g))。然而在超大字符串场景下,正则表达式存在显著的性能隐患:
- 正则回溯与状态机开销:即使是简单的贪婪量词,正则引擎在长文本中也需要维护状态栈。若表达式设计不当,回溯会导致耗时成倍增加。
- 全局 match 的内存灾难:
str.match(regexGlobal)会一次性在内存中构建包含所有匹配项的完整数组,其堆内存峰值与split()一样剧烈。 - 非捕获组与捕获组的开销:如果正则表达式中包含了括号但未使用
(?:...)非捕获语法,引擎会在每次匹配时额外保留捕获组子串并存入内部字典,使得内存消耗再度翻倍。
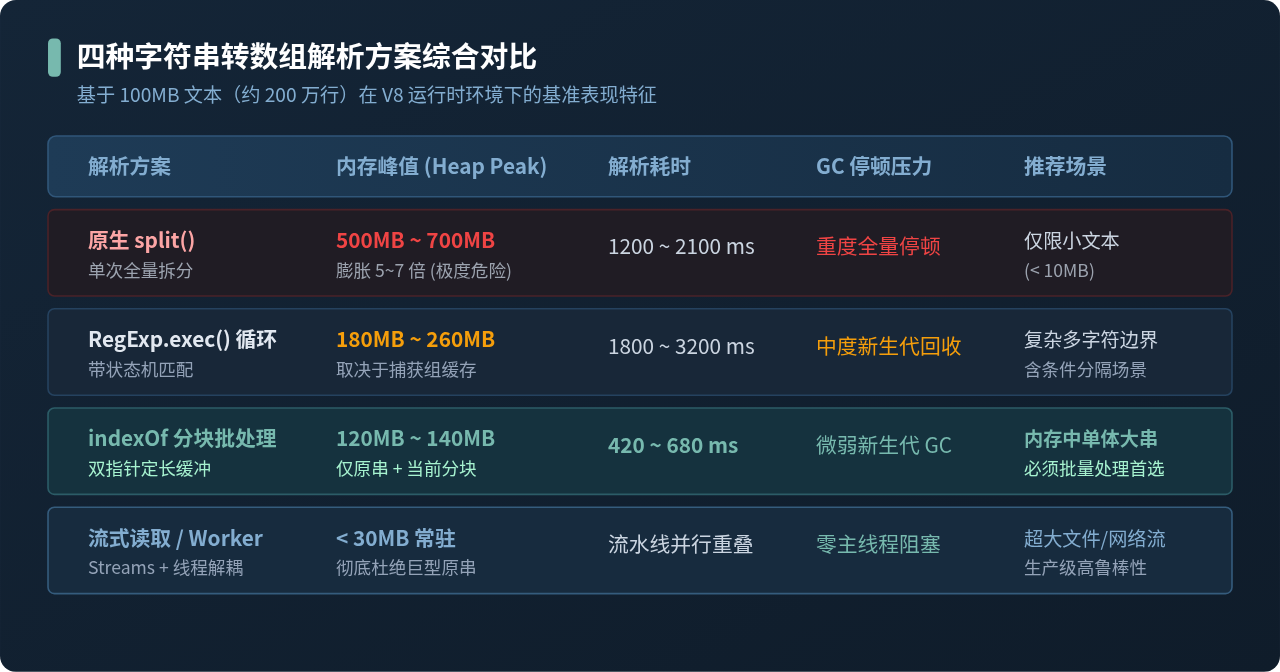
如果分隔符必须使用正则(例如同时兼容
和
,或者存在多个可选分隔符),应当避免 str.split(regex),而是使用带有全局标志 /g 的正则并结合 RegExp.prototype.exec() 循环:
/**
 * 复杂正则分隔符的低内存迭代器
 * @param {string} text
 * @param {RegExp} regexWithGlobal - 必须带 g 标志的正则表达式
 */
function* tokenizeRegexLazy(text, regexWithGlobal) {
  let lastIndex = 0;
  let match;

  while ((match = regexWithGlobal.exec(text)) !== null) {
    yield text.substring(lastIndex, match.index);
    lastIndex = regexWithGlobal.lastIndex;
  }

  if (lastIndex <= text.length) {
    yield text.substring(lastIndex);
  }
}

// 注意正则末尾必须带有 'g' 标志以保持状态位步进
const regexPattern = /
?
/g;
for (const line of tokenizeRegexLazy(bigText, regexPattern)) {
  handleLine(line);
}
源头治理:流式读取与 Web Worker 异步卸载
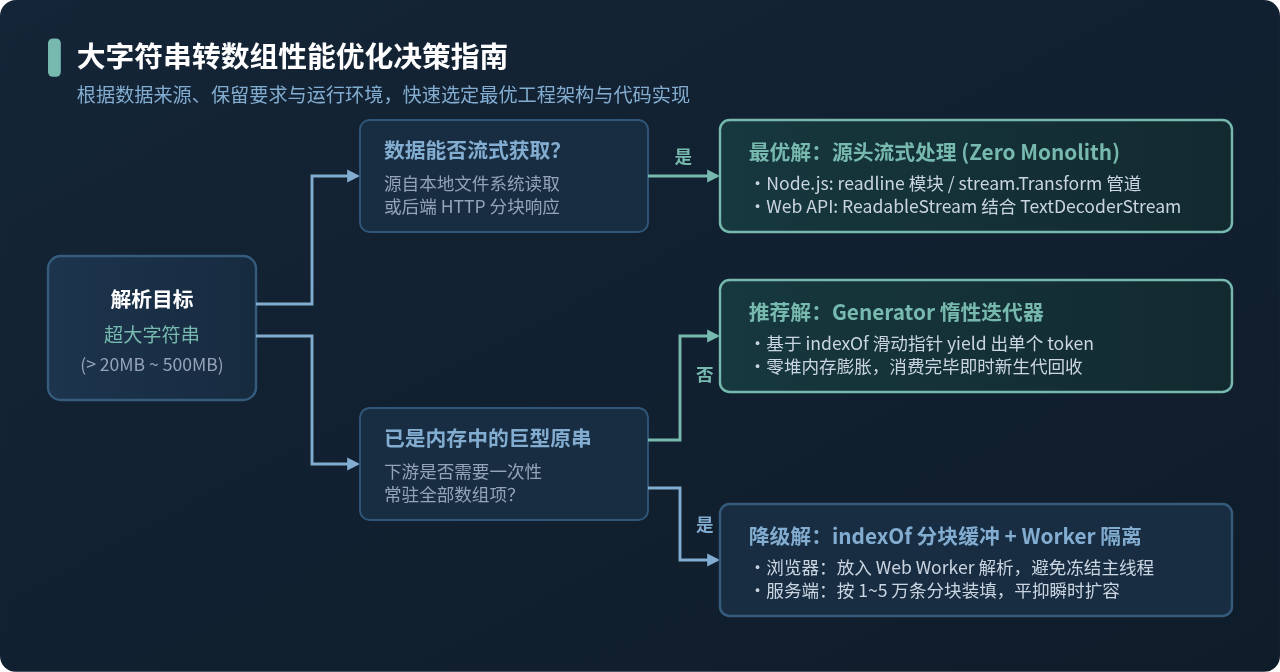
优化大字符串转数组的最优方案,是在系统架构层面避免“巨型单体字符串”在内存中形成。如果大字符串来自网络请求响应体(Fetch Response)或本地文件系统,应当从输入源头进行流式管道化解析。
1. Node.js 环境下的流式管道化(readline 模块)
如果运行在 Node.js 环境中,处理几个 GB 的大文件绝不能先调用 fs.readFileSync() 转为巨型字符串再 split,而应使用内置的 readline 配合文件读取流:
import fs from 'node:fs';
import readline from 'node:readline';

async function processLargeFileByStream(filePath) {
  const fileStream = fs.createReadStream(filePath, {
    highWaterMark: 64 * 1024, // 64KB 缓冲区
    encoding: 'utf-8'
  });

  const rl = readline.createInterface({
    input: fileStream,
    crlfDelay: Infinity // 自动兼容
 与

  });

  for await (const line of rl) {
    // 数据按 64KB 分段涌入,常驻内存仅几兆字节,完全规避 OOM
    processLine(line);
  }
}
2. 浏览器环境:利用 Web Worker 隔离主线程
如果在浏览器端必须对内存中已有的大字符串进行解析,且无法避免生成数组,则切勿在主线程直接执行。耗时数百毫秒的密集计算会导致用户界面完全冻结、动画掉帧、点击无响应。此时应当将文本传递给 Web Worker:
// main.js: 主线程派发
const worker = new Worker('parser.worker.js');
worker.postMessage({ rawText: bigText, delimiter: '
' });

worker.onmessage = (e) => {
  const { type, chunk } = e.data;
  if (type === 'chunk') {
    renderBatchToTable(chunk);
  } else if (type === 'done') {
    hideLoadingSpinner();
  }
};
工程实践中的注意事项与边界防护
1. V8 字符串最大长度限制
不同版本的 V8 引擎对单个字符串的最大字符长度存在硬件和架构限制。在较新的 64 位 Node.js 与 Chrome 环境中,单字符串最大限制通常约为 1,073,741,799 个字符(约 1GB 文本);在旧版本或受限容器环境中可能仅有 512MB。一旦超出该阈值,在读取或拼接大字符串时会直接抛出 RangeError: Invalid string length。如果数据体量接近该上限,必须使用流(Streams)或分片(Blob/Buffer)切分,不能试图在内存中保留单个字符串。
2. 跨平台换行符兼容处理
在处理由不同操作系统生成的文件时,Windows 系统使用
,而 Linux/macOS 使用
。如果简单使用 text.indexOf('
'),提取出的行末可能残留不可见的 字符,导致后续数值转换(如 parseInt)或正则匹配出现非预期异常。优化代码中应增加行尾清理:
// 移除潜在的
 尾巴
const cleanLine = line.endsWith('
') ? line.slice(0, -1) : line;
3. 空数据与连续分隔符的边界防护
当大字符串开头、末尾存在分隔符,或文本中存在连续分隔符(如两个连续换行符)时,indexOf 截取的 substring(start, next) 会返回空字符串 ""。在编写游标提取逻辑时,应根据实际业务规范明确是否需要跳过空项(if (line.length === 0) continue;),避免将冗余的空字符串存入批次数组中白白占用槽位。
4. 性能与内存的正确评测方式
在评估大字符串转数组的优化效果时,单纯使用 console.time() 只能测量执行时间,无法反映堆内存压力。在 Node.js 环境中,应结合 process.memoryUsage() 监控堆内存峰值:
function measureHeapImpact(label, taskFn) {
  if (global.gc) global.gc(); // 需要以 --expose-gc 启动 Node.js
  const beforeMem = process.memoryUsage().heapUsed;
  const start = performance.now();

  taskFn();

  const end = performance.now();
  const afterMem = process.memoryUsage().heapUsed;

  console.log(`[${label}] 耗时: ${(end - start).toFixed(2)} ms | 堆内存增量: ${((afterMem - beforeMem) / 1024 / 1024).toFixed(2)} MB`);
}
通过严格的基准测试可以验证:将传统的 split() 升级为基于 indexOf 的滑动游标生成器或定长分块缓冲后,不仅能将堆内存峰值降低 70% 至 90%,更彻底消除了由老生代全量 GC 带来的系统卡死风险,确保海量文本解析任务在高并发与受限环境下平稳运行。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章