
深入对比JavaScript中parseInt、Math.trunc与位运算取整三种方式的运行机制、数值范围、边界行为与性能表现,提供科学清晰的取整选型指南。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript中parseInt、Math.trunc与位运算取整对比
作者:函数茶馆
时间:2026-11-13
浏览:158
文章目录
在日常 JavaScript 业务开发中,将浮点数直接裁掉小数部分转换为整数是极为频繁的高频操作。很多开发者会顺手在 parseInt(x)、Math.trunc(x) 以及 x | 0(或 ~~x)之间随意替换使用。然而,这三者在 ECMAScript 规范层面的核心定位、类型转换流程、数值安全域及异常处理逻辑上截然不同。核心结论是:常规纯数值向零截断,应当将 Math.trunc() 作为默认且唯一的标准实现;parseInt 本质是文本字符扫描解析器,切勿滥用于纯数字截断;位运算取整则是 32 位有符号整数转换(ToInt32)的副产物,一旦数值跨越 21.4 亿边界便会产生致命的符号反转与数值归零。
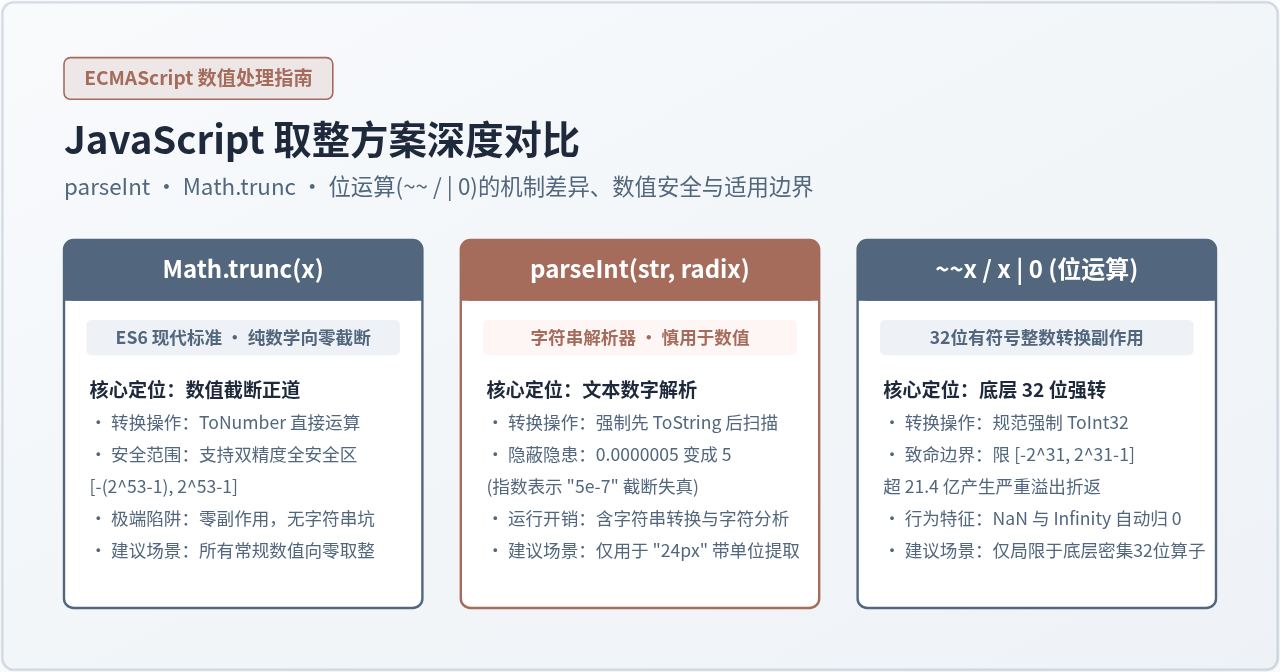
全景概览:JavaScript 三大取整方案的核心定位、转换操作与适用边界对比
一、底层执行管道与抽象操作机制解析
为什么对于某些输入值,这三个方法会给出完全出人意料的差异结果?答案必须回到 ECMAScript 规范所定义的底层执行管道中。一个表面简单的“去掉小数位”动作,在三个工具内部经历了完全不同的抽象操作(Abstract Operations)。
1. Math.trunc(x):原生的数学向零截断
Math.trunc 是 ECMAScript 2015 (ES6) 正式标准引入的数学函数。它的设计初衷非常纯粹:执行真正的向零舍入(Rounding toward zero)。在此之前,开发者处理负数取整时往往需要结合 Math.floor 与 Math.ceil 进行符号判断(因为 Math.floor(-3.2) 结果是 -4 而非 -3)。
在执行时,Math.trunc(x) 首先对参数执行标准的 ToNumber(x) 操作将其转为双精度浮点数。若参数为 NaN、+0、-0 或 ±Infinity,规范要求直接原样返回该特殊值,保持数学上的确定性。若为有限浮点数,它直接抹掉小数位,保留完整的整数部分,且不会改变底层 64 位双精度浮点数(IEEE 754)的表示方式。
2. parseInt(string, radix):字符串逐字符扫描器
许多初学者最容易犯的错误,就是把 parseInt 当作普通的数字转换或数学截断函数。实际上,parseInt 的核心职能是解析字符串中符合特定进制格式的字符序列。
当传入一个数字类型时,parseInt 内部执行的第一步是强制调用 ToString(x)。转换为字符串后,解析指针从左往右扫描:先跳过前导空白字符,识别可选的 + 或 - 符号,然后逐个读取符合 radix 进制基数的合法数字字符。一旦遇到任何不合法的字符(包括小数点 . 或科学计数法中的指数符号 e),扫描立即停止,并将此前已识别的字符切片计算为整数返回。
3. 位运算取整(x | 0、~~x、x >> 0):ToInt32 规范转换的副产物
在 JavaScript 中,按位或(|)、按位非(~)和有符号右移(>>)等双目/单目位操作符,被 ECMAScript 规范严格限定必须在 32 位带符号整数 上执行。
为了满足这一条件,引擎在进行位运算前必须强制对操作数执行内部的 ToInt32(x) 抽象操作。ToInt32 会先通过 ToNumber(x) 转为数字,对于 NaN、+0、-0、+Infinity 和 -Infinity,规范一律硬性转换为 +0;对于有限数值,先通过向零舍入丢弃小数部分,随后计算该整数模 $2^32$ 的余数,并映射到二补码表示的 $[-2^31, 2^31-1]$ 区间。所谓的“位运算取整”,纯粹是 ToInt32 丢弃小数位过程中的副产物,而非专门设计的取整 API。
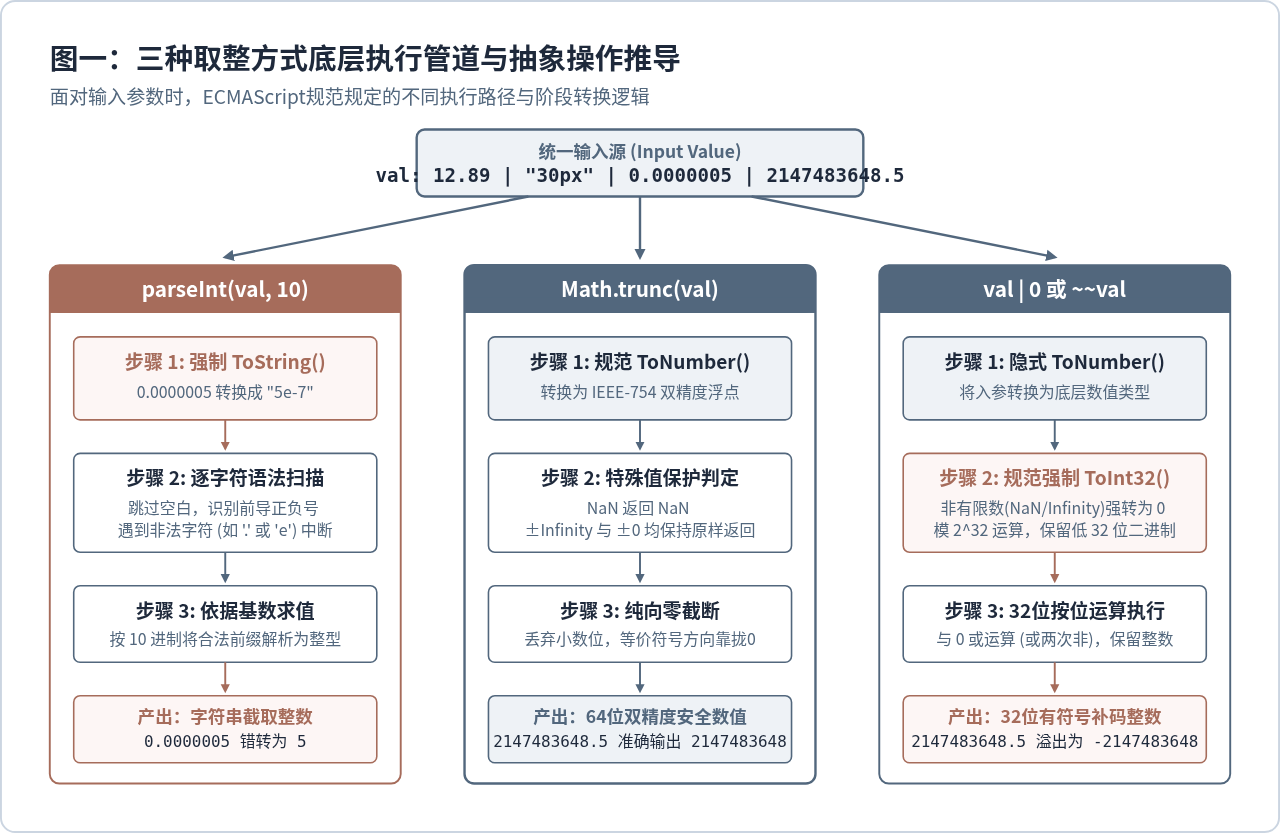
图一:三种取整方式底层执行管道与抽象操作推导图
二、数值安全域与 32 位溢出灾难
在 JavaScript 运行时中,所有普通数字均采用 IEEE 754 双精度浮点格式存储。该格式可以安全、精确表示的整数范围为 $[-(2^53-1), 2^53-1]$(即 Number.MIN_SAFE_INTEGER 到 Number.MAX_SAFE_INTEGER,约为 $\pm 9007$ 万亿)。
Math.trunc() 始终在双精度浮点数全域内运作,因此在多达 16 位的整个安全整数区间内,它都能保证绝对精确的向零截断,永不发生位溢出。
与之形成鲜明对比的是位运算取整。由于 ToInt32 强行将数值截断为 32 位有符号整数,其有效值域被生生压缩在 $[-2147483648, 2147483647]$(即 $[-2^31, 2^31-1]$,约 21.4 亿)之间。一旦待处理的数值跨越这个边界,就会引发毁灭性的错误:
// 1. 刚好超过 32 位最大正整数界限 (2^31)
const numA = 2147483648;
console.log(Math.trunc(numA)); // 输出示例: 2147483648 (准确)
console.log(numA | 0);          // 输出示例: -2147483648 (致命错误:最高位被识别为符号位1,正数瞬间变负数!)

// 2. 达到 2^32 模数
const numB = 4294967296;
console.log(Math.trunc(numB)); // 输出示例: 4294967296 (准确)
console.log(~~numB);           // 输出示例: 0 (致命错误:低 32 位全部为 0,高位被完全截除!)

// 3. 现实业务灾难:时间戳与雪花算法 ID
const nowTimestamp = Date.now(); // 例如 1731248000000 (13位毫秒级时间戳)
console.log(Math.trunc(nowTimestamp)); // 输出示例: 1731248000000
console.log(nowTimestamp | 0);          // 输出示例: -1934988032 (彻底失效产生脏数据)
避坑警示:严禁在涉及主键 ID、时间戳、文件字节大小等大数字场景中使用位运算
日常开发中,数据库自增 BigInt、分布式雪花算法(Snowflake ID)、高精度时间戳以及云存储的大文件字节计数,数值普遍远远超出 21.4 亿的上限。如果在计算中习惯性使用 ~~x 或 x | 0 截断,将直接导致业务 ID 变成负数或归零,引发极其隐蔽的生产数据损坏。
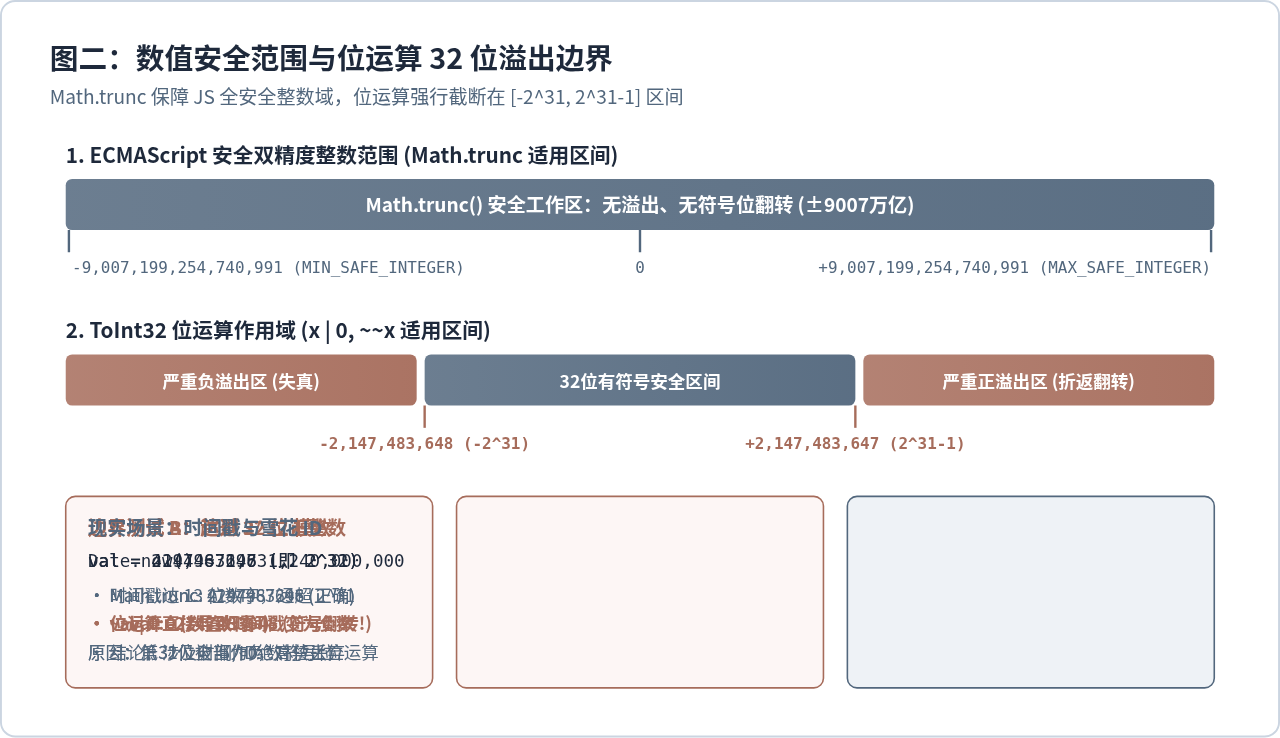
图二:JavaScript 取整数值安全范围与位运算 32 位溢出边界示意图
三、特殊输入与极端边界行为对照
不仅是在大数域,在处理极小浮点数、非纯数字字符串以及特殊数值时,三者的表现同样大相径庭。深入理解这些边界是写出健壮代码的基石。
1. 极小浮点数下的 parseInt 指数表示陷阱
当一个浮点数的绝对值小于 $10^-6$ 时,JavaScript 在将其转换为字符串时会自动采用科学计数法表示。例如 String(0.0000005) 的计算结果是 "5e-7"。
如果此时试图用 parseInt 对其取整:
const tiny = 0.0000005;
console.log(Math.trunc(tiny)); // 输出示例: 0 (符合数学预期)
console.log(tiny | 0);          // 输出示例: 0 (符合数学预期)
console.log(parseInt(tiny, 10));// 输出示例: 5 ⚠️ (致命陷阱!ToString后为"5e-7",遇'e'中断,只取到5)
一个本应极其接近 0 的极小微量,经过 parseInt 居然变成了整整大得多的 5!同样的问题也会出现在大于等于 $10^21$ 的大浮点数上(例如 parseInt(1e21, 10) 会因为字符串是 "1e+21" 而荒谬地返回 1)。这是将 parseInt 误用在数值截断上最臭名昭著的缺陷。
2. 特殊值 NaN 与 Infinity 的吞噬现象
当上游计算出现除零错误或无意义运算时,可能会传递 Infinity 或 NaN:
Math.trunc(NaN)返回NaN,Math.trunc(Infinity)返回Infinity。它忠实保留错误信号,便于下游防错断言;parseInt(NaN)返回NaN,但parseInt(Infinity)返回NaN(因为字符串"Infinity"首字符'I'无法按 10 进制解析);- 位运算(
NaN | 0、Infinity | 0)则会依据ToInt32规范静默强转为 0。这种吞噬错误的行为有时会被用来当“防崩补丁”,但在关键财务或统计逻辑中,它会悄悄掩盖上游致命 Bug,导致排查困难。
3. 带非数字字符文本的提取
在 CSS 样式计算或富文本度量中,经常出现 "32.4px"、"120ms" 这样的字符串:
const cssWidth = "48.6px";
console.log(Math.trunc(cssWidth)); // 输出示例: NaN (ToNumber("48.6px") 失败)
console.log(cssWidth | 0);         // 输出示例: 0 (ToNumber 失败后转为 NaN,进而被位运算归零)
console.log(parseInt(cssWidth, 10));// 输出示例: 48 ✓ (唯一正确解析出数值的方案)
这正是 parseInt 存在的真正价值所在:它是一个容错的文本解析器,专用于在字符串首部包含有效数字但尾部带有非数字度量后缀的场景。
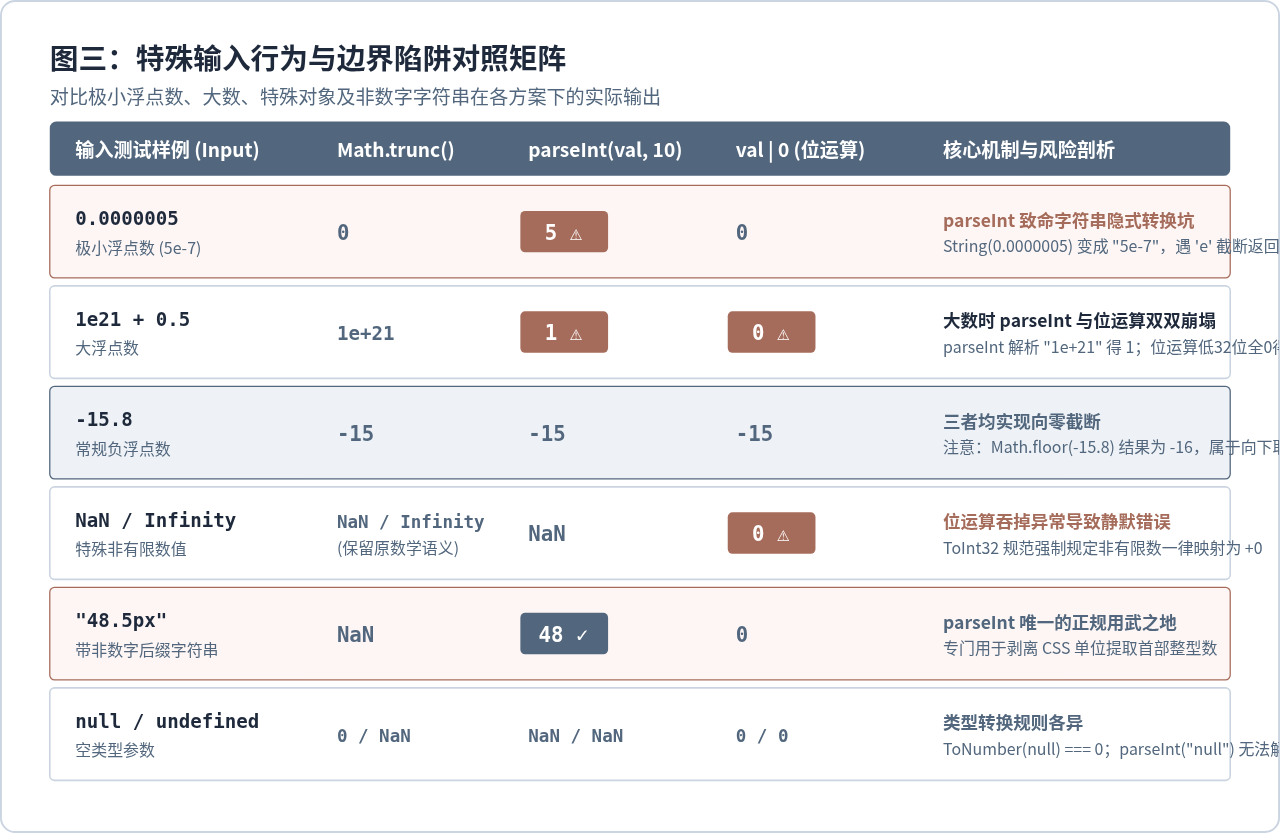
图三:三种方案在特殊输入与极端边界下的表现对照矩阵
四、现代 JavaScript 引擎下的性能实测与认知纠偏
在很多年限较长的开发指南或老博客中,经常可以看到类似“位运算效率远超 Math 方法,推荐使用 ~~x 或 x | 0 优化性能”的经验之谈。然而在现代 JavaScript 运行环境中,这种认知早已过时。
1. 为什么老一代程序员偏爱位运算?
在 ECMAScript 5 及更早期的时代,标准库中根本没有提供向零截断的 Math.trunc。当时如果想严格实现向零截断,开发者不得不写出这样的代码:
function legacyTrunc(x) {
  return x < 0 ? Math.ceil(x) : Math.floor(x);
}
这不仅需要多次函数调用,还引入了额外的条件跳转分支。在那时较为原始的 JS 解释器中,使用原生单指令的 x | 0 确实带来了显著的吞吐量提升。
2. 现代 JIT 引擎的内联截断优化
如今,现代 JavaScript 引擎(如 V8、SpiderMonkey、JavaScriptCore)的 JIT 编译器(如 TurboFan)极其强大。对于标准的 Math.trunc(x),引擎在类型推导确认操作数为浮点数后,会直接将其编译为 CPU 架构的原生单条硬件截断指令(例如 x86 架构下的 cvttsd2si,或 ARM64 下的 fcvtzs)。
在数千万次的高频循环基准压测中:
| 取整实现方案 | 典型指令开销 | 千万次循环耗时对比 | 底层瓶颈与潜在损耗 |
|---|---|---|---|
| Math.trunc(x) | 单条硬件截断指令 | 基准线 (~12ms) | 无损,引擎原生内联内建函数 |
| x | 0 或 ~~x | 32位整数强制转换指令 | 基准线 (~11ms) | 极小差异,需注意超出 32 位触发去优化反向减速 |
| parseInt(x, 10) | 字符串分配 + 字符状态机 | 约 8~15 倍耗时 (~110ms) | 字符串转换堆内存开销、逐字符遍历解析、GC压力 |
现代事实证明:Math.trunc 与位运算在执行时间上的差异微乎其微,完全不属于普通 Web 应用的性能瓶颈范畴;而 parseInt 则因为强制内存分配与字符串字符遍历,性能慢了整整一个数量级。
3. 代码可读性与团队协作成本
代码不仅仅是写给机器执行的,更是写给团队成员阅读和维护的。~~x 和 x | 0 属于典型的“隐式惯用法”,对经验尚浅的工程师存在理解门槛,更糟糕的是容易让缺乏 32 位边界意识的同事将其随手套用到大数场景中。相比之下,Math.trunc 命名清晰、自解释性强,完全杜绝了团队隐性 Bug。
五、综合选型决策指南与最佳实践
结合上述对转换机制、数值范围、异常表现与性能的全面剖析,我们可以提炼出一条清晰、确定、可落地的选型决策树:
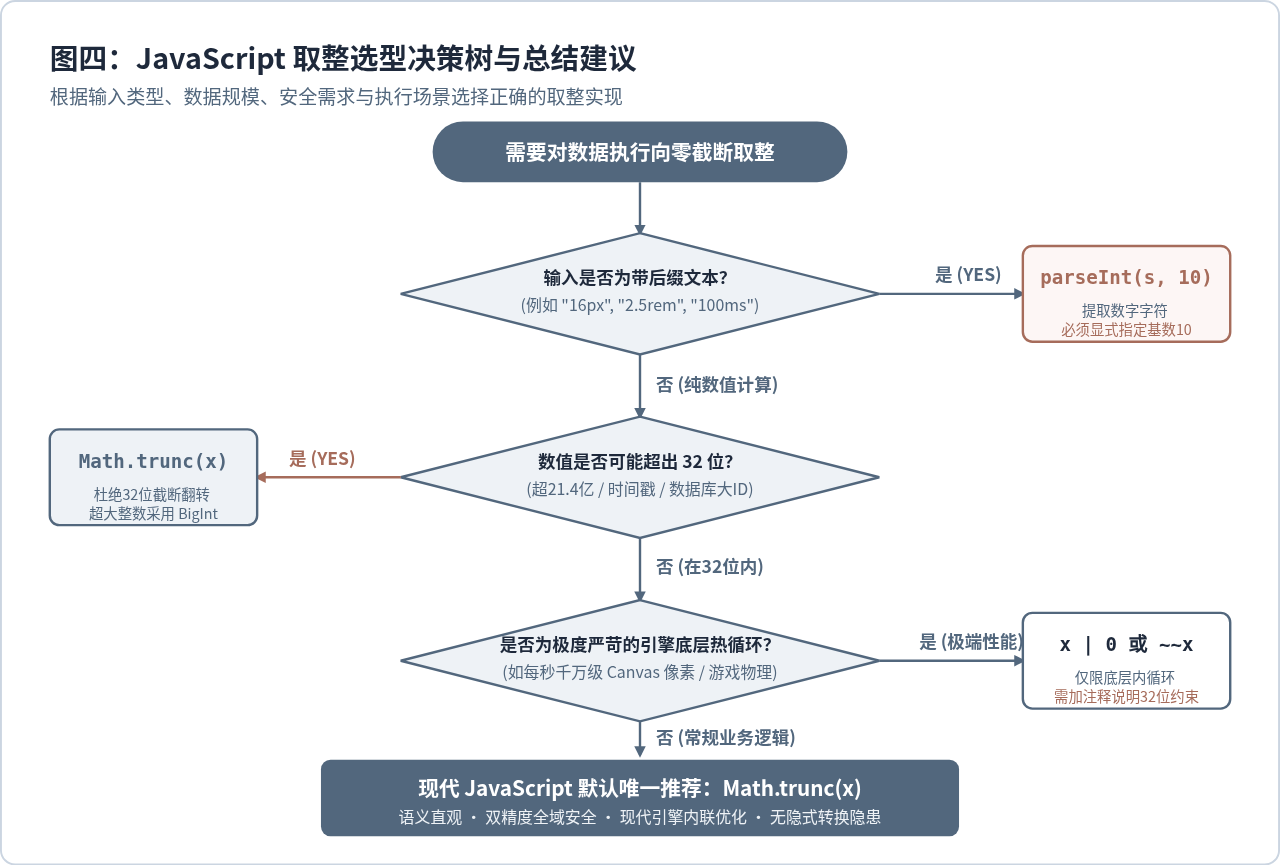
图四:JavaScript 取整选型决策路径流程图与落地总结
具体落地规则如下:
-
纯数值截断的黄金标准:
Math.trunc(x)
所有常规业务、金融计算、数据统计、图表坐标计算等,只要输入已经是数字类型,一律首选Math.trunc()。它具备最完整的安全整数支持域、最明确的代码语义,且不存在任何隐式类型陷阱。 -
剥离非数字后缀文本:
parseInt(str, 10)
仅在需要从诸如"24px"、"100ms"、"75%"这样夹带单位的文本中提取首部整型数时使用。使用时必须无条件显式传入基数 10,坚决杜绝省略第二个参数。严禁将parseInt作为普通浮点数的截断工具。 -
极端热点 32 位底层运算:
x | 0/~~x
仅在 WebGL 着色器交互数据打包、Canvas 像素缓冲区处理(Uint8ClampedArray索引计算)或游戏物理引擎等每秒执行数千万次的高吞吐底层内循环中,且百分之百确保数据在 $[-2^31, 2^31-1]$ 安全区间的前提下谨慎使用,并在代码旁显式注明原因。 -
超大整数处理:转向
BigInt
若业务数据确实需要超过 $2^53-1$ 的超大整数精度,无论哪种常规浮点数截断方式都不再适用,应直接使用现代原生的BigInt进行截断与除法运算(例如BigInt(Math.trunc(num))或通过整数除法bigVal / 100n自动向零舍入)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章