
深入对比JavaScript中字符串转浮点数的常用方式:parseFloat、Number()与一元加号+的核心原理、字符扫描机制、空字符串与边界值处理差异,以及开发中的最佳实践与避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS字符串转浮点数:parseFloat、Number与一元加号的区别
作者:清欢
时间:2026-11-05
浏览:353
文章目录
在 JavaScript 中,将字符串转为浮点数最常见的三种方式是
parseFloat()、Number() 与一元加号 +。它们的核心区别在于:parseFloat() 采用宽松的前缀逐字符解析,能自动提取前导数值并忽略末尾的非数字字符(例如把 "12.5px" 解析为 12.5),但会将空字符串判定为 NaN;而 Number() 和一元加号 + 底层均依据 ECMAScript 规范的 ToNumber 规则执行严格的整体类型转换,任何杂质字符都会导致转换结果变为 NaN,但它们会把空字符串和纯空格字符串静默转换为 0。理解这些内在差异,是避免线上出现异常计算与默认值 Bug 的关键。
一、核心机制差异:宽松前缀解析 vs 严格整体转换
很多开发者初学 JavaScript 时容易将 parseFloat() 与 Number() 混为一谈,甚至认为一元加号仅仅是 parseFloat() 的语法糖。事实并非如此,这两类方案在底层遵循截然不同的转换逻辑。
parseFloat(string) 是一个专门针对字符串的解析器。如果传入的参数不是字符串,引擎会先调用 ToString 抽象操作将其强制转换为字符串,随后从左到右逐个字符扫描,截取最长可构成合法浮点数的前缀。一旦遇到任何不能作为有效数字的字符(例如字母、符号或第二个小数点),扫描立刻停止,并返回已经识别出的数值。
相比之下,Number(value) 与一元加号 +value 属于原生的类型强制转换运算符,底层直接调用规范定义的 ToNumber 抽象操作。这种转换要求被解析的字符串在去除首尾空白后,必须从头到尾百分之百符合数字字面量的严格语法。哪怕字符串仅在末尾包含一个非数字字符,整个转换过程也会被判定为失败并返回 NaN。
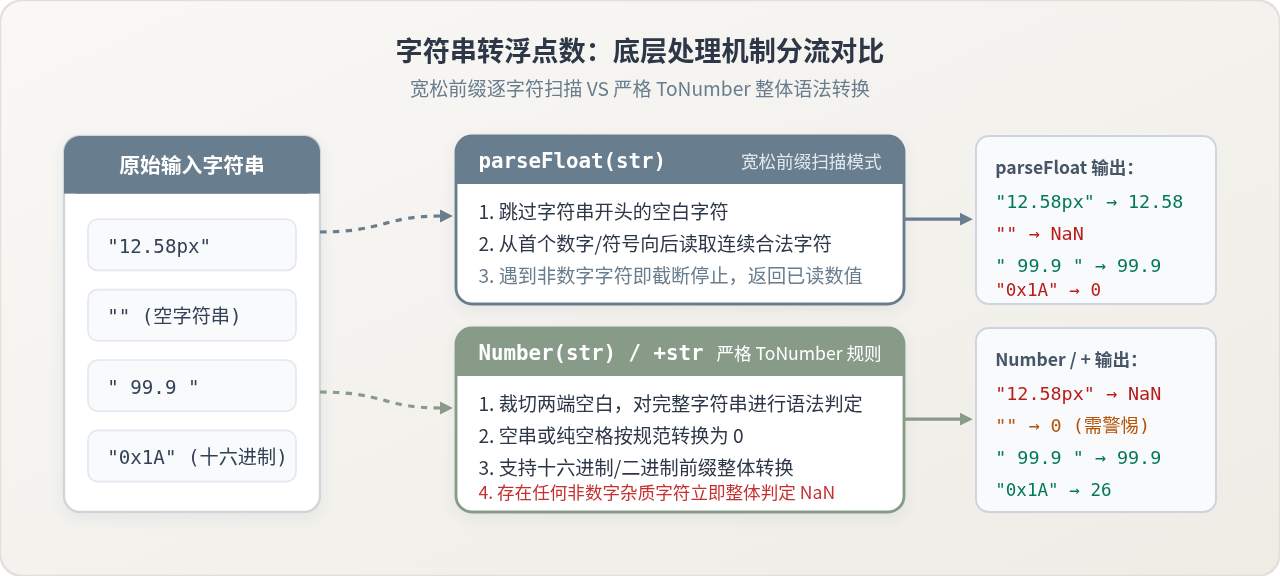
下面的简短代码直观地反映了两者的行为分流:
// 1. 含有非数字后缀时
parseFloat("18.5rem"); // 18.5(提取有效数字前缀)
Number("18.5rem");     // NaN(存在非数字字符,整体失败)
+"18.5rem";            // NaN(与 Number() 行为完全一致)

// 2. 处理空字符串时
parseFloat("");        // NaN(找不到有效数字前缀)
Number("");            // 0(ECMAScript 规范规定空串转为 0)
+"";                   // 0
二、逐字符解析过程:parseFloat 的工作原理
为了更清晰地理解 parseFloat 的容错性,我们需要掌握它的字符扫描状态机。当我们将字符串(例如 " -18.75rem")传递给 parseFloat 时,引擎在内部会经历以下明确的推导阶段:
- 跳过前导空白:解析器首先扫描前几个字符。如果字符属于制表符、空格、换行符等空白符,指针直接后移,不将其视为非法输入。
- 捕获符号位:检查有效字符的第一位是否为正号
+或负号-。如果是,则将其作为符号记录下来;如果不是,则直接进入整数扫描阶段。 - 读取整数序列:连续读取
0-9的十进制数字字符,直至遇到非数字符号。 - 处理小数点:当遇到第一个小数点
.时,解析器将其判定为小数分隔符,并继续向后读取后续的十进制数字。需要注意的是,如果后续再次遇到第二个小数点,解析器会将其视作终止符。 - 识别科学计数法指数:如果扫描到小写字母
e或大写字母E,且其后紧随可选符号及连续数字,解析器能正确解析指数部分(例如"1.2e3")。 - 截断并终止返回:一旦遇到既不是十进制数字、也不是合法指数标志的字符(例如
"r"),解析器立刻截断,放弃后续所有未读取字符,输出已捕获的数值。如果开篇第一个有效字符就无法识别,则直接输出NaN。
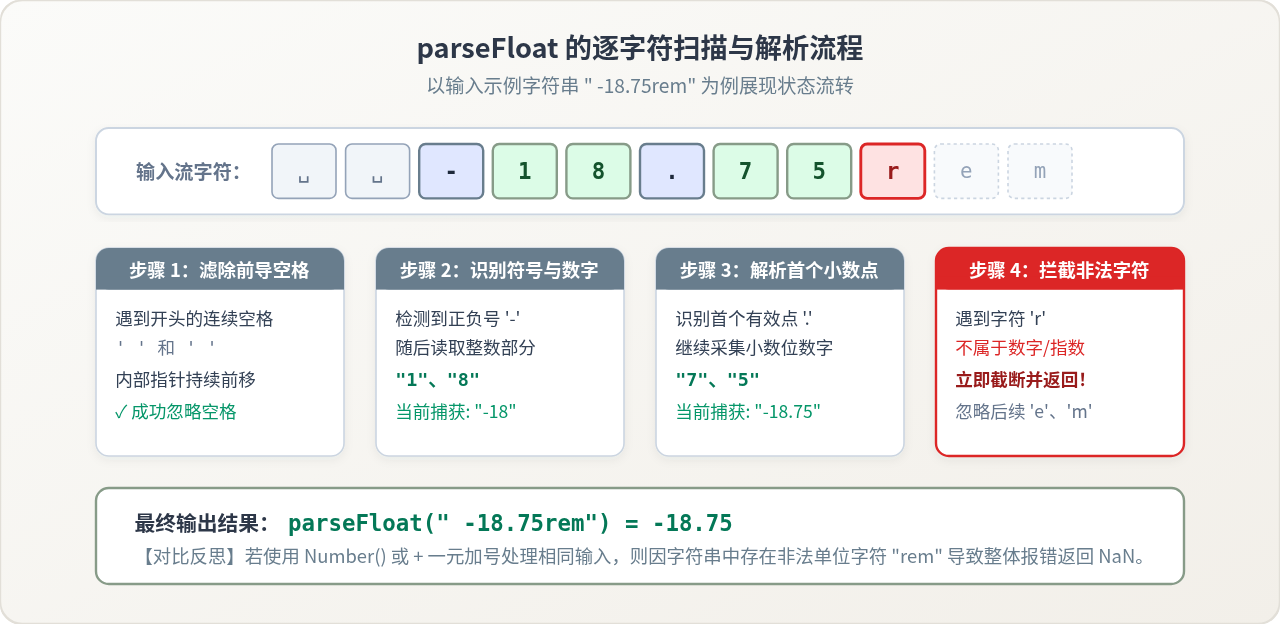
这种容错截断机制赋予了 parseFloat 极佳的文本容错能力,尤其适用于解析带有单位的 CSS 尺寸或者用户带有后缀的自然语言输入。但在需要高精度数据校验的场景下,这也可能成为掩盖脏数据的隐患。
三、边界值与特殊情况对比:空串、空白与非数字字符
在真实业务开发中,最容易引发线上隐患的往往不是正规的浮点数格式,而是空值、非字符串类型以及特殊格式输入。
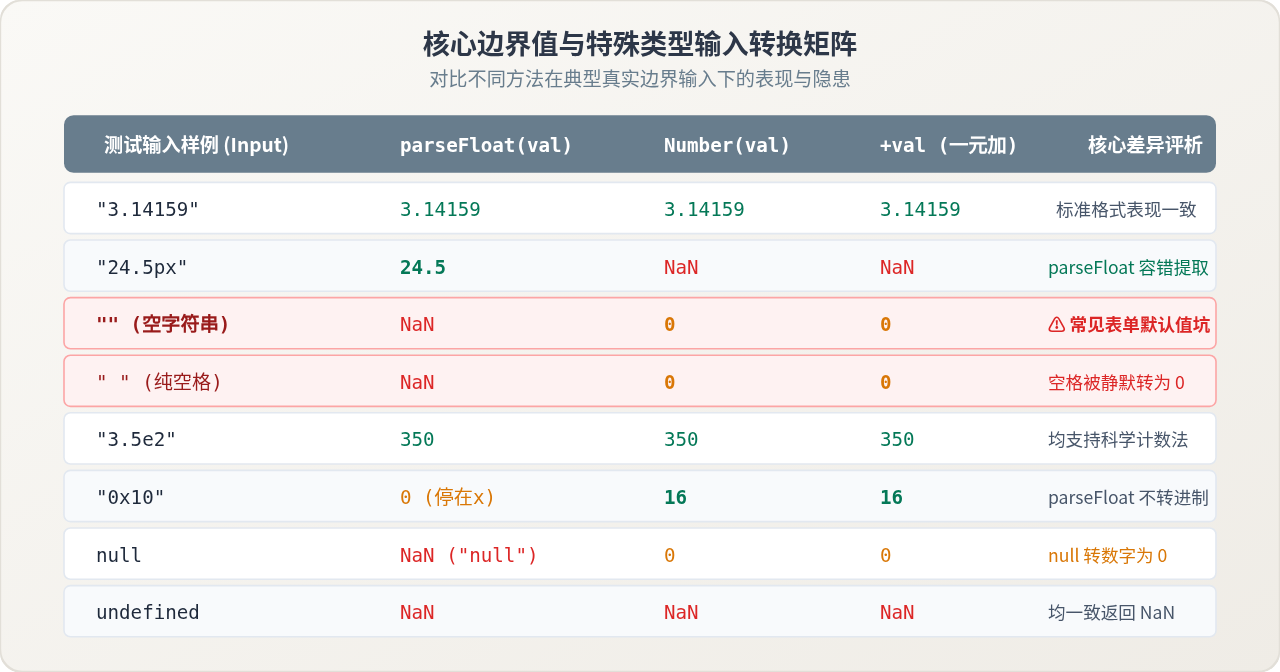
1. 空字符串与纯空白字符的致命差异
这是三者在日常开发中最具破坏性的差异:
parseFloat("")和parseFloat(" ")返回NaN。因为扫描器在跳过空白后没有读取到任何数字字符。Number("")、Number(" ")、+""、+" "均返回0。
⚠️ 业务避坑警示:在表单提交或数据过滤场景中,用户未填写表单导致输入为空字符串
"" 时,如果直接使用 +val 或 Number(val) 转换,空输入会被无声无息地转换为 0。如果字段代表商品折扣、温度或年龄,0 具有极其特殊的业务含义,这将导致本应为“未填写”的校验逻辑彻底失效。
2. 进制前缀解析差异
JavaScript 允许在数字字面量中使用 0x(十六进制)、0b(二进制)和 0o(八进制)前缀:
Number("0x10")和+"0x10"能够识别进制前缀,将其转换为十进制数字16。parseFloat("0x10")不支持十六进制解析。它读取到0之后,遇到字符x判定为非法字符,截断终止,最终返回0。
3. 非字符串类型的隐式强制转换
当参数非字符串时,差异进一步放大:
// 传入 null
parseFloat(null);       // NaN,因为先转成字符串 "null",首字符 'n' 无法解析
Number(null);           // 0,ToNumber(null) 规定返回 0
+null;                  // 0

// 传入 undefined
parseFloat(undefined);  // NaN,字符串为 "undefined"
Number(undefined);      // NaN
+undefined;             // NaN

// 传入布尔值
parseFloat(true);       // NaN,字符串为 "true"
Number(true);           // 1,ToNumber(true) 规定返回 1
+true; // 1| 对比维度 | parseFloat(str) | Number(str) | +str (一元加号) |
|---|---|---|---|
| 转换规范依据 | ECMAScript 字符串逐字符扫描算法 | ECMAScript ToNumber 抽象操作 | ECMAScript ToNumber 抽象操作 |
| 带单位后缀 (如 "12.5px") | 提取数值 12.5 |
返回 NaN |
返回 NaN |
空字符串 "" |
返回 NaN |
转换为 0 |
转换为 0 |
纯空格字符串 " " |
返回 NaN |
转换为 0 |
转换为 0 |
十六进制 "0x1A" |
返回 0(无法跨越字符 x) |
转换为 26 |
转换为 26 |
参数为 null |
返回 NaN |
转换为 0 |
转换为 0 |
参数为 true |
返回 NaN |
转换为 1 |
转换为 1 |
| 执行性能 | 需逐字符遍历字符串,开销略高 | 引擎内部优化,速度较快 | 运算符单指令级处理,速度最快 |
四、一元加号与 Number() 的内在联系与风格取舍
在语言底层规范中,一元加号表达式 +expr 的执行流程是先求得表达式的值,随后直接调用内部的 ToNumber()。而全局函数 Number(expr) 同样直接将参数委托给 ToNumber()。因此在功能与转换结果上,两者是 100% 等价的。
它们唯一的区别在于语法形式、代码可读性与微小的性能倾向:
- 代码语义性:
Number(value)的意图极其明确,即便是没有深厚 JS 经验的维护者也能一眼看出这是类型转换。而一元加号+value容易被误认为是正负符号,或者在配合其他运算符时产生混淆(例如a + + b)。 - 执行效率:在 V8 引擎的高频热点代码中,一元加号由于是基础运算符,不需要函数调用的语法封装,微基准测试中吞吐量通常略微领先,因此常见于算法实现或动画逐帧计算中。
五、实战场景选型与安全转换方案
在实际项目开发中,选择哪种方式取决于具体的业务场景与输入数据的可信度。我们可以借助下面的决策流程进行技术选型:
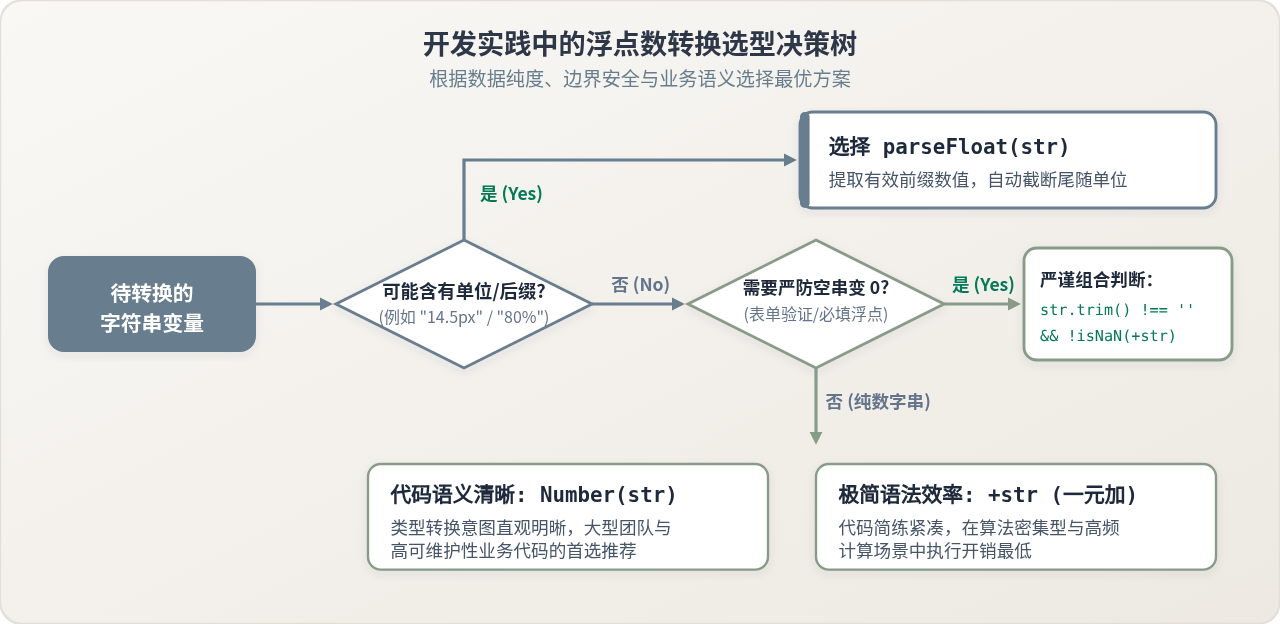
场景 1:提取带单位的界面尺寸(推荐 parseFloat)
当需要从 DOM 节点的计算样式、CSS 变量或配置中读取尺寸值时,字符串往往带有 px、rem、% 等后缀。此时只有 parseFloat 能够优雅胜任:
function getContainerWidth(element) {
  const widthStr = window.getComputedStyle(element).width; // 例如 "384.75px"
  const widthNum = parseFloat(widthStr);
  return Number.isNaN(widthNum) ? 0 : widthNum;
}
场景 2:表单输入严格校验(严防空串被转为 0)
在处理用户填写的金额、重量或评分时,输入值要求必须是纯数字,且绝不允许将未填写的空字符串自动当成 0。建议结合 trim() 与严格转换:
function parseStrictFloat(rawInput) {
  // 1. 确保为字符串并剔除首尾空白
  if (typeof rawInput !== "string") {
    return NaN;
  }
  const trimmed = rawInput.trim();

  // 2. 防御性拦截:空字符串直接判定为非法,不转为 0
  if (trimmed === "") {
    return NaN;
  }

  // 3. 使用严格转换,拦截含有非数字字符的内容
  const result = Number(trimmed);
  return Number.isNaN(result) ? NaN : result;
}

// 验证执行结果
parseStrictFloat("  28.90  "); // 28.9
parseStrictFloat("");          // NaN(成功阻断)
parseStrictFloat("28.9px");     // NaN(成功拦截杂质)
💡 最佳实践建议:在团队项目编码规范中,日常业务逻辑推荐优先使用具备自解释性的
Number(str),并辅以针对空字符串的显式防范;当明确需要解析单位后缀时,显式使用 parseFloat(str);而在对执行性能极其敏感、且已在入参处确保数据为纯数字格式的算法中,才使用一元加号 +str。
六、浮点数计算避坑提醒
成功将字符串转换为浮点数之后,在进行后续数值运算时,还需要警惕 JavaScript 基于 IEEE 754 双精度浮点数标准带来的二进制精度误差:
- 经典精度陷阱:
parseFloat("0.1") + parseFloat("0.2") === 0.30000000000000004。 - 如果业务涉及电商支付、资金计算等敏感场景,不宜直接拿转换后的原生浮点数做累加或比对,应在业务中采用整数(以“分”为单位)运算,或引入专业的精度数学库。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章