
深入解析JavaScript中处理Emoji表情与多字节增补区生僻汉字时的字符串索引陷阱,剖析UTF-16编码机制,并提供Intl.Segmenter与字节预算安全截断的最佳实践方案。

当前位置:首页 > JavaScript 基础 > 正文
JavaScript处理Emoji和多字节中文切割的索引陷阱
作者:小括号
时间:2026-11-04
浏览:408
文章目录
在 JavaScript 中直接使用
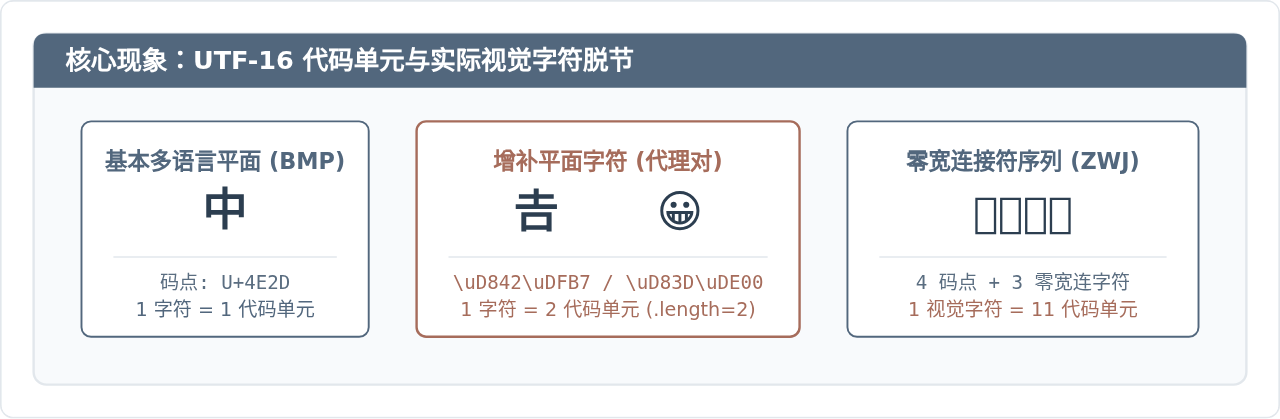
str.slice()、str.substring() 或 str.length 处理文本时,计算基准并不是视觉字符,而是 UTF-16 代码单元(Code Unit)。当字符串中包含 Emoji(如 😀、👨👩👧👦)或 Unicode 增补区生僻汉字(如“𠮷”、“𪚥”)时,单个字符会跨越 2 个或多达十几个代码单元;粗暴依索引切分必然会斩断代理对(Surrogate Pair)或字素序列,产生乱码字符 Intl.Segmenter 按字素簇(Grapheme Cluster)安全分割,或在受限场景下配合 TextEncoder 进行安全字节预算截断。
一、现象剖析:看似正常的切片为何破坏了字符?
在日常开发中,对用户昵称、动态简介做截断展示是极高频的需求。开发者习惯直接使用 str.slice(0, 5) 或 str.substring(0, 10)。在纯英文或常见中文环境下,这种操作几乎不会出错。然而一旦遇到用户输入特有生僻字或表情符号,字符串就会出现肉眼可见的裂痕。
// 示例 1:增补汉字(如“𠮷”字,U+20BB7)
const rareName = "𠮷祥";
console.log(rareName.length); // 输出: 3 (并非预期的 2)
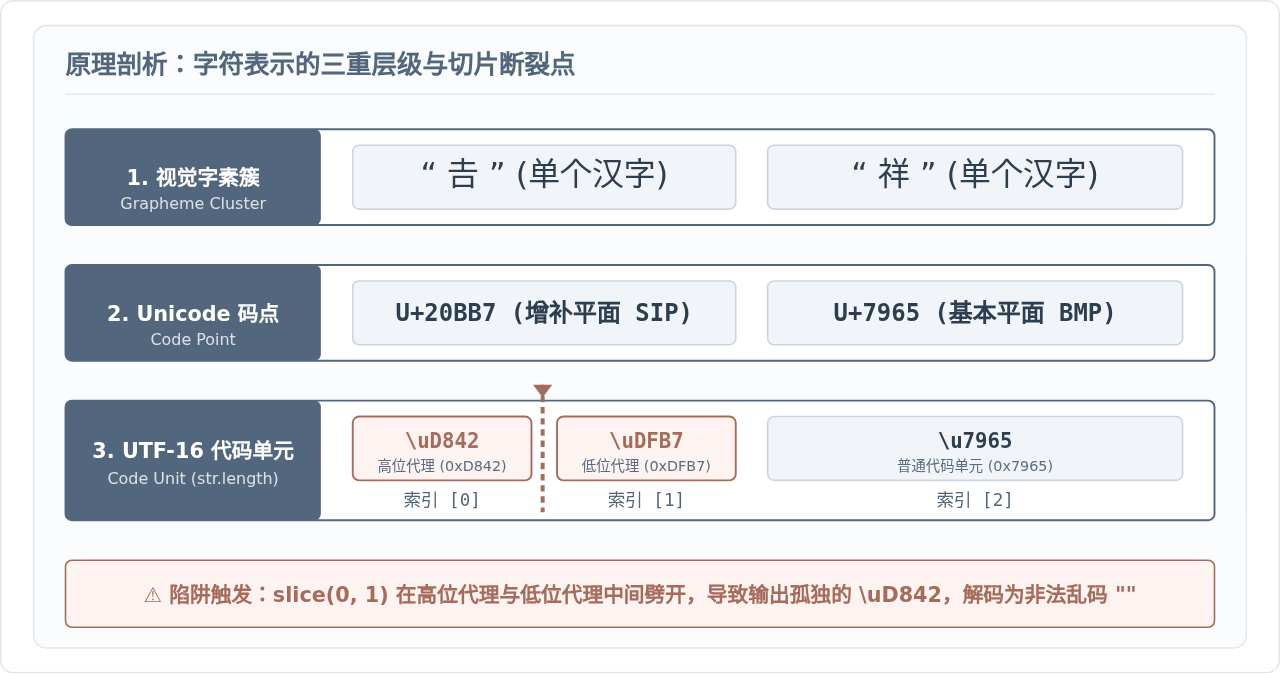
console.log(rareName.slice(0, 1)); // 输出: "\uD842" (展示为乱码 "")
console.log(rareName.slice(0, 2)); // 输出: "𠮷"
// 示例 2:标准 Emoji
const greeting = "😀你好";
console.log(greeting.length); // 输出: 4
console.log(greeting.slice(0, 1)); // 输出: "\uD83D" (展示为乱码 "")
// 示例 3:多码点复合 Emoji
const family = "👨👩👧👦一家人";
console.log(family.length); // 输出: 14
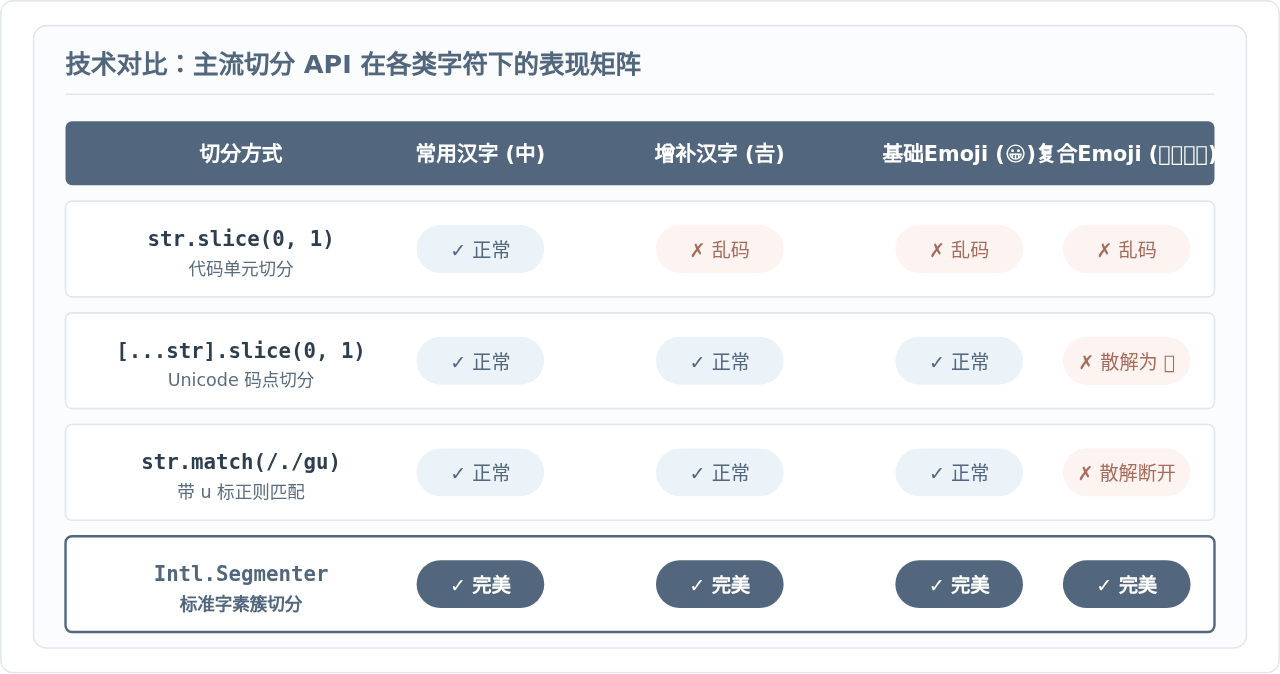
console.log(family.slice(0, 2)); // 输出: "👨" (仅截出爸爸,家庭散解)
之所以产生上述令人费解的结果,关键在于 JavaScript 语言规范(ECMAScript)在设计初期沿用了 16 位 Unicode 编码。在规范中,所有基于索引的字符串 API(包括 charAt、charCodeAt、slice、substring、substr 以及方括号属性访问 str[i])全部严格操作于 UTF-16 代码单元(Code Unit),而非 Unicode 码点(Code Point),更不是用户肉眼感知的字符(Grapheme Cluster)。
二、核心机制:UTF-16 代理对与多字节汉字
为了准确处理这类问题,必须理清 UTF-16 的编码规则:
- 基本多语言平面(BMP,U+0000 到 U+FFFF):覆盖了绝大部分常用现代文字(包括 2 万余个常用汉字)。在 UTF-16 中,这些字符正好占用 1 个 16 位代码单元(2 字节),因此其视觉字符数、码点数与代码单元数完全重合。
- 增补多语言平面(SMP/SIP 等,U+10000 到 U+10FFFF):容纳了扩展汉字(如中日韩统一表意文字扩展区 B/C/D/E/F/G 等)、古代文字以及绝大部分 Emoji。因为 16 位无法容纳超过
0xFFFF的数值,UTF-16 规定使用一对 16 位数值来共同表达一个码点,称为代理对(Surrogate Pair):- 高位代理(High Surrogate):取值范围为
0xD800到0xDBFF。 - 低位代理(Low Surrogate):取值范围为
0xDC00到0xDFFF。
- 高位代理(High Surrogate):取值范围为
注意:孤立的高位或低位代理在 Unicode 规范中是非法的。如果字符串在切分时恰好砍在代理对中间,剩下的半个字符就会变成孤立代理(Lone Surrogate)。当传给不支持的数据库(如仅支持标准 UTF-8 的系统)、JSON 序列化器或网络接口时,极易诱发致命的序列化或解析异常。
三、深层隐患:比代理对更复杂的 Emoji 复合序列
如果说处理增补区生僻字只需要保障“码点(Code Point)”完整,那么处理 Emoji 则要面对更深层次的复合字符序列(ZWJ Sequence)。
例如家庭表情 👨👩👧👦 看上去只是 1 个图标,但它并非单一码点,而是由 4 个独立的 Emoji 码点(👨、👩、👧、👦)通过 3 个零宽连接符(Zero-Width Joiner,U+200D)串联起来的组合体。其在底层包含了整整 11 个 UTF-16 代码单元:
// 👨 (2单元) + ZWJ (1单元) + 👩 (2单元) + ZWJ (1单元) + 👧 (2单元) + ZWJ (1单元) + 👦 (2单元) = 11单元
const familyEmoji = "👨👩👧👦";
console.log(familyEmoji.length); // 11
console.log([...familyEmoji].length); // 7 (码点展开,依然拆成了多个碎片)
不仅是家庭表情,国旗表情(如 🇨🇳 由两个区域指示符号 U+1F1E8 和 U+1F1F3 组合而成,包含 4 个代码单元)、带肤色与性别的职业表情(如 🏃🏽♀️ 由跑步者 + 肤色修饰符 + ZWJ + 女性符号组合而成)均属于此列。如果采用传统的按码点扩展语法(如 Array.from(str) 或 [...str]),虽然不会斩断单个代理对,但依然会破坏复合序列,导致表情退化为多个离散符号。
四、排查与安全截断执行步骤
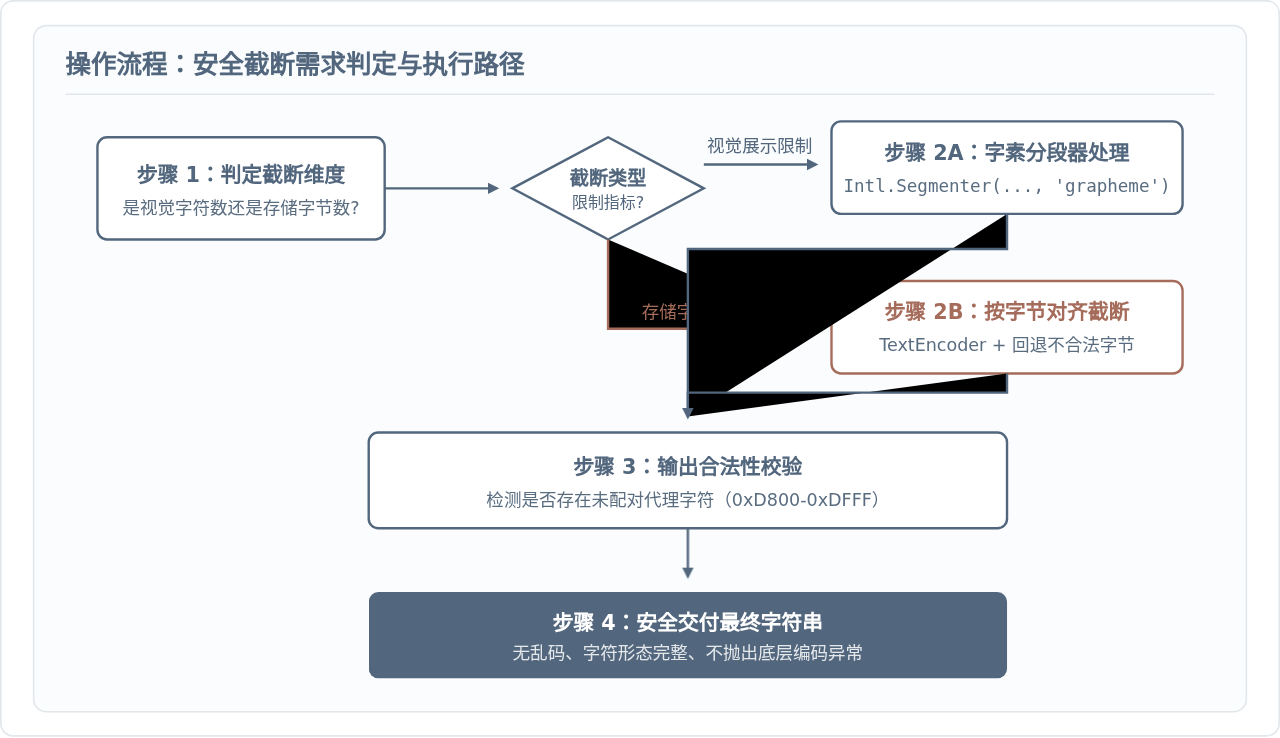
在实际工程开发中,当面临“文本限制前 N 个字符”或“超出限制截断加省略号”的需求时,推荐按照以下规范化的流程进行处理:
五、具体实现:开箱即用的解决方案
1. 现代标准解法:基于 Intl.Segmenter 的安全截断
ECMAScript 2022 正式引入了 Intl.Segmenter API。它严格遵循 Unicode 文本分割标准(UAX #29),能精准识别各种复杂 Emoji 序列、变体选择符和汉字,是目前最为标准、优雅的解法:
/**
* 安全截取指定视觉字符数(Grapheme Clusters)的字符串
* @param {string} text 原始文本
* @param {number} maxGraphemes 最大允许的视觉字符数
* @param {string} [ellipsis=""] 超出时追加的省略符
* @returns {string} 截断后的安全字符串
*/
function safeSlice(text, maxGraphemes, ellipsis = "") {
if (typeof text !== "string" || maxGraphemes <= 0) return "";
// 检测环境是否支持 Intl.Segmenter (现代浏览器与 Node.js 16+ 全面支持)
if (typeof Intl !== "undefined" && Intl.Segmenter) {
const segmenter = new Intl.Segmenter("zh-CN", { granularity: "grapheme" });
const segments = Array.from(segmenter.segment(text), s => s.segment);
if (segments.length <= maxGraphemes) {
return text;
}
return segments.slice(0, maxGraphemes).join("") + ellipsis;
}
// 降级方案:使用扩展运算符按 Unicode 码点切分(可防生僻汉字破坏,但无法处理复合Emoji)
const codePoints = [...text];
if (codePoints.length <= maxGraphemes) {
return text;
}
return codePoints.slice(0, maxGraphemes).join("") + ellipsis;
}
// 示例运行
const input = "𠮷祥如意👨👩👧👦迎新春";
console.log(safeSlice(input, 3, "..."));
// 正确输出: "𠮷祥如..."
console.log(safeSlice(input, 5, "..."));
// 正确输出: "𠮷祥如意👨👩👧👦..." (完整保留了复杂的全家福Emoji,没有任何碎片)2. 后端对齐:基于 UTF-8 字节预算(Byte Budget)的防撕裂截断
在很多数据库字段设计中(例如 MySQL 的 VARCHAR(255) 或某些网络协议固定报文头部),限制并非来自界面字符数,而是底层 UTF-8 字节大小。此时,如果粗暴地把字符串编码为 Uint8Array 后按字节切断,断点很可能落在一个 UTF-8 多字节字符的中间(例如一个汉字占用 3 字节,Emoji 占用 4 字节),导致末尾残存非法字节序列。
/**
 * 按 UTF-8 字节长度限制安全截断文本,绝不切裂多字节字符或代理对
 * @param {string} str 输入文本
 * @param {number} maxBytes 最大字节预算
 * @returns {string}
 */
function truncateByBytes(str, maxBytes) {
  const encoder = new TextEncoder();
  const encoded = encoder.encode(str);

  // 未超出限制直接返回
  if (encoded.byteLength <= maxBytes) {
    return str;
  }

  // 使用 TextDecoder 配置 fatal: false 进行安全解码恢复
  // 切片后,利用 TextDecoder 的流式解析特性自动丢弃末尾不完整的字节
  const decoder = new TextDecoder("utf-8", { fatal: false, ignoreBOM: true });
  const slicedBytes = encoded.subarray(0, maxBytes);

  // 先解码截断后的字节
  let decoded = decoder.decode(slicedBytes);

  // 防御性检查:确保末尾不会包含孤立的 UTF-16 高位代理
  if (decoded.length > 0) {
    const lastCharCode = decoded.charCodeAt(decoded.length - 1);
    if (lastCharCode >= 0xD800 && lastCharCode <= 0xDBFF) {
      decoded = decoded.slice(0, -1);
    }
  }

  return decoded;
}

// 示例运行
const testData = "测试生僻字𠮷与Emoji😀";
// 4个常规汉字(12字节) + "𠮷"(4字节) = 16字节
console.log(truncateByBytes(testData, 14));
// 输出: "测试生僻字" (因为14字节装不下完整的4字节"𠮷",安全回退,绝不产出乱码)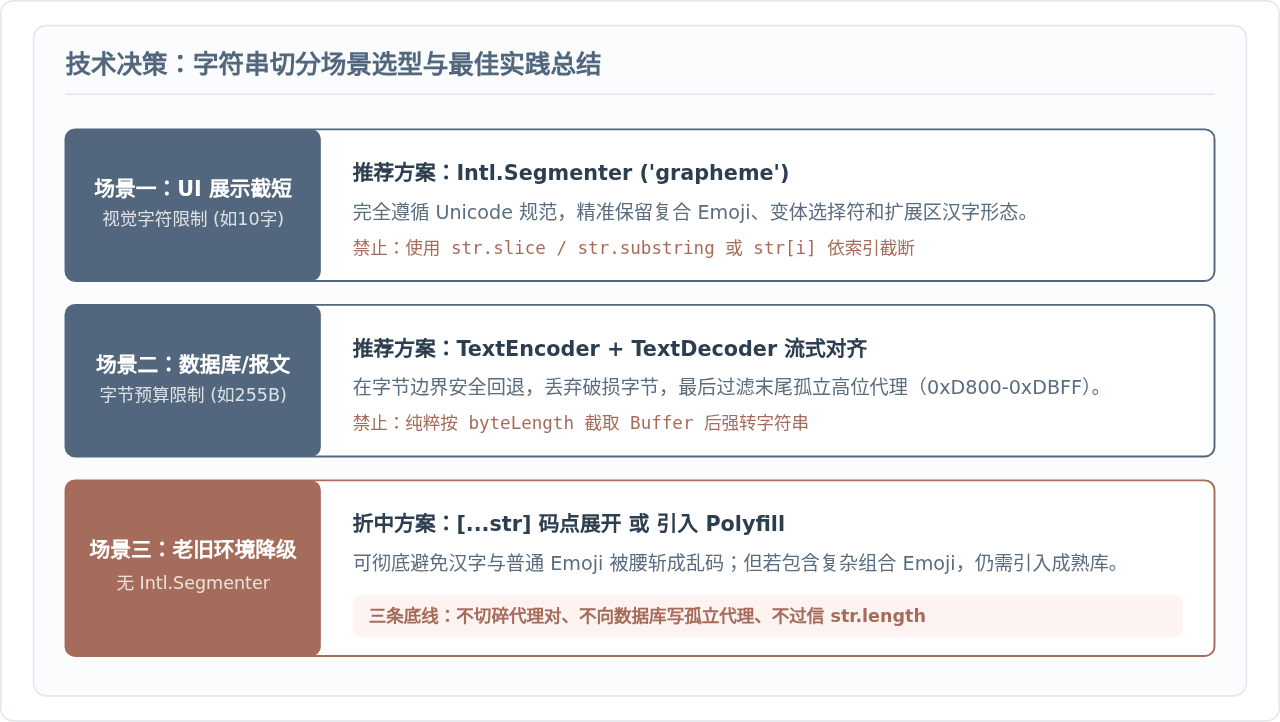
六、排查与总结清单
排查现有项目是否存在此类索引陷阱时,可重点检索以下几项代码模式:
- 全词搜索原生截断方法:全局检索
.slice(、.substring(、.substr(,检查其入参是否直接来源于固定长度,且截取对象为用户不受控输入的昵称、留言、标题等。 - 全词搜索索引访问:检查是否存在
str[0](如取姓氏或首字母)的操作。对于输入"𠮷祥",name[0]只会拿到无效的代理前半段"\uD842"。如果只需要取首字符,应使用Array.from(str)[0]或通过Intl.Segmenter获取第一段。 - 输入长度统计:界面上的“还可输入 10/20 字”计数器,若直接使用
value.length,会导致用户粘贴一个 Emoji 就扣除 2 到 11 个字符配额,带来极差的用户体验。应统一采用字素簇计数。
JavaScript 语言底层的 UTF-16 设计是早期标准的历史产物,但现代 ECMAScript 已经给出了完整的标准化能力。理解代码单元、Unicode 码点与字素簇之间的界限,是编写健壮、高可用现代 Web 应用程序的基础能力。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章