
深入解析 Quill Delta 数据规范与底层原理,提供在 Node.js 服务端与浏览器端实现 Delta 与 HTML 双向高效互转的工程方案、核心算法与避坑指南。

当前位置:首页 > JavaScript 项目实战 > 正文
Quill Delta 格式解析:怎么实现内容与 HTML 的互转
作者:小满
时间:2026-11-04
浏览:544
文章目录
主题:富文本数据架构与转换工程
核心协议:Quill Delta (OT 规范)
工程实践指南
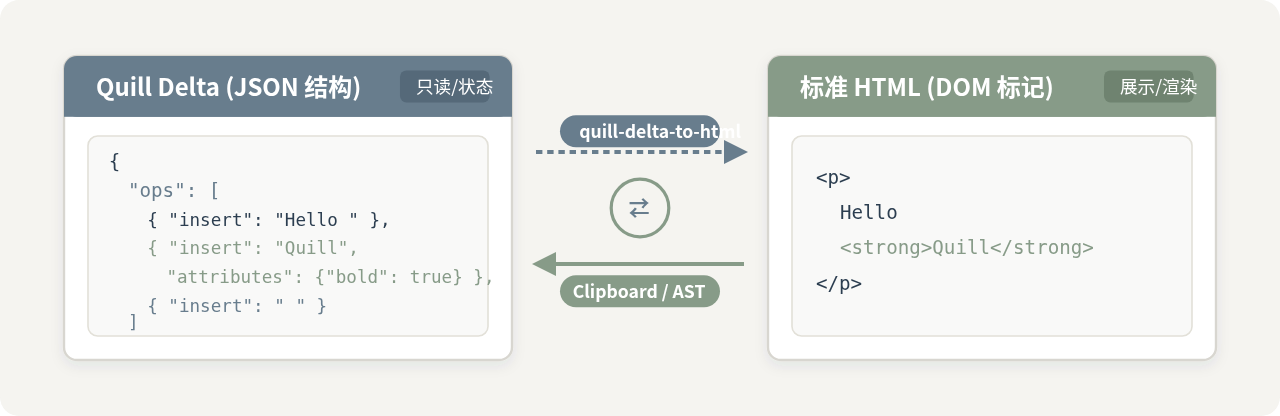
Quill Delta 是一种基于操作转换(Operational Transformation, OT)模型的精简 JSON 规范,它通过记录线性的
insert 操作序列来精确描述富文本的内容结构与排版样式。在现代 Web 架构中,前端富文本编辑器通常以 Delta 作为标准数据载体进行编辑与存储,而在服务端静态渲染(SSR)、SEO 页面抓取、邮件发送以及第三方平台分发时,必须将 Delta 转换为语义化的标准 HTML;反之,当导入历史文章、爬虫抓取数据或粘贴富文本时,又需要将杂乱的 HTML 解析还原为结构严密的 Delta。本文将全面拆解 Delta 的核心数据规范,并详细讲解两种格式在服务端与前端实现高效、准确互转的具体方案、核心算法与避坑指南。
一、深入理解 Quill Delta 数据结构与底层设计逻辑
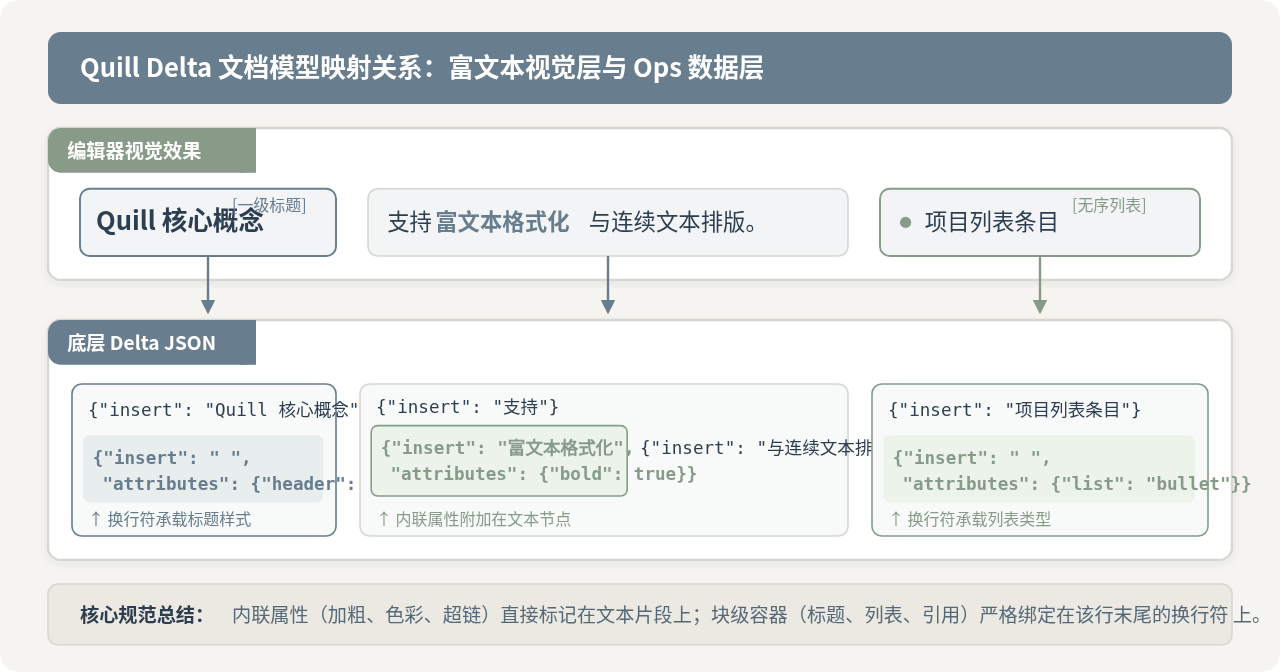
要实现高质量的格式互转,首先必须透彻理解 Quill Delta 的底层建模思想。与常见的基于树状 DOM(如 ProseMirror、Slate)的富文本模型不同,Quill 采用了一种极致扁平的线性序列来表示文档。一个完整的 Delta 文档是一个包含 ops 数组的 JSON 对象,每个操作单元代表一个离散的内容片段。
1. 操作类型的两面性:变更流与状态快照
Delta 在设计上兼具两种形态:在协同编辑过程中,它是一串包含 retain(保留光标偏移)、delete(删除字符)和 insert(插入内容)的变更操作指令集;而当文档完成编辑并被读取或持久化保存时(即通过 quill.getContents() 获取),它表现为一份纯净的文档状态快照——内部仅包含一系列 insert 操作。
2. 内联样式与块级样式的核心差异
理解 Quill Delta 转换的关键在于掌握其对样式的两种截然不同的绑定机制:
- 内联格式(Inline Formats):粗体、斜体、下划线、颜色、超链接等样式,直接挂载在被包裹文字片段的
attributes属性上。例如{ insert: "文本", attributes: { bold: true } }。 - 块级格式(Block Formats)与换行符绑定:这是 Quill 最独特的精妙设计。在 Delta 中,段落、标题、无序/有序列表、代码块、引用块等容器属性,并不作为外层父节点存在,而是全部附着在该行末尾的换行符
{ insert: " ", attributes: { header: 1 } }。如果换行符没有attributes,则代表普通的正文段落(<p>)。
3. 嵌入对象(Embeds)
除了纯文本,富文本中常见的图片、视频、公式、分割线等非文本内容被称为 Embeds。在 Delta 中,它们的 insert 属性值不再是字符串,而是一个键值对象。例如图片表示为 { insert: { image: "https://example.com/logo.png" } },分割线表示为 { insert: { divider: true } }。
二、Delta 转换为 HTML 的实现路径与服务端方案
将 Delta 转换为标准 HTML 是实际业务中最频繁的需求。例如在内容管理系统(CMS)中,用户在后台编辑提交后,前台展示页面需要通过服务端渲染(SSR)或静态网站生成器(SSG)直接输出 HTML,以保证秒开体验与搜索引擎爬虫抓取。
1. 方案一:使用生产级生态库 quill-delta-to-html
在 Node.js 服务端或构建脚本中,最稳健高效的方案是使用经过广泛验证的开源库 quill-delta-to-html。它无需启动庞大的无头浏览器或 JSDOM 环境,纯靠 JavaScript 内存字符串流处理,具有极高的吞吐性能。
// 安装依赖:npm install quill-delta-to-html
const { QuillDeltaToHtmlConverter } = require('quill-delta-to-html');

// 待转换的 Delta 数据
const deltaOps = [
  { insert: "Quill 架构解析" },
  { insert: "
", attributes: { header: 1 } },
  { insert: "了解 Delta 转换到 " },
  { insert: "HTML", attributes: { bold: true } },
  { insert: " 的全流程。
" },
  { insert: "支持列表渲染" },
  { insert: "
", attributes: { list: "bullet" } }
];

// 配置转换器参数
const converter = new QuillDeltaToHtmlConverter(deltaOps, {
  paragraphTag: 'p',
  inlineStylesFlag: true,      // 将格式输出为行内样式还是 class
  linkTarget: '_blank',         // 超链接自动追加 target 属性
  allowBackgroundClasses: false
});

// 执行转换
const html = converter.convert();
console.log(html);
// 输出结果:
// <h1>Quill 架构解析</h1>
// <p>了解 Delta 转换到 <strong>HTML</strong> 的全流程。</p>
// <ul><li>支持列表渲染</li></ul>
关键配置说明:
inlineStylesFlag 控制着文本样式的表达方式。若设为 false,转换器会输出带有 ql-font-serif、ql-size-large 等 class 属性的标签,此时展示端必须加载 Quill 官方自带的 quill.snow.css 或 quill.core.css;若设为 true,则会直接内联输出 style="color: #ff0000;",更加适合邮件模板或第三方富文本嵌入。
2. 方案二:自主实现核心分块与状态机转换算法
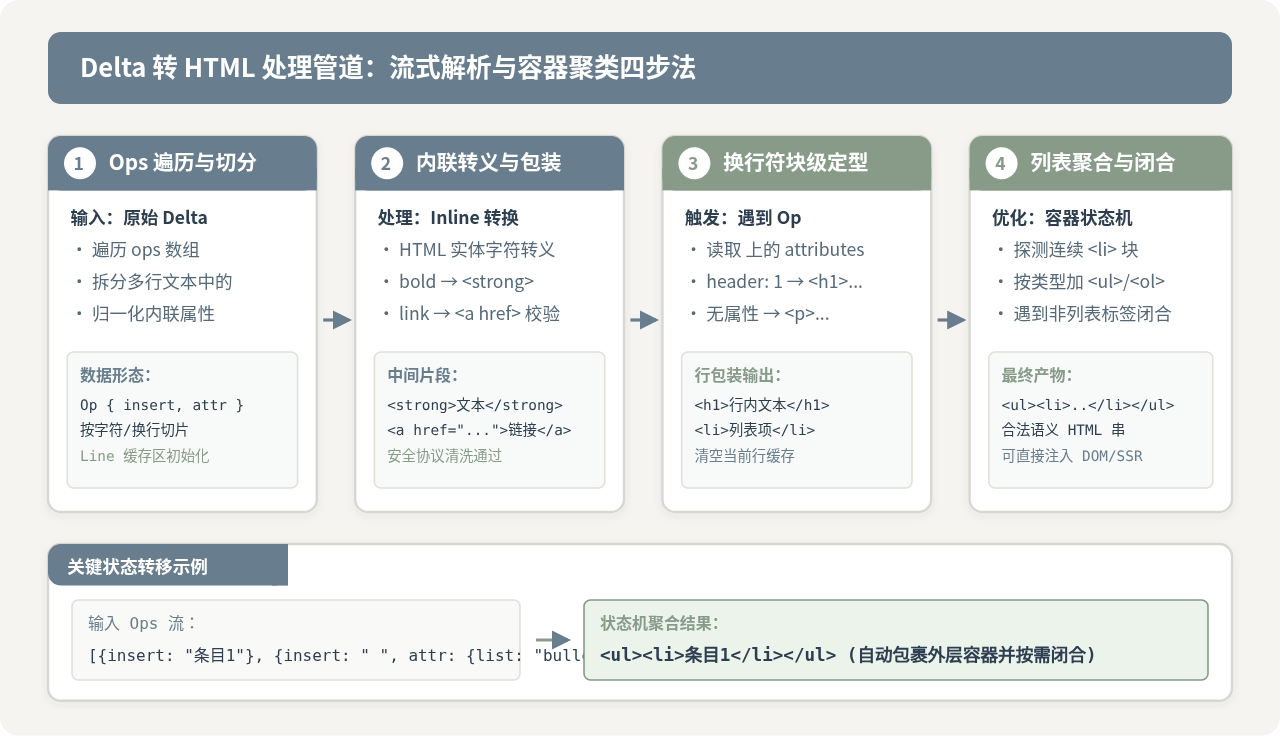
为了深刻掌握转换机理,我们可以拆解 Delta 转 HTML 的核心算法处理管道。整个算法遵循流式状态机模式,主要包含四个关键步骤:
- 行切分(Line Splitter):顺序读取 ops。若一个
insert字符串中包含多个 - 内联格式包装(Inline Formatter):对文本内容执行 HTML 实体转义(防止
<、>、&破坏标签结构),并依据其attributes从内向外包裹<strong>、<em>、<a href="...">等行内标签。 - 换行符触发块定型(Block Demarcator):一旦遇到包含
header、list、blockquote等键名,将当前行缓冲区的内联 HTML 字符串包裹为对应块级标签(如<h1>...</h1>),随后重置行缓冲区。 - 连续列表聚合状态机(List Aggregator):由于单个列表项在 Delta 中仅表现为一行
<li>,转换引擎必须维护一个列表状态机:当遇到第一个list块时插入<ul>或<ol>开标签;只要后续行持续为同类型列表项,就持续输出<li>;一旦遇到非列表块或文档结束,立即补全闭合标签</ul>或</ol>。
三、HTML 解析还原为 Delta 的实现原理与方案
将 HTML 还原为 Delta 的典型应用场景包括:从旧版富文本数据库导入历史数据、在编辑器中支持用户从外部网页/Word 中粘贴内容、以及通过爬虫采集文章后存入富文本系统。由于 HTML 存在语法宽容度高、标签嵌套层次任意、样式冗余分散等特性,这一方向的转换复杂度远高于 Delta 转 HTML。
1. 浏览器环境:利用 Quill 原生 Clipboard 模块
如果转换发生在前端浏览器中,最安全、精准的做法是直接调用 Quill 编辑器实例内置的 clipboard 模块。Quill 的底层核心框架 Parchment 内部注册了详尽的 DOM 节点匹配器(Matchers),能抹平各类浏览器生成的怪异 HTML 标签。
// 在浏览器前端环境中执行
const quill = new Quill('#editor', { theme: 'snow' });

const externalHtml = '<h2>导入文章</h2><p>这是一段带有 <b>加粗</b> 的文本。</p>';

// 方法一:将 HTML 直接转换并静默加载进编辑器
quill.clipboard.dangerouslyPasteHTML(0, externalHtml);

// 方法二:仅做纯数据转换,获取对应的 Delta 对象而不改变当前编辑器内容
const delta = quill.clipboard.convert({ html: externalHtml });
console.log(JSON.stringify(delta));
// 输出结果:
// {"ops":[{"insert":"导入文章"},{"attributes":{"header":2},"insert":"
"},{"insert":"这是一段带有 "},{"attributes":{"bold":true},"insert":"加粗"},{"insert":" 的文本。
"}]}
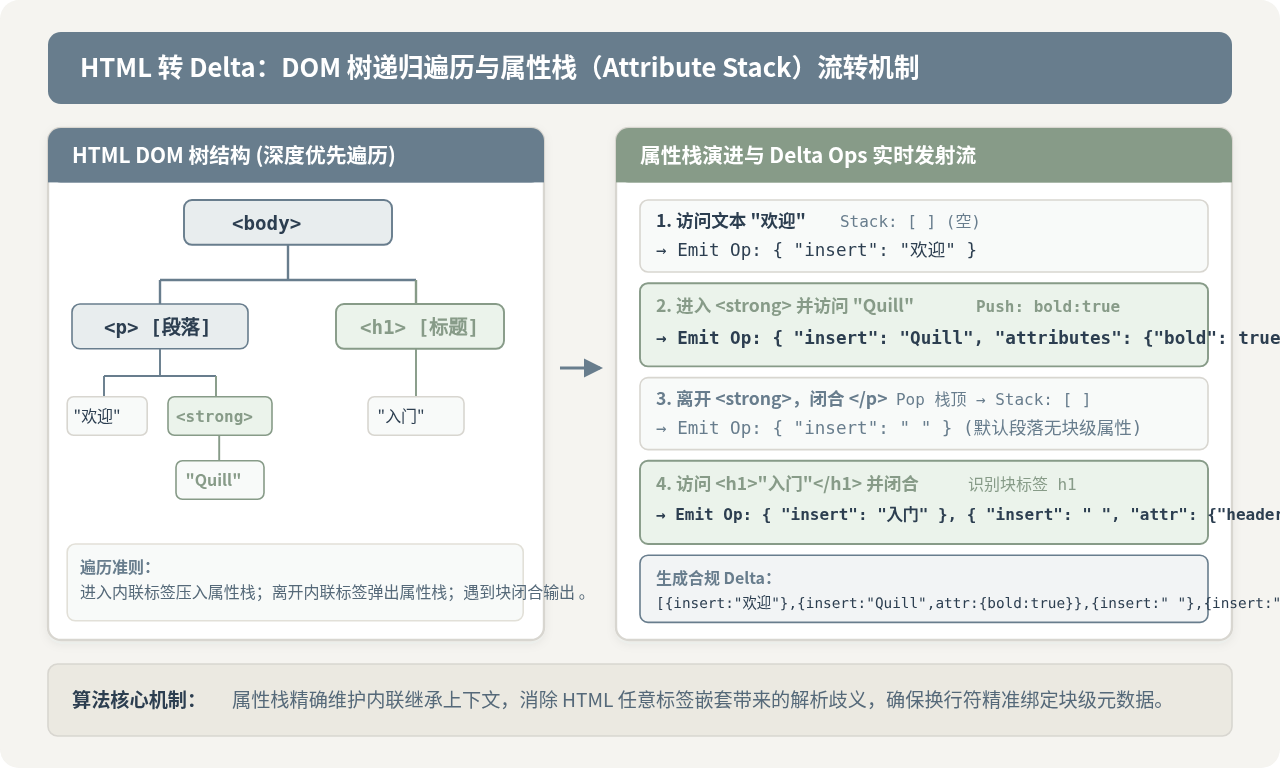
2. Node.js 无头服务端环境:属性栈(Attribute Stack)递归解析
在 Node.js 服务端进行批量数据迁移或 API 接口中转时,由于缺乏原生 window.document,通常有两种技术选型:
- JSDOM 模拟环境:引入
jsdom库构造出完整的全局 DOM 环境,随后实例化一个 Quill 对象调用clipboard.convert()。优点是转换规则与前端完全一致,缺点是 JSDOM 启动慢、内存占用大,难以支撑高并发批量处理。 - 轻量级 DOM AST + 属性栈算法(推荐):引入轻量级 DOM 解析库(如
node-html-parser或cheerio),通过递归遍历 DOM 树并维护一个“属性栈”来独立生成 Delta。
属性栈算法的核心运转机制如下:
- 栈式累加:遍历器向下递归访问子节点。当进入一个内联标签(如
<strong>、<a href="...">)时,解析其样式并推入当前属性栈; - 切片发射:当遇到纯文本节点时,取出当前栈中累加的所有活跃属性,与文本拼接发射为一个包含
attributes的{ insert: text, attributes }操作; - 栈顶弹出:完成内联标签内所有子节点的访问后,将对应样式从栈顶弹出,确保后续同级节点不被污染;
- 块级收尾:当一个块级标签(如
<p>、<h1>、<li>)遍历完毕时,向 Delta 追加该行专属的换行符 op:{ insert: " ", attributes: blockAttributes }。
四、方案对比与权衡:直接存储 HTML vs 存储 Delta 并在边界转换
在规划企业级内容管理平台、在线协同文档或多端内容发布系统时,架构师往往面临一个根本性的数据建模决策:数据库持久层到底应该直接存储富文本生成的 HTML,还是统一存储原生的 Quill Delta,并在展示边界按需转为 HTML?
为了清晰评估两种技术路线的影响,我们在一致的生产系统环境(支持多端消费、协同维护、长期演进)下对比关键维度:
| 对比维度 | 方案 A:直接持久化 HTML 字符串 | 方案 B:持久化原生 Delta并在边界按需转 HTML |
|---|---|---|
| 数据规范性与清洗难度 | 各浏览器富文本排版标签差异巨大,容易混入大量无用废弃标签(如 <span style="font-family:...">),二次清洗成本极高。 |
统一强类型 JSON 数组,数据规范纯粹一致,字段严格遵循 Delta Schema,天生具备数据纯净性。 |
| 协同编辑与版本追踪 | HTML 包含深层嵌套标签,多用户并发编辑时很难在字符粒度进行无冲突的 OT/CRDT 运算,极易造成标签错配导致崩溃。 | Delta 天生就是为操作转换(OT)设计的规范,支持毫秒级字符偏移计算与变更集(ChangeSet)追踪,协同编辑体验顺滑。 |
| 跨平台渲染与灵活性 | 在 iOS、Android、Flutter 或微信小程序等移动原生端,解析与渲染原生 HTML 异常繁琐,通常只能依赖高耗电的 WebView。 | Delta 作为纯数据结构,不仅能在 Web 端转 HTML,还能轻松转为 Flutter TextSpan、Markdown 或原生组件树。 |
| 安全性与 XSS 攻击面 | 直接持久化 HTML 存在极高的 XSS 注入风险,入库与出库必须配置复杂的 HTML 过滤白名单,稍有不慎便会造成漏洞。 | Delta 数据本身不具备执行能力;在输出边界转 HTML 时由转换引擎自动统一转义特殊字符,整体攻击面降到最低。 |
| 开发维护初期成本 | 开发门槛极低,前端 innerHTML 即可输出渲染,无需维护任何转换管道。 |
需要在前后端接入转换库,初期存在少量学习与适配成本。 |
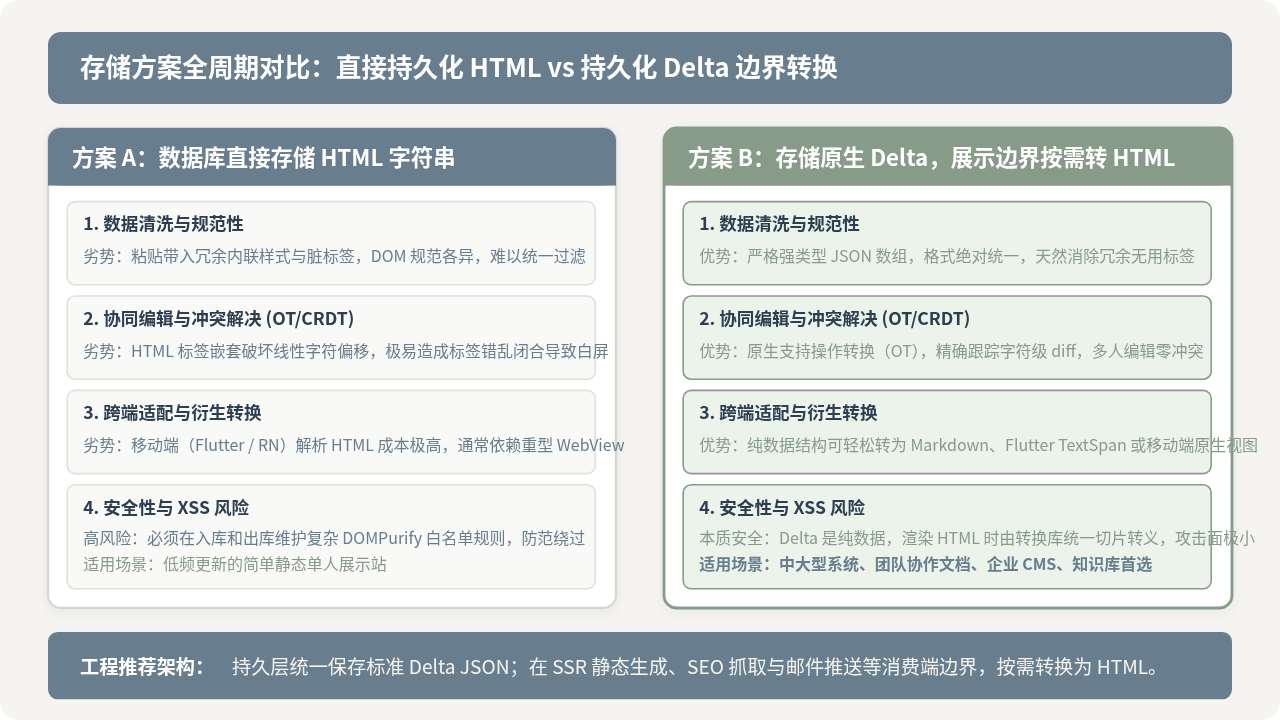
系统架构选型结论:对于简单的个人静态博客或只读展示页面,直接使用 HTML 确实简单迅速;但对于任何具备多端展示、协同编辑、内容审计或长期维护演进需求的业务系统,强烈推荐持久层统一保存标准化的 Delta JSON,仅在面向搜索引擎爬虫、静态页面生成或第三方 API 推送的边界层,按需将其转换为标准化 HTML。
五、双向互转中的关键细节与避坑指南
在双向转换的实际工程落地中,由于 HTML DOM 与线性 Delta 规范之间的概念映射差异,开发者极易遇到以下四类典型陷阱。提前做好针对性处理可以避免大量线上显示异常与解析 Bug。
1. 连续空行与空白字符折叠问题
在 Quill 编辑器中,用户敲击两次回车会产生一个空行,在 Delta 中记录为连续的 { insert: "
" }。但在标准 HTML 中,若将其单纯转换为 <p></p>,浏览器默认的盒模型与行高规范会将其高度折叠为 0,导致页面显示上空行完全消失。
避坑方案:在将 Delta 转换为 HTML 时,对于内容为空的段落行,务必输出为
<p><br></p>;反向将 HTML 转 Delta 时,遇到 <p><br></p> 或 <p> </p>,应精准还原为单字符 { insert: "
" },切勿引入无意义的多余空格。
2. 多级列表嵌套与缩进关系
HTML 的多级列表是通过嵌套标签实现的(例如 <ul><li>子项<ul><li>深层项</li></ul></li></ul>);而在 Quill Delta 中,列表项始终保持完全扁平,层级深度由换行符上的 indent 属性控制(例如 attributes: { list: "bullet", indent: 1 })。
在编写自定义转换逻辑时,如果遇到 indent: 2,需要正确维护一个缩进层级栈。当缩进增加时开启新的子列表标签,缩进减少时及时闭合多余的层级标签,避免出现标签未闭合导致的整个页面布局错乱。
3. 自定义 Blot 与 Embed 对象的注册丢失
Quill 允许开发者通过 Parchment 扩展自定义 Blot(例如代码高亮块、数学公式卡片、附件下载胶囊、用户提及 @ 标签等)。默认的转换库(如 quill-delta-to-html)无法自动识别这些自定义格式,通常会直接将其忽略跳过。
解决方案:必须在转换器实例化时显式注册自定义渲染器(Custom Embed Handlers)。例如:
converter.renderCustomWith(function(customOp, contextOp) {
  if (customOp.insert.type === 'user-mention') {
    const user = customOp.insert.value;
    return `<span class="mention" data-id="${user.id}">@${user.name}</span>`;
  }
});
4. 恶意链接与 XSS 协议注入防护
Delta 中的超链接格式为 attributes: { link: "..." }。如果用户在富文本中恶意构造了形如 javascript:alert(document.cookie) 或 vbscript:... 的伪协议链接,若在转 HTML 时直接将其拼装到 <a href="..."> 中,用户点击链接便会触发 XSS 跨站攻击。
安全规范:在将 Delta 转换为 HTML 时,务必对
link 属性执行严格的协议白名单检查。仅放行以 http://、https://、mailto:、tel: 开头的链接,任何不匹配白名单的协议均应强制重置为 about:blank 或剔除超链接标签。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章