
深入解析ES6+解构赋值与ES Modules模块化机制的核心概念、语法规则、模式匹配机制、实时绑定原理及工程最佳实践。

当前位置:首页 > JavaScript 基础 > 正文
ES6+新特性在JavaScript编程中的应用:解构与模块化
作者:小括号
时间:2026-10-30
浏览:103
文章目录
解构赋值与模块化机制是现代JavaScript(ECMAScript 2015及后续规范)中最具颠覆性且最高频使用的两项特性。解构赋值彻底改变了对象与数组中提取数据的语法形态,将繁琐的命令式属性访问转化为简洁明了的模式匹配;而官方标准模块(ES Modules,简称ESM)则从语言底层解决了长期存在的全局作用域污染、依赖拓扑混乱以及运行时打包难以深度优化等痛点。本文将围绕这两项核心特性的底层机制、语法规范、常见认知盲区以及实际工程应用展开系统讲解,帮助开发者构建清晰、健壮的代码设计思维。
一、解构赋值的底层机制与核心语法
解构赋值(Destructuring Assignment)本质上是一种语法糖,它允许我们使用类似于数组字面量或对象字面量的语法,从可迭代对象或普通对象中提取属性并赋值给独立变量。其底层依据的是“模式匹配”(Pattern Matching)原则:等号右侧为数据源,等号左侧为接收模式,两端结构一一对应进行解析。
1. 数组解构:按迭代器顺序匹配
数组解构的核心匹配规则是“位置对应”。由于数组及所有原生可迭代对象(如Set、Map、字符串)均实现了 Symbol.iterator 协议,解构引擎会依次驱动迭代器,将产出的值赋值给左侧对应位置的变量。
// 基础按序解构与元素跳过
const rgb = [255, 140, 0];
const [r, , b] = rgb;
// r: 255, b: 0

// 配合剩余元素(Rest Element)收集尾部数据
const [primary, secondary, ...others] = ['Vue', 'React', 'Angular', 'Svelte', 'Solid'];
// primary: 'Vue', secondary: 'React', others: ['Angular', 'Svelte', 'Solid']

// 经典应用:优雅交换变量(无需临时变量)
let x = 1, y = 2;
[x, y] = [y, x];
// x: 2, y: 1
2. 对象解构:按属性键名寻址
与数组按位置解析不同,对象解构依赖的是属性键(Key)的匹配,与属性在对象中的书写顺序完全无关。如果左侧变量名与右侧属性名相同,可直接简写;若需要修改本地变量名,则需使用别名语法 { 原属性名: 新变量名 }。
const user = {
  id: 1001,
  username: 'zhang_san',
  role: 'admin'
};

// 属性同名提取与别名重映射
const { username, role: userRole } = user;
// username: 'zhang_san', userRole: 'admin'
// 注意:原属性名 role 在当前作用域并未声明为变量,生效的是 userRole
3. 默认值的触发边界
解构赋值允许为变量设置默认值。但在实际开发中,开发者经常对默认值的触发机制产生混淆。ECMAScript规范明确规定:只有当解构目标值严格等于 undefined 时,默认值才会生效。如果属性值为 null、false、0 或空字符串 "",默认值均不会被触发。
const responseConfig = {
  timeout: 0,
  retries: null,
  debug: undefined
};

const {
  timeout = 3000,   // timeout 值为 0,严格不等于 undefined,解构结果仍为 0
  retries = 3,      // retries 值为 null,不等于 undefined,解构结果仍为 null
  debug = true,     // debug 值为 undefined,默认值生效,解构结果为 true
  cache = true      // 属性不存在即为 undefined,默认值生效,解构结果为 true
} = responseConfig;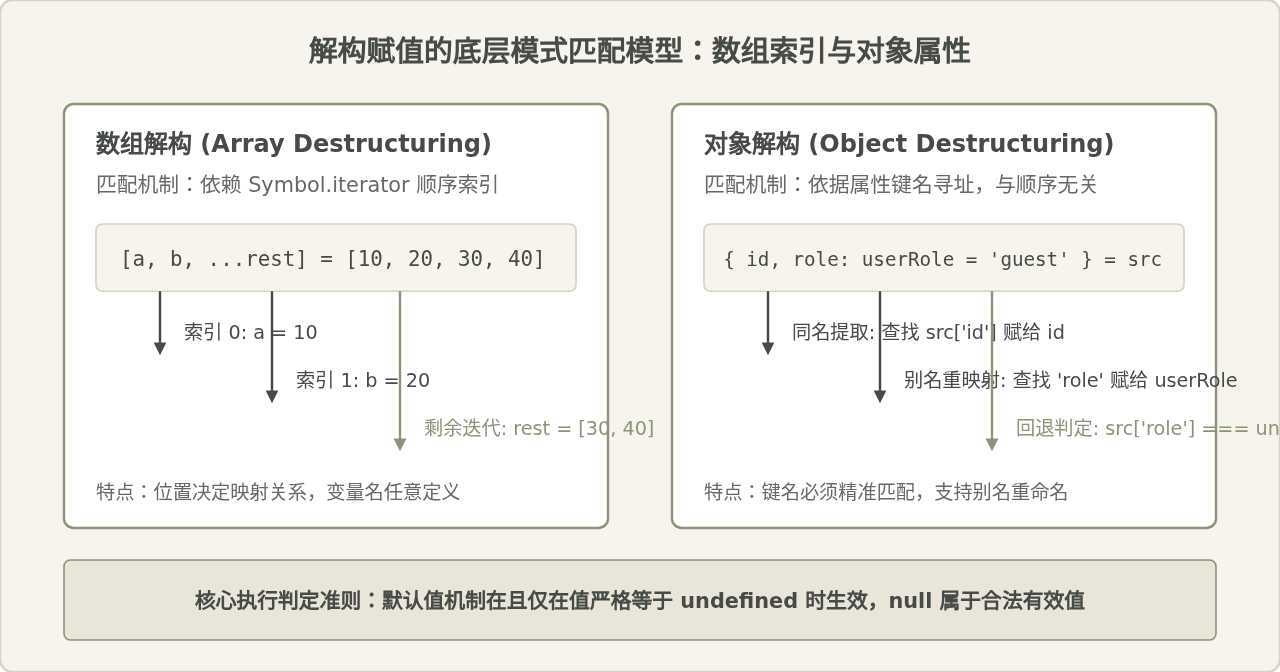
二、解构在复杂场景下的工程实战与防错处理
在日常业务开发中,我们很少处理扁平的一维对象,多数场景涉及来自网络接口的深层嵌套数据、组件Props参数传递或事件载荷清洗。若缺乏健壮的防御手段,解构语法可能成为引发运行时崩盘的隐患。
1. 嵌套对象解构与“Cannot destructure property of null/undefined”防护
当解构一个为 null 或 undefined 的表达式时,JavaScript引擎会立即抛出 TypeError。例如在异步API请求未完成前,嵌套属性极可能为 null。为此,我们必须在每一个可能为空的嵌套层级提供默认空对象 = {} 进行防御兜底。
// 模拟来自服务端的复杂API载荷
const apiResponse = {
  code: 200,
  data: {
    pagination: {
      currentPage: 1,
      pageSize: 20
    },
    items: [
      { id: 101, title: 'ES6 Modules Guide' }
    ]
  }
};

// 健壮的嵌套解构范式:层层兜底
const {
  code,
  data: {
    pagination: { currentPage = 1, pageSize = 10 } = {},
    items = []
  } = {}
} = apiResponse || {};
在上述代码中:
apiResponse || {}确保即便最外层传入的是null,第一层解构也不会报错;data: { ... } = {}确保当apiResponse.data缺失或为undefined时,内部的pagination解构能安全降级;pagination: { ... } = {}保证深层分页对象不存在时仍能安全回退至默认的分页数值。
2. 函数参数解构:打造高可读性的配置对象
在ES6之前,包含多个可选参数的函数往往需要处理长长的实参列表或在函数内部手动合并默认配置对象。借助解构与默认参数,我们可以声明出既支持按需传参、又具有明确默认行为的健壮API接口。
interface RequestOptions {
  method?: string;
  headers?: Record<string, string>;
  timeout?: number;
}

// 通过解构直接在函数形参处定义字段与默认值
function createHttpClient(url, {
  method = 'GET',
  headers = { 'Content-Type': 'application/json' },
  timeout = 5000
} = {}) { // 注意最后的 = {},允许调用方不传第二个参数
  return {
    url,
    method,
    headers,
    timeout,
    execute() {
      // 发起请求逻辑
    }
  };
}

// 优雅调用:无需补齐无关参数,传参顺序完全自由
const clientA = createHttpClient('/api/v1/posts'); // 使用全部默认选项
const clientB = createHttpClient('/api/v1/upload', { method: 'POST', timeout: 10000 });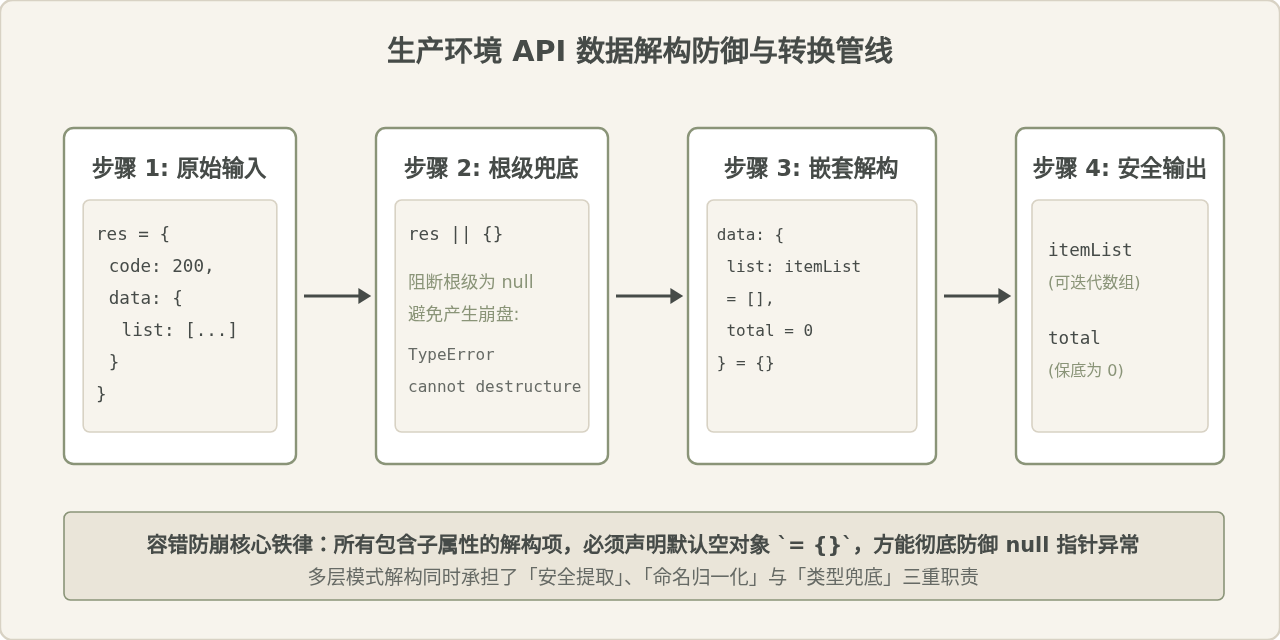
3. 常见认知辨析:解构等于深拷贝吗?
在实际编码中,经常有初学者认为使用解构重组对象可以实现数据的完全隔离。这种看法是不准确的。解构赋值本质上只进行浅层复制(Shallow Copy)。如果解构出来的属性值本身是复杂对象或数组,解构变量保存的依然是原对象的堆内存引用地址,对其内部属性的修改依然会直接污染原对象。
const originalState = {
  theme: 'dark',
  userProfile: {
    nickname: 'DevOne',
    tags: ['js', 'es6']
  }
};

// 使用解构与对象展开构造新对象
const updatedState = {
  ...originalState,
  theme: 'light' // 浅层基本类型:完全独立
};

// 修改深层嵌套引用属性
updatedState.userProfile.nickname = 'DevTwo';

console.log(originalState.userProfile.nickname);
// 输出: 'DevTwo' —— 原状态被意外篡改!
结论:解构与剩余参数展开仅能保护对象的第一层基本类型字段;若需深层状态隔离,必须配合深拷贝工具或不可变数据结构。
三、ES Modules 模块化底层机制与工程实现
在ES6之前,JavaScript在语言级别没有原生的模块化体系。社区先后演进出了服务于服务端的 CommonJS(Node.js采用)以及浏览器端的 AMD(RequireJS采用)和 CMD(SeaJS采用)。ES6推出的 ES Modules(ESM) 成为现代ECMAScript标准的官方规范。它不仅统一了客户端与服务端的模块语法,更在底层设计上带来了质的飞跃。
1. 命名导出与默认导出的协作规范
ESM提供了两类导出语法:具名导出(Named Export)与默认导出(Default Export)。
// mathUtils.js —— 具名导出:单个模块可导出多个标识符
export const PI = 3.1415926;

export function add(a, b) {
  return a + b;
}

export function multiply(a, b) {
  return a * b;
}

// logger.js —— 默认导出:单个模块仅能存在一个 default
export default class Logger {
  log(msg) {
    console.log(`[INFO] ${msg}`);
  }
}
导入时的语法规则非常严谨:
- 导入具名导出时,必须使用花括号包裹标识符:
import { add, PI } from './mathUtils.js';; - 导入默认导出时,不能使用花括号,可自由赋予本地变量名:
import MyLogger from './logger.js';; - 两者可以结合:
import MyLogger, { logLevel } from './logger.js';; - 使用命名空间全部导入:
import * as MathUtils from './mathUtils.js';。
2. 核心原理对比:实时只读绑定 vs 运行时值拷贝
这是 ESM 与 CommonJS 最核心的本质差异:
- CommonJS 输出的是“值的拷贝”:当
require()加载一个模块时,执行整个模块代码并将module.exports的当前值复制一份输出。随后模块内部状态再发生变化,导入端持有的副本不会改变。 - ESM 输出的是“值的只读引用(Live Read-Only Binding)”:当通过
import引入变量时,引擎并不拷贝数据,而是在符号表中建立一条动态只读绑定。如果导出模块在运行时改变了该变量的值,导入端会实时感知最新值;同时,导入端无法对该变量直接进行重新赋值。
// counter.js (ESM 模块)
export let count = 1;
export function increment() {
  count++;
}

// main.js
import { count, increment } from './counter.js';

console.log(count); // 输出: 1
increment();
console.log(count); // 输出: 2!ESM 具有实时只读绑定机制,感知到了 counter 内部的最新值
// count = 10;      // 运行时抛出 TypeError: Assignment to constant variable,外部只读!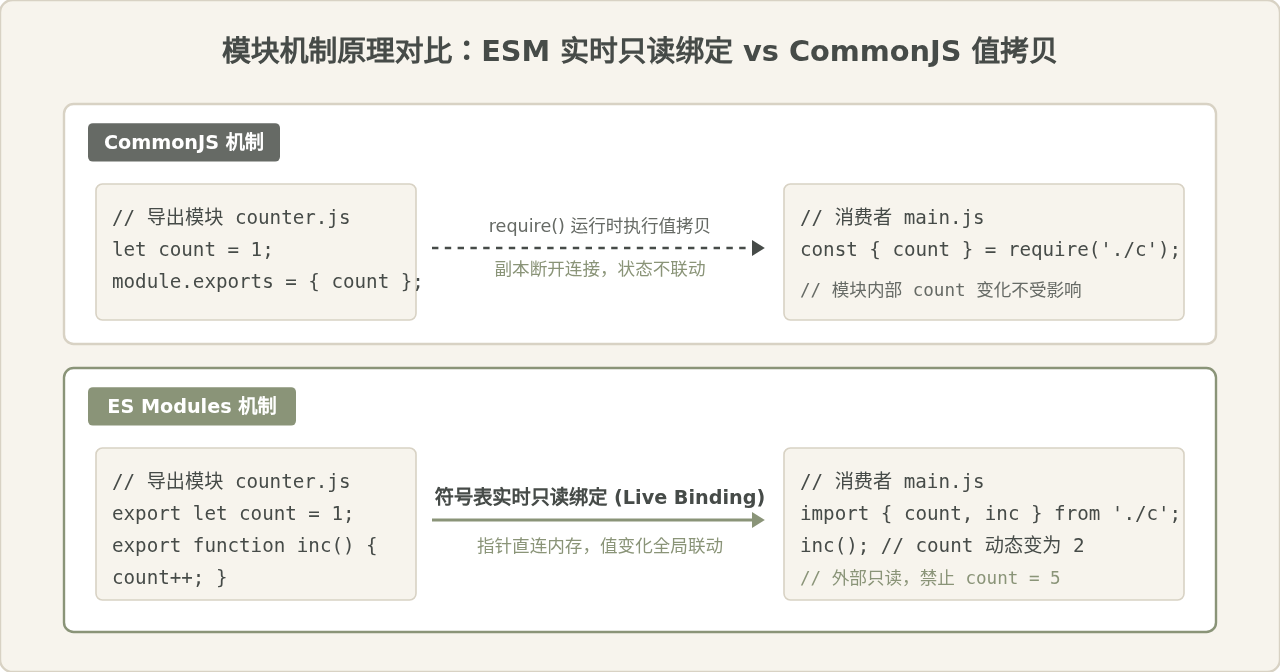
3. 静态分析与 Tree-shaking 优化红利
ESM在语法层面严格要求:import 和 export 语句只能出现在模块的最顶层作用域,不能置于 if 分支、循环或函数体内部。这种限制看似牺牲了一定的灵活性,但为构建工具(如Webpack、Rollup、Vite)带来了至关重要的“静态分析能力(Static Analysis)”。
在代码编译打包期,构建工具无需运行JavaScript代码,仅通过语法树解析就能构建出整个项目的完整模块依赖拓扑图。对于那些声明了导出但从未被任何导入消费的死代码(Dead Code),构建系统可以无风险地将其直接剔除,这就是现代前端性能优化的核心支柱——Tree-shaking。
// 动态按需加载场景:当必须在特定条件或异步下加载模块时,使用动态 import() 函数
async function handleExportReport() {
  if (needPdfExport) {
    // 动态 import() 返回一个 Promise,支持代码分割与按需加载
    const { generatePdf } = await import('./pdfGenerator.js');
    generatePdf();
  }
}
四、解构与模块化的联合工程实践与规范
在大型前端与Node.js工程中,解构赋值与模块化体系往往紧密结合。掌握以下协作范式,能极大提升团队协作效率并规避隐藏缺陷。
1. 桶模式(Barrel Pattern)与聚合重导出的权衡
在组件库或功能模块开发中,开发者常用 index.js 作为公共出口,集中重导出子模块的标识符:
// components/index.js —— 桶文件聚合导出
export { default as Button } from './Button.js';
export { default as Modal } from './Modal.js';
export { default as Table } from './Table.js';
export * from './types.js';

// 消费端解构式导入
import { Button, Modal } from '@/components';
工程警示:过度依赖 Barrel 文件可能破坏 Tree-shaking
当桶文件中混合了大量重型模块且存在副作用(Side Effects)代码时,打包工具可能无法安全剔除未使用的子组件,导致最终打包体积膨胀。在组件库架构设计中,建议在 package.json 中严格配置 "sideEffects": false,并优先推荐按路径分包导入。
2. 具名导入与对象命名空间解构的取舍
在日常编码中,以下两种语法在功能上看似一致,但对构建系统有着截然不同的意义:
// 方式 A:直接具名导入(强烈推荐)
import { debounce, throttle } from 'lodash-es';

// 方式 B:命名空间导入后解构(不推荐)
import * as lodash from 'lodash-es';
const { debounce, throttle } = lodash;
辨析分析:方式A能够被绝大多数静态分析器精准识别,Tree-shaking工具能够精确保留 debounce 和 throttle 并丢弃其余上百个未使用函数;而方式B将整个命名空间对象作为动态实体导入,在特定打包工具的宽松模式下可能触发“防优化惩罚”,导致整个模块全量打入最终产物。
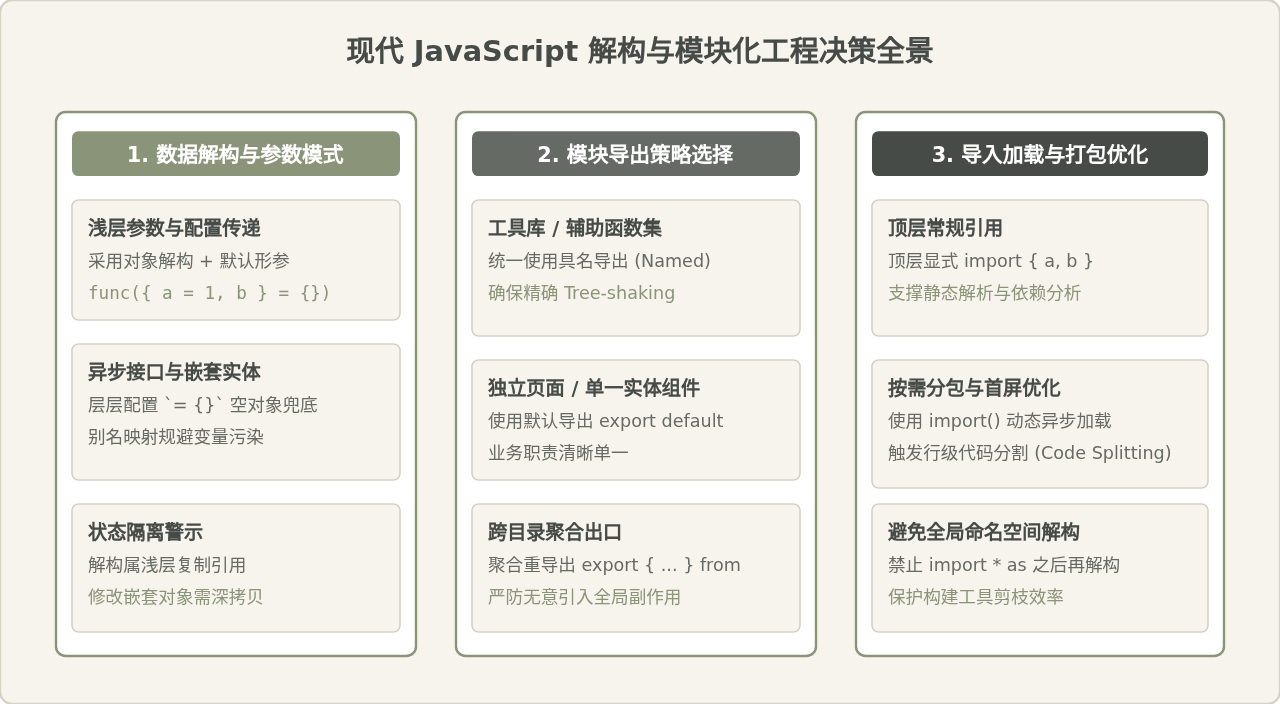
五、核心结论与回顾
解构赋值与模块化构成了现代 JavaScript 架构设计的基石。理解并运用好这两项特性,需要把握以下核心结论:
- 解构是模式匹配而非简单赋值:数组依序由迭代器展开,对象依键寻址;默认值唯有在值为
undefined时才会被激活; - 防崩边界需显式构造:任何潜在为空的嵌套对象,必须在每一层声明默认空对象
= {},避免抛出不可控的TypeError; - 解构与浅拷贝的界限:解构仅创建第一层浅拷贝,深层对象引用依然共享,修改深层状态必须遵循不可变数据规范;
- ESM 的静态本质是现代工程化的驱动器:编译期静态依赖图为 Tree-shaking 提供了必要条件,其“只读实时绑定”机制彻底规避了 CommonJS 的值拷贝不同步问题;
- 工程协作规范重于技巧堆砌:工具库优先具名导出,顶层显式具名导入,谨慎使用聚合桶导出与全量命名空间解构,确保应用体积与运行性能的最优平衡。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章