

本文深入解析 SpiderMonkey 引擎中函数序列化的两种实现技术:反编译字节码与直接存储源码。从 Firefox 16 到 17 的版本演进展示了从依赖反编译器到直接保存源码的转变,重点讨论了严格模式、注释处理及括号保留等细节差异,并探讨了利用 toString 修改函数源码的实际应用场景。
SpiderMonkey 函数序列化技术演进
在 JavaScript 中,将函数序列化为字符串(即获取函数源码)看似简单,但其底层引擎实现却相当复杂。SpiderMonkey 引擎历史上采用过两种不同的序列化策略:一是通过反编译器将编译后的字节码还原为源码字符串;二是在编译前将源码压缩存储,需要时再解压还原。
探讨JavaScript SpiderMonkey引擎中函数序列化的具体实现方式
序列化接口与标准规范
SpiderMonkey 中提供函数序列化功能的接口主要有三个:Function.prototype.toString、Function.prototype.toSource 以及 uneval。其中,只有 toString 是标准方法,被各引擎通用。然而,ES5 标准(15.3.4.2)对该方法的规定极为简略,实际上缺乏详细规范,具体实现由各个引擎自行决定。
阐述函数序列化在代码处理中的作用与意义
函数序列化的实际应用
函数序列化的核心用途之一,是利用生成的源码字符串来重新定义或修改原有函数。
提供相关代码示例供参考
代码如下:
function a() {
...
alert("a")
...
}
a() //执行时可能会弹出"a"
a = eval("(" + a.toString().replace('alert("a")', 'alert("b")') + ")")
a() //执行时可能会弹出"b"
你可能会疑惑,为何平时开发中很少见到这种需求。确实,对于完全掌控的 JS 文件,直接修改源码即可,无需通过打补丁方式修改函数。但在无法控制源文件的场景下,这种技术至关重要,例如 Greasemonkey 脚本需要禁用或修改目标网站的函数,或者 Firefox 扩展需要修改 Firefox 自身(由 JS 编写)的函数。
展示Firefox浏览器环境下脚本序列化的实际案例:提供Firefox脚本示例的代码片段
代码如下:
location == "chrome://browser/content/browser.xul" && eval("gURLBar.handleCommand=" + gURLBar.handleCommand.toString().replace(/^\s*(load.+);/gm, "/^javascript:/.test(url)||(content.location=='about:blank'||content.location=='about:newtab')?$1:gBrowser.loadOneTab(url,{postData:postData,inBackground:false, allowThirdPartyFixup: true});"))这段代码的作用是:当在地址栏按下回车时,让 Firefox 在新标签页中打开页面,而不是覆盖当前标签。实现原理是利用 toString 方法获取 gURLBar.handleCommand 函数的源码,通过正则表达式替换关键逻辑后,再使用 eval 重新定义该函数。
为什么不直接重写函数呢?
gURLBar.handleCommand = function(){...//将原本的函数更改了一个小地方}
直接重写的主要问题是兼容性。我们需要尽可能小地改动源码。如果直接重写,一旦 Firefox 内部 gURLBar.handleCommand 的实现发生变化,脚本就会失效。例如 Firefox 3 和 4 中该函数内容差异巨大,但若仅通过正则替换特定关键字,只要该关键字未变,脚本就能保持兼容。
介绍对序列化结果进行反编译字节码分析的过程
基于反编译器的序列化机制
在 SpiderMonkey 中,函数解析后会被编译为字节码(bytecode),内存中存储的并非原始源码。因此,SpiderMonkey 包含一个反编译器,其主要功能是将字节码反编译为源码形式。
在 Firefox 16 及更早版本中,SpiderMonkey 采用上述反编译方法。如果你使用这些版本的 Firefox,可以尝试以下代码:
提供反编译字节码相关的代码示例
代码如下:
alert(function () {
"字符串";
//注释
return 1 + 2 + 3
}.toString())
返回的字符串是
function () {
return 6;
} 指出SpiderMonkey的输出结果与其他主流浏览器存在显著差异:
说明无意义的原始值字面量在编译阶段会被移除,例如示例中的字符串字面量
你可能认为这没什么问题,因为这些值对函数运行结果无影响。但请注意严格模式字符串 "use strict" 的处理。
在不支持严格模式的版本(如 Firefox 3.6)中,"use strict" 被视为普通字符串,编译时会被删除。在 SpiderMonkey 实现严格模式后,虽然编译时仍忽略该字符串,但反编译器会判断函数是否处于严格模式。如果是,则会在函数体第一行添加 "use strict",对应引擎源码如下。
static JSBool
提供验证字面量移除的代码示例
代码如下:
DecompileBody(JSPrinter *jp, JSScript *script, jsbytecode *pc)
{
/* Print a strict mode code directive, if needed. */
if (script->strictModeCode && !jp->strict) {
if (jp->fun && (jp->fun->flags & JSFUN_EXPR_CLOSURE)) {
/*
* We have no syntax for strict function expressions;
* at least give a hint.
*/
js_printf(jp, "\t/* use strict */ \n");
} else {
js_printf(jp, "\t\"use strict\";\n");
}
jp->strict = true;
}
jsbytecode *end = script->code + script->length;
return DecompileCode(jp, script, pc, end - pc, 0);
}
说明代码注释在编译过程中同样会被清除
这看似影响不大,但有人利用函数注释实现多行字符串,这种方法在 Firefox 17 之前的版本中不可用。
提供验证注释移除的代码示例
代码如下:
function hereDoc(f) {
return f.toString().replace(/^.+\s/,"").replace(/.+$/,"");
}
var string = hereDoc(function () {/*
我
你
他
*/});
console.log(string)
我
你
他
说明原始值字面量的运算操作会在编译阶段提前执行.
这算是一种优化方式,《高性能JavaScript》曾提及:
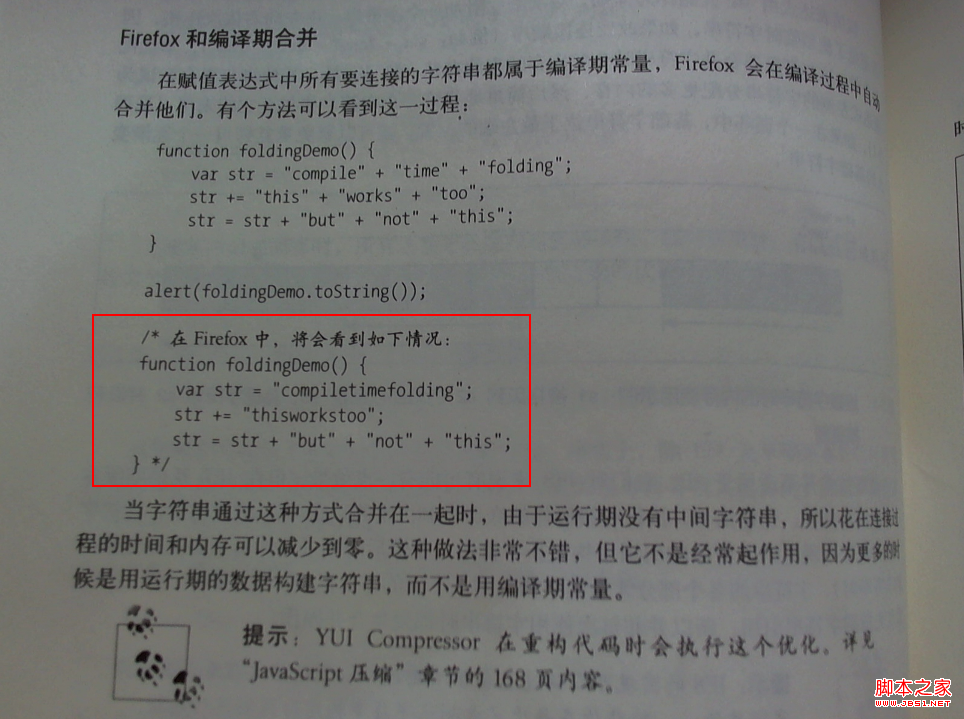
分析反编译字节码技术存在的局限性与弊端
由于新技术(如严格模式)的出现及修复其他 bug 时的修改,反编译器实现经常变动,这可能导致新 bug。我曾在 Firefox 10 左右遇到一个关于反编译时是否保留小括号的 bug,具体细节已模糊,但涉及括号处理问题。
提供展示反编译弊端的代码示例
代码如下:
(function (a,b,c){return (a+b)+c}).toString()
"function (a, b, c) {
return a + b + c;
}"
反编译时,(a+b) 中的小括号被省略,因加法结合律从左到右,这通常没问题。但我遇到的 bug 是:
提供补充说明的代码示例
代码如下:
(function (a,b,c){return a+(b+c)}).toString()
"function (a, b, c) {
return a + b + c;
}"
这会导致错误,因为 a+b+c 不等于 a+(b+c)。例如当 a=1, b=2, c="3" 时,a+b+c 结果为 "33",而 a+(b+c) 为 "123"。
关于反编译器,Mozilla 工程师 Luke Wagner 指出,反编译器严重阻碍了新功能的实现,且经常引发 bug:
Not to pile on, but I too have felt an immense drag from the decompiler in the last year. Testing coverage is also poor and any non-trivial change inevitably produces fuzz bugs.The sooner we remove this drag the sooner we start reaping the benefits. In particular,I think now is a much better time to remove it than after doing significant frontend/bytecode hacking for new language features.
Brendan Eich 也表示,反编译器存在诸多不足:
I have no love for the decompiler, it has been hacked over for 17 years. 存储函数源码
直接存储源码的实现方案
从 Firefox 17 开始,SpiderMonkey 改用第二种方法(直接存储源码),其他浏览器可能也采用此方式。此时序列化得到的字符串与源码完全一致,包括空白符和注释,大部分问题得以解决。但严格模式处理仍存疑问。
例如:
提供补充说明的代码示例
代码如下:
(function A() {
"use strict";
alert("A");
}) + ""
当然,返回的源码中也应包含 "use strict",所有浏览器均如此实现:
提供补充说明的代码示例
代码如下:
function A() {
"use strict";
alert("A");
}
但如果这样呢:
提供补充说明的代码示例
代码如下:
(function A() {
"use strict";
return function B() {
alert("B")
}
})() + ""
内部函数 B 也处于严格模式,输出 B 的源码是否应添加 "use strict"?试验如下:
前文提到,Firefox 17 之前(Firefox 4 之后)的版本通过判断当前函数是否处于严格模式来决定是否输出 "use strict"。函数 B 继承函数 A 的严格模式,因此会包含 "use strict"。
同时,源码缩进严格,因为反编译器会对源码进行格式化,即使原源码无缩进也无妨:
提供补充说明的代码示例
代码如下:
function B() {
"use strict";
alert("B");
}
Firefox 17 之后的版本是否带有 "use strict"?由于直接保存源码,且函数 B 中确实无 "use strict" 字样。试验结果是:会添加 "use strict",但缩进可能有问题,因为缺少格式化步骤。
提供补充说明的代码示例
代码如下:
function B() {
"use strict";
alert("B")
}
SpiderMonkey 最新版 jsfun.cpp 源码中有对应注释:
// 如果一个函数的某个上层函数中拥有"use strict",那么这个函数就继承了上层函数的严格模式.
// 我们也会在这个内部函数的函数体内插入"use strict".
// 这就确保了,如果这个函数的toString方法的返回值被重新求值时,
// 重新生成的函数会和原函数有着相同的语义.
而其他浏览器则不带 "use strict":
提供补充说明的代码示例
代码如下:
function B() {
alert("B")
}
虽然影响不大,但我觉得 Firefox 的实现更合理。