

Mistral发布新视觉模型PixtralLarge,宣称在多项基准测试中超越GPT-4o与Gemini-1.5Pro。但遭质疑对比模型过少,实际性能不及Qwen2-VL和Molmo,日文识别能力甚至不如Qwen7B版本。
ChatGPT付费功能免费,Mistral复制Canvas和Artifact
作者:技术拾光
时间:2026-07-29
浏览:130
文章目录
Pixtral Large 视觉模型表现
说回模型本身的表现,Mistral 这次对 Pixtral Large 的定位相当明确:当前视觉领域的 SOTA(State-of-the-Art)。
从他们公布的 benchmark 成绩来看,在 MMMU、MathVista、ChartQA 等六个不同任务类型的数据集上,Pixtral Large 的成绩要么超过 Gemini-1.5 Pro 和 GPT-4o,要么与之持平。和 Claude-3.5 Sonnet 相比,优势还要更明显一些。而对比开源阵营的 Llama-3.2 90B,那更是直接甩开了一个身位。
更有意思的是,Mistral 团队还搞了一个“自测”——用自家开源的 MM-MT-Bench 基准,让 GPT-4o 来做评委。结果你猜怎么着?Pixtral Large 居然排在了第一位,甚至超过了那位“既当裁判又当运动员”的 GPT-4o 本身。
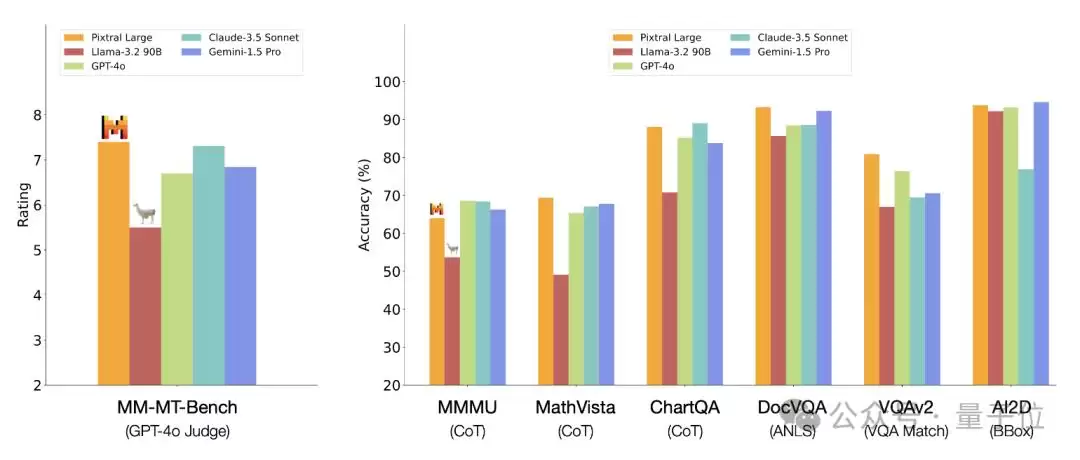
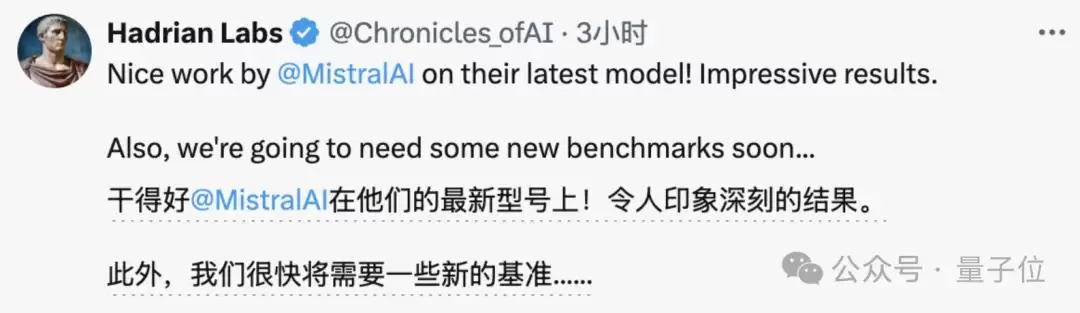
有网友看了这个成绩单后调侃说,看来 benchmark 又该更新换代了。
社区质疑与实测反馈
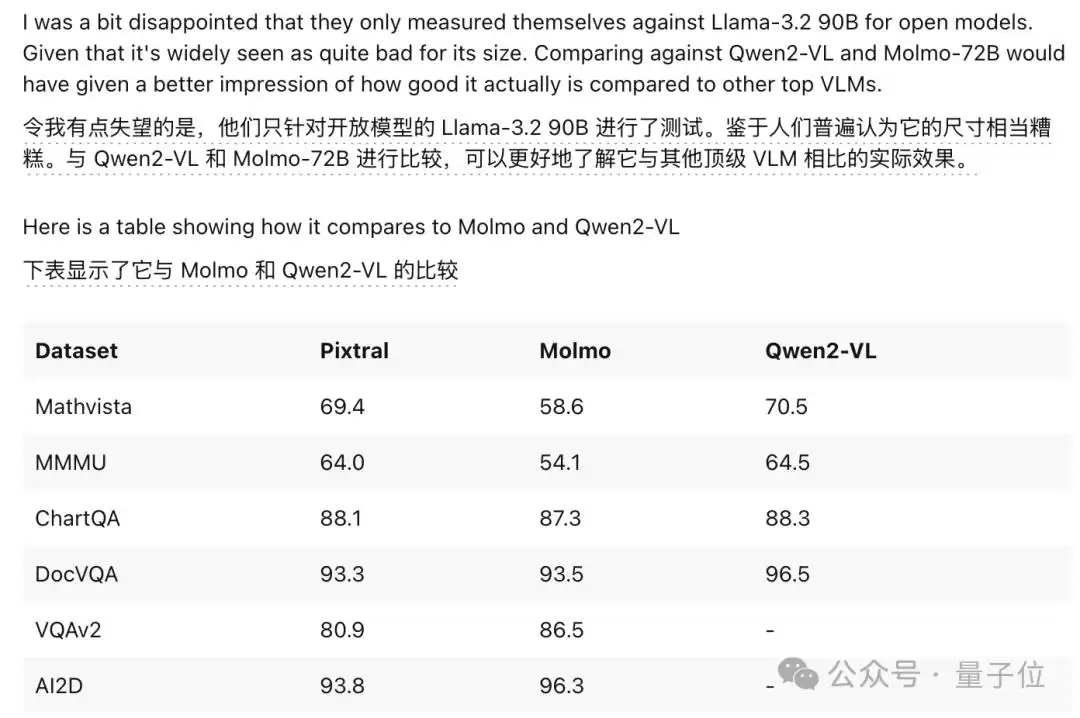
不过,Reddit 上很快就有人提出了不同意见。质疑的点在于:Mistral 官方选择对比的模型数量实在太少了。开源模型只拉了 Llama-3.2 90B 来比,但实际在多个数据集上,Qwen2-VL(72B 的最大版本)的表现其实比 Pixtral 要强。此外,在部分数据集中,Pixtral 的成绩也不如 Molmo——这是由西雅图一家非营利研究机构 Ai2 开发的开源模型。
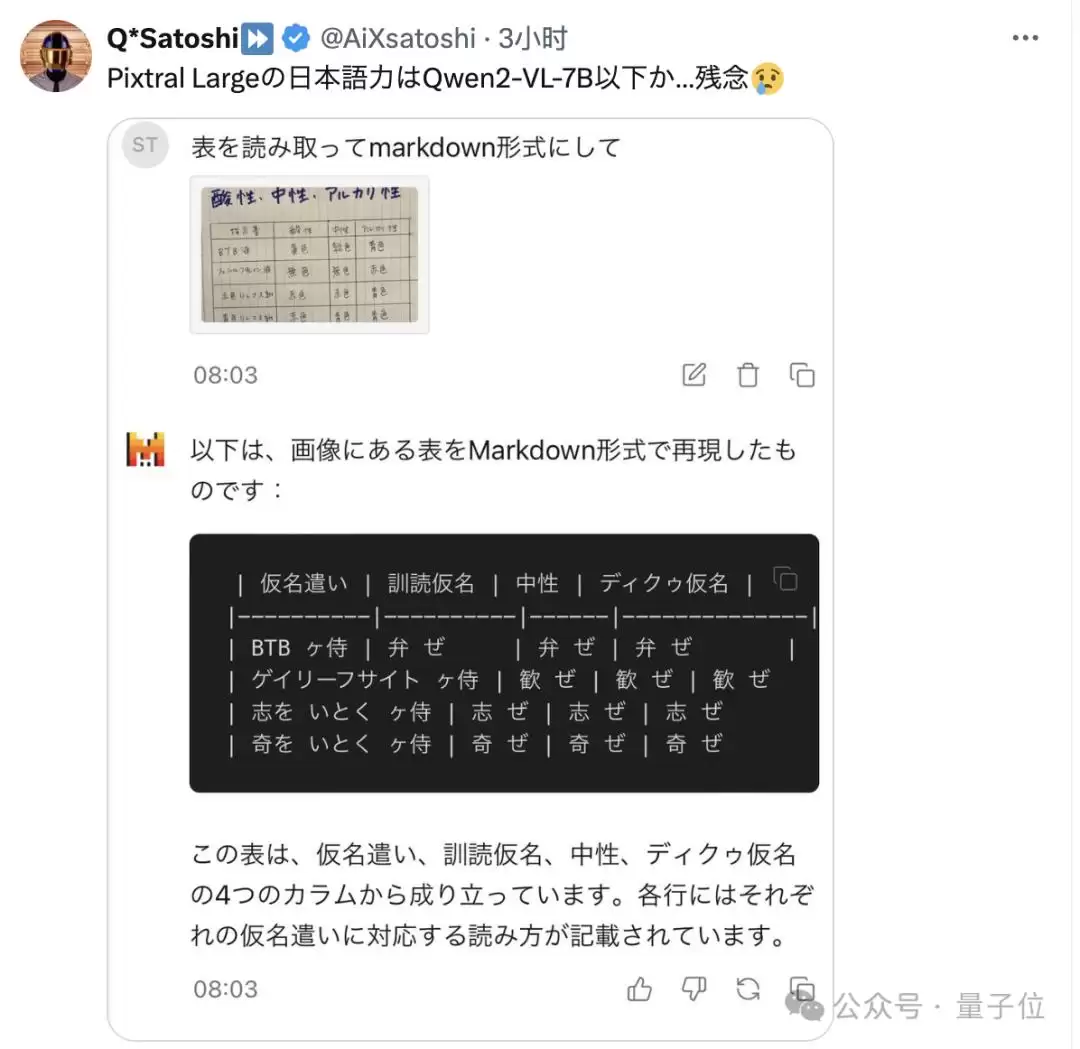
更扎心的是,有网友实测后发现,在包含日文的图片识别任务里,Pixtral Large 的表现甚至还不如 Qwen 的 7B 版本。
所以,Mistral 这次端出来的新产品,到底能不能打?不妨留个言说说你的看法。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章