

HashSet基于哈希表实现,不保证元素顺序且不允许重复。通过hashCode定位存储位置,equals判断是否重复,底层采用数组加链表结构处理哈希冲突,确保唯一性与高效存取。允许存储一个null元素,且线程不安全,平均时间复杂度O(1),常用于去重。
HashSet实现Set接口
作者:技术拾光
时间:2026-07-28
浏览:579
文章目录
在Java集合框架中,实现Collection接口的Set最常用的是HashSet。Set接口的设计理念很纯粹:用来存放无序且不重复的元素,这与数学课本里的集合概念一致——不允许重复成员。具体实现上,有HashSet、LinkedHashSet和TreeSet三位主力,其中HashSet基于哈希表实现,存取效率最高,应用也最广泛。下面将详细拆解HashSet的特点和用法。
HashSet的核心特点
HashSet作为Set的常用实现,核心特点是不保证元素的存储顺序,并且绝对不允许重复元素。如果集合里已经存在某个元素,再想加入一个一模一样的对象是不被允许的,这确保了集合中每个元素都是独一无二的。
HashSet使用示例
先来看一个实际例子,直观感受HashSet的用法。
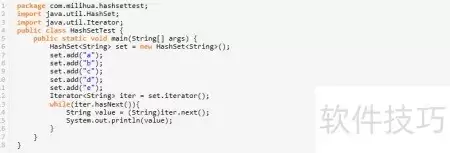
示例代码创建了一个HashSet实例来存储字符串。通过add方法添加几个字符串元素后,使用Iterator迭代器遍历,将集合中的每个字符串读取出来。整个过程清晰明了。
运行程序后,控制台显示的效果如下。
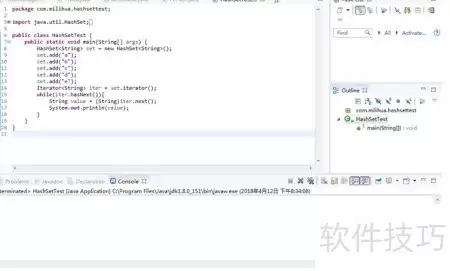
从输出结果可以看到,添加的顺序与遍历的顺序完全不同——这正是HashSet无序性的体现。可能有同学好奇:之前学习的数组、ArrayList都是按插入顺序排列,但HashSet为什么不按顺序?
HashSet的底层原理
HashSet存储元素时,依靠对象的哈希码来确定位置。每个对象调用自身的hashCode方法得到一个哈希值,再经过固定算法计算在散列表中的索引。系统首先检查目标位置是否已被占用:如果没人,直接存入;如果已有元素,则拿新对象与该位置上所有已有对象逐一比较——通过equals方法判断。如果发现集合中已有完全相同的对象,则不重复添加,直接引用原对象;如果找不到相同对象,则插入新对象。这套机制既保证了唯一性,又提高了查找和存取的效率——这正是HashSet高效的核心原理。
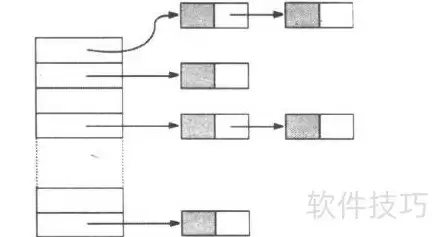
HashSet的底层采用数组加链表的结构,数组的每个位置对应一个链表,这种结构称为散列表。图中左侧是存储主体的数组,每个元素存放的是链表的头节点。添加元素时,系统先调用hashCode获取哈希值,然后根据值确定在数组中的位置。如果多个元素计算出的哈希值相同,则发生哈希冲突,此时HashSet将这些元素串成一个链表,链表的首地址存入对应数组索引位置——这样就能高效地存储和查找。
自定义对象与HashSet
前面的例子存储的是字符串这类现成的类,如果换成自定义对象,该如何操作?
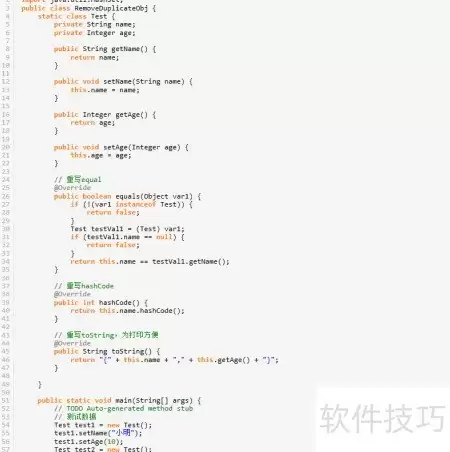
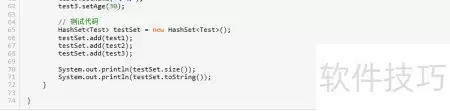
来看一个使用HashSet存储自定义对象的例子。
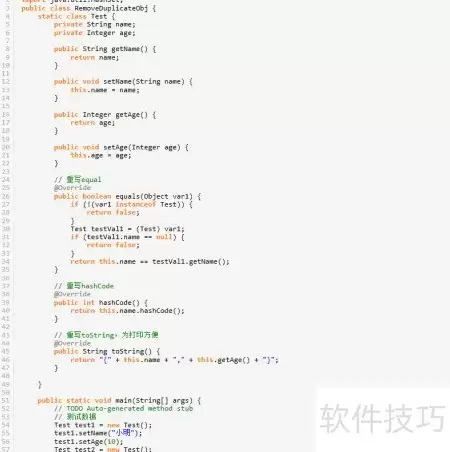
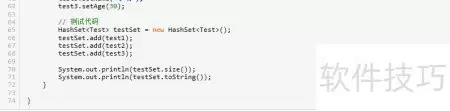
因为Set集合不允许重复元素,所以自定义类必须明确告诉集合“怎样才算重复”。示例代码通过重写hashCode()和equals()方法定义两个RemoveDuplicateObj对象是否相同。这两个方法联手决定了对象的唯一性,确保集合能正确去重。
equals()方法负责判断两个对象是否“相等”。在自定义类中,需要根据具体属性重写该方法。例如RemoveDuplicateObj类通过比较name属性判断——如果两个对象的name相同,则认为是同一个对象,这样就能满足业务上的去重需求。
在散列存储体系中,hashCode()方法主要用于定位存储位置。即便两个对象的hashCode值相同,也不代表它们是同一个对象——只是说它们被映射到了同一个桶(链表)中。对于初学者,可以粗略理解为hashCode()返回的是对象的某种“地址标识”(虽然并非真正的物理内存地址,而是根据对象信息计算出的特征值)。当向集合中添加新元素时,系统先调用hashCode快速找到目标桶位置,然后在该桶内进行比较,这样插入和查找的效率就大大提高了——这是哈希表高性能的关键所在。
总而言之,Set的实现类依靠哈希值确定存储位置,查找时只需在对应桶内进行少量比较即可定位。由于底层采用哈希机制,Set接口在添加、获取、删除元素时,效率都非常可观。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章