

谷歌发布Gemini3.6Flash等三款新模型,主打节省token和低成本,但实测性能提升有限,与竞品相比性价比尴尬。旗舰3.5Pro持续跳票,引发用户大规模差评,技术路线疑偏重成本而忽视智力水平,导致口碑下滑,市场信心受挫,前景堪忧。
Gemini 3.6 Flash遭网友吐槽:省token丢智商
作者:技术拾光
时间:2026-07-23
浏览:436
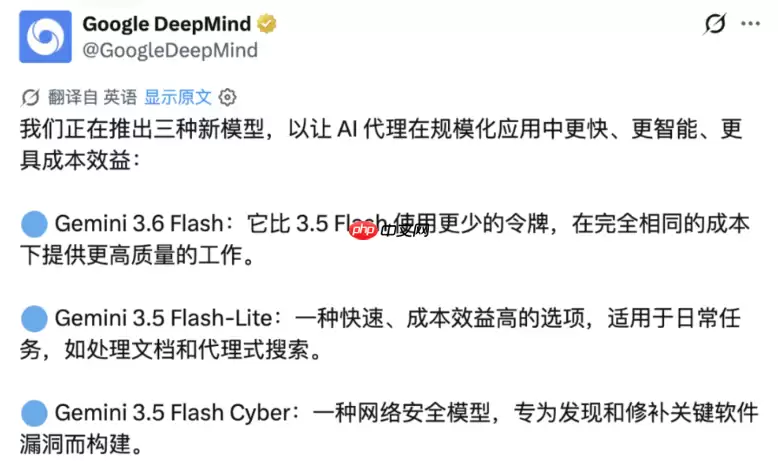
不知道你有没有这种感觉,如果用Gemini用得早,去年底那会儿,圈子里最流行的一个玩笑是:眼睁睁看着自家兄弟慢慢患上阿尔茨海默症,是个什么体验——大概就是当时用Gemini的感觉。按理说,科技公司发布新模型,正是回击这种调侃的最佳时机。可谁想到,Google一口气端出三款新模型,非但没把质疑压下去,反而让网友笑得更大声了。这画面,活脱脱就是“所有人都不看好你,偏偏你最不争气”。这三款新作分别是3.6Flash、3.5Flash-Lite,以及专门针对网络安全的3.5Flash Cyber。官方博客的措辞还是老一套:“更高效、更聪明、专为大规模AI agent而生”——听着熟悉吧?但实际体验,却呈现出冰火两重天的割裂感。
先说说当家主力3.6Flash。它是今年5月I/O大会上亮相的3.5Flash的小幅升级版,官方给它的定位是:真正能扛事、跑得稳、干得久的实干型选手。这一代最核心的卖点,就是“省token”。根据Artificial Analysis Index的数据,3.6Flash相较3.5Flash,输出token减少了17%,在DeepSWE这类复杂场景下,甚至能省下高达65%;多步任务中,推理轮次和工具调用次数也明显下降。价格方面同样做了调整:输入端是1.5美元/百万token,输出端从上一代的9美元降到了7.5美元/百万token,成本压缩得很明显,单个agent任务的开销也更低了。
基准测试里,代码能力成了主攻方向。DeepSWE得分从37%跃升到49%,官方强调说,它生成的代码冗余更少、执行循环更短,整体风格更贴近生产环境标准;机器学习研究类的MLE Bench,提升尤其亮眼,从49.7%飙到了63.9%;操作系统交互类的OSWorld-Verified,则从78.4%升到了83%,而且计算机操作能力已经作为Gemini API和企业版的原生内置功能,主打即插即用;知识型工作GDPval-AA v2的分数,从1349涨到了1421。Hebbia、Harvey这些客户反馈,在文档解析、图表数据解读、报告撰写这类多模态任务里,表现很突出,Figma和JetBrains也公开为它站台。还有一个不起眼但意义不小的地方:知识截止时间终于从2025年1月推进到了2026年3月,那本“老黄历”总算翻篇了。安全层面,3.6Flash搭载了升级版的Frontier Safety防护机制,重点防范化学、生物、放射性、核及网络攻击这五大高危滥用方向,越狱抵抗能力增强,同时也在控制误拒率,避免把合理请求给拦错了。
定位稍低一档的是3.5Flash-Lite,主打极致速度和极致性价比,专攻高吞吐、低延迟的场景,比如agent驱动的实时搜索和批量文档处理。它目前是3.5系列里响应最快的模型,Artificial Analysis实测每秒能输出350个token,价格更是亲民——输入只要0.3美元、输出2.5美元/百万token,质量远超今年3月发布的3.1Flash-Lite。这个模型支持动态推理档位调节:轻量任务用最低档,图快和省;复杂子任务则可以提升“思考档位”,实现多步拆解;计算机操作能力也内置在工具链里。
性能提升相当可观:代码和agent任务测试集Terminal-Bench2.1,得分从31%跃到了54%;长上下文理解GDM-MRCR v2,从60.1%升到了72.2%;真实业务场景GDPval-AA v2,更是从642暴增到了1140。更有意思的是,这款“小弟”在多项agent和编程任务里,居然反超了前辈3Flash——比如SWE-Bench Pro达到了54.2%(3Flash是49.6%)、OSWorld-Verified是74.0%(3Flash是65.1%)。这意味着,原本需要靠3Flash完成的任务,现在有了更快更强的平替方案。官方也列举了好几个落地案例:从海量电商数据里自动提取产品特征、辅助3.6Flash一次性生成25套网页设计方案、批量翻译并摘要收据、边玩边迭代开发小游戏……Ashler、Palo Alto Networks、Ramp这些客户也纷纷点赞,说它“速度、智能、成本”三位一体。
第三款3.5Flash Cyber,画风突变,专精于代码安全漏洞的识别和修复。Google的思路挺有意思:现在AI发现漏洞的速度,已经远远超过了人类修复的节奏,导致漏洞越积越多;与其被动追赶,不如用低成本、高效率的Flash模型来批量“补锅”。这个模型基于3.5Flash微调而来,配合自研的CodeMender工具,内部可以调度多个Flash Cyber agent协同作业,最后整合生成一份结构化的安全报告。在业内权威的CyberGym基准测试里,它已经跻身第一梯队,而且token消耗优于更大尺寸的模型。不过,这个模型暂时没有开放公众使用——考虑到漏洞挖掘本身就有双刃剑的属性,Google效仿Anthropic采取了严格的安全叙事策略,只面向可信的合作伙伴限量内测。目标很明确:为一线防御团队争取黄金修复窗口,在漏洞被恶意利用前完成闭环处置,同时严防技术滥用。
看到这里,你可能会疑惑:说好的旗舰级3.5Pro去哪儿了?官方口径仍然是“正与合作伙伴联合测试,成熟后即刻上线”。但这句话背后的故事,可能没那么体面。根据彭博社等媒体的报道,3.5Pro在代码生成能力上,长期没能达到内部预期,Google甚至在今年6月下旬紧急更新训练数据,想强化代码短板,结果还是没什么起色;更有传闻说,它已经彻底推翻了原有的训练路径,启动了全新的预训练流程。而Google AI布道师Logan Kilpatrick,更是在舆论场上直接绕开了3.5Pro,把焦点转向了Gemini 4,宣称“史上最宏大的Gemini 4预训练已经全面启动,进展令人振奋”。放在旗舰跳票这个大背景下,这举动难免被解读为转移视线、画饼续命。
单看今天发布的Flash系列,外界的评价也不是一边倒的叫好。第三方评测机构Artificial Analysis指出:两款新模型确实在单任务耗时和token效率上,实现了减半式的优化,Flash-Lite的智能指数上涨了11分,但3.6Flash的综合智能水平,和3.5Flash相比几乎停滞不前。价格没低到能掩盖能力落差,能力也没高到能支撑成本溢价。X平台上就有用户直言,3.6Flash在Artificial Analysis榜单上和3.5Flash同分,甚至还比不上Meta Spark1.1、GLM-5.2、5.6Luna、Sonnet5、Grok4.5、5.6Terra这些竞品,直呼“简直烂透”。
网友Angel则从性价比切入,指出3.6Flash的单位成本高于GPT-5.6Sol medium,而智能表现反而更低,“又贵又笨”的组合确实尴尬——毕竟Flash系列的立身之本就是极致性价比,现在却被对手当场戳破短板,无异于自砸招牌。作为对照,OpenAI最近也宣布:因为周活跃用户突破了1000万,Codex和ChatGPT Work付费用户的配额迎来了新一轮重置。这么一对比,这么一落差,还有人记得那个曾经被寄予厚望的Google Gemini 3吗?
实测派也很快补刀。网友Balder直接开团,说三款新模型的整体性能,都比旧版3.5Flash差,问题包括基础解码异常、中文选词离谱、生成图像和视频质量极差、指令响应错位、额度限制严苛、记忆混乱频繁、工具调用严重失准等等。他还抛出一个“阴谋论”:Google这么做,可能是想腾出算力资源转售给Anthropic,并阴阳了一句“这就是皮查伊想要的Cloud First”。X用户Conor Dart则用Google自家的Antigra vity平台跑了一轮AI游戏生成测试,结果木纹质感更糟了,大理石纹理勉强接近但依然不能用,直言“又一次翻车”,并表示“还是继续等Gemini 3.5或3.6Pro吧”。
一边是官方描绘的“更高效、更便宜、更省token”的理想账本,一边是多数用户现场打出的差评,再叠加旗舰跳票、核心人才流失、市值持续承压这些连锁反应。这很难不让人怀疑:Google这次是不是真在技术路线上走了偏锋——只顾着压缩成本,却忘了同步拉升智力水平,只能靠几款Flash模型暂时稳住阵脚。反正Gemini 4的预训练已经启程了,如果这一把再翻车,那句关于“阿尔茨海默症”的玩笑,恐怕就要从调侃变成预言了。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章