

索引 索引到底是什么?简单说,就是MySQL用来快速获取数据的一种数据结构。没有索引,查询就像在一本没有目录的书里找东西,只能一页一页翻。 索引的数据结构有哪些? 常见的索引数据结构有好几种,但各有各的短板: 二叉树:能一定程度上优化查询速度,但问题在于它容易长成“单边树”——和链表差不多,查询效率
MySQL性能优化:聚集索引与覆盖索引如何避免回表?
作者:技术拾光
时间:2026-07-21
浏览:430
文章目录
索引
索引到底是什么?简单说,就是MySQL用来快速获取数据的一种数据结构。没有索引,查询就像在一本没有目录的书里找东西,只能一页一页翻。
索引的数据结构有哪些?
常见的索引数据结构有好几种,但各有各的短板:
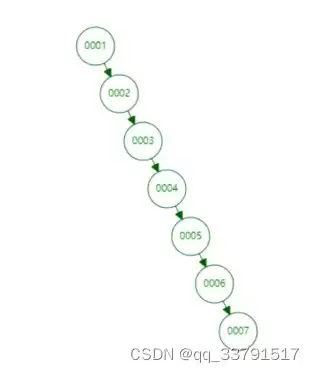
- 二叉树:能一定程度上优化查询速度,但问题在于它容易长成“单边树”——和链表差不多,查询效率反而没有什么提升。
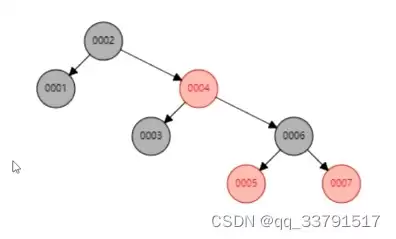
- 红黑树:和二叉树的问题类似,极端情况下也可能出现单边树,无法保证稳定高效的查询。
- Hash表:等值查询确实很快,但问题是它不支持排序,范围查询就更不用提了。
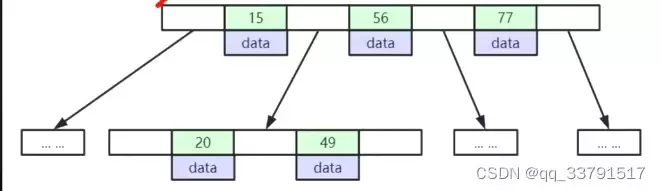
- B-Tree:所有节点都包含数据,节点中的数据从左到右依次递增排列。相比前几种,它有了明显改进。
B+Tree:B-Tree的变种
MySQL真正使用的索引数据结构,其实是B+Tree。它和B-Tree有什么区别?关键看三点:
- 非叶子节点不存储数据,只存储索引,也就是所谓的“高阶冗余”。这样一来,一个节点就能放下更多的索引字段。
- 叶子节点包含了所有索引字段,并且从左到右依次递增。
- 叶子节点之间,用双向指针相连,范围查询和顺序访问的效率直接拉满。
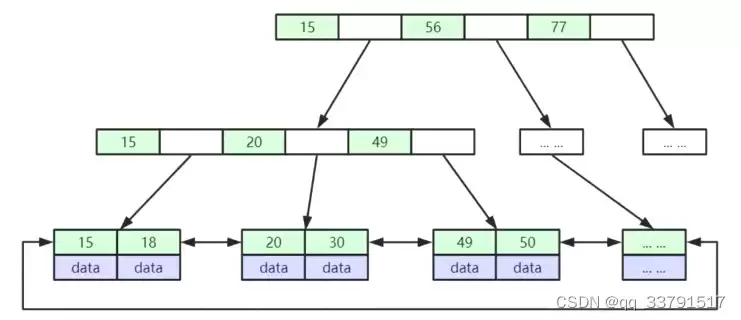
MySQL最终选定的数据结构:B+Tree
B+Tree的一个节点,分配的空间大小是16KB。粗略估算一下,16KB能放多少索引?大概1170个。三层B+Tree的话,1170×1170×16,差不多能承载2000万条数据。这也是为什么生产环境中,MySQL单表通常建议控制在1000万条左右——数据再多了,就该考虑分库分表了。好在MySQL的横向扩容本身并不复杂。
MySQL的数据引擎,是表级别的,不是数据库级别的。这一点要记清楚。不同引擎,索引的实现方式差别很大:
- MyISAM
它的索引是非聚集的,叶子节点存放的是主键的指针,索引文件和数据文件是分开的。查询完索引后,还需要回表去拿数据。还有一个短板:不支持事务。
- InnoDB
这是目前最常用的引擎。它的索引是聚集索引,主键索引的叶子节点直接存放整条数据。其他索引(组合索引、唯一索引、普通索引)查询时,如果索引里已经包含了所需返回的字段,那就不需要回表了。这里的“回表”,指的是再次查询主键索引,拿到需要的字段,而不是去读数据文件。如果索引里没有包含所需字段,那就免不了回表操作。所以,在实际的索引优化中,要尽量使用覆盖索引,避免回表带来的额外开销。
另外,推荐使用自增主键。这样新增数据时,直接在索引后面追加数据就行,而不是插入到中间。如果表中没有定义主键,InnoDB会虚拟一个主键,并基于它生成主键索引。
总结
从二叉树到B+Tree,再到不同引擎的索引实现,核心思路其实就一条:用合适的数据结构,尽可能减少磁盘I/O。而在实际开发中,覆盖索引、避免回表,是索引优化里最常用也最有效的手段之一。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章