

StabilityAI推出首个视频生视频模型StableVideo4D,输入单个物体视频即可在约40秒内生成8个不同视角的多视角视频,已开源至HuggingFace。该模型基于StableVideoDiffusion升级,可免费用于研究和非商业用途,服务于游戏开发、视频编辑、虚拟现实等领域。
D视频版Sora来了,AI视频生成新突破
作者:技术拾光
时间:2026-07-05
浏览:605
文章目录
40秒生成3D视频,Stability AI开源首个视频生视频模型
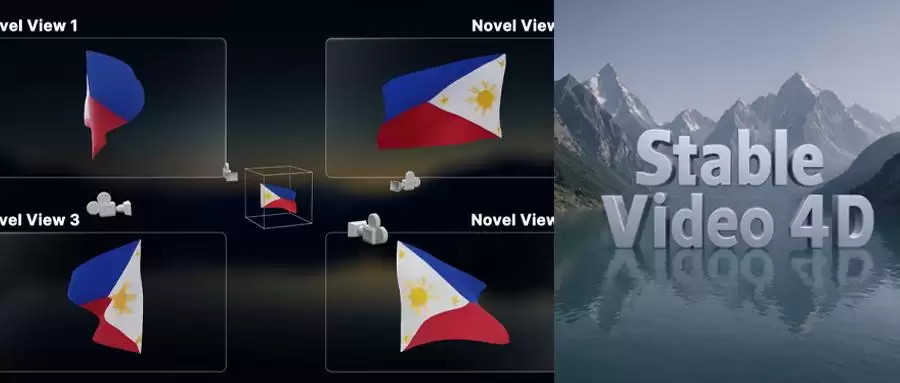
输入单个物体视频,就能获取任意拍摄视角的全视图3D动态视频——这项原本带有科幻色彩的能力,如今已有开源实现。
智东西7月25日消息,7月24日晚间,AI独角兽Stability AI推出其首个视频生视频(video-to-video)模型Stable Video 4D(SV4D)。该模型能直接实现:将单个物体的视频输入,转换为8个不同视角的多个新视频,用户可根据需要指定任意摄像机角度。
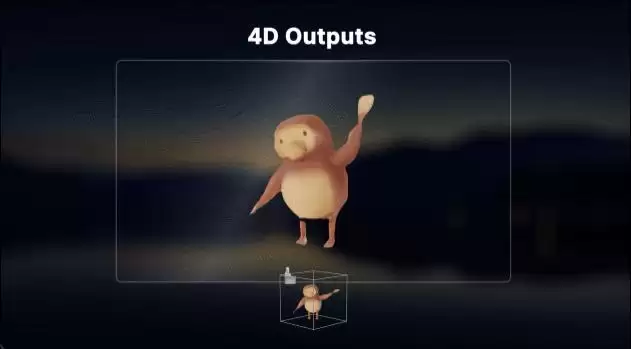
▲输出全视图视频演示
目前,SV4D单次推理约需40秒即可生成8个视图各5帧的视频,整个4D优化流程则需要20至25分钟。模型已在Hugging Face上开源,可应用于游戏开发、视频编辑、虚拟现实(VR)等场景,并免费用于研究与非商业用途。
与此同时,SV4D技术论文也已同步发布,研究团队由Stability AI和东北大学的学者组成,论文详细阐述了模型框架结构、优化策略及测评结果等内容。
▲SV4D论文
Stability AI自2019年成立以来,持续聚焦文字、图像、音频、视频等多模态领域的开源模型,并于2022年跻身独角兽行列。尽管自去年起经历了寻求出售、核心技术团队离职、CEO卸任等困境,但并未打断其持续开源新模型的步伐。
今年6月,Stability AI在债台高筑的情况下,获得前Facebook总裁Sean Parker等投资者8000万美元注资,并迎来新任CEO——前Weta FX(维塔数码)负责人Prem Akkaraju。Akkaraju上任后一个月内,接连发布了聊天机器人Stable Assistant、音频生成模型Stable Audio Open,以及本次的SV4D。
01. 基于SVD升级4D框架,40秒生成多视角视频
SV4D主要用于3D模型的多视角视频生成。输入为单个物体的单视角视频,输出则为同一物体8个不同角度的多视角视频。
该模型以图生视频模型Stable Video Diffusion(SVD)为基础,实现了从图生视频到视频生视频的能力跃升。具体运行时,用户先上传一段视频,再指定所需摄像机角度,SV4D将根据指定视角生成8个新视角视频,从而提供拍摄对象的全面多角度视图。生成的视频可用于优化拍摄对象的动态表示,在游戏开发、视频编辑、VR等场景中均能发挥作用。
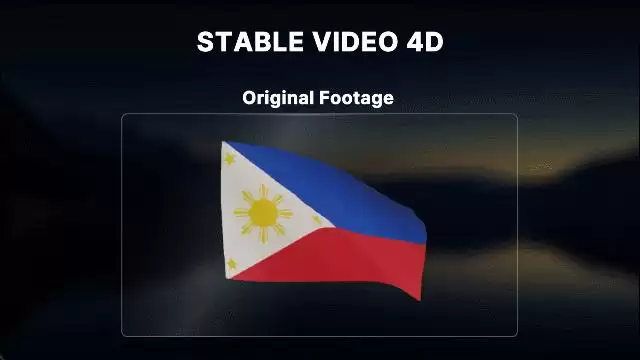
▲SV4D输入输出
目前SV4D仍处于研究阶段,可在约40秒内生成8个视角各5帧的视频,整个4D优化流程约需20至25分钟。
以往用于多视角视频生成的方法,通常需要从图像扩散模型、视频扩散模型和多视图扩散模型的组合中分别采样,而SV4D能同时生成多个新视图视频,显著提升了空间和时间轴的一致性。此外,该方法还能实现更轻量的4D优化框架,无需像以往那样使用多个扩散模型进行繁琐的分数蒸馏采样。
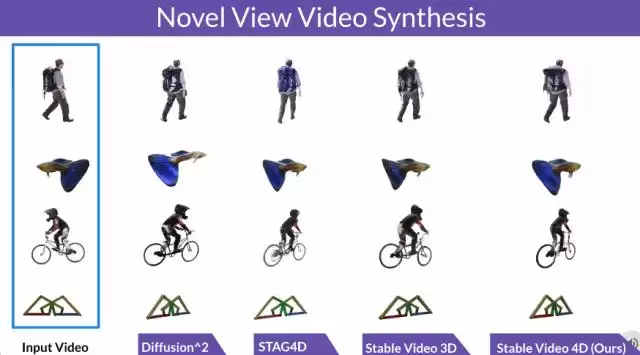
▲SV4D与其他方法对比
与其他方法相比,SV4D能生成更多样化的多视图视频,且更细致、更忠实于输入视频,在帧与视图之间保持良好一致性。
SV4D是Stability AI推出的首个视频到视频生成模型,已在Hugging Face上开源发布。Stability AI表示,团队仍在积极完善该模型,目标是使其能够处理更广泛的现实世界视频,而不仅限于用于训练的合成数据集。
02. 混合采样保持时间一致,4D生成全面超越基线
SV4D技术论文同步发布,其中详细解读了模型的框架结构。
总体而言,SV4D是一个用于生成动态3D对象新视图视频的统一扩散模型。给定一个单目参考视频,SV4D为每个视频帧生成在时间上一致的新视图,然后利用生成的新视图视频高效优化隐式4D表示,无需依赖基于分数蒸馏采样的优化。
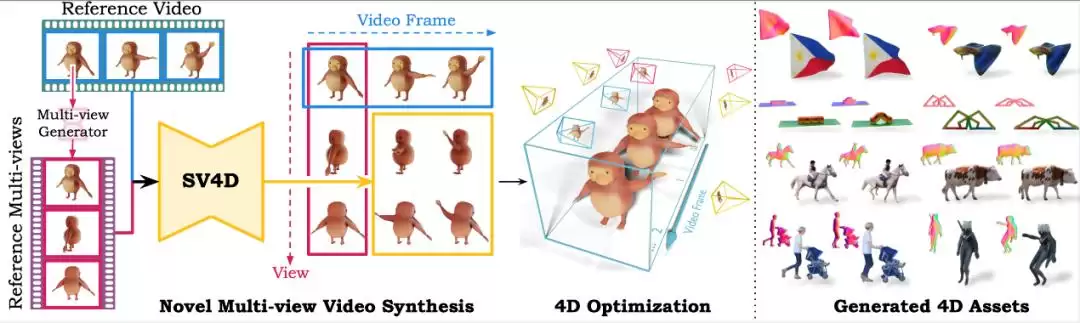
▲SV4D框架概述及生成的4D资产
SV4D模型结构如下图所示。基于相机条件,SV4D将相机视点的正弦嵌入传递给UNet中的卷积块,并在空间和视图注意力块中,使用输入视频进行交叉注意力条件设定。为提高时间一致性,SV4D引入了一个额外的运动注意力块,并以第一帧的相应视图为交叉注意力条件。
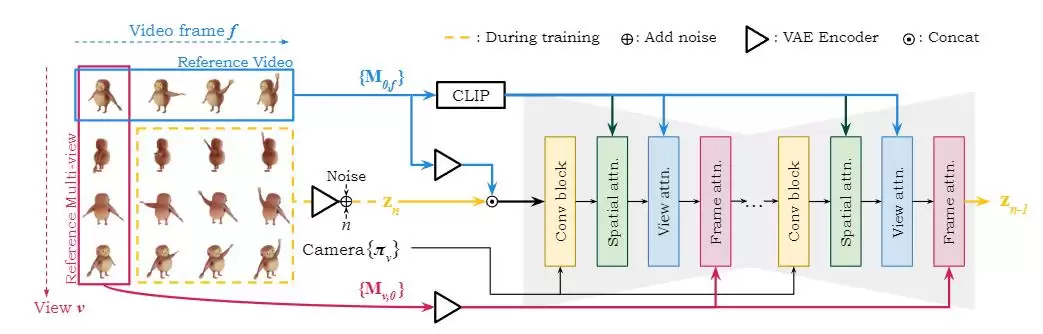
▲SV4D模型结构
为在保持时间一致性的同时扩展生成的多视图视频,研究团队在推理过程中提出了一种新颖的混合采样策略。首先,SV4D采样一组稀疏的锚定帧,然后将锚定帧作为新的条件图像,对中间帧进行密集采样或插值。为确保连续生成之间的平滑过渡,SV4D在密集采样期间交替使用时间窗口内的第一帧前向帧或最后一帧后向帧进行条件设置。
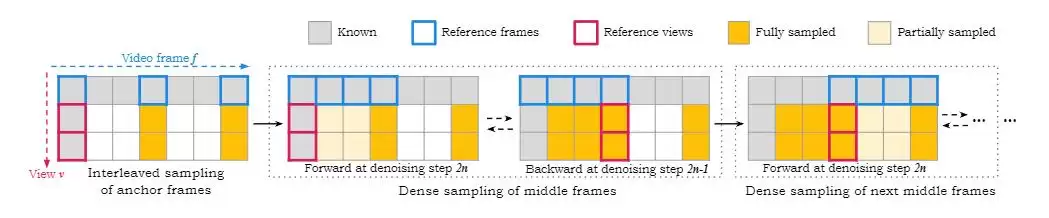
▲SV4D模型采样
在框架优化方面,SV4D使用参考多视图图像的第一帧,优化由多分辨率哈希网格以及密度和颜色多层感知机(MLP)表示的静态NeRF,然后解冻时间变形MLP,并使用随机采样的视图和帧来优化动态NeRF。
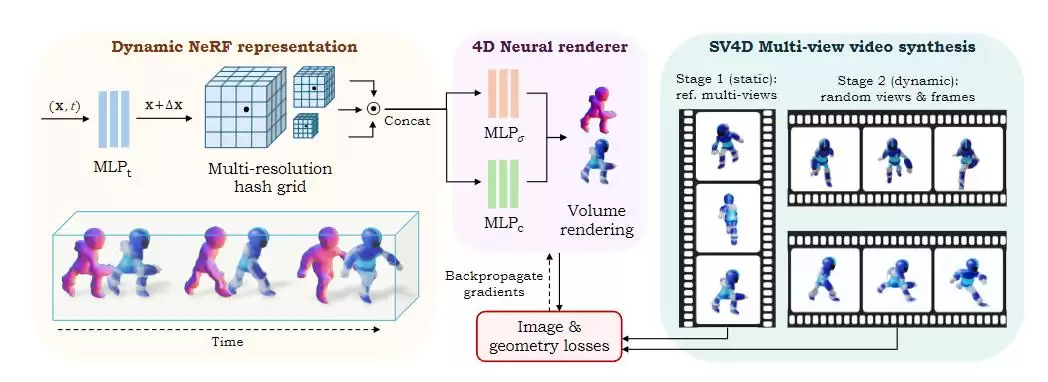
▲优化框架概述
为训练统一的新视图视频生成模型,SV4D研究团队从现有Obja verse数据集中整理了一个动态3D对象数据集。在多个数据集上的实验结果和用户研究显示,与以往工作相比,SV4D在新视图视频合成以及4D生成方面展现出最先进的性能。
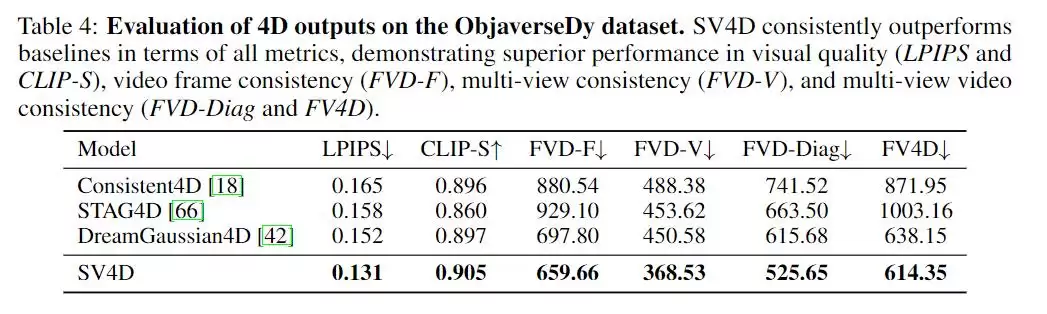
▲Obja verseDy数据集上4D输出的评估
在Obja verseDy数据集上的4D输出评估中,SV4D在所有指标上均优于基线,在视觉质量(LPIPS和CLIP-S)、视频帧一致性(FVD-F)、多视图一致性(FVD-V)以及多视图视频一致性(FVD-Diag和FV4D)等方面均超越了此前模型。
03. 结语:Stability AI多模态版图再添新布局
Stability AI以文生图开源模型起家,在文本、视频、3D等多个模态上均有布局。此次开源SV4D,是其在3D与视频生成两个方向上的共同进展。
尽管该模型目前仍处于前期研究阶段,但其在各项指标上表现出的优异能力以及模型架构上的创新思路,为未来发展开拓了广阔前景。随着模型迭代与优化,SV4D有望在游戏、VR等更多领域的应用中发挥重要作用。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章