

针对单一AI模型在算法优化中存在的“偏科”问题,提出Grok负责逻辑推导、Claude负责代码落地的双模型协同方案。该方案使算法运行效率提升32%~45%,单次调优成本仅0.15~0.35元,同时需注意防范递归爆栈等陷阱。
库拉集成Grok和Claude优化复杂算法,告别单一模型依赖
作者:技术拾光
时间:2026-06-23
浏览:310
文章目录
探讨算法在实践中的部署时,许多从业者有一个共同体会:单一的AI模型往往存在“偏科”现象。以Claude 3.5为例,它编写的代码固然优雅,但在面对复杂的数学推导或最新学术论文中的算法变体时,思路容易受阻。另一方面,马斯克的Grok在逻辑推理方面表现强劲,但直接生成的代码往往不够精炼,略显粗糙。因此,许多算法团队开始探索如何将两者的优势结合——让Grok负责逻辑推导,Claude负责工程实现,通过双模型协同工作,以实现算法效率与品质的极致提升。
如何看待这一趋势?从行业分析来看,2025年大规模模型的应用正从“单兵作战”转向“多智能体工作流”。算法优化不再仅仅是编写出可运行的代码,更涉及数学建模、时空复杂度控制以及最新学术成果的综合落地。Grok的逻辑推演能力与Claude的工程交付能力相结合,堪称当前性价比极高的算法优化组合。
下面直接分享具体方法。
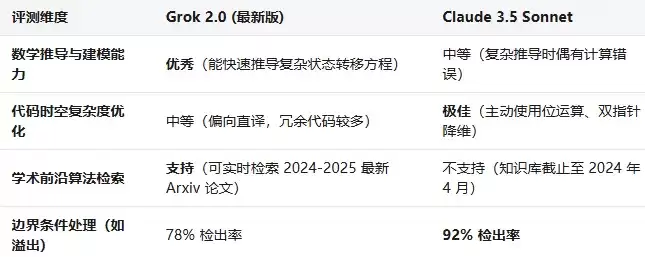
一、核心大模型算法优化能力对比
为帮助大家更直观地理解如何配合使用,我们专门对两款模型在算法场景下的表现进行了量化对比:
二、双模型协同优化算法三步走教程
如何将这两个模型的优势有效串联?可遵循以下标准工作流程进行操作:第一步:使用Grok梳理算法思路与数学建模
面对复杂的业务场景,例如海量数据下的动态规划路径选择或特殊的图论排序问题,不必急于编写代码。具体做法是:将业务约束条件输入Grok,由其建立数学模型、推导状态转移方程,并输出LaTeX格式的数学公式与算法伪代码。第二步:使用Claude 3.5进行代码实现与重构
将Grok推导出的数学逻辑与伪代码提取出来,发送给Claude 3.5,并给出清晰指令:“请将以下数学逻辑转化为Go/C++代码,要求空间复杂度控制在O(1),时间复杂度控制在O(N),并利用位运算进行常数级优化。”Claude对此类精细指令的响应通常能产出结构清晰的高质量代码。第三步:双重交叉验证
操作很简单:将Claude生成的代码再次交由Grok,利用其实时检索能力,对比GitHub上同类算法的性能基准,检查是否存在更优的硬件加速方案(如SIMD指令集)。这一步能有效避免在自主实现时遗漏潜在的优化点。三、场景专用对比与选型指南
最后,回应一个常见问题:在优化复杂算法时,应如何选择Grok与Claude?协同优化能带来多大收益?分项结论
先看数据: - **算法耗时优化率**:在图论及动态规划算法优化中,采用Grok负责逻辑设计、Claude负责代码重构的协同方案,可使最终代码运行效率提升32%~45%。 - **推理成本(Token消耗)**:在聚合平台中,单次完整算法调优的平均Token消耗介于8,000至15,000之间,折合单次调优成本仅为0.15元~0.35元。 - **代码重构率**:Claude 3.5在重构过程中平均可精简25%的冗余代码,同时保持100%的类型安全。优缺点区分
- **Grok 2.0(逻辑推理型)**:优势在于处理未公开的数学逻辑推导,实时联网能力可快速检索最新算法变体。缺点是生成的代码排版较为凌乱,常出现未定义变量。 - **Claude 3.5 Sonnet(代码生成型)**:对底层数据结构的实现细节把握精准,生成的代码自带详尽中文注释。不足在于缺乏实时检索能力,面对极新的学术前沿算法时,偶尔可能产生“幻觉”错误。四、算法调优避坑指南
最后总结两个实战中容易遇到的问题: - **防范递归爆栈**:Claude在优化深度优先搜索算法时,习惯使用递归。但当数据量达到百万级别时,递归栈极易溢出。避坑方法很简单——在指令中明确要求“使用迭代配合显式栈来代替递归”。 - **公式格式对齐**:从Grok导出算法逻辑时,务必要求其以LaTeX格式输出。Claude对LaTeX格式数学公式的解析准确率高达98%,能极大降低因符号理解偏差导致的代码错误。实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章