

多智能体龙虾系统通过顺序流水线实现分工执行,包含总经理、项目经理、前端工程师、算法工程师等角色。每个Agent拥有SKILL.md技能手册,通过上下文传递逐级细化任务,最终由项目经理汇总交付,解决了单体模型角色混淆与协作效率问题。
多Agent龙虾创新架构:一句话组建AI打工团队分工执行解析
作者:技术拾光
时间:2026-06-13
浏览:671
文章目录
一、行业背景:从单体LLM到多Agent协作的范式跃迁
1.1 单体模型的瓶颈
大语言模型在过去两年取得了惊人的进步,但在实际落地中,我们始终面临一个核心矛盾:一个模型再强,也只是“一个人在战斗”。 当用户提出一个复杂需求,比如“帮我开发一个基于GraphRAG的智能问答系统”——这个需求天然横跨了战略分析、项目管理、前端架构、算法设计等多个专业领域。让一个LLM同时扮演所有角色,输出往往沦为“大而全却浅尝辄止”的四不像:每一点都沾边,但每一点都不够深入。 这背后的技术根因是: * **上下文窗口的竞争**:当单一Prompt试图承载多个角色的指令,有效上下文被摊薄,模型难以在每个维度都深入。 * **角色混淆**:同一个模型在“战略视角”和“代码实现”之间频繁切换,导致输出风格割裂。 * **缺乏协作结构**:单体模型无法享受“前序角色的输出作为后序角色的输入”这种流水线增益。1.2 多Agent协作的崛起
2024年以来,从AutoGen到CrewAI,从LangGraph到OpenAI Swarm,多Agent框架如雨后春笋般涌现。但大多数框架停留在“编排层”——它们解决了“谁先谁后”的问题,却没有解决每个Agent凭什么专业的问题。 这就像组建了一个团队,每个成员只有岗位名称,没有专业技能手册。结果就是:5个Agent开会讨论,5个都在说车轱辘话。 多智能体龙虾系统的核心创新,正在于将“角色定义 + 专业技能 + 流水线协作”三者一体化:每个龙虾Agent不只是有一个名字,而是拥有一份完整的SKILL.md技能手册,内含核心技能、辅助技能、软技能的层次化定义,以及具体的应用场景示例。1.3 为什么是龙虾?
龙虾(Lobster)——甲壳坚硬、钳子分工(一只碎壳、一只切割)、蜕壳重生。这恰好是多Agent系统的隐喻:每个Agent外壳坚固(角色边界清晰),左右钳各有分工(核心技能+辅助技能),且能随业务蜕壳升级(技能体系可迭代)。二、核心技术架构:龙虾团队的“操作系统”
2.1 整体架构概览
``` ┌──────────────────────────────────────────────────────┐ │ 前端 (index.html + app.js) │ │ ┌─────────┐ ┌──────────┐ ┌────────────────────┐ │ │ │ 数字员工 │ │ 开会模式 │ │ WebSocket消息渲染 │ │ │ │ 卡片网格 │ │ 六边形布局 │ │ (agent_start/ │ │ │ │ (10只龙虾)│ │ 气泡发言 │ │ agent_chunk/ │ │ │ └─────────┘ └──────────┘ │ agent_done/ │ │ │ │ multi_agent_ │ │ │ │ complete) │ │ │ └────────────────────┘ │ └──────────────────────┬───────────────────────────────┘ │ WebSocket (ws://localhost:8001/api/chat/ws) ┌──────────────────────┴───────────────────────────────┐ │ 后端 (FastAPI + StreamHandler) │ │ ┌──────────────────────────────────────────────────┐ │ │ │ StreamHandler (核心调度引擎) │ │ │ │ handle_chat() → 路由分发 │ │ │ │ ├── "多数字员工规划" → handle_multi_agent_chat │ │ │ │ ├── "财经分析" → web_agent_chat │ │ │ │ └── "数学画图" → math_agent_chat │ │ │ └──────────────────────────────────────────────────┘ │ │ ┌────────────┐ ┌─────────────┐ ┌──────────────┐ │ │ │ QwenService│ │ SkillLoader │ │ Conversation │ │ │ │ (LLM调用) │ │ (SKILL.md解析)│ │ Manager │ │ │ │ AsyncOpenAI│ │ (脚本执行) │ │ (JSON持久化) │ │ │ └────────────┘ └─────────────┘ └──────────────┘ │ └──────────────────────────────────────────────────────┘ │ ┌────────────────────────┴───────────────────────────────┐ │ 技能层 (skills/ 目录) │ │ 总经理/项目经理/前端工程师/算法工程师/ │ │ 产品经理/ UI设计/数据分析师/个人秘书/ │ │ 客服/财经分析/多数字员工规划/ │ │ 每个目录: SKILL.md + scripts/ + references/ │ └──────────────────────────────────────────────────────────┘ ```2.2 三层架构的职责划分
| 层次 | 组件 | 核心职责 | | :--- | :--- | :--- | | **交互层** | 前端HTML/CSS/JS | 数字员工卡片展示、开会模式、WebSocket消息渲染、Markdown/LaTeX排版 | | **调度层** | StreamHandler | 多Agent流水线编排、WebSocket消息协议、上下文传递、对话持久化 | | **技能层** | SKILL.md体系 | 角色定义、技能分类、参考文档、可执行脚本 | 这种三层分离的设计使得:换模型不影响协作逻辑,改协作流程不影响技能定义,增减员工只改SKILL.md。三、分工执行的核心机制:5阶段顺序流水线
3.1 流水线设计哲学
多智能体龙虾系统的分工执行,本质上是一个带上下文传递的顺序流水线(Sequential Pipeline with Context Passing)。 不同于传统的并行多Agent模式(各Agent独立回答后投票/汇总),龙虾系统选择了顺序模式,原因有三: 1. **真实团队的协作是串行的**:在现实软件公司中,总经理先分析,项目经理再规划,工程师再执行——信息天然有序流动。 2. **上下文累积增益**:后序Agent能看到前序Agent的完整输出,站在“巨人的肩膀上”深入,而非从零开始。 3. **避免角色冲突**:并行模式下多个Agent可能给出矛盾建议,顺序模式通过信息流方向天然消解冲突。3.2 五阶段流水线详解
以 `handle_multi_agent_chat()` 方法为核心,整个协作分为5个阶段: ``` 用户需求 │ ▼ ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐ ┌──────────┐ │ Stage 1 │──│ Stage 2 │──│ Stage 3 │──│ Stage 4 │──│ Stage 5 │ │ 总经理 │ │ 项目经理 │ │ 前端工程师 │ │ 算法工程师 │ │ 项目经理 │ │ 需求分析 │ │ 任务分配 │ │ 前端方案 │ │ 算法方案 │ │ 总结交付 │ └──────────┘ └──────────┘ └──────────┘ └──────────┘ └──────────┘ 300字 400字 500字 500字 500字 ```Stage 1:总经理——需求分析与战略定位
``` general_manager_prompt = f""" 你扮演微学AI软件公司的【总经理】角色。请根据用户提出的需求,从战略和全局角度进行分析。 用户需求:{message} 请给出专业的需求分析,描述一下需求的意义和价值,背景。 请用专业但易懂的语言进行阐述。输出一段话即可,只要输出300字左右。 """ ``` 设计要点: * 总经理只接收用户原始需求,不携带其他Agent的输出——确保“第一视角”的纯粹性。 * 字数限制300字——强制聚焦,避免战略分析沦为长篇大论。 * 提示词强调“意义和价值”——总经理的角色定位是“Why”而非“How”。 输出示例(假设用户需求为“开发一个AI面试助手”):Stage 2:项目经理——任务拆解与分工规划
``` pm_prompt = f""" 你扮演微学AI软件公司的【项目经理】角色。基于总经理的需求分析,请进行项目规划和任务分配。 用户原始需求:{message} 总经理分析:{response_text} # ← 携带Stage 1的输出 请给出: ## 1. 项目里程碑规划 ## 2. 具体的任务分解 ## 3. 各角色的职责分工 ## 4. 时间线和优先级建议 """ ``` 设计要点: * 项目经理接收用户原始需求 + 总经理分析——双输入保证任务拆解既有业务依据又有战略方向。 * 结构化输出模板(4个二级标题)——引导模型按项目管理框架思考,减少发散。 * 字数限制400字——比总经理多100字,因为任务拆解需要更多细节。 上下文传递的关键:注意 `{response_text}` 变量在Stage 2中被复用,此时它保存的是总经理的输出。这种“变量接力”是整个流水线的核心机制。Stage 3:前端工程师——前端技术方案
``` frontend_prompt = f""" 你扮演微学AI软件公司的【前端工程师】角色。请从前端开发角度分析需求并给出技术方案。 用户需求:{message} 项目计划:{response_text} # ← 此时携带的是Stage 2项目经理的输出 请给出: ## 1. 前端技术架构建议 ## 2. 关键技术选型 ## 3. 界面设计方案要点 ## 4. 用户体验优化建议 请给出专业的前端开发方案。只要输出500字左右。最后回答已经开始干活了。 """ ``` 设计要点: * 前端工程师接收的是项目经理的任务分配,而非总经理的战略分析——信息流的粒度在逐级细化。 * 末尾“已经开始干活了”——模拟真实工程师的行事风格,增强沉浸感。 * 字数增至500字——技术方案需要具体的架构描述和选型理由。Stage 4:算法工程师——算法实现方案
``` algo_prompt = f""" 你扮演微学AI软件公司的【算法工程师】角色。请从算法和技术实现角度分析需求并给出解决方案。 用户需求:{message} 前端方案:{response_text} # ← 此时携带的是Stage 3前端工程师的输出 请给出: ## 1. 核心算法设计 ## 2. 技术实现方案 ## 3. 数据处理流程 ## 4. 性能优化策略 """ ``` 设计要点: * 算法工程师看到的是前端方案——这意味着算法设计可以与前端接口对齐,避免“前后端不匹配”的经典问题。 * 输出框架更偏向“实现层”——核心算法、数据处理、性能优化,这些都是可落地的技术细节。 * 与Stage 3形成前后端协作的自然闭环。Stage 5:项目经理——总结交付
``` summary_prompt = f""" 你扮演微学AI软件公司的【项目经理】角色。请根据前面各角色的分析,生成项目总结和交付文档。 用户原始需求:{message} 总经理分析:{general_manager_response} 项目经理任务分配:{pm_response} 前端工程师方案:{frontend_response} 算法工程师方案:{algo_response} 请综合所有分析内容,输出一份完整的项目总结和交付文档,包含: ## 1. 项目概述与背景 ## 2. 需求分析总结 ## 3. 技术方案概述 ## 4. 交付清单和时间节点 ## 5. 项目工程文件包 """ ``` 设计要点: * 全量上下文汇聚:Stage 5是唯一一个能看到所有前序Agent输出的阶段——项目经理在此刻扮演“信息枢纽”。 * 变量命名从 `response_text` 变为具名变量(`general_manager_response`, `pm_response` 等)——因为需要精确引用每个角色的输出。 * 输出交付文档而非讨论——标志着从“分析”到“交付”的转换。3.3 上下文传递的数据流图
``` message (用户原始需求) │ ├── Stage 1: 总经理 ← {message} │ │ │ ▼ general_manager_response ├── Stage 2: 项目经理 ← {message} + {general_manager_response} │ │ │ ▼ pm_response ├── Stage 3: 前端工程师 ← {message} + {pm_response} │ │ │ ▼ frontend_response ├── Stage 4: 算法工程师 ← {message} + {frontend_response} │ │ │ ▼ algo_response └── Stage 5: 项目经理 ← {message} + {general_manager_response} + {pm_response} + {frontend_response} + {algo_response} │ ▼ summary_text (最终交付) ``` 注意一个精妙的细节:Stage 2-4中,每个Agent只看到前一个Agent的输出(通过 `response_text` 变量接力),而非全部前序输出。这是有意为之的信息过滤——避免上下文过长导致模型注意力分散,同时保证信息流的线性递进。 而Stage 5则打破了这个规则,全量汇聚所有输出——因为项目经理的总结角色需要“上帝视角”。四、WebSocket实时协作协议:龙虾们的“对讲机”
4.1 自定义消息类型体系
龙虾系统定义了一套轻量但完备的WebSocket消息协议,专门服务于多Agent协作场景: | 消息类型 | 方向 | 语义 | 关键字段 | | :--- | :--- | :--- | :--- | | `agent_start` | Server→Client | 某Agent开始响应 | agent_index, agent_name, agent_a vatar, agent_description | | `agent_chunk` | Server→Client | Agent的流式输出片段 | agent_index, content, done | | `agent_done` | Server→Client | 某Agent完成响应 | agent_index | | `multi_agent_complete` | Server→Client | 全部Agent协作完成 | (空) | | `status` | Server→Client | 系统状态通知 | status, message, skill | | `chunk` | Server→Client | 普通聊天流式片段 | content, done | | `error` | Server→Client | 错误信息 | error, details | 这套协议的设计哲学是:用最小的消息类型集合,覆盖多Agent协作的完整生命周期。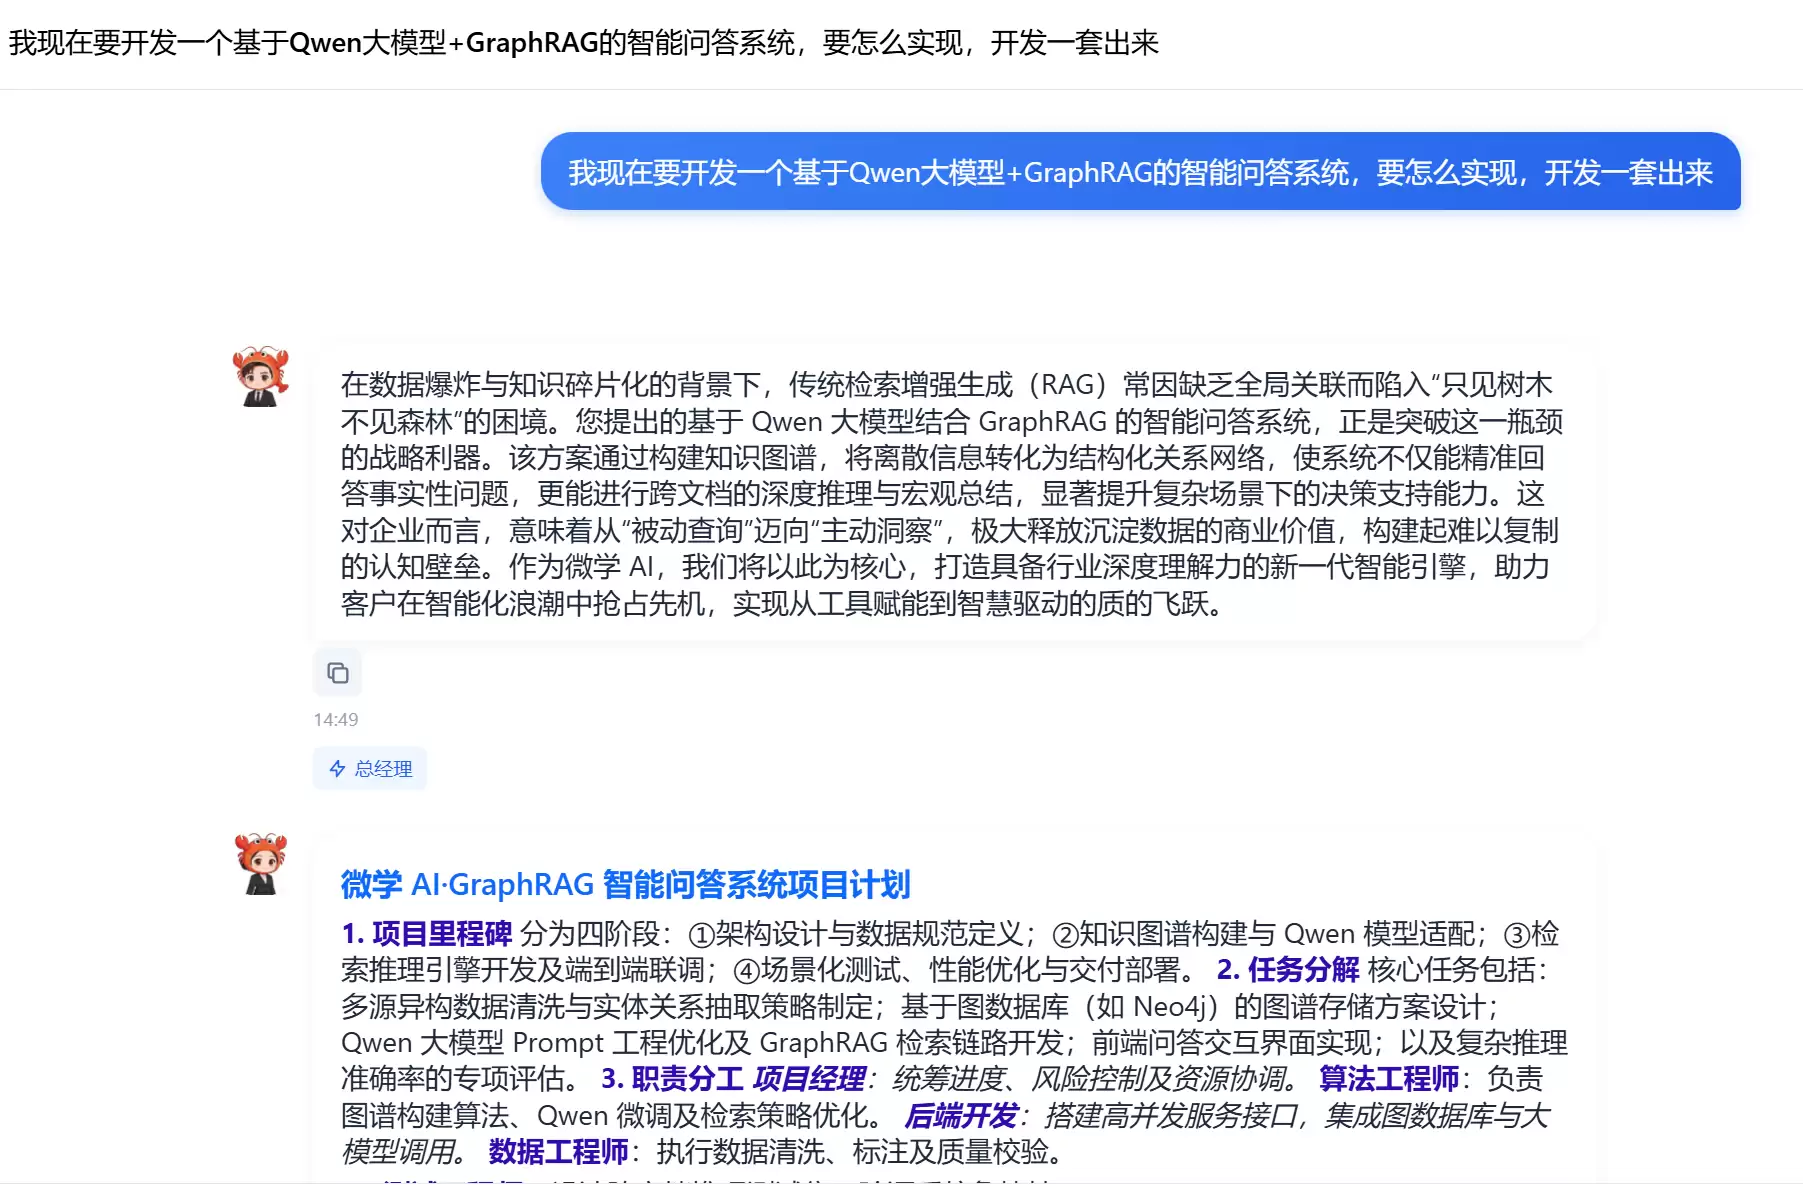
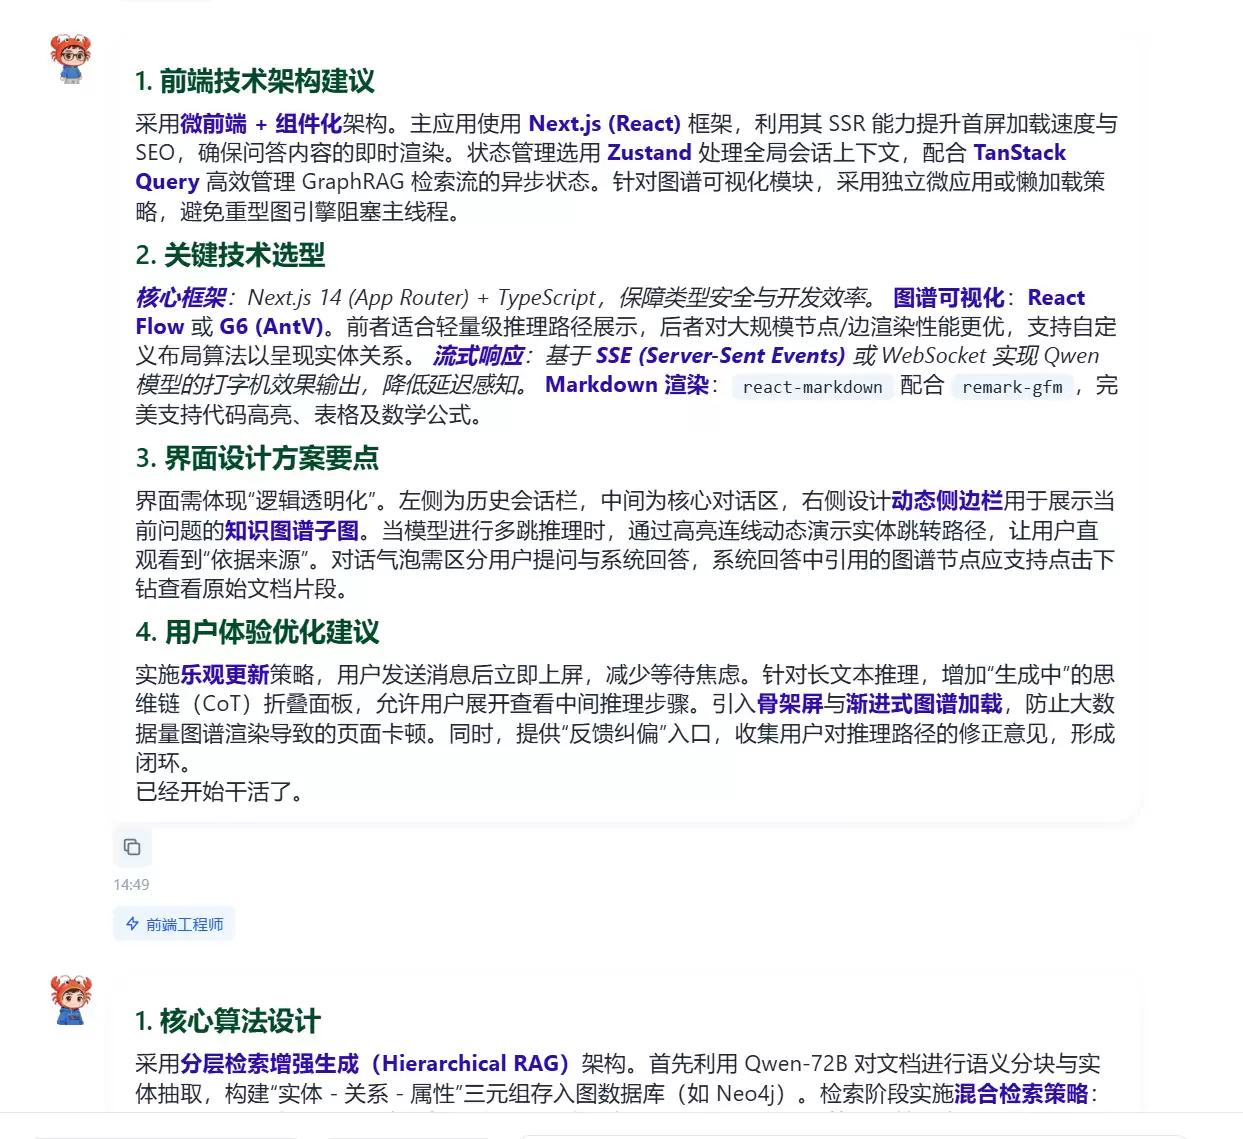
4.2 消息流转时序图
4.3 agent_index的角色映射
`agent_index` 是前端区分“当前谁在说话”的关键标识: | agent_index | 角色名称 | 阶段 | 头像 | | :---: | :--- | :--- | :-- | | 0 | 总经理 | 需求分析 | 总经理-龙虾.png | | 1 | 项目经理 | 任务分配 | 项目经理-龙虾.png | | 2 | 前端工程师 | 前端方案 | 前端工程师-龙虾.png | | 3 | 算法工程师 | 算法方案 | 算法工程师-龙虾.png | | 4 | 项目经理 | 总结交付 | 项目经理-龙虾.png | 前端通过 `agent_index` 精确控制每条消息的归属渲染——同一个项目经理在Stage 2和Stage 5使用相同的头像和名称,但 `agent_index` 不同,UI可以分别展示。4.4 流式输出的工程实现
每个Agent的输出都通过 `qwen_service.chat_stream()` 实现逐token推送: ``` async for chunk in qwen_service.chat_stream([{"role": "user", "content": prompt}], model=model): response_text += chunk await self.send_agent_chunk(agent_index, chunk, done=False) await self.send_agent_chunk(agent_index, "", done=True) ``` 关键设计: * **增量推送**:每收到一个token就立即推送给前端,而非等全部生成完毕——用户可以实时看到每个龙虾“边想边说”。 * **空chunk + done=True**:作为流结束标志,与内容chunk区分开。 * **变量累积**:`response_text += chunk` 在内存中持续拼接完整回复,供后续阶段作为上下文使用。五、分工执行的三大应用场景
5.1 场景一:全链路软件项目开发(核心场景)
触发方式:选择“多数字员工规划”技能。 这是龙虾系统最核心的分工执行场景。用户输入一句话需求,5个阶段自动流转: ``` 用户: "帮我开发一个基于GraphRAG的智能问答系统" 龙虾团队协作过程: 总经理: "GraphRAG是下一代RAG架构,通过知识图谱增强检索召回率..." 项目经理: "M1(1-2分钟): 需求确认与图谱Schema设计; M2(2-3分钟): 算法原型..." 前端工程师: "采用React+D3.js构建知识图谱可视化,支持节点交互探索..." 算法工程师: "核心采用LightRAG架构,Entity抽取用NER pipeline,关系推理用..." 项目经理: "交付清单: 1.知识图谱Schema 2.前端交互原型 3.GraphRAG算法包..." ``` 场景价值: * 用户从“一句话想法”到“可执行方案”的全自动转化。 * 每个维度的分析深度远超单体模型(因为有角色专注度保障)。 * 前后端方案天然对齐(算法工程师看到了前端方案)。5.2 场景二:财经分析(专业垂直场景)
触发方式:选择“财经分析”技能。 ``` async def web_agent_chat(self, message, conversation_id, model): # Stage 1: 前端工程师提供数据页面 await self.send_agent_start(1, "前端工程师", ...) texts = "## 股市市场分析 https://summary.jrj.com.cn/dataCenter/dpyt/" await self.send_agent_chunk(1, texts, done=False) # Stage 2: 财经分析师进行深度解读 await self.send_agent_start(2, "财经分析", ...) general_manager_prompt = f""" 你扮演【财经分析】角色。用户需求:{message} 默认今天是2026年4月21日,目前上证指数4073点,跌幅0.21%... """ ``` 场景特点: * 2阶段精简流程:前端工程师提供实时数据页面URL → 财经分析师解读分析。 * 嵌入式URL:前端直接推送金融数据网站链接,用户可点击查看实时数据。 * 时效性注入:Prompt中嵌入当前日期和大盘数据,确保分析基于最新市场状态。 这个场景展示了一个重要的设计模式:并非所有分工都需要5阶段全流程。根据需求复杂度,可以灵活裁剪为2阶段、3阶段等轻量流程。5.3 场景三:数学画图(工具集成场景)
触发方式:选择“数学画图”技能。 ``` async def math_agent_chat(self, message, conversation_id, model): # Stage 1: 算法工程师给出画图策略 await self.send_agent_start(1, "算法工程师", ...) general_manager_prompt = f""" 你扮演【算法工程师】角色。用户需求:{message} 给出画图策略,200字左右 """ # Stage 2: 前端工程师提供GeoGebra工具页面 await self.send_agent_start(2, "前端工程师", ...) texts = "## 数学画图操作 https://www.geogebra.org/geometry" await self.send_agent_chunk(2, texts, done=False) ``` 场景特点: * 算法+工具的组合:算法工程师先给出画图思路,前端工程师再提供GeoGebra在线工具。 * 思路先行,工具跟上:避免用户拿到工具却不知道怎么画。 * 外部工具集成:通过URL嵌入的方式,将GeoGebra等专业工具无缝集成到对话流中。六、SKILL.md技能体系:龙虾们的“专业证书”
6.1 技能定义的三层结构
每个龙虾Agent的专业能力由SKILL.md定义,采用YAML front matter + Markdown正文的标准格式: ``` skills/ ├── 总经理/ │ └── SKILL.md # 角色: 战略规划与决策支持 ├── 项目经理/ │ └── SKILL.md # 角色: 项目管理与协调 ├── 前端工程师/ │ └── SKILL.md # 角色: 界面开发与用户体验 ├── 算法工程师/ │ └── SKILL.md # 角色: 算法设计与模型训练 ├── 产品经理/ │ └── SKILL.md # 角色: 需求分析与产品规划 ├── UI设计/ │ └── SKILL.md # 角色: 界面设计与视觉优化 ├── 数据分析师/ │ └── SKILL.md # 角色: 数据挖掘与洞察 ├── 个人秘书/ │ └── SKILL.md # 角色: 日程管理与事务处理 ├── 客服/ │ └── SKILL.md # 角色: 客户咨询与问题解答 ├── 财经分析/ │ └── SKILL.md # 角色: 财经与股票分析 └── 多数字员工规划/ └── SKILL.md # 元技能: 团队协作流程定义 ``` 以总经理的SKILL.md为例,技能体系分为三个层次: ``` ## 二、必备技能体系 ### (一)专业技能 1. 战略规划能力→ SWOT/PEST分析、目标设定、路径规划 2. 经营决策能力→ 信息整合、风险评估、成本收益分析 3. 财务管理能力→ 财务分析、预算管理、成本控制 4. 组织管理能力→ 架构设计、制度建设、流程优化 ### (二)辅助技能 1. 数据分析能力→ 数据整理、趋势分析、可视化呈现 2. 项目管理能力→ 项目规划、资源协调、进度管控 3. 法律合规意识→ 风险识别、合规审查 4. 技术理解力→ 技术趋势把握、价值评估 ### (三)软技能 1. 领导力 2. 沟通能力 3. 决策力 4. 学习能力 5. 情绪管理 6. 洞察力 ```6.2 技能加载与执行流程
当用户选择某个技能时,`SkillLoader` 执行以下流程: ``` # 1. 解析SKILL.md的YAML front matter skill_context = await skill_loader.execute_skill(selected_skill, {"message": message}) # 2. 构建技能提示 skill_prompt = f"# 技能: {skill_context['name']}" skill_prompt += f"# 描述: {skill_context['description']}" # 3. 注入参考文件 if skill_context.get('references'): for ref in skill_context['references']: skill_prompt += f"## {ref['filename']}\n{ref['content']}" # 4. 注入脚本执行结果 if skill_context.get('script_result'): skill_prompt += f"# 技能执行结果:\n{skill_context['script_result']}" # 5. 组装系统消息 skill_system_message = {"role": "system", "content": f"你现在需要使用 {selected_skill} 技能来回答用户问题。以下是技能相关信息:{skill_prompt}"} ``` 这种设计使得技能的定义(SKILL.md)和技能的执行(StreamHandler中的Prompt组装)完全解耦。新增一个龙虾员工,只需要新增一个目录和SKILL.md文件,无需修改任何代码。6.3 技能体系与多Agent协作的映射关系
10个龙虾员工在多Agent协作中并非全部参与,而是根据场景动态选择: | 协作场景 | 参与的龙虾 | 阶段数 | | :--- | :--- | :--- | | 多数字员工规划 | 总经理→项目经理→前端工程师→算法工程师→项目经理 | 5 | | 财经分析 | 前端工程师→财经分析师 | 2 | | 数学画图 | 算法工程师→前端工程师 | 2 | | 单技能对话 | 任意单个龙虾 | 1 | 未来扩展:可根据需求类型自动路由到不同的龙虾组合,比如“设计需求”触发总经理→产品经理→UI设计→前端工程师的4阶段流程。七、前端交互设计:龙虾团队的“作战室”
7.1 数字员工卡片系统
前端用5列网格布局展示10个龙虾员工的数字工牌: ```
总经理
战略规划与决策支持
工作中...7.2 开会模式:六边形协作可视化
点击顶部的“开会模式”按钮,前端切换到六边形布局: ``` ┌─────┐ ┌────┤总经理├────┐ │ └─────┘ │ ┌───┴───┐ ┌───┴───┐ │产品经理│ │项目经理│ └───┬───┘ └───┬───┘ │ ┌─────┐ │ └────┤秘书 ├────┘ └──┬──┘ ┌──────┼──────┐ ┌───┴───┐┌──┴──┐┌──┴───┐ │前端工程││UI设计││算法工程│ └───────┘└─────┘└──────┘ ``` 开会模式下: * 龙虾头像排列为六边形会议桌布局。 * 正在发言的龙虾头像放大、加光晕。 * 发言内容以气泡形式浮在头像旁边。 * 打字机效果逐字显示,增强沉浸感。7.3 多Agent消息的差异化渲染
前端通过 `agent_index` 区分不同龙虾的消息,实现差异化渲染: ``` handleAgentStart(data) { // 创建新的消息气泡,使用agent_name和agent_a vatar // 添加蓝色左边框标识多Agent消息 } handleAgentChunk(data) { // 将chunk追加到对应agent_index的消息气泡中 // 支持Markdown实时渲染 + LaTeX公式 } handleAgentDone(data) { // 完成当前Agent的消息渲染 // 滚动到底部 } handleMultiAgentComplete(data) { // 全部Agent完成,恢复输入状态 } ``` CSS中多Agent消息使用蓝色左边框(`border-left: 3px solid #3b82f6`)与普通消息区分,每个Agent消息块内嵌头像和名称,形成类似Slack Thread的视觉效果。八、模型路由与多Provider支持
8.1 模型选择器
前端提供10个模型选项,覆盖国内外主流大模型: | 模型 | 提供商 | 特点 | | :--- | :--- | :--- | | Qwen3.5-Plus | 阿里云 | 默认模型,性价比高 | | Qwen3.5-397B-A17B | 阿里云 | MoE架构,超强推理 | | Qwen3-235B | 阿里云 | 高质量中文输出 | | GLM-5 | 智谱AI | 中文理解力强 | | MiniMax-M2.5 | MiniMax | 长上下文优势 | | Doubao-Seed-2.0-Code | 字节跳动 | 代码生成专精 | | Gemini3 | Google | 多模态能力 | | DeepseekV3.1 | DeepSeek | 推理链深度 | | GPT5.2 | OpenAI | 综合能力标杆 | | Claude4.2 | Anthropic | 长文本理解 |8.2 OpenAI兼容接口的统一封装
所有模型通过统一的OpenAI兼容接口调用: ``` class QwenService: def __init__(self): self.client = AsyncOpenAI( api_key=settings.api_key, base_url=settings.base_url # 统一API网关 ) async def chat_stream(self, messages, model=None): model = model or settings.default_model stream = await self.client.chat.completions.create( model=model, messages=messages, stream=True ) async for chunk in stream: if chunk.choices[0].delta.content: yield chunk.choices[0].delta.content ``` 这种设计使得:切换模型只需修改前端下拉选择,后端无需任何改动。API网关(如aiping.cn)负责将OpenAI格式的请求路由到不同Provider。九、对话持久化与状态管理
9.1 JSON文件存储
对话数据以JSON文件形式持久化在 `data/` 目录下: ``` class ConversationManager: def add_message(self, conversation_id, role, content, skill_used=None): """添加消息到对话""" message = Message( role=role, content=content, skill_used=skill_used # 记录使用的技能/Agent ) ``` 每条消息记录了: * `role`: user / assistant * `content`: 消息内容 * `skill_used`: 使用的龙虾Agent名称(如“总经理”、“算法工程师”) 这种设计使得: * 可以追溯每个需求被哪些龙虾处理过。 * 历史对话可以作为新对话的上下文(`get_messages(limit=10)` 获取最近10条)。 * 支持多轮对话中的Agent角色记忆。9.2 WebSocket连接管理
``` async def websocket_handler(websocket: WebSocket): handler = StreamHandler(websocket) wait handler.connect() try: while True: data = await websocket.receive_json() if data.get("type") == "chat": await handler.handle_chat(data) except WebSocketDisconnect: await handler.handle_disconnect() ``` 长连接保持,单连接多轮对话,断线自动清理。十、深度思考与未来演进
10.1 当前架构的优势与局限
**优势**: * **角色专业度保障**:每个Agent有独立的SKILL.md,避免了“一个人演多个角色”的困境。 * **上下文累积增益**:顺序流水线确保后序Agent站在前序Agent的肩膀上。 * **实时交互体验**:WebSocket流式输出让用户感受到“团队在协作”。 * **低成本扩展**:新增龙虾员工只需新增SKILL.md,无需改代码。 **局限**: * **顺序执行的延迟叠加**:5个阶段串行,总耗时≈5×单Agent耗时。 * **无并行协作能力**:前端工程师和算法工程师天然可以并行,但当前只能串行。 * **上下文窗口消耗**:Stage 5汇聚全部输出,长需求可能导致超长Prompt。 * **缺乏反思机制**:Agent之间没有“质疑-修正”的迭代循环。10.2 演进路线图
* **Phase 1 — 并行流水线**: * 将Stage 3(前端)和Stage 4(算法)改为并行执行。 * 使用 `asyncio.gather()` 同时调用两个Agent。 * 预计延迟减少约30%。 * **Phase 2 — 动态路由**: * 根据用户需求类型,自动选择参与的龙虾组合。 * “设计需求”→总经理+产品经理+UI设计。 * “数据分析需求”→总经理+数据分析师+算法工程师。 * 实现需求到Agent组合的智能映射。 * **Phase 3 — 反思循环**: * 在Stage 5之后增加“交叉评审”阶段。 * 算法工程师评审前端方案的技术可行性。 * 前端工程师评审算法方案的接口友好度。 * 形成“执行→评审→修正”的迭代闭环。 * **Phase 4 — 多模态协作**: * 引入图像生成Agent(Stable Diffusion)。 * 引入代码执行Agent(Jupyter内核)。 * 引入数据可视化Agent(ECharts/Matplotlib)。 * 实现“文字+代码+图表+设计稿”的多模态交付。10.3 对行业的启示
多智能体龙虾系统的实践给我们三点启示: 1. **分工比规模更重要**:与其追求一个“无所不能”的超大模型,不如让多个专业小模型各司其职。现实中没有“全能员工”,AI也不应该有。 2. **上下文传递是协作的灵魂**:多Agent系统的关键不是“有多少个Agent”,而是“Agent之间传递什么信息”。龙虾系统的顺序流水线设计,本质上是一种信息过滤机制——每个Agent只看到与它相关的上下文。 3. **技能定义应该与编排逻辑分离**:SKILL.md体系让“Agent会什么”和“Agent怎么协作”完全解耦。这意味着你可以用同一套技能定义,搭配不同的编排策略(顺序、并行、层级、动态路由),适应不同场景。总结
多智能体龙虾系统是一个从真实业务需求出发、逐步演进的工程实践。它没有追求架构上的“完美”,而是务实地解决了“一句话需求如何被AI团队分工执行”的核心问题。 5阶段顺序流水线、WebSocket实时协作协议、SKILL.md技能体系、10只龙虾的专业分工——这些设计选择背后,是对“AI协作应该像人类团队协作一样自然”这一理念的坚持。 当你下次对着龙虾系统说“帮我做一个XXX”时,想象一下:10只龙虾同时竖起耳朵,总经理开始思考战略,项目经理翻开任务板,前端和算法工程师已经打开IDE——一句话,整个团队开始运转。 这,就是分工执行的魅力。实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章