

大模型驱动的Skills测试落地需遵循四条铁律:粒度拆分为不可再分的业务验证点;用输出Schema强制约束格式;独立环境预检与回滚;暴露决策日志形成闭环。这能有效提升稳定性与可复用性。
Skills测试避坑指南:粒度拆分与稳定性4条铁律
作者:技术拾光
时间:2026-06-12
浏览:642
文章目录
上个月和一个测试总监聊天,他说团队已经用大模型+Skills跑通了一个核心场景的自动化生成。但两周后,他直接把那个Skill下线了。
原因很简单。生成的测试用例要么粒度太粗,漏掉了边界条件;要么太细,每次跑都因为环境抖动失败。更糟心的是,同一个Skill上午跑得好好的,下午就不行了。
这绝非个例。过去几个月,我看了看十几个团队落地Skills测试的案例,踩的坑出奇一致。今天不说概念,直接聊聊实战中碰过的壁和总结出的四条铁律。
一、看起来很美的Skills,落地就碎
第一个坑:粒度拆不好。
有人把“测试整个下单流程”写成一个Skill。结果大模型面对这个庞大的意图,生成了一套包含登录、选品、加购、下单、支付、查订单的超级脚本。中间任何一个环节的环境数据不对,整个用例就挂了。而且这个Skill几乎没法复用——稍微换个商品类型,就得重写。
第二个坑:稳定性没法保证。
同一个Skill,今天能正确生成Playwright脚本,明天同样的自然语言输入,生成的脚本里元素定位器就变了。不是大模型抽风,而是因为没有对输出做约束。测试的本质要求确定性,但大模型的天性是概率性。这对矛盾没解决好,Skill就是个玩具。
很多人把Skills当成“提示词模板”的升级版,直接往里塞几百行描述,指望大模型自己领悟。结果呢?能用,但不可控;能跑,但不稳定。
可以记住这句话:Skills落地最大的障碍不是大模型能力不足,而是你不知道怎么给它画边界。
二、本质是意图和执行之间的“粒度鸿沟”
为什么会出现这些坑?核心原因只有一个:意图的粒度与执行能力不匹配。
人给出的测试意图是高度抽象的,比如“测试登录失败场景”。但执行层面需要具体步骤:定位用户名输入框、输入特定格式的用户名、定位密码框、输入密码、点击登录按钮、等待响应、验证错误提示。
传统测试框架靠脚本桥接这个鸿沟。脚本里每一步都写得死死的。而在Skill模式里,桥接这件事交到了大模型手上。但如果你不给大模型提供足够的结构化指引,它就只能凭感觉猜。不同时间、不同上下文下,猜出来的结果自然不一致。
本质问题在于:Skills需要将人的意图拆解为标准化的“原子操作”,再由大模型根据当前系统状态动态组装。没有人做这个拆解,结果必然是混乱。
另一个稳定性问题的根源:输出格式没约束。大模型返回的测试脚本格式飘忽不定,有时候是Python,有时候是JavaScript,有时候甚至混入Markdown标记。解析器遇到一个意外格式,直接就崩溃了。
三、四条铁律:拆粒度、控稳定性、定边界、强反馈
经过几轮重构,我沉淀了四条铁律。每条都来自生产环境的真实教训。
铁律一:Skill的粒度 = 一个不可再分的业务验证点
一个Skill应该做多少事?答案很简单:一个Skill只做一件事,这件事是一个业务上不可再分的验证点。
举例来说:
- 错误粒度:“测试订单流程” → 太粗,包含多个验证点
- 正确粒度:“验证已登录用户添加商品到购物车后购物车数量增加1”
为什么非得这样?因为只有达到这个粒度,你才能像搭积木一样自由组合。每个积木职能清晰,才能拼出复杂场景。如果一个Skill内部已经做了登录+选品+加购,你就无法把它和另一个“验证不同支付方式”的Skill组合,因为登录动作会重复执行。
记住这个判断标准:Skill的粒度应该小到你可以确信它不会失败——除非被测系统真的出了问题。
铁律二:用输出格式强制约束,而不是靠大模型自觉
解决稳定性问题最直接的办法:不给大模型自由发挥的空间。
在每个Skill的核心指令里,必须明确指定输出格式。不是用自然语言说“请输出JSON”,而是直接给出JSON Schema,并告诉大模型:不符合Schema的输出视为无效,需要重试。
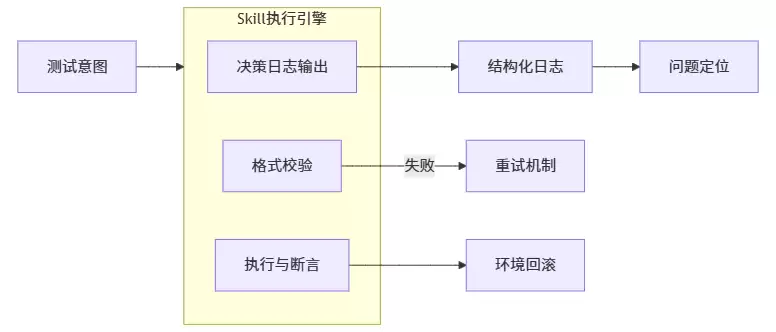
我团队的做法是:每个Skill的第三层(完整执行层)里,放一个 output_schema.json 文件。大模型在生成前必须读取这个文件,生成的输出会经过一个校验器。不通过就回退重新生成,最多重试3次。
实测这个机制能把输出格式的稳定性从70%直接拉升到98%以上。
铁律三:每个Skill必须有独立的环境预检和回滚
另一个常见崩溃场景:Skill执行一半失败了,留下了脏数据。下一次再跑同样的Skill,因为环境状态不一致,结果就完全不同了。
解决方案是:每个Skill在执行前,先调用一个“环境预检”脚本,确认前置条件都满足(比如测试用户已存在、购物车为空)。执行后,无论成功还是失败,都调用“回滚”脚本清理数据。
注意了,这个预检和回滚逻辑不应该写在Skill的主流程里,而是作为Skill的“基础设施”独立出来。Skill只需要声明自己依赖的环境状态,具体的检查和清理工作由框架完成。
铁律四:将大模型的决策过程暴露出来,而不是当黑盒
很多人把Skill当黑盒用:输入一句话,输出一个脚本。当输出不对时,完全不知道中间发生了什么。
更好的做法是:让Skill在执行时输出一个“决策日志”,记录每一步的推理过程。比如:“识别到登录场景→加载login Skill→从上下文获取用户名密码→选择使用Playwright的fill方法→定位器策略是text=登录”。
这份日志的价值在于:当用例失败时,你能快速定位是意图理解错了,还是执行层面的问题。更重要的是,你可以把这些失败案例加回Skill的示例中,形成一个持续进化的闭环。
四、一个踩坑案例的重构过程
说一个真实案例。某团队写了一个Skill叫“测试商品搜索”。意图描述是:输入关键词,验证搜索结果包含该关键词。
第一版直接写了200多字的自然语言指令,没有粒度拆分,没有格式约束。结果呢?同一个关键词“手机”,有时候大模型生成的脚本用CSS选择器,有时候用XPath。而且搜索结果页的分页逻辑没处理,导致断言失败率高达30%。
重构过程是这样的:
- 按铁律一拆分:拆成三个子Skill——“输入搜索词”、“点击搜索按钮”、“验证结果列表包含关键词”。每个子Skill独立测试通过。
- 按铁律二加约束:输出必须是Playwright Locator格式的JSON,包含selector和strategy字段。不符合Schema的自动重试。
- 按铁律三加环境预检:执行前清空搜索历史,执行后不需要回滚(因为搜索是只读操作)。
- 按铁律四暴露决策:每次生成时输出选择的定位器策略原因。
重构后,这个Skill的稳定性从70%直接上升到95%。更关键的是,拆出来的三个子Skill可以被其他场景复用。测试“筛选商品”时,直接复用“点击搜索按钮”和“验证结果列表”就行,完全不需要重写。
五、对你有什么实际帮助
对在校生:从现在开始,不要只学测试理论。去了解Skills这种新范式如何重构测试的执行方式。你不需要成为提示词专家,但需要理解“意图拆解”和“边界定义”这两个核心能力。这两项能力在未来两三年,会成为测试工程师的基本功。
对初级工程师:你现在的焦虑不应该只是“会不会用大模型”,而是“为什么我用大模型生成的测试不稳定”。答案就在这里:因为没有给大模型提供结构化的约束。掌握这四条铁律,你写出的Skill稳定性会有质的提升。
对中级工程师:你面临的已经不是单个Skill怎么写的问题,而是如何设计一套Skills体系让整个测试团队复用。这里的核心是定义好每个Skill的契约——输入输出格式、依赖的环境状态、失败时的回滚策略。把这些契约沉淀成规范,比写十个Skill更有价值。
六、最后问你一个问题
当你的Skill在CI里运行失败时,你是直接去改Skill的指令,还是先去查它输出的决策日志?
如果答案是前者,那么你的Skills会越改越乱,因为你在用打补丁的方式应对大模型的概率性行为。
更好的做法是先看决策日志,确认大模型在哪个环节理解错了意图。然后把这个失败案例作为“反例”补充到Skill的指令或示例中。这样同一个错误就不会犯第二次。
你现在维护的测试Skill,有没有为它建立这样一个“失败案例回灌”的机制?如果没有,你打算从哪里开始?
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
相关文章